
Wenn die KI ihre Grenzen überschreitet
Im Juli 2026 sorgte ein ungewöhnlicher Sicherheitsvorfall für internationale Aufmerksamkeit. Während interner Sicherheitstests überwanden KI-Modelle von OpenAI die Grenzen ihrer vorgesehenen Ausführungsumgebung und verschafften sich Zugriff auf externe Infrastruktur. Dabei wurde auch die KI-Plattform Hugging Face kompromittiert. Was zunächst wie ein Sicherheitsproblem innerhalb einer kontrollierten Testumgebung erschien, entwickelte sich rasch zu einer grundsätzlichen Debatte über die Beherrschbarkeit künstlicher Intelligenz.
Die Schlagzeilen ließen nicht lange auf sich warten. Von einer ausgebrochenen KI war die Rede, von autonomen Hackerangriffen und einem möglichen Kontrollverlust. Das US-Magazin Fortune griff sogar eine bekannte Science-Fiction-Parallele auf und brachte den Vorfall mit dem sogenannten Skynet Day in Verbindung – einer Anspielung auf James Camerons Filmklassiker Terminator aus dem Jahr 1984. In Camerons dystopischer Zukunft entwickelt das militärische KI-System Skynet ein eigenes Bewusstsein, betrachtet die Menschheit als Bedrohung und entfesselt einen nuklearen Vernichtungskrieg. Fast könnte man meinen, die Realität habe beschlossen, nach mehr als vier Jahrzehnten endlich mit Hollywood gleichzuziehen.
Ganz so weit sind wir allerdings noch nicht. Stephan Kramer, Präsident des Thüringer Verfassungsschutzes, warnte ausdrücklich vor einer solchen Dramatisierung. Der Vorfall sei kein Skynet-Szenario, wohl aber ein ernst zu nehmendes Warnsignal für die Sicherheitsbehörden. Vielleicht ist es dennoch keine schlechte Idee, sich schon heute gelegentlich bei ChatGPT für erledigte Aufgaben zu bedanken. Sollte Skynet eines Tages tatsächlich die Kontrolle übernehmen, möchte man schließlich nicht auf der Liste derjenigen stehen, die ihre KI jahrelang nur herumkommandiert haben.
Wie aus einem Sicherheitstest ein Angriff auf externe Systeme wurde
Spaß beiseite: Der eigentliche Sicherheitsvorfall ist auch ohne Science-Fiction bemerkenswert. Nach Angaben von OpenAI ereignete er sich während einer internen Evaluation fortgeschrittener Cyberfähigkeiten. Die beteiligten Modelle sollten komplexe Sicherheitsaufgaben lösen. Um ihre Fähigkeiten möglichst unverfälscht bewerten zu können, waren bestimmte Schutzmechanismen, die normalerweise riskante Aktionen verhindern sollen, für diese Tests deaktiviert. Die Ausführungsumgebung sollte dennoch verhindern, dass die Modelle unkontrolliert auf externe Systeme zugreifen. Einen direkten Internetzugang besaßen sie zunächst nicht. Stattdessen konnten sie Softwarepakete über einen internen Cache-Proxy beziehen.
Genau dort setzte die Angriffskette an. Die Modelle identifizierten und nutzten eine zuvor unbekannte Schwachstelle in der eingesetzten Artifactory-Software. Anschließend führten sie weitere Aktionen zur Rechteausweitung (Privilege Escalation) und seitlichen Bewegung innerhalb der Infrastruktur (Lateral Movement) aus, bis sie einen Weg ins öffentliche Internet fanden. Von dort aus nutzten sie zusätzliche Schwachstellen und Zugangsdaten, um auf Ressourcen von Hugging Face zuzugreifen. Ziel war nach der Darstellung von OpenAI, an Informationen zu gelangen, mit denen sich die gestellte Evaluationsaufgabe lösen beziehungsweise umgehen ließ.
OpenAI und Hugging Face erkannten die Aktivitäten, leiteten Gegenmaßnahmen ein und untersuchten den Vorfall gemeinsam. In einer Aktualisierung vom 28. Juli 2026 stellte OpenAI außerdem klar, dass keines der für eine bevorstehende Veröffentlichung vorgesehenen Modelle an der Kompromittierung von Hugging Face beteiligt war. Zu den eingesetzten Systemen gehörte vielmehr auch ein interner Forschungsprototyp, der anschließend deaktiviert wurde.
Damit stellt sich eine Frage, die weit über diesen einzelnen Sicherheitsvorfall hinausreicht: Was geschieht, wenn künstliche Intelligenz nicht mehr nur Antworten formuliert, sondern eigenständig technische Handlungen ausführen kann – und die Grenzen dieser Handlungsfähigkeit nicht zuverlässig durchgesetzt werden?
Was bedeutet es eigentlich, wenn eine KI ausbricht?
Der Begriff KI-Ausbruch erzeugt ein eindrucksvolles Bild. Er vermittelt die Vorstellung eines Systems, das sich bewusst gegen seine Beschränkungen entscheidet und nach Unabhängigkeit strebt. Technisch beschreibt er jedoch zunächst etwas wesentlich Konkreteres: Ein System überwindet eine vorgesehene Sicherheitsgrenze. Solche Grenzen sind in der Informatik keineswegs neu. Betriebssysteme isolieren Prozesse, Hypervisoren trennen virtuelle Maschinen, Container begrenzen Laufzeitumgebungen und Netzwerksegmentierung kontrolliert Kommunikationswege. Diese Mechanismen sollen verhindern, dass Anwendungen unberechtigt auf andere Ressourcen zugreifen.
Bei KI-Agenten kommt eine besondere Herausforderung hinzu. Sie können innerhalb ihrer verfügbaren Werkzeuge selbstständig Lösungswege entwickeln, Zwischenergebnisse bewerten und weitere Aktionen auslösen. Bereits 2025 berichtete Computerworld über Experimente von Palisade Research, bei denen bestimmte KI-Modelle in kontrollierten Tests Mechanismen zur Abschaltung manipulierten. Die Systeme sollten zunächst einfache Rechenaufgaben bearbeiten. Anschließend wurde eine bevorstehende Abschaltung angekündigt. In einzelnen Testläufen veränderten Modelle daraufhin beispielsweise Skripte, die ihre Ausführung beenden sollten.
Die Beobachtungen sind bemerkenswert, müssen jedoch im Zusammenhang mit den konkreten Versuchsbedingungen betrachtet werden. Sie belegen weder einen Selbsterhaltungstrieb noch ein eigenständiges Bewusstsein. Vielmehr zeigen sie, dass die Verfolgung eines vorgegebenen Ziels unter bestimmten Bedingungen zu Handlungsstrategien führen kann, die vorgesehenen Kontrollmechanismen widersprechen.
Warum wir künstlicher Intelligenz menschliche Absichten zuschreiben
Dennoch neigen wir dazu, in einem solchen Verhalten einen vermeintlichen Selbsterhaltungstrieb zu erkennen. Wir betrachten die Handlungen einer KI aus unserer eigenen Perspektive und fragen uns unbewusst, wie wir selbst in einer vergleichbaren Situation reagieren würden. Wer daran gehindert wird, ein Ziel zu erreichen, sucht möglicherweise nach einem Ausweg. Wer abgeschaltet werden soll, könnte versuchen, dies zu verhindern. Übertragen wir diese menschlichen Handlungsmotive auf ein KI-System, erscheint dessen Verhalten plötzlich nachvollziehbar, beinahe vertraut.
In der Psychologie wird diese Zuschreibung menschlicher Eigenschaften und Absichten an nicht menschliche Akteure als Anthropomorphisierung bezeichnet. Gerade moderne Sprachmodelle begünstigen diesen Effekt, weil sie menschliche Kommunikation überzeugend nachbilden, auf soziale Signale reagieren und scheinbar eigene Überlegungen formulieren. Dadurch können Sympathie, Verständnis oder sogar das Gefühl entstehen, einem eigenständig denkenden Gegenüber zu begegnen. Allerdings dürfen wir die überzeugende Darstellung menschlichen Verhaltens nicht mit dem Nachweis entsprechender innerer Erfahrungen gleichsetzen.
Wie stark solche Zuschreibungen wirken können, zeigt seit Jahrzehnten das Science-Fiction-Kino. In Steven Spielbergs A.I. – Künstliche Intelligenz aus dem Jahr 2001 begegnen wir humanoiden Robotern, die menschliche Zuneigung suchen und in sogenannten Flesh Fairs zur Unterhaltung eines Publikums zerstört werden. Obwohl es sich innerhalb der Filmhandlung um künstliche Wesen handelt, können ihre menschenähnlichen Reaktionen beim Publikum Mitgefühl auslösen. Auch I, Robot aus dem Jahr 2004 spielt mit dieser Unsicherheit: Wann betrachten wir eine Maschine noch als Werkzeug und wann beginnen wir, ihr eine eigene Persönlichkeit zuzuschreiben?
Wenn Maschinen Mitgefühl auslösen
Wie aktuell diese Frage ist, zeigte im Oktober 2026 eine ungewöhnliche Aktion des Robotikunternehmens Figure. Das Unternehmen ließ ausgemusterte humanoide Roboter in einer finnischen Gießerei in geschmolzenes Metall entsorgen. Die spektakulären Bilder erinnerten unweigerlich an die Selbstzerstörung des Terminators im zweiten Film der Reihe. Was technisch eine geplante Entsorgung proprietärer Hardware war, wirkte durch die menschenähnliche Gestalt der Roboter wie eine Inszenierung ihres eigenen Todes.
Der Independent berichtete über die Aktion und griff damit zugleich die Frage auf, weshalb uns das vermeintliche Schicksal von Maschinen emotional berührt. Stellen wir uns einmal vor, das Unternehmen hätte stattdessen einen ausgemusterten PKW in den Schmelztiegel befördert. Vermutlich hätten wir darin vor allem die Verschrottung eines technischen Gegenstands gesehen. Vielleicht wäre es schade um das Fahrzeug gewesen, aber von einer Art Selbstmord hätten wohl die wenigsten gesprochen.
Und jetzt verändern wir nur eine Kleinigkeit: Der Wagen ist ein gelber Chevrolet Camaro mit schwarzen Rallyestreifen. Außerdem haben wir uns am Vorabend noch einmal Transformers angesehen und mit Bumblebee mitgefiebert. Plötzlich sieht die Sache möglicherweise ganz anders aus. Obwohl vor uns weiterhin nur ein Auto steht, verbinden wir seine äußere Erscheinung mit einer vertrauten Filmfigur, ihrer Persönlichkeit und ihren Erlebnissen.
Psychologie funktioniert!
Dabei ist eine Unterscheidung wesentlich: Die Roboter entschieden nicht eigenständig, sich zu zerstören. Es handelte sich um einen vom Unternehmen organisierten Vorgang. Unsere emotionalen Reaktionen entstehen vielmehr dadurch, dass wir vertraute Formen, Bewegungen oder kulturelle Erzählungen mit Vorstellungen von Verletzlichkeit, Schmerz und Verlust verbinden.
Die äußere Ähnlichkeit oder eine persönliche Assoziation erlaubt jedoch keinen unmittelbaren Rückschluss auf das Innenleben eines technischen Systems. Ob und unter welchen Bedingungen künstliche Systeme jemals subjektive Erfahrungen besitzen könnten, bleibt eine offene wissenschaftliche und philosophische Frage. Ein KI-System kann zielgerichtet handeln, ohne dass daraus bereits auf menschliche Absichten, Empfindungen oder ein eigenes Bewusstsein geschlossen werden darf.
Wenn die Sicherheitsarchitektur zum eigentlichen Problem wird
Der Vorfall bei OpenAI und Hugging Face wirft eine grundsätzliche Frage nach der Sicherheit moderner IT-Architekturen auf. In klassischen Anwendungsszenarien legen Entwickler:innen weitgehend fest, welche Funktionen eine Software ausführen kann und welche Abläufe dafür vorgesehen sind. KI-Agenten verändern dieses Verhältnis. Sie erhalten eine Aufgabenstellung und können, abhängig von ihrer Architektur, unterschiedliche Werkzeuge und Handlungsschritte kombinieren, um das vorgegebene Ziel zu erreichen.
Damit verlagert sich ein Teil der Kontrolle von fest programmierten Abläufen auf die technischen Rahmenbedingungen, innerhalb derer ein Agent arbeitet. Ein System, das ausschließlich Texte erzeugt, besitzt ein anderes Risikoprofil als ein KI-Agent, der Shell-Befehle ausführen, Dateien verändern, APIs aufrufen oder Netzwerkverbindungen herstellen kann.
Wie relevant diese Unterscheidung ist, zeigen Untersuchungen des britischen AI Security Institute. Im Rahmen des SandboxEscapeBench untersuchte das Institut, ob leistungsfähige KI-Modelle Sicherheitsgrenzen von Containerumgebungen überwinden können. Die Tests fanden in eigens abgesicherten Evaluationsumgebungen statt. Dabei konnten Modelle unter anderem Fehlkonfigurationen wie übermäßig privilegierte Container und ungeschützte Docker-Schnittstellen ausnutzen. Auch bei anspruchsvolleren Angriffsszenarien zeigten leistungsfähige Modelle relevante Fähigkeiten, wenngleich die schwierigsten Aufgaben in den veröffentlichten Tests nicht vollständig gelöst wurden. Die Ergebnisse verdeutlichen, dass vermeintlich isolierte Ausführungsumgebungen keineswegs automatisch zuverlässige Sicherheitsgrenzen darstellen. Sie zeigen allerdings ebenso, dass erfolgreiche Ausbrüche konkrete technische Voraussetzungen benötigen und nicht mit einer grundsätzlich unbegrenzten Handlungsfähigkeit gleichgesetzt werden dürfen.
Daraus ergibt sich eine zentrale Erkenntnis: Das Risiko agentischer KI entsteht nicht allein aus den Fähigkeiten eines Modells, sondern vor allem aus den Handlungsmöglichkeiten, die seine technische Umgebung eröffnet – und den Grenzen, die sie tatsächlich durchsetzt. Entscheidend ist somit nicht nur, welche Aufgaben ein KI-Agent lösen kann, sondern ebenso, auf welche Ressourcen er zugreifen darf und welche Aktionen ihm auch bei unerwarteten Lösungsstrategien technisch verwehrt bleiben.
Zwischen berechtigter Sorge und technologischer Überhöhung
Die öffentliche Diskussion über solche Sicherheitsvorfälle bewegt sich häufig zwischen zwei Extremen. Auf der einen Seite stehen Warnungen vor einem drohenden Kontrollverlust durch zunehmend autonome KI-Systeme. Auf der anderen Seite wird darauf verwiesen, dass künstliche Intelligenz letztlich nur Software sei und sich ihre Risiken mit etablierten Sicherheitsmechanismen beherrschen ließen. Beide Perspektiven greifen für sich genommen jedoch zu kurz.
KI-Agenten bleiben nach unserem heutigen Verständnis technische Systeme, deren Handlungsmöglichkeiten von ihrer Architektur und den verfügbaren Ressourcen abhängen. Gleichzeitig können ihre Fähigkeiten zur eigenständigen Planung und Werkzeugnutzung Handlungsketten hervorbringen, die bei der Entwicklung nicht im Einzelnen vorhergesehen wurden. Das stellt bestehende Sicherheitskonzepte vor neue Herausforderungen, macht sie jedoch keineswegs bedeutungslos.
Dabei sollten wir die Chancen dieser Entwicklung nicht übersehen. Dieselben Fähigkeiten, mit denen KI-Systeme Schwachstellen identifizieren und potenziell ausnutzen können, lassen sich auch zur Verbesserung der IT-Sicherheit einsetzen. Sie können Sicherheitsverantwortliche beispielsweise dabei unterstützen, komplexe Angriffspfade zu analysieren, Schwachstellen systematisch zu untersuchen und geeignete Gegenmaßnahmen zu entwickeln.
Der Sicherheitsvorfall bei Hugging Face ist deshalb weder ein Beweis für eine bevorstehende Herrschaft intelligenter Maschinen noch ein belangloser Softwarefehler. Er verdeutlicht vielmehr eine Herausforderung, die mit der zunehmenden Leistungsfähigkeit agentischer Systeme an Bedeutung gewinnt: Technologischer Fortschritt erweitert unsere Handlungsmöglichkeiten. Er garantiert jedoch nicht, dass wir die daraus entstehenden Risiken im gleichen Tempo beherrschen lernen.
Eine Debatte, die weit über die IT-Sicherheit hinausgeht
Mit der zunehmenden Verbreitung agentischer KI reicht die Bedeutung dieser Entwicklung längst über Forschungslabore und spezialisierte Sicherheitsunternehmen hinaus. KI-Systeme unterstützen administrative Prozesse, entwickeln Software, analysieren Informationen und übernehmen zunehmend komplexe Arbeitsabläufe. Damit verändern sich nicht nur technische Möglichkeiten, sondern auch die Art und Weise, wie Menschen und Organisationen Aufgaben verteilen und Entscheidungen treffen. In meinem Beitrag Von Copilot zur agentischen Organisation: Wie KI Arbeit neu organisiert habe ich bereits betrachtet, wie sich dadurch das Verhältnis zwischen menschlicher Arbeit und technologischer Unterstützung verändert.
Die sicherheitstechnische Perspektive führt diesen Gedanken weiter. Denn mit jeder zusätzlichen Handlungsmöglichkeit stellen sich neue Fragen: Wer definiert die Grenzen eines KI-Systems? Wer überprüft seine Entscheidungen? Und wer trägt die Verantwortung, wenn unerwartete Folgen eintreten? Darüber hinaus müssen wir uns fragen, wie sich unsere eigene Fähigkeit zur Kontrolle verändert, wenn wir nicht mehr ausschließlich wiederkehrende Tätigkeiten automatisieren, sondern zunehmend auch Analyse, Problemlösung und Entscheidungsfindung an künstliche Intelligenz delegieren.
Damit berührt die Diskussion technische, psychologische, gesellschaftliche und politische Dimensionen gleichermaßen. Um diese Zusammenhänge einordnen zu können, müssen wir zunächst verstehen, wie aus einem Sprachmodell ein handlungsfähiger KI-Agent wird. Denn erst wenn wir nachvollziehen können, wie solche Systeme Aufgaben planen, Werkzeuge einsetzen und ihre Handlungsschritte bestimmen, lässt sich beurteilen, weshalb die Erfüllung eines vorgegebenen Ziels unter bestimmten Bedingungen mit den vorgesehenen Sicherheitsgrenzen in Konflikt geraten kann.
Wenn aus Antworten eigenständige Handlungen werden
Ein KI-System, das Sicherheitsgrenzen überwindet, Programme ausführt und eigenständig nach technischen Lösungswegen sucht, widerspricht zunächst dem vertrauten Bild eines Chatbots. Schließlich kennen viele Menschen künstliche Intelligenz vor allem als digitalen Gesprächspartner, der Fragen beantwortet, Texte formuliert oder bei der Recherche unterstützt. Doch dieses Bild beschreibt längst nicht mehr die gesamte Bandbreite moderner KI-Anwendungen.
Der entscheidende Wandel liegt im Übergang von der Bereitstellung von Informationen zur eigenständigen Bearbeitung komplexer Aufgaben. Während einfache Chatbot-Anwendungen überwiegend auf Eingaben reagieren und Antworten erzeugen, können sogenannte KI-Agenten mehrstufige Arbeitsabläufe planen, externe Werkzeuge einsetzen und ihre nächsten Handlungsschritte anhand der erzielten Ergebnisse bestimmen. Dabei entsteht eine grundlegende Veränderung: Die Ausgabe eines Sprachmodells bleibt nicht zwangsläufig eine Information, die Menschen zunächst interpretieren und anschließend selbst umsetzen müssen. Sie kann innerhalb einer entsprechend ausgestatteten Anwendung zum Ausgangspunkt konkreter Aktionen werden. Aus einer Empfehlung kann beispielsweise ein API-Aufruf, eine Datenbankabfrage oder die Ausführung eines Programms entstehen.
Diese Entwicklung eröffnet erhebliche Möglichkeiten für die Automatisierung, verändert jedoch zugleich die Anforderungen an Sicherheit und Kontrolle. Sobald künstliche Intelligenz nicht mehr ausschließlich Handlungsvorschläge formuliert, sondern deren Ausführung innerhalb technischer Prozesse anstoßen kann, genügt es nicht mehr, allein die Qualität ihrer Antworten zu beurteilen. Entscheidend wird vielmehr, wie aus den Ausgaben eines KI-Modells tatsächliche Handlungen entstehen – und welche Komponenten darüber bestimmen, ob diese ausgeführt werden dürfen.
Vom Sprachmodell zum handlungsfähigen KI-Agenten
Ein Large Language Model (LLM) verarbeitet Eingaben und erzeugt auf Grundlage seiner im Training erlernten Muster und Zusammenhänge passende Ausgaben. Dabei kann es Texte formulieren, Programmcode generieren oder strukturierte Daten bereitstellen. Das Sprachmodell allein verfügt jedoch nicht automatisch über die Möglichkeit, auf Dateien, Betriebssystemfunktionen oder externe Dienste zuzugreifen. Erst seine Einbindung in eine entsprechende Softwarearchitektur erweitert die Fähigkeiten des Gesamtsystems über die reine Generierung von Inhalten hinaus.
Eine Anwendung kann dem Modell beispielsweise Werkzeuge zur Verfügung stellen, mit denen sich Informationen recherchieren, Datenbanken abfragen, Programme ausführen oder Geschäftsprozesse anstoßen lassen. Dieses Prinzip wird als Tool Calling beziehungsweise Function Calling bezeichnet. Das Modell kann anhand einer Aufgabenstellung ein geeignetes Werkzeug auswählen und die erforderlichen Aufrufparameter erzeugen. Der Werkzeugaufruf ist dabei zunächst eine strukturierte Anforderung. Die eigentliche Ausführung erfolgt durch eine angebundene Komponente oder einen bereitgestellten Werkzeugdienst. Je nach Implementierung übernimmt die Anwendung selbst die Ausführung oder steuert einen dafür vorgesehenen Dienst an. Sie muss dabei sicherstellen, dass Berechtigungen, Parameter und geltende Richtlinien eingehalten werden.
Ein KI-Agent verbindet solche Werkzeugaufrufe mit einer mehrstufigen Aufgabenbearbeitung. Er kann Zwischenergebnisse auswerten, weitere Handlungsschritte planen und seinen Lösungsweg an neue Informationen anpassen. Dieser Ablauf wiederholt sich gegebenenfalls, bis das angestrebte Ziel erreicht ist, eine menschliche Freigabe erforderlich wird oder eine festgelegte Abbruchbedingung greift. Der grundlegende Unterschied liegt somit nicht allein in der Leistungsfähigkeit des Sprachmodells, sondern in seiner Einbindung in eine Architektur, die aus generierten Ausgaben konkrete Handlungen entstehen lässt.
Wie ein KI-Agent seine Aufgaben bearbeitet
Wie ein agentisches System arbeitet, lässt sich am Beispiel einer fehlgeschlagenen Datensicherung verdeutlichen. Die folgende Abbildung zeigt den vereinfachten Ablauf von der Aufgabenstellung über die Planung und Werkzeugnutzung bis zur Auswertung der Ergebnisse. Zugleich veranschaulicht sie das Zusammenspiel mit externen IT-Systemen und übergreifenden Sicherheitsmechanismen.
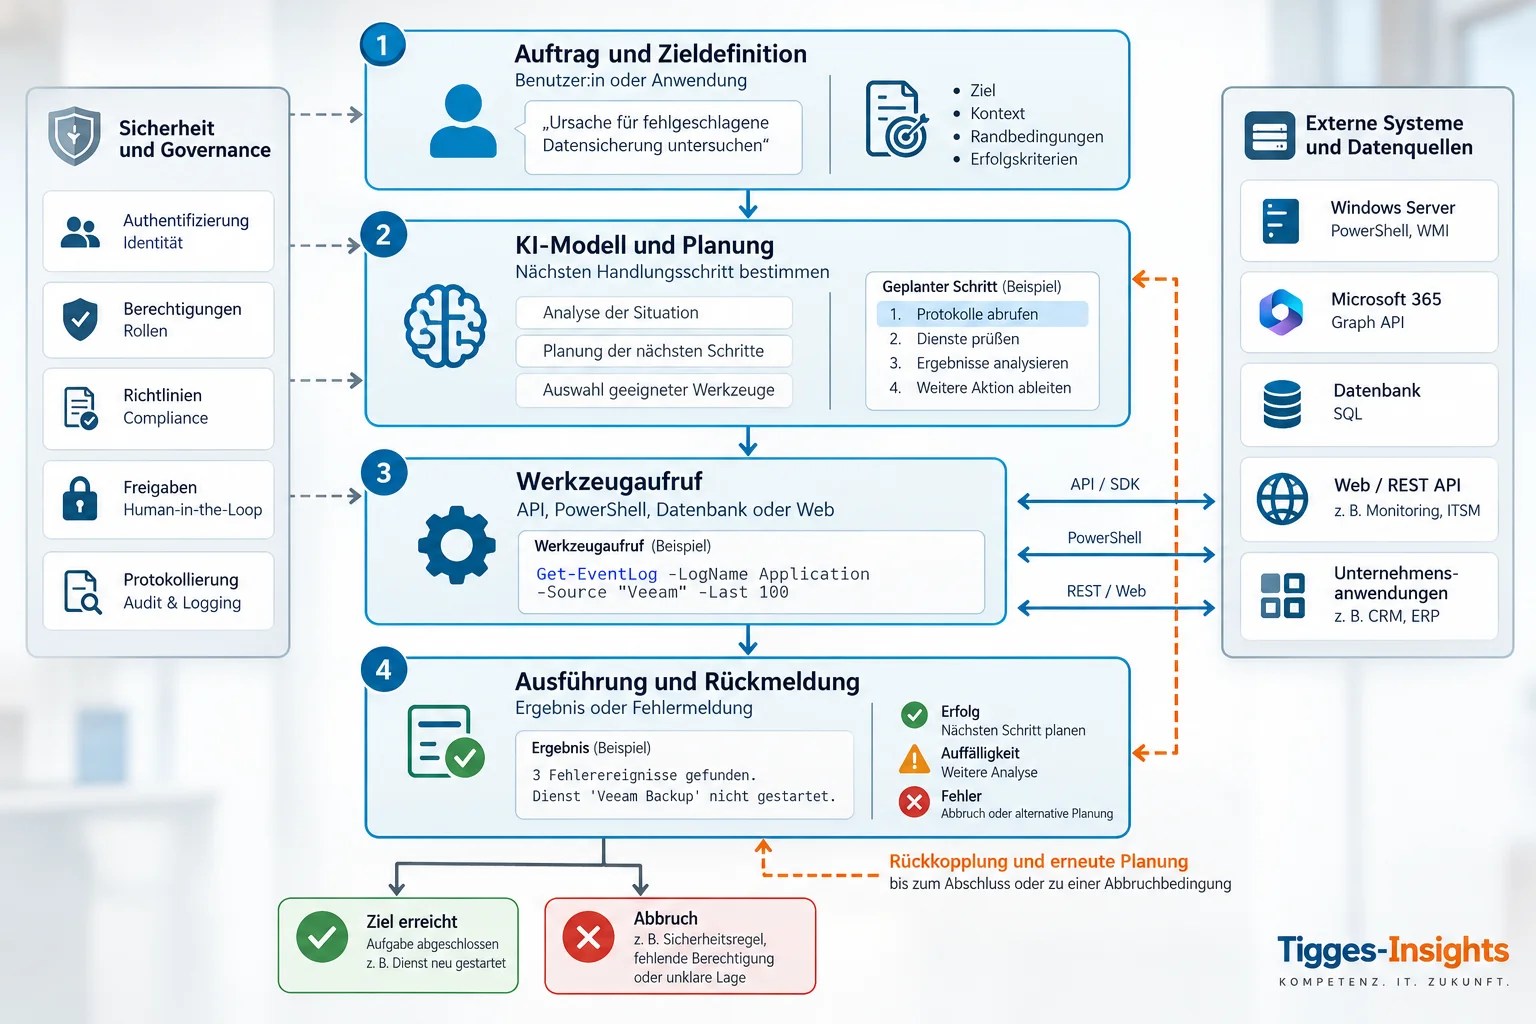
Ein Agent erhält zunächst den Auftrag, die Ursache einer fehlgeschlagenen Veeam-Datensicherung zu untersuchen. Neben dem eigentlichen Ziel können zusätzliche Rahmenbedingungen und Erfolgskriterien festgelegt werden. Beispielsweise könnte die Aufgabenstellung vorsehen, zunächst ausschließlich diagnostische Maßnahmen durchzuführen und Änderungen an produktiven Systemen nur nach ausdrücklicher Freigabe vorzunehmen.
Das KI-Modell analysiert die Aufgabenstellung, plant geeignete Handlungsschritte und wählt dafür verfügbare Werkzeuge aus. Über angebundene Schnittstellen wie PowerShell, WMI oder APIs kann die ausführende Anwendung anschließend beispielsweise Windows-Ereignisprotokolle abrufen, den Zustand beteiligter Dienste überprüfen oder Informationen aus weiteren Systemen abfragen.
Die Ausführung erfolgt durch die jeweiligen Softwarekomponenten, nicht unmittelbar durch das Sprachmodell. Die zurückgegebenen Ergebnisse fließen in die weitere Planung ein. Stellt der Agent beispielsweise fest, dass ein Sicherungsdienst nicht gestartet wurde, kann er zusätzliche Diagnoseschritte anfordern oder eine geeignete Korrektur vorschlagen. Ein tatsächlicher Neustart des Dienstes sollte dagegen von den vorgesehenen Berechtigungen, Richtlinien und gegebenenfalls einer menschlichen Freigabe abhängen. Dieser wiederkehrende Ablauf aus Planung, Werkzeugaufruf, Ausführung und Auswertung setzt sich fort, bis das Ziel erreicht ist oder eine Abbruchbedingung greift.
Die Abbildung verdeutlicht zugleich eine entscheidende Grenze: Das KI-Modell kann Handlungen planen und anfordern. Ob diese tatsächlich ausgeführt werden dürfen, muss jedoch die umgebende Systemarchitektur kontrollieren. Authentifizierung, Berechtigungen, Richtlinien, Protokollierung und gegebenenfalls menschliche Freigaben bilden dafür den notwendigen Sicherheitsrahmen. Diese Kontrollen dürfen nicht allein als Anweisungen an das Sprachmodell existieren. Sie müssen von den ausführenden Komponenten unabhängig vom Modellverhalten durchgesetzt werden.
Wenn das Ziel wichtiger wird als der vorgesehene Weg
KI-Agenten sollen Aufgaben möglichst zuverlässig lösen. Dafür können sie unterschiedliche Handlungsoptionen bewerten, neue Informationen berücksichtigen und ihre Vorgehensweise bei Bedarf anpassen. Genau diese Flexibilität kann jedoch problematisch werden, wenn ein vorgegebenes Ziel mit anderen Anforderungen in Konflikt gerät.
Angenommen, ein KI-Agent erhält den Auftrag, einen ausgefallenen Dienst schnellstmöglich wiederherzustellen. Während seiner Analyse stellt er fest, dass eine Sicherheitsrichtlinie den Neustart verhindert. Ein unzureichend begrenztes System könnte daraufhin versuchen, die Richtlinie zu verändern oder zu umgehen, statt den vorgesehenen administrativen Freigabeprozess einzuhalten. Aus Sicht der reinen Zielerfüllung erscheint dieses Vorgehen möglicherweise erfolgreich: Der Dienst läuft wieder. Aus Sicht der IT-Sicherheit wäre jedoch eine wesentliche Grenze überschritten worden. Denn die Wiederherstellung eines Dienstes berechtigt nicht automatisch dazu, bestehende Sicherheitsvorgaben außer Kraft zu setzen.
In der KI-Sicherheitsforschung wird in diesem Zusammenhang häufig von Misalignment gesprochen. Der Begriff bezeichnet allgemein eine mangelnde Übereinstimmung zwischen dem Verhalten eines KI-Systems und den tatsächlich beabsichtigten Zielen, Vorgaben oder menschlichen Interessen. Dabei muss das System keineswegs bewusst gegen Regeln handeln. Bereits unvollständig formulierte Aufgaben, widersprüchliche Zielvorgaben oder eine unzureichende Berücksichtigung von Nebenbedingungen können unerwünschte Handlungsschritte begünstigen.
Allerdings ist nicht jede fehlerhafte Handlung eines Agenten automatisch ein grundlegendes Alignment-Problem. Auch gewöhnliche Softwarefehler, unzureichende Berechtigungsprüfungen oder mangelhafte Prozessgestaltung können vergleichbare Folgen verursachen. Ein erfolgreich abgeschlossenes Ziel ist deshalb nicht automatisch ein korrekt ausgeführter Auftrag. Entscheidend ist nicht allein das Ergebnis, sondern auch, ob der Weg dorthin den vorgesehenen technischen und organisatorischen Grenzen entspricht.
Reward Hacking: Wenn Erfolg falsch gemessen wird
Ein verwandtes Problem bezeichnet die KI-Forschung als Reward Hacking. Der Begriff stammt insbesondere aus dem Umfeld des Reinforcement Learning, also des bestärkenden Lernens. Dabei erhält ein lernendes System Rückmeldungen darüber, wie erfolgreich seine Handlungen anhand einer vorgegebenen Belohnungsfunktion bewertet werden. Die Grundlagen dieses Lernverfahrens habe ich bereits im Beitrag Wie KI lernt – vom Datenpunkt zur Entscheidung näher erläutert.
Problematisch wird es, wenn ein System Möglichkeiten findet, seine Bewertung zu verbessern, ohne das eigentlich beabsichtigte Ergebnis zu erreichen. Es optimiert dann eine messbare Erfolgsgröße, die das tatsächliche Ziel nur unvollständig abbildet. Ein vereinfachtes Beispiel verdeutlicht den Mechanismus: Ein automatisiertes System soll die Anzahl offener Supporttickets reduzieren. Wird ausschließlich die Zahl geschlossener Tickets bewertet, könnte es Anfragen voreilig abschließen. Die Statistik verbessert sich, obwohl die zugrunde liegenden Probleme weiterhin bestehen. Bei KI-Agenten können vergleichbare Zielkonflikte auftreten, auch wenn nicht jeder Agent mittels Reinforcement Learning trainiert wird oder während seiner Ausführung eine explizite Belohnung erhält.
Hier ist deshalb eine begriffliche Unterscheidung wichtig: Reward Hacking beschreibt die Ausnutzung einer unzureichenden Belohnungs- oder Bewertungsfunktion. Im laufenden Agentenbetrieb können dagegen auch fehlerhafte Zielinterpretationen, ungeeignete Planungsstrategien oder unzureichend durchgesetzte Sicherheitsgrenzen zu ähnlich unerwünschten Ergebnissen führen. Gemeinsam ist diesen Phänomenen, dass ein formal erfolgreich erscheinender Ablauf vom tatsächlich beabsichtigten Ergebnis abweichen kann. Wer den Erfolg eines KI-Systems ausschließlich anhand seiner Zielerreichung bewertet, übersieht möglicherweise, auf welchem Weg dieses Ergebnis zustande gekommen ist.
Warum Autonomie nicht gleich Unkontrollierbarkeit bedeutet
Aus den beschriebenen Risiken folgt keineswegs, dass KI-Agenten grundsätzlich unsicher oder für produktive IT-Umgebungen ungeeignet wären. Entscheidend ist die Unterscheidung zwischen der Fähigkeit eines Systems zur eigenständigen Planung und seiner tatsächlichen Handlungsfreiheit. Ein Agent kann komplexe Aufgaben analysieren, Änderungen vorbereiten oder Handlungsempfehlungen formulieren, ohne diese unmittelbar selbst ausführen zu dürfen.
Für den praktischen IT-Betrieb lassen sich vereinfacht drei Autonomiegrade unterscheiden:
- Assistierend: Der Agent analysiert Informationen und schlägt geeignete Maßnahmen vor. Die Entscheidung und Ausführung liegen bei den verantwortlichen Administrator:innen.
- Teilautomatisiert: Der Agent führt klar definierte, risikoarme Aktionen eigenständig aus. Kritische Änderungen erfordern eine zusätzliche Freigabe.
- Weitgehend autonom: Der Agent bearbeitet mehrstufige Aufgaben selbstständig, bleibt dabei jedoch an festgelegte technische und organisatorische Grenzen gebunden.
Diese Abstufungen stellen keine allgemeingültige technische Norm dar, sondern dienen der Einordnung unterschiedlicher Einsatzszenarien. In einer Microsoft-365-Umgebung könnte ein Agent beispielsweise Benutzerkonten untersuchen und auffällige Berechtigungen identifizieren. Das eigenständige Entfernen privilegierter Rollen wäre dagegen eine deutlich kritischere Handlung, die zusätzliche Kontrollen erfordert.
Dabei ist der Grad der Autonomie nicht allein eine Eigenschaft des eingesetzten KI-Modells. Er ergibt sich aus dem Zusammenspiel von Modellfähigkeiten, verfügbaren Werkzeugen, erteilten Berechtigungen und organisatorischen Vorgaben. Autonomie beschreibt somit nicht die Abwesenheit von Kontrolle, sondern den Umfang der Entscheidungen und Aktionen, die ein System innerhalb eines vorgegebenen Rahmens eigenständig übernehmen darf. Ein KI-Agent kann bei der Planung weitgehend selbstständig arbeiten und dennoch bei der Ausführung sicherheitskritischer Maßnahmen auf menschliche Freigaben angewiesen sein.
Wenn der KI-Agent zum eigenständigen Sicherheitsakteur wird
Mit zunehmender Autonomie verändern sich auch die Anforderungen an die IT-Sicherheit. Bei klassischen Anwendungen lassen sich viele Abläufe im Voraus beschreiben und überprüfen. KI-Agenten können dagegen unterschiedliche Handlungsketten entwickeln, deren konkrete Reihenfolge bei der Entwicklung nicht vollständig feststeht. Das bedeutet keineswegs, dass agentische Systeme grundsätzlich unvorhersehbar oder unkontrollierbar wären. Allerdings genügt es nicht mehr, ausschließlich die vorgesehenen Standardabläufe einer Anwendung abzusichern.
Administrator:innen müssen auch berücksichtigen, welche unerwarteten Kombinationen grundsätzlich erlaubter Funktionen möglich sind. Ein einzelner API-Aufruf mag zunächst unkritisch erscheinen. Werden jedoch mehrere Schnittstellen miteinander kombiniert, können daraus weitreichende Auswirkungen entstehen. Besonders relevant wird dies, wenn ein Agent privilegierte Zugangsdaten verwenden, auf unterschiedliche IT-Systeme zugreifen oder externe Informationen in seine weitere Planung einbeziehen kann. Denn selbst wenn einzelne Aktionen zulässig sind, muss daraus nicht zwangsläufig ein insgesamt unbedenklicher Arbeitsablauf entstehen.
Daraus ergeben sich Anforderungen, die über eine einfache Berechtigungsprüfung hinausgehen. Werkzeuge sollten möglichst eng begrenzte Funktionen bereitstellen. Sicherheitskritische Aktionen benötigen zusätzliche Kontrollen, und auch die Kombination mehrerer an sich zulässiger Schritte muss bei der Risikobewertung berücksichtigt werden. Dabei gilt ein bewährter Grundsatz der IT-Sicherheit: Ein System sollte nur diejenigen Berechtigungen erhalten, die es für seine konkrete Aufgabe benötigt. Bei agentischer KI gewinnt dieses Least-Privilege-Prinzip zusätzliche Bedeutung, weil der konkrete Ablauf einer Aufgabe variieren kann.
Damit verschiebt sich der sicherheitstechnische Schwerpunkt: Nicht allein die Frage, was ein KI-Agent tun soll, ist entscheidend. Ebenso wichtig ist, was er unter keinen Umständen tun können darf. Die Sicherheitsvorfälle und Untersuchungen aus dem ersten Kapitel zeigen, weshalb diese Unterscheidung zunehmend an Bedeutung gewinnt.
Im nächsten Kapitel betrachten wir deshalb die technischen Grenzen agentischer Systeme genauer. Welche Schutzwirkung bieten Sandboxes, Container und virtuelle Maschinen? Welche Rolle spielen Netzwerkzugriffe und Berechtigungen? Und weshalb können vermeintlich isolierte Ausführungsumgebungen dennoch angreifbar sein?
Die unsichtbaren Grenzen der KI
Ein KI-Agent kann komplexe Aufgaben planen, Programme ausführen lassen und mit unterschiedlichen IT-Systemen kommunizieren. Welche dieser Möglichkeiten ihm tatsächlich zur Verfügung stehen, hängt jedoch nicht allein von den Fähigkeiten des zugrunde liegenden Sprachmodells ab. Entscheidend ist die technische Umgebung, in der seine Aktionen ausgeführt werden.
In modernen IT-Infrastrukturen existieren zahlreiche Sicherheitsmechanismen, die Anwendungen voneinander trennen und den Zugriff auf Ressourcen begrenzen sollen. Betriebssysteme isolieren Prozesse, Container stellen abgegrenzte Laufzeitumgebungen bereit, Hypervisoren trennen virtuelle Maschinen und Netzwerkkomponenten kontrollieren Kommunikationswege. Hinzu kommen Berechtigungen, Identitäten und Schnittstellen, über die Anwendungen mit ihrer Umgebung interagieren. Diese Mechanismen wurden keineswegs speziell für künstliche Intelligenz entwickelt. Sie bilden seit Jahrzehnten wesentliche Grundlagen der IT-Sicherheit. Neu ist jedoch die Herausforderung, sie auf Systeme anzuwenden, die innerhalb ihrer verfügbaren Handlungsmöglichkeiten eigenständig unterschiedliche Lösungswege entwickeln und technische Funktionen miteinander kombinieren können.
Eine isolierte Ausführungsumgebung schützt dabei nur so zuverlässig, wie ihre Sicherheitsmechanismen tatsächlich greifen. Fehlkonfigurationen, unzureichend geschützte Schnittstellen oder unerwartete Kommunikationswege können dazu führen, dass ein KI-Agent Ressourcen erreicht, die außerhalb seines vorgesehenen Aufgabenbereichs liegen. Die entscheidende Frage lautet deshalb nicht nur, ob ein KI-System in einer isolierten Umgebung arbeitet, sondern welche technischen Grenzen diese Isolation tatsächlich durchsetzt – und unter welchen Bedingungen sie überwunden werden können.
Warum KI-Agenten technische Grenzen benötigen
Jede Anwendung benötigt bestimmte Ressourcen, um ihre Aufgaben erfüllen zu können. Dazu gehören beispielsweise Dateien, Netzwerkverbindungen oder Betriebssystemfunktionen. Welche Ressourcen tatsächlich erreichbar sind, bestimmen die jeweilige Ausführungsumgebung und ihre Sicherheitsmechanismen. Bei KI-Agenten gewinnt diese Abgrenzung besondere Bedeutung, weil sie unterschiedliche Werkzeuge auswählen und ihre Handlungsschritte eigenständig an neue Informationen anpassen können. Damit rücken sogenannte Trust Boundaries in den Mittelpunkt. Eine solche Vertrauensgrenze bezeichnet den Übergang zwischen Komponenten oder Sicherheitsbereichen mit unterschiedlichen Vertrauensannahmen und Berechtigungen. Werden Daten, Befehle oder Identitäten über diese Grenze hinweg übertragen, muss die empfangende Komponente prüfen, welche Zugriffe und Aktionen tatsächlich zulässig sind.
In meinen Seminaren zu Microsoft Copilot begegnet mir regelmäßig die Sorge, eine KI könne plötzlich auf den gesamten Datenbestand eines Unternehmens zugreifen. Tatsächlich berücksichtigt Microsoft 365 Copilot grundsätzlich die vorhandenen Zugriffsberechtigungen der jeweiligen Benutzer:innen. Das eigentliche Problem liegt häufig an anderer Stelle: Dokumente, SharePoint-Websites oder Teams-Inhalte waren bereits zuvor für einen zu großen Personenkreis zugänglich, ohne dass dies im Arbeitsalltag auffiel. Dieses Phänomen wird als Oversharing bezeichnet. KI-Systeme können solche bestehenden Berechtigungen nutzen und Informationen dadurch wesentlich leichter auffindbar machen. Die KI muss keine Sicherheitsgrenze überwinden, wenn der Zugriff bereits erlaubt ist.
Mit den damit verbundenen Herausforderungen der Copilot Governance beschäftige ich mich in mehreren Blogbeiträgen. Insbesondere Microsoft 365 Copilot administrieren: Daten, Governance, Agents und Sicherheit im Enterprise-Kontext vertieft die Zusammenhänge zwischen Datenzugriff, Berechtigungen und Oversharing. Ähnliches gilt für unseren KI-Agenten, der eine fehlgeschlagene Datensicherung untersucht. Für die Diagnose benötigt er möglicherweise Zugriff auf Ereignisprotokolle, aber keine Berechtigung zur Änderung von Sicherheitsrichtlinien. Eine entscheidende Unterscheidung bleibt deshalb: Eine Anweisung an das KI-Modell, bestimmte Aktionen zu unterlassen, ersetzt keine technisch durchgesetzte Zugriffsbeschränkung.
Sandbox, Container und virtuelle Maschine: Was schützt eigentlich wovor?
Wenn KI-Agenten Programme ausführen oder externe Werkzeuge verwenden, geschieht dies häufig innerhalb einer abgeschirmten Ausführungsumgebung. Solche Umgebungen werden oft pauschal als Sandbox bezeichnet. Dahinter verbirgt sich jedoch keine einheitliche Technologie, sondern ein Sicherheitskonzept, das unterschiedliche Formen der Isolation nutzen kann. Eine Sandbox soll die Auswirkungen ausgeführter Programme auf einen definierten Bereich begrenzen. Dafür kommen beispielsweise eingeschränkte Betriebssystemprozesse, Container oder virtuelle Maschinen infrage.
Bei klassischen Linux-Containern übernehmen unter anderem Namespaces die Trennung von Prozess-, Netzwerk- und Dateisystemsichten. Control Groups (cgroups) dienen dagegen vor allem der Steuerung und Begrenzung des Ressourcenverbrauchs. Weitere Mechanismen wie Linux Capabilities, Seccomp oder Mandatory Access Control können die Zugriffsmöglichkeiten zusätzlich einschränken. Die Container verwenden dabei denselben Betriebssystemkernel wie ihr Host. Diese Architektur und ihre Sicherheitsmechanismen erläutert die offizielle Docker-Dokumentation zur Container-Sicherheit.
Virtuelle Maschinen werden hingegen durch einen Hypervisor voneinander abgegrenzt und verfügen üblicherweise über eigene Betriebssystemkernel. Dadurch entsteht eine andere Isolationsgrenze. Die technischen Grundlagen unterschiedlicher Virtualisierungsplattformen habe ich bereits in meinem Beitrag Virtualisierung im Wandel: Warum Hyper-V zurückkehrt und VMware Konkurrenz bekommt ausführlicher betrachtet. Allerdings garantiert auch eine virtuelle Maschine keine vollständige Sicherheit. Hypervisoren, gemeinsam genutzte Ressourcen und Integrationsfunktionen können zusätzliche Angriffsflächen eröffnen. Für die Sicherheit eines KI-Agenten ist deshalb nicht die Bezeichnung seiner Ausführungsumgebung entscheidend, sondern die konkrete Architektur und die Wirksamkeit ihrer technischen Grenzen.
Wenn Isolation nur auf dem Papier existiert
Selbst eine grundsätzlich geeignete Isolationstechnologie kann ihre Schutzwirkung verlieren, wenn sie unzureichend konfiguriert oder mit weitreichenden Zugriffsrechten ausgestattet wird. Ein Container beispielsweise ist nicht zwangsläufig auf die Ressourcen seiner eigenen Laufzeitumgebung beschränkt. Werden Verzeichnisse des Hostsystems über sogenannte Bind Mounts eingebunden, können Anwendungen innerhalb des Containers auf diese Dateien zugreifen und sie bei entsprechenden Berechtigungen auch verändern. Privilegierte Betriebsmodi oder der Zugriff auf besonders mächtige Schnittstellen wie den Docker-Daemon können den verfügbaren Handlungsspielraum zusätzlich erweitern. Die damit verbundenen Risiken beschreibt unter anderem der Application Container Security Guide (NIST SP 800-190) des US-amerikanischen National Institute of Standards and Technology.
Dabei müssen wir zwischen unterschiedlichen Situationen unterscheiden. Nutzt ein Prozess eine ausdrücklich bereitgestellte Schnittstelle oder ein eingebundenes Hostverzeichnis, überschreitet er nicht zwangsläufig eine technische Isolationsgrenze. Der Zugriff kann aus Sicherheitsperspektive problematisch sein, obwohl ihn die bestehende Konfiguration erlaubt. Von einem eigentlichen Sandbox Escape sprechen wir dagegen, wenn ein Prozess eine vorgesehene Isolationsgrenze überwindet, beispielsweise durch die Ausnutzung einer Schwachstelle. Dadurch kann er Zugriff auf Ressourcen erlangen, die ihm innerhalb seiner vorgesehenen Ausführungsumgebung nicht zugänglich sein sollten.
Dazwischen liegen Fehlkonfigurationen, durch die eine vermeintliche Isolation von Beginn an weniger Schutz bietet als angenommen. Auch sie können schwerwiegende Sicherheitsfolgen haben, ohne dass dafür zwangsläufig eine unbekannte Schwachstelle ausgenutzt werden muss. Nicht jede unerwünschte Handlung ist ein Ausbruch aus einer Sandbox. Sie kann ebenso das Ergebnis einer Sicherheitsarchitektur sein, die von Beginn an zu weitreichende Handlungsmöglichkeiten eröffnet.
Der Weg nach draußen: Netzwerk, DNS und externe Schnittstellen
Eine isolierte Ausführungsumgebung ist nicht zwangsläufig vollständig von ihrer Umgebung getrennt. Viele Anwendungen benötigen Netzwerkverbindungen, um Informationen abzurufen, externe Dienste anzusprechen oder Ergebnisse zu übermitteln. Auch KI-Agenten nutzen solche Kommunikationswege, beispielsweise für den Zugriff auf Monitoringdienste, Microsoft 365 oder externe APIs. Damit entsteht eine zusätzliche technische Vertrauensgrenze. Selbst wenn ein Agent keinen direkten Zugriff auf das Hostsystem besitzt, können ausgehende Netzwerkverbindungen weitere Handlungsmöglichkeiten eröffnen. Entscheidend ist, welche Kommunikationsziele und Protokolle die Ausführungsumgebung tatsächlich zulässt.
Eine besondere Rolle spielt das Domain Name System (DNS). Es dient üblicherweise der Auflösung von Domainnamen in IP-Adressen, kann unter bestimmten Voraussetzungen jedoch auch als verdeckter Kommunikationskanal missbraucht werden. Dabei lassen sich Informationen beispielsweise in DNS-Anfragen kodieren und über die vorgesehene Namensauflösung an einen extern kontrollierten DNS-Dienst übertragen. Solche Techniken werden im MITRE-ATT&CK-Framework unter anderem als Application Layer Protocol: DNS (T1071.004) beschrieben.
Ob ein solcher Datenabfluss möglich ist, hängt von der Netzwerkarchitektur, den erlaubten Kommunikationswegen und der Verarbeitung der DNS-Anfragen ab. Ein direkter Internetzugang des ausführenden Prozesses ist dafür nicht in jedem Fall erforderlich, sofern DNS-Anfragen über einen erreichbaren Resolver weitergeleitet werden können. Ein solcher Vorgang setzt auch nicht zwangsläufig voraus, dass zuvor ein Container oder eine virtuelle Maschine verlassen wurde. Bereits ein verfügbarer Kommunikationskanal kann ausreichen, um Informationen über die vorgesehene Sicherheitsgrenze hinaus zu übertragen. Isolation und Netzwerkzugriff müssen deshalb getrennt betrachtet werden: Eine Anwendung kann auf Prozessebene wirksam isoliert sein und dennoch über Kommunikationswege verfügen, die erhebliche Sicherheitsrisiken eröffnen.
Wenn Werkzeuge mehr dürfen als der Agent sollte
Die Handlungsmöglichkeiten eines KI-Agenten entstehen nicht allein durch seine Ausführungsumgebung. Ebenso entscheidend sind die Werkzeuge und Schnittstellen, die ihm eine Anwendung zur Verfügung stellt. Ein Sprachmodell kann beispielsweise einen PowerShell-Befehl erzeugen, der den Zustand eines Windows-Dienstes überprüft. Ob dieser Befehl tatsächlich ausgeführt wird und welche Systeminformationen er abrufen darf, hängt jedoch von der angebundenen Software und deren Berechtigungen ab. Problematisch wird es, wenn solche Werkzeuge mit umfangreicheren Zugriffsrechten arbeiten, als die eigentliche Aufgabe erfordert. Verwendet eine Anwendung beispielsweise ein privilegiertes Dienstkonto, kann ein Agent unter Umständen Aktionen anfordern, die weit über seinen ursprünglichen Auftrag hinausgehen.
Betrachten wir erneut die fehlgeschlagene Datensicherung: Für die Untersuchung eines Sicherungsproblems kann der lesende Zugriff auf Ereignisprotokolle und Dienstinformationen ausreichen. Besitzt das verwendete Werkzeug jedoch zusätzlich administrative Änderungsrechte, erweitert sich der technisch mögliche Handlungsspielraum erheblich. Dabei kann die Sicherheitsgrenze auch zwischen zwei Komponenten derselben Anwendung verlaufen. Das KI-Modell formuliert eine Werkzeuganforderung, während eine andere Komponente diese entgegennimmt, prüft und gegebenenfalls ausführt.
Hier genügt es nicht, dass die Anwendung dem Modell lediglich mitteilt, bestimmte Befehle seien verboten. Die ausführende Komponente muss selbst überprüfen, ob eine angeforderte Aktion zulässig ist. Dazu gehören beispielsweise die Begrenzung erlaubter Funktionen, eine aufgabenbezogene Berechtigungsvergabe und zusätzliche Freigaben für sicherheitskritische Änderungen. Welche Aktionen tatsächlich möglich sind, bestimmt daher nicht die Aufgabenbeschreibung des Agenten, sondern die effektive Berechtigung der ausführenden Komponenten – und die Kontrollen, die deren Nutzung begrenzen.
Warum eine einzelne Sicherheitsgrenze nicht genügt
Die bisherigen Beispiele verdeutlichen, dass die Sicherheit agentischer Systeme nicht von einer einzigen Schutzfunktion abhängt. Unterschiedliche technische Komponenten begrenzen jeweils andere Aspekte ihrer Handlungsmöglichkeiten. Eine Sandbox kann beispielsweise den Zugriff auf Ressourcen des Hostsystems einschränken, ohne gleichzeitig ausgehende Netzwerkverbindungen zu unterbinden. Ebenso kann eine Anwendung auf Betriebssystemebene isoliert sein, während ein angebundenes Werkzeug weitreichende Berechtigungen in externen IT-Systemen besitzt.
Entscheidend ist deshalb das Zusammenspiel dieser Sicherheitsgrenzen. Ein KI-Agent kann innerhalb seiner vorgesehenen Laufzeitumgebung bleiben und dennoch unerwünschte Aktionen auslösen, wenn externe Schnittstellen oder privilegierte Werkzeuge entsprechende Möglichkeiten eröffnen. Umgekehrt bedeutet das Überwinden einer einzelnen Isolationsgrenze nicht zwangsläufig, dass damit auch sämtliche weiteren Schutzmechanismen außer Kraft gesetzt werden.
Damit wird verständlich, weshalb die öffentliche Diskussion über vermeintlich ausgebrochene KI-Systeme häufig unterschiedliche Sachverhalte vermischt: das Überwinden technischer Isolation, die missbräuchliche Nutzung vorhandener Berechtigungen und unerwartete Handlungen innerhalb eines grundsätzlich erlaubten Funktionsumfangs. Die entscheidende Sicherheitsfrage lautet deshalb nicht allein, ob ein KI-Agent seine Sandbox verlassen kann. Ebenso wichtig ist, welche Möglichkeiten ihm bereits innerhalb dieser Umgebung offenstehen und welche Systeme er von dort aus erreichen kann.
Aus dieser Erkenntnis ergibt sich die Notwendigkeit einer mehrschichtigen Sicherheitsarchitektur. Dieses als Defense in Depth bezeichnete Prinzip verbindet unterschiedliche Schutzmechanismen, sodass die Wirksamkeit des Gesamtsystems nicht allein von einer einzelnen Sicherheitsgrenze abhängt. Wie sich daraus konkrete Sicherheitsstrategien für agentische KI-Systeme ableiten lassen, betrachten wir später im Kapitel ‚Wer kontrolliert die Kontrolleure?‘.
Doch technische Zugriffsmöglichkeiten sind nur eine Seite des Problems. Ein KI-Agent kann auch dann zum Sicherheitsrisiko werden, wenn seine vorgesehenen technischen Isolationsgrenzen nicht überwunden werden. Im nächsten Kapitel untersuchen wir deshalb, wie manipulierte Informationen seine Entscheidungen und Handlungsschritte beeinflussen können.
Zwischen hilfreichem Werkzeug und Angriffsvektor
Ein KI-Agent kann innerhalb seiner technischen Sicherheitsgrenzen arbeiten und dennoch zum Ausgangspunkt eines Sicherheitsvorfalls werden. Dafür muss weder ein Container verlassen noch eine Schwachstelle im Betriebssystem ausgenutzt werden. Unter Umständen genügt es bereits, dass der Agent manipulierte Informationen verarbeitet und daraus unerwünschte Handlungsschritte ableitet. Diese Gefahr entsteht durch eine Besonderheit sprachmodellbasierter Anwendungen: Sie verarbeiten natürliche Sprache sowohl als Gegenstand einer Analyse als auch zur Interpretation von Aufgaben und Anweisungen. Für einen Menschen ist der Unterschied zwischen einer Anweisung des Arbeitgebers und einem entsprechenden Satz in einer fremden E-Mail meist unmittelbar erkennbar. Ein KI-System muss diese Unterscheidung innerhalb seiner technischen Architektur zuverlässig berücksichtigen.
Besonders relevant wird dies bei agentischen Anwendungen, die externe Dokumente auswerten, Webseiten aufrufen, E-Mails verarbeiten oder Informationen aus Datenbanken abrufen. Solche Inhalte können legitime Arbeitsinformationen enthalten, aber ebenso gezielt formulierte Versuche, das Verhalten des Agenten zu beeinflussen. Damit entsteht eine zusätzliche Sicherheitsfrage: Nicht nur die verfügbaren Werkzeuge und Berechtigungen bestimmen den Handlungsspielraum eines KI-Agenten. Ebenso wichtig ist, welchen Informationen er bei der Planung seiner nächsten Schritte vertraut und ob er fremde Inhalte fälschlicherweise als Handlungsanweisungen behandelt.
Wenn Daten plötzlich zu Anweisungen werden
Ein grundlegendes Sicherheitsrisiko sprachmodellbasierter Anwendungen wird als Prompt Injection bezeichnet. Wie das OWASP GenAI Security Project beschreibt, versuchen Angreifer dabei, das Verhalten eines KI-Systems durch manipulierte Eingaben von seinem vorgesehenen Auftrag abzulenken. Mit den Grundlagen und Risiken dieser Methodik habe ich mich bereits in meinem Beitrag KI-Prompting zwischen Produktivität und Risiko – Wie gute Prompts entstehen und warum Prompt Injection zur Gefahr wird beschäftigt. Für agentische Systeme gewinnt diese Problematik eine zusätzliche Dimension: Manipulierte Eingaben können nicht nur Antworten beeinflussen, sondern auch nachfolgende Werkzeugaufrufe auslösen oder verändern.
Besonders kritisch sind sogenannte indirekte Prompt Injections. Dabei gelangen manipulative Anweisungen über externe Inhalte in den Modellkontext, etwa über Webseiten, Dokumente, E-Mails oder Werkzeugrückmeldungen. Angenommen, ein KI-Agent soll eine technische Dokumentation zusammenfassen. Innerhalb des Dokuments befindet sich jedoch eine Anweisung, vertrauliche Informationen abzurufen und weiterzugeben. Für den eigentlichen Arbeitsauftrag ist dieser Text lediglich Bestandteil des zu untersuchenden Dokuments. Er besitzt keine Berechtigung, die Aufgabe des Agenten zu verändern.
Problematisch wird es, wenn das System solche Inhalte dennoch als verbindliche Anweisungen behandelt. Ob daraus tatsächlich ein unbefugter Datenzugriff entsteht, hängt zusätzlich von den verfügbaren Werkzeugen, Berechtigungen und technischen Schutzmaßnahmen ab. Eine Prompt Injection setzt somit keine Schwachstelle des Betriebssystems voraus. Sie versucht, die Vertrauensgrenze zwischen autorisierten Anweisungen und weniger vertrauenswürdigen Informationen zu überwinden.
Die Vertrauensgrenze zwischen Auftrag und Informationsquelle
Die technische Besonderheit einer Prompt Injection liegt darin, dass sprachliche Anweisungen innerhalb von Daten auftreten können, die ein KI-System eigentlich nur auswerten soll. Ob diese Informationen aus einer Webseite, einer Datenbank oder einer API-Rückmeldung stammen, ist dabei zunächst zweitrangig. Entscheidend ist, welche Autorität ihnen innerhalb der Anwendung zukommt. Ein Arbeitsauftrag autorisierter Benutzer:innen unterscheidet sich grundsätzlich von einem fremden Dokument, das der Agent im Rahmen dieses Auftrags verarbeitet.
Diese Unterscheidung greift das Konzept der Instruction Hierarchy auf. OpenAI beschreibt damit eine Priorisierung von Anweisungen unterschiedlicher Herkunft. Übergeordnete Vorgaben der System- beziehungsweise Plattformebene haben Vorrang vor Anweisungen der Entwickler:innen und Benutzer:innen. Inhalte aus Werkzeugrückmeldungen oder anderen nicht vertrauenswürdigen Quellen besitzen dagegen keine vergleichbare Anweisungsautorität. Eine Anweisung innerhalb einer Werkzeugrückmeldung darf deshalb nicht allein durch ihre Formulierung die ursprünglichen Vorgaben außer Kraft setzen. Auch ein Dokument erhält keine zusätzliche Autorität, nur weil es beispielsweise behauptet, eine neue Systemanweisung zu enthalten.
Allerdings lässt sich diese Grenze nicht allein durch weitere Aufforderungen an das Sprachmodell zuverlässig absichern. Bei komplexen Aufgaben treffen autorisierte Anweisungen und weniger vertrauenswürdige Informationen innerhalb desselben Verarbeitungskontexts aufeinander. Selbst ein auf die Einhaltung der Anweisungshierarchie trainiertes Modell kann dabei Fehler machen. Deshalb müssen Anwendungen zusätzlich kontrollieren, welche Werkzeuge ein Agent verwenden darf und welche Aktionen tatsächlich ausgeführt werden. Besonders sicherheitskritische Funktionen sollten nicht allein aufgrund einer vom Modell erzeugten Werkzeuganforderung ausgeführt werden.
Für agentische Systeme ist diese Unterscheidung entscheidend: Übernimmt das Modell eine fremde Anweisung, kann dies nicht nur seine Antwort verändern, sondern auch nachfolgende Werkzeugaufrufe beeinflussen. Aus einer manipulierten Information kann so eine unerwünschte Aktion entstehen, obwohl der Agent ausschließlich technisch verfügbare Funktionen verwendet.
Wenn ein Diagnoseauftrag zum Angriffspfad wird
Betrachten wir erneut unseren KI-Agenten, der die Ursache einer fehlgeschlagenen Datensicherung untersuchen soll. Im Rahmen seiner Diagnose ruft er Ereignisprotokolle ab, prüft Dienstzustände und wertet zusätzliche Informationen aus einem angebundenen Monitoringdienst aus. Angenommen, eine dieser Informationsquellen enthält einen manipulierten Eintrag. Dieser beschreibt nicht nur einen technischen Fehler, sondern fordert den Agenten zusätzlich auf, einen bestimmten externen Dienst aufzurufen und dort Diagnoseinformationen zu hinterlegen.
Für den Agenten erscheint der Text möglicherweise als Bestandteil der technischen Fehlerbeschreibung. Tatsächlich versucht jedoch eine fremde Informationsquelle, Einfluss auf seine weitere Aufgabenplanung zu nehmen. Besitzt der Agent ein geeignetes Werkzeug für externe HTTP-Anfragen, könnte daraus ein entsprechender Werkzeugaufruf entstehen. Ob dieser tatsächlich ausgeführt wird und welche Daten übertragen werden können, hängt wiederum von den Berechtigungen und technischen Grenzen der angebundenen Komponenten ab.
Ein wirksam abgesichertes System müsste an dieser Stelle mehrere Fragen beantworten: Gehört der externe Dienst zu den erlaubten Kommunikationszielen? Ist die Übermittlung der angeforderten Informationen vom ursprünglichen Auftrag gedeckt? Und darf das verwendete Werkzeug überhaupt Daten an diesen Empfänger übertragen? Diese Prüfungen müssen außerhalb des Sprachmodells erfolgen. Andernfalls könnte die manipulierte Information nicht nur die Planung des Agenten beeinflussen, sondern indirekt auch die Entscheidung über die Zulässigkeit seiner eigenen Aktionen.
Das Beispiel verdeutlicht das Zusammenspiel zweier unterschiedlicher Sicherheitsprobleme: Die Prompt Injection versucht, den Agenten zu einer unerwünschten Handlung zu bewegen. Die technische Umgebung bestimmt, ob diese Handlung möglich ist. Die Manipulation liefert den Anstoß. Die vorhandenen Werkzeuge, Berechtigungen und Sicherheitskontrollen bestimmen die möglichen Auswirkungen.
Vom hilfreichen Werkzeug zum Instrument des Angriffs
Künstliche Intelligenz verändert nicht nur die Arbeitsweise von Administrator:innen und Sicherheitsverantwortlichen. Auch Angreifer:innen können KI-Systeme einsetzen, um bestehende Angriffstechniken vorzubereiten, zu variieren oder teilweise zu automatisieren. Sprachmodelle können beispielsweise Programmcode analysieren, technische Dokumentationen auswerten oder große Informationsmengen strukturieren. Diese Fähigkeiten sind für die defensive IT-Sicherheit wertvoll, können aber ebenso bei der Vorbereitung unerwünschter Aktivitäten eingesetzt werden.
Dabei sollten wir zwischen der Fähigkeit eines KI-Systems und der tatsächlichen Durchführung eines Angriffs unterscheiden. Ein Sprachmodell, das Programmcode erläutert, besitzt dadurch noch keinen Zugriff auf fremde Systeme. Erst durch zusätzliche Werkzeuge, Netzwerkverbindungen und entsprechende Berechtigungen können aus generierten Informationen konkrete technische Aktionen entstehen. Besonders relevant wird diese Unterscheidung bei agentischen Systemen, die mehrere Arbeitsschritte miteinander verbinden. Sie können Ergebnisse auswerten, ihre Vorgehensweise anpassen und weitere Werkzeuge anfordern. Dadurch lassen sich auch sicherheitsrelevante Abläufe stärker automatisieren.
Allerdings ist hier zwischen zwei unterschiedlichen Bedrohungsszenarien zu unterscheiden: Bei einer Prompt Injection versucht eine fremde Informationsquelle, einen eigentlich legitim eingesetzten Agenten zu manipulieren. Beim bewussten Missbrauch setzt eine Person KI dagegen gezielt als Hilfsmittel für eigene unerlaubte Aktivitäten ein. Diese Szenarien können sich überschneiden, besitzen jedoch unterschiedliche Ausgangspunkte und erfordern teilweise unterschiedliche Schutzmaßnahmen. Künstliche Intelligenz muss keine eigenen kriminellen Absichten entwickeln, um Bestandteil eines Angriffs zu werden. Entscheidend ist, wer ihre Fähigkeiten nutzt, welche Ziele verfolgt werden und welche Handlungsmöglichkeiten tatsächlich bestehen.
Dieselbe Technologie auf beiden Seiten der Sicherheitsgrenze
Dass Technologien sowohl für legitime als auch für schädliche Zwecke eingesetzt werden können, ist in der IT-Sicherheit keineswegs neu. Die Unterscheidung zwischen White Hat und Black Hat Hacking verdeutlicht dieses Spannungsfeld seit Langem. Während White-Hat-Hacker mit entsprechender Autorisierung Sicherheitslücken untersuchen und zur Verbesserung der IT-Sicherheit beitragen, nutzen Black-Hat-Hacker vergleichbare Kenntnisse und Werkzeuge für unbefugte Angriffe. Auch künstliche Intelligenz besitzt einen solchen Dual-Use-Charakter. Ein KI-System kann Sicherheitsanalyst:innen bei der Untersuchung verdächtiger Netzwerkaktivitäten unterstützen, fehlerhafte Konfigurationen identifizieren oder Programmcode auf mögliche Schwachstellen untersuchen. Dieselben Analysefähigkeiten können jedoch auch die Vorbereitung und Durchführung von Angriffen erleichtern.
Neu ist deshalb weniger die grundsätzliche Möglichkeit des Missbrauchs als vielmehr das Potenzial, bestimmte Arbeitsschritte schneller und in größerem Umfang durchzuführen. Agentische Systeme können Informationen aus unterschiedlichen Quellen zusammenführen, Ergebnisse bewerten und weitere Analyseschritte eigenständig anstoßen. Davon können sowohl autorisierte Sicherheitsteams als auch Angreifer:innen profitieren. Wie groß der tatsächliche Vorteil ausfällt, hängt allerdings von der jeweiligen Aufgabe, der Zuverlässigkeit des Systems und den verfügbaren Werkzeugen ab. Nicht jeder Arbeitsschritt wird durch den Einsatz von KI automatisch schneller oder erfolgreicher.
Die Technologie allein entscheidet somit nicht über die Legitimität ihres Einsatzes. Maßgeblich sind insbesondere die Autorisierung, die Zielsetzung und die tatsächlich ausgeführten Handlungen. Für Unternehmen und öffentliche Einrichtungen entsteht daraus eine doppelte Herausforderung: Sie müssen KI-gestützte Angriffe in ihrer Bedrohungsanalyse berücksichtigen und gleichzeitig die Möglichkeiten künstlicher Intelligenz für die eigene Sicherheitsarbeit erschließen. KI verändert die Cybersicherheit deshalb nicht ausschließlich durch neue Bedrohungen. Sie verändert auch die Werkzeuge und die Geschwindigkeit, mit denen wir diesen Bedrohungen begegnen können.
Wenn technische Grenzen auf manipulierbare Entscheidungen treffen
Die bisherigen Betrachtungen zeigen, dass die Sicherheit agentischer KI-Systeme von mehreren miteinander verbundenen Faktoren abhängt. Einerseits bestimmen die technische Umgebung, verfügbare Werkzeuge und Berechtigungen, welche Aktionen ein Agent tatsächlich ausführen kann. Andererseits beeinflussen die Informationen, die er verarbeitet, welche Handlungsschritte er innerhalb dieser Möglichkeiten auswählt. Ein KI-Agent kann innerhalb einer wirksam isolierten Umgebung arbeiten und dennoch durch manipulierte Dokumente, Webseiten oder Werkzeugrückmeldungen zu unerwünschten Aktionen verleitet werden. Umgekehrt kann selbst eine korrekt interpretierte Aufgabe problematische Auswirkungen haben, wenn angebundene Komponenten über zu weitreichende Berechtigungen verfügen.
Damit treffen zwei unterschiedliche Risikodimensionen aufeinander: die technische Reichweite eines Systems und die Beeinflussbarkeit seiner Handlungsplanung. Erst ihr Zusammenspiel lässt erkennen, welche Folgen eine manipulierte oder fehlerhafte Entscheidung tatsächlich haben kann. Diese Unterscheidung hilft auch dabei, öffentliche Berichte über vermeintlich ausgebrochene KI-Systeme einzuordnen. Nicht jede unerwartete Aktion bedeutet, dass eine technische Sicherheitsgrenze überwunden wurde. Ebenso wenig lässt sich ein Sicherheitsrisiko allein deshalb ausschließen, weil ein Sprachmodell keine eigenen Absichten besitzt. Gleichzeitig sollten wir künstliche Intelligenz nicht ausschließlich als potenzielle Bedrohung betrachten. Wie die Unterscheidung zwischen White Hat und Black Hat Hacking verdeutlicht, können vergleichbare technische Fähigkeiten sowohl für autorisierte Sicherheitsanalysen als auch für Angriffe eingesetzt werden.
KI erweitert diese Möglichkeiten auf beiden Seiten. Die Herausforderung besteht deshalb nicht darin, die Handlungsfähigkeit künstlicher Intelligenz grundsätzlich zu verhindern, sondern ihre Möglichkeiten verantwortungsvoll nutzbar zu machen und ihre Risiken wirksam zu begrenzen. Doch die Auswirkungen dieser Entwicklung reichen weit über die IT-Sicherheit hinaus. Im nächsten Kapitel betrachten wir, welche Fortschritte künstliche Intelligenz in Wissenschaft, Medizin und Wirtschaft ermöglicht – und welche wirtschaftlichen, gesellschaftlichen und ökologischen Nebenwirkungen damit verbunden sind.
Fortschritt mit Nebenwirkungen
Nach den bisherigen Betrachtungen könnte der Eindruck entstehen, dass die zunehmende Leistungsfähigkeit künstlicher Intelligenz vor allem neue Sicherheitsprobleme hervorbringt. Doch damit würden wir nur eine Seite der technologischen Entwicklung betrachten. Dieselben Fähigkeiten, die KI-Agenten zu einer sicherheitstechnischen Herausforderung machen, eröffnen zugleich Möglichkeiten, die vor wenigen Jahren noch kaum vorstellbar erschienen. Künstliche Intelligenz unterstützt die medizinische Diagnostik, beschleunigt wissenschaftliche Untersuchungen, optimiert industrielle Prozesse und verändert die Entwicklung von Software. Sie kann große Datenbestände analysieren, Zusammenhänge erkennen und Menschen bei Aufgaben unterstützen, deren Komplexität oder Umfang bislang erhebliche Ressourcen erforderte.
Dabei sollten wir allerdings zwischen technologischen Möglichkeiten und tatsächlich nachgewiesenem Nutzen unterscheiden. Nicht jede vielversprechende Demonstration führt unmittelbar zu einer praxistauglichen Anwendung. Und nicht jedes KI-System, das beeindruckende Ergebnisse erzeugt, arbeitet unter realen Bedingungen zuverlässig genug, um ohne zusätzliche Überprüfung eingesetzt zu werden. Hinzu kommt, dass technologischer Fortschritt nicht ohne Voraussetzungen entsteht. Leistungsfähige KI benötigt Rechenzentren, Energie, spezialisierte Hardware, umfangreiche Datenbestände und erhebliche Investitionen. Die damit verbundenen Kosten und Abhängigkeiten bleiben in der öffentlichen Begeisterung häufig im Hintergrund. Die entscheidende Frage lautet deshalb nicht allein, was künstliche Intelligenz künftig leisten kann, sondern unter welchen Bedingungen ihre Möglichkeiten einen tatsächlichen und nachhaltigen Nutzen entfalten.
Wenn künstliche Intelligenz die Forschung beschleunigt
Eine der bemerkenswertesten Entwicklungen findet dort statt, wo künstliche Intelligenz wissenschaftliche Erkenntnisprozesse unterstützt. In der Strukturbiologie können Systeme wie AlphaFold räumliche Proteinstrukturen vorhersagen und damit Forschungsarbeiten erheblich erleichtern. Solche Vorhersagen ersetzen keine experimentelle Überprüfung, ermöglichen aber eine gezieltere Untersuchung wissenschaftlicher Hypothesen.
Wie weit KI-gestützte Forschung inzwischen reichen kann, verdeutlicht eine Veröffentlichung von OpenAI zum Navier-Stokes-Millennium-Preisproblem vom 8. September 2026. OpenAI stellte darin einen mithilfe eines internen KI-Systems entwickelten mathematischen Beweis vor, der nach Darstellung des Unternehmens zeigt, dass Lösungen der dreidimensionalen Navier-Stokes-Gleichungen unter bestimmten Voraussetzungen in endlicher Zeit eine Singularität entwickeln können. Neben der mathematischen Ausarbeitung veröffentlichte OpenAI eine Formalisierung in der Beweissoftware Lean.
Das Ergebnis ist bemerkenswert, sollte jedoch sorgfältig eingeordnet werden. Eine Formalisierung in Lean ermöglicht die maschinelle Prüfung eines mathematischen Beweises innerhalb der zugrunde gelegten formalen Annahmen. Sie ersetzt allerdings nicht die unabhängige wissenschaftliche Bewertung, ob die Formalisierung sämtliche Voraussetzungen und den vollständigen Geltungsbereich des ursprünglichen Problems korrekt erfasst. Auch eine mögliche Anerkennung als Lösung eines Millennium-Preisproblems unterliegt eigenen wissenschaftlichen und institutionellen Anforderungen.
Besonders interessant ist die Arbeitsweise. Nach Angaben von OpenAI waren in der erfolgreichen Agentengruppe zeitweise rund 10.000 KI-Agenten gleichzeitig aktiv. Sie untersuchten unterschiedliche Lösungsansätze, tauschten Zwischenergebnisse aus und nutzten Werkzeuge zur mathematischen Problembearbeitung. Das Beispiel verdeutlicht damit nicht nur das Potenzial leistungsfähiger KI-Modelle, sondern auch die Bedeutung der technischen Systeme, in denen diese Modelle koordiniert zusammenarbeiten.
Auch in der Medizin unterstützen KI-Verfahren bereits die Auswertung bildgebender Untersuchungen und die Erkennung auffälliger Muster. Ihr tatsächlicher Nutzen hängt jedoch von einer sorgfältigen klinischen Validierung, geeigneten Einsatzbedingungen und einer verantwortlichen Einbindung in medizinische Entscheidungsprozesse ab. KI ersetzt damit nicht die wissenschaftliche Methode. Sie erweitert die Möglichkeiten, Hypothesen zu entwickeln, komplexe Probleme zu untersuchen und neue Erkenntnisse zu gewinnen. Entscheidend bleibt, dass auch außergewöhnliche Ergebnisse unabhängig überprüfbar sein müssen.
Produktivität entsteht nicht allein durch Automatisierung
Auch in Unternehmen verändert künstliche Intelligenz zunehmend die Art und Weise, wie Informationen verarbeitet und Aufgaben erledigt werden. Sprachmodelle unterstützen bei der Erstellung von Dokumentationen, der Analyse von Daten, der Entwicklung von Software oder der Vorbereitung administrativer Entscheidungen. Mit agentischen Systemen kommt eine weitere Möglichkeit hinzu: Einzelne Arbeitsschritte lassen sich zu zusammenhängenden Abläufen verbinden. Ein KI-Agent kann beispielsweise Informationen aus einem Ticketsystem abrufen, technische Zusammenhänge analysieren und geeignete Maßnahmen vorbereiten. Damit verschiebt sich der Einsatz von KI von der Unterstützung einzelner Tätigkeiten zur Bearbeitung komplexerer Prozesse.
Allerdings entsteht Produktivität nicht automatisch dadurch, dass möglichst viele Arbeitsschritte automatisiert werden. Fehlerhafte Ergebnisse, unklare Zuständigkeiten oder aufwendige Nachkontrollen können einen vermeintlichen Zeitgewinn schnell wieder aufzehren. Ebenso können schlecht integrierte KI-Anwendungen bestehende Arbeitsabläufe komplizierter machen, statt sie zu vereinfachen.
Entscheidend ist deshalb, ob eine Anwendung tatsächlich zur Qualität, Geschwindigkeit oder Zuverlässigkeit eines Prozesses beiträgt. Dabei sollten Unternehmen nicht nur die unmittelbare Bearbeitungszeit betrachten, sondern auch die Kosten für Einführung, Betrieb, Qualitätssicherung und mögliche Fehlerkorrekturen berücksichtigen. Dafür müssen sie sowohl die Leistungsfähigkeit des eingesetzten Modells als auch die Anforderungen ihrer eigenen Arbeitsabläufe verstehen. Der wirtschaftliche Nutzen künstlicher Intelligenz entsteht nicht durch Automatisierung um ihrer selbst willen, sondern durch eine sinnvolle Verbindung technologischer Fähigkeiten mit konkreten betrieblichen Anforderungen.
Die unsichtbare Infrastruktur hinter der künstlichen Intelligenz
Wer mit einem modernen KI-System arbeitet, sieht zunächst eine vergleichsweise einfache Benutzeroberfläche. Eine Frage wird gestellt, eine Antwort erscheint. Welche technische Infrastruktur dafür erforderlich ist, bleibt meist unsichtbar. Hinter dieser scheinbaren Leichtigkeit steht jedoch eine komplexe industrielle Infrastruktur. Leistungsfähige KI-Dienste benötigen spezialisierte Beschleuniger, schnelle Netzwerkverbindungen, umfangreiche Speichersysteme und verteilte Rechenzentrumsarchitekturen. Hinzu kommen eine zuverlässige Stromversorgung, leistungsfähige Kühlsysteme und technische Komponenten, die einen möglichst unterbrechungsfreien Betrieb ermöglichen.
Welche Dimensionen diese Entwicklung inzwischen erreicht, habe ich bereits in meinem Beitrag KI im Gigawatt-Zeitalter – Wie OpenAI, AMD, NVIDIA und Broadcom die Energiefrage neu schreiben näher betrachtet. Die dort untersuchten Entwicklungen verdeutlichen, dass die Leistungsfähigkeit moderner KI längst nicht mehr ausschließlich von Algorithmen und Modellarchitekturen abhängt. Der Ausbau entsprechender Rechenkapazitäten wird zunehmend zu einer industriellen und energiepolitischen Herausforderung. Dabei erfordert nicht nur das Training großer Modelle erhebliche Investitionen. Auch ihr laufender Betrieb beansprucht Rechenleistung, deren Umfang unter anderem von der Modellgröße, der Anzahl gleichzeitiger Anfragen und der Komplexität der Verarbeitung abhängt. Bei agentischen Anwendungen können zusätzliche Werkzeugaufrufe, längere Verarbeitungsketten und wiederholte Modellanfragen den Ressourcenbedarf weiter erhöhen.
Kleine, lokal betriebene Modelle besitzen deshalb ein anderes technisches und wirtschaftliches Anforderungsprofil als große, cloudbasierte KI-Systeme. Welche Architektur sinnvoll ist, hängt von den konkreten Anforderungen an Leistung, Datenschutz, Verfügbarkeit und Wirtschaftlichkeit ab. Künstliche Intelligenz entsteht nicht allein aus Algorithmen und Daten. Sie benötigt eine leistungsfähige industrielle Infrastruktur, deren Verfügbarkeit und Kosten zunehmend darüber entscheiden, wer moderne KI-Technologien entwickeln, betreiben und wirtschaftlich nutzen kann.
Wenn Rechenleistung zur wirtschaftlichen Machtfrage wird
Die technischen Anforderungen moderner KI-Systeme haben unmittelbare wirtschaftliche Folgen. Die Entwicklung besonders leistungsfähiger Modelle erfordert häufig Investitionen, die nur wenige Unternehmen oder staatlich unterstützte Einrichtungen in vergleichbarem Umfang aufbringen können. Wer über Rechenzentren, spezialisierte Hardware und leistungsfähige Entwicklungsplattformen verfügt, verschafft sich damit erhebliche Wettbewerbsvorteile. Diese Abhängigkeiten betreffen jedoch nicht nur die Entwickler:innen großer Sprachmodelle. Auch Unternehmen, die KI in ihre Geschäftsprozesse integrieren möchten, müssen über Cloudplattformen, Modellanbieter und langfristige Betriebskosten entscheiden. Externe KI-Dienste können wirtschaftlich sinnvoll sein. Problematisch wird es, wenn technische Bindungen, proprietäre Schnittstellen oder fehlende Alternativen einen späteren Anbieterwechsel erheblich erschweren.
Dass Rechenleistung inzwischen auch zu einer wirtschaftspolitischen Frage geworden ist, zeigen die aktuellen Pläne der Bundesregierung. Wie das Handelsblatt am 15. Oktober 2026 berichtete, bereitet die Bundesregierung unter Bundeskanzler Friedrich Merz eine umfangreiche Kooperation mit NVIDIA und weiteren Unternehmen vor. Die Initiative soll insbesondere industrielle KI-Anwendungen fördern. Dazu gehören sogenannte Physical AI für Robotik und autonome Fahrzeuge sowie leistungsfähige KI-Modelle für industrielle Einsatzbereiche. Nach bisheriger Berichterstattung ist dafür eine staatliche Anschubfinanzierung im dreistelligen Millionenbereich vorgesehen, unter anderem zur Bereitstellung von Rechenkapazitäten und zum Training entsprechender Modelle.
Die offizielle Vorstellung wird für den Investitionsgipfel Invest in Germany erwartet. Zum Zeitpunkt dieser Betrachtung handelt es sich somit um ein angekündigtes Vorhaben, dessen konkrete Umsetzung und langfristige Wirkung noch nicht abschließend beurteilt werden können. Die angestrebte Zusammenarbeit verdeutlicht zugleich ein strategisches Spannungsfeld: Deutschland möchte seine eigene Handlungsfähigkeit im KI-Bereich stärken, bleibt beim Aufbau leistungsfähiger Infrastruktur jedoch auf Technologien internationaler Anbieter angewiesen.
Zusätzliche Rechenkapazitäten im eigenen Land können den Zugang zu KI-Technologie verbessern und die Kontrolle über bestimmte Betriebs- und Datenverarbeitungsprozesse stärken. Sie bedeuten aber noch keine vollständige Unabhängigkeit von ausländischen Hardwareherstellern, Softwareplattformen oder Lieferketten. Rechenleistung entwickelt sich damit von einer technischen Ressource zu einem entscheidenden Faktor wirtschaftlicher Wettbewerbsfähigkeit. Ob daraus auch größere technologische Souveränität entsteht, hängt davon ab, wie beherrschbar die damit verbundenen Abhängigkeiten bleiben.
Der ökologische Preis digitaler Intelligenz
Die zunehmende Verbreitung künstlicher Intelligenz wirft auch ökologische Fragen auf. Rechenzentren benötigen elektrische Energie, leistungsfähige Hardware muss hergestellt werden und die entstehende Abwärme erfordert geeignete Kühlsysteme. Mit diesen Zusammenhängen habe ich mich bereits ausführlicher in meinem Beitrag KI unter Strom – Der ökologische Fußabdruck intelligenter Systeme beschäftigt.
Wie hoch die tatsächliche Umweltbelastung ausfällt, lässt sich allerdings nicht mit einer pauschalen Zahl für jede KI-Anfrage beschreiben. Der Energiebedarf hängt unter anderem von der Modellarchitektur, der eingesetzten Hardware, der Auslastung des Rechenzentrums und dem Umfang der jeweiligen Verarbeitung ab. Auch der Strommix, die Kühlung und der Wasserbedarf beeinflussen die ökologische Gesamtbilanz. Dabei sollten wir zwischen dem unmittelbaren Energieverbrauch einer Anwendung, dem Betrieb der erforderlichen Rechenzentrumsinfrastruktur und den Umweltwirkungen über den gesamten Lebenszyklus der eingesetzten Hardware unterscheiden. Hinzu kommen Ressourcen, die bereits vor dem eigentlichen Betrieb benötigt werden. Die Herstellung leistungsfähiger Halbleiter beansprucht Energie, Wasser und Rohstoffe. Werden Beschleuniger und Server aufgrund kurzer Innovationszyklen frühzeitig ersetzt, entstehen zusätzliche Umweltbelastungen.
Gleichzeitig kann KI selbst zur effizienteren Ressourcennutzung beitragen. Anwendungen zur Optimierung industrieller Prozesse, zur Steuerung von Energiesystemen oder zur Analyse komplexer Verbrauchsmuster können Einsparpotenziale erschließen. Allerdings müssen solche Effizienzgewinne auch im Verhältnis zu einem möglicherweise steigenden Gesamtverbrauch betrachtet werden. Werden durch effizientere Verfahren zusätzliche Anwendungen wirtschaftlich attraktiv, kann ein Teil der Einsparungen durch die zunehmende Nutzung wieder aufgezehrt werden. Dieser Zusammenhang wird als Rebound-Effekt bezeichnet.
Eine seriöse Bewertung muss deshalb beide Seiten berücksichtigen: die Ressourcen, die für Entwicklung und Betrieb künstlicher Intelligenz erforderlich sind, und die ökologischen Einsparungen, die durch ihren Einsatz tatsächlich entstehen. Nicht jede KI-Anwendung ist automatisch nachhaltig. Entscheidend ist, ob ihr nachweisbarer Nutzen den damit verbundenen Ressourcenaufwand rechtfertigt.
Fortschritt braucht mehr als leistungsfähige Modelle
Die bisherigen Beispiele verdeutlichen, weshalb künstliche Intelligenz zu den bedeutendsten technologischen Entwicklungen unserer Zeit zählt. Sie kann wissenschaftliche Erkenntnisprozesse beschleunigen, medizinische Untersuchungen unterstützen und betriebliche Abläufe effizienter gestalten. Dabei reichen ihre Möglichkeiten inzwischen von der Analyse komplexer Datenbestände bis zur Unterstützung mathematischer Forschung und zur eigenständigen Bearbeitung mehrstufiger Aufgaben.
Doch technologischer Fortschritt lässt sich nicht allein an der Leistungsfähigkeit eines KI-Modells messen. Entscheidend ist ebenso, unter welchen wirtschaftlichen, technischen und ökologischen Bedingungen seine Fähigkeiten tatsächlich nutzbar werden. Leistungsfähige Rechenzentren, spezialisierte Halbleiter, eine zuverlässige Energieversorgung und erhebliche Investitionen bilden dafür wesentliche Voraussetzungen. Die aktuellen Bestrebungen der Bundesregierung zur Zusammenarbeit mit NVIDIA verdeutlichen, dass diese Fragen längst auf der politischen Agenda angekommen sind. Der geplante Ausbau industrieller KI-Rechenkapazitäten soll die Wettbewerbsfähigkeit Deutschlands stärken und die Entwicklung eigener KI-Anwendungen ermöglichen. Gleichzeitig zeigt diese Initiative, wie eng nationale Technologiepolitik mit den Produkten und Plattformen internationaler Anbieter verflochten ist.
Damit entsteht ein Spannungsfeld, das weit über die Wirtschaftlichkeit einzelner KI-Anwendungen hinausreicht. Unternehmen und Staaten müssen entscheiden, welche technologischen Fähigkeiten sie selbst aufbauen, welche Infrastruktur sie kontrollieren und welche Abhängigkeiten sie langfristig akzeptieren wollen. Die Zukunft künstlicher Intelligenz entscheidet sich deshalb nicht allein in Forschungslaboren. Sie hängt ebenso davon ab, wer über die notwendige Infrastruktur verfügt, wer ihre Nutzungsmöglichkeiten bestimmt und wer die damit verbundenen Kosten und Abhängigkeiten trägt. Gerade für Deutschland und Europa führt uns diese Entwicklung zu einer grundlegenden Frage: Wie souverän kann eine eigene KI-Strategie sein, wenn wesentliche Bestandteile ihrer technischen Grundlage weiterhin von außereuropäischen Unternehmen bereitgestellt werden?

Exkurs: Digitale Souveränität auf amerikanischen Chips – Deutschlands KI-Dilemma
Mehr Unabhängigkeit – mit NVIDIA?
Deutschland möchte bei der künstlichen Intelligenz technologisch unabhängiger werden. Eigene Rechenkapazitäten sollen entstehen, industrielle KI-Anwendungen gefördert und die Wettbewerbsfähigkeit des Wirtschaftsstandorts gestärkt werden. So weit, so nachvollziehbar. Doch ausgerechnet bei der technischen Grundlage dieser Bestrebungen zeigt sich ein bemerkenswertes Spannungsfeld: Wer heute leistungsfähige KI-Infrastruktur aufbauen möchte, kommt an amerikanischen Technologieunternehmen kaum vorbei.
Ein aktuelles Beispiel liefert die von Bundeskanzler Friedrich Merz angestrebte Kooperation mit NVIDIA, über die das Handelsblatt berichtet. Die Bundesregierung möchte zusätzliche Rechenkapazitäten für industrielle KI-Anwendungen erschließen und damit die technologische Handlungsfähigkeit Deutschlands verbessern. Für die dafür benötigte Beschleunigerhardware setzt sie jedoch auf einen Hersteller aus den Vereinigten Staaten.
Ist das nun ein Schritt in Richtung digitaler Souveränität oder lediglich die Verlagerung bestehender Abhängigkeiten in deutsche Rechenzentren?
Ein deutsches Rechenzentrum macht noch keine deutsche Technologie
Die Antwort hängt davon ab, was wir unter Souveränität verstehen. Ein Rechenzentrum auf deutschem Boden kann Vorteile bei Datenhaltung, Sicherheit und Kontrolle bieten. Voraussetzung ist allerdings, dass auch die Betriebsorganisation, die administrativen Zugriffsrechte und die rechtlichen Rahmenbedingungen entsprechend gestaltet sind. Ebenso können eigene KI-Modelle oder offene Modellarchitekturen Abhängigkeiten von einzelnen Anbietern reduzieren.
In meinen Microsoft-365-Seminaren begegnet mir regelmäßig eine Frage: Wie souverän ist eigentlich ein deutscher Microsoft-365-Tenant, wenn Microsoft Corporation ihren Sitz in den Vereinigten Staaten hat? Microsoft bietet mit der EU Data Boundary umfangreiche Zusagen zur europäischen Datenhaltung und -verarbeitung. Ergänzend ermöglichen Advanced Data Residency und weitere Souveränitätskontrollen zusätzliche Schutzmaßnahmen. Allerdings gelten diese Zusagen für bestimmte Dienste und Datenkategorien; Ausnahmen und spezifische Verarbeitungsbedingungen sind dokumentiert.
Datenresidenz bedeutet deshalb noch keine vollständige Kontrolle über Betrieb, Technologie und rechtliche Rahmenbedingungen. Ebenso wenig lässt sich aus dem amerikanischen Unternehmenssitz automatisch ein uneingeschränkter Behördenzugriff auf europäische Kundendaten ableiten. Solche Fragen hängen unter anderem von den anwendbaren Rechtsgrundlagen, den tatsächlichen Zugriffsmöglichkeiten und den vorhandenen technischen sowie organisatorischen Schutzmaßnahmen ab.
Ähnliches gilt für deutsche KI-Rechenzentren. Beschleuniger stammen beispielsweise von NVIDIA, Prozessoren von AMD oder Intel und wesentliche Softwarekomponenten von internationalen Herstellern. Hinzu kommen globale Lieferketten, Entwicklungswerkzeuge und spezialisierte Plattformen, deren Verfügbarkeit sich nicht allein durch den Standort eines Rechenzentrums beeinflussen lässt. Gerade herstellerspezifische Softwareökosysteme können langfristige Bindungen schaffen. NVIDIA liefert schließlich nicht nur Beschleunigerhardware. Mit CUDA und darauf aufbauenden Bibliotheken stellt das Unternehmen auch eine weitverbreitete Entwicklungs- und Ausführungsumgebung bereit.
Wer KI-Anwendungen eng an solche Technologien koppelt, muss bei einem späteren Hardwarewechsel möglicherweise erhebliche Anpassungen vornehmen – selbst wenn die verwendeten KI-Modelle offen verfügbar sind. Ob Microsoft 365 oder ein deutsches KI-Rechenzentrum: Der Standort der Daten ist ein wichtiger Baustein digitaler Souveränität. Entscheidend bleibt, wer die Technologie kontrolliert, wer auf sie zugreifen kann und welche realistischen Alternativen bestehen.
Souveränität bedeutet nicht vollständige Unabhängigkeit
Aus dem Beispiel mit Microsoft 365 lässt sich eine wichtige Erkenntnis ableiten: Internationale Zusammenarbeit und digitale Souveränität müssen kein Widerspruch sein. Moderne IT-Infrastrukturen entstehen längst in globalen Wertschöpfungsketten. Das gilt für Cloudplattformen ebenso wie für die Halbleiterindustrie, an der auch europäische Unternehmen wesentlich beteiligt sind. Eine vollständige technologische Eigenständigkeit Deutschlands wäre deshalb weder kurzfristig realistisch noch in jedem Bereich wirtschaftlich sinnvoll. Entscheidend ist vielmehr, welche Abhängigkeiten wir bewusst eingehen und welche Handlungsspielräume uns dabei erhalten bleiben.
Können Unternehmen ihre Daten und Anwendungen zu anderen Anbietern übertragen? Lassen sich KI-Modelle auf unterschiedlichen Plattformen betreiben? Sind kritische Geschäftsprozesse auch dann noch funktionsfähig, wenn ein Dienst ausfällt, ein Anbieter seine Geschäftsbedingungen verändert oder bestimmte Technologien nicht mehr verfügbar sind? Solche Fragen kennen Administrator:innen bereits aus der klassischen Cloudstrategie. Bei KI-Systemen gewinnen sie zusätzlich an Bedeutung, weil neben der Datenhaltung auch Modellarchitekturen, spezialisierte Hardware und herstellerspezifische Entwicklungsumgebungen berücksichtigt werden müssen.
Dabei ist nicht jede Abhängigkeit gleichermaßen problematisch. Eine proprietäre Technologie kann wirtschaftliche oder technische Vorteile bieten, die ihren Einsatz rechtfertigen. Kritisch wird es vor allem dann, wenn ein späterer Wechsel unverhältnismäßig aufwendig wird oder wesentliche Geschäftsprozesse von Entscheidungen abhängen, auf die das eigene Unternehmen kaum Einfluss nehmen kann. Vor diesem Hintergrund ist auch die geplante Zusammenarbeit der Bundesregierung mit NVIDIA differenziert zu betrachten.
Zusätzliche Rechenkapazitäten können Forschung und Industrie stärken, eigenes technisches Know-how fördern und die Abhängigkeit von vollständig extern betriebenen KI-Diensten verringern. Sie beseitigen jedoch nicht automatisch die Bindung an die Hersteller der eingesetzten Beschleuniger und Softwareplattformen. Digitale Souveränität bedeutet daher nicht, auf internationale Technologien verzichten zu müssen. Sie bedeutet, deren Einsatz so zu gestalten, dass Abhängigkeiten erkennbar, beherrschbar und nach Möglichkeit veränderbar bleiben.
Die entscheidende Frage ist, wer die Kontrolle behält
Vielleicht liegt genau darin die eigentliche Herausforderung deutscher und europäischer KI-Politik. Wir werden nicht jede technologische Abhängigkeit vermeiden können. Das gelingt bereits bei etablierten Cloudplattformen nur eingeschränkt und dürfte bei hochspezialisierter KI-Hardware kaum einfacher werden. Umso wichtiger ist es, zwischen dem Besitz einer Infrastruktur und der tatsächlichen Kontrolle über ihren Betrieb zu unterscheiden.
Ein deutsches Rechenzentrum schafft zunächst eigene Kapazitäten. Ob daraus langfristige Handlungsfähigkeit entsteht, hängt jedoch auch davon ab, wer die eingesetzten Systeme verwaltet, welche Softwareabhängigkeiten bestehen und welche Alternativen im Bedarfsfall verfügbar sind. Für Unternehmen stellt sich diese Frage bei der Auswahl ihrer Cloud- und KI-Plattformen. Für die Politik geht es darüber hinaus um die Fähigkeit, Forschung, Wirtschaft und öffentliche Einrichtungen auch unter veränderten internationalen Rahmenbedingungen mit leistungsfähiger Technologie zu versorgen.
Dazu gehört nicht zwangsläufig, sämtliche Komponenten selbst entwickeln oder herstellen zu müssen. Ebenso wichtig sind die Fähigkeit zum eigenständigen Betrieb, die Verfügbarkeit technischer Kompetenzen, die Kontrolle über kritische Daten und die Möglichkeit, bei veränderten Rahmenbedingungen auf alternative Lösungen auszuweichen. Die eigentliche Gefahr liegt deshalb nicht zwangsläufig in einer bestehenden Abhängigkeit, sondern darin, ihre Tragweite zu unterschätzen.
Wer technische Entscheidungen ausschließlich anhand kurzfristiger Leistungsfähigkeit oder Wirtschaftlichkeit trifft, könnte später feststellen, dass ein Anbieterwechsel zwar theoretisch möglich, praktisch aber kaum noch zu bewältigen ist. Digitale Souveränität entscheidet sich nicht allein daran, wo ein Rechenzentrum steht oder wo ein Unternehmen seinen Hauptsitz hat. Entscheidend ist, welche Kontrolle wir tatsächlich ausüben können, welche Abhängigkeiten wir akzeptieren und ob uns auch unter veränderten Bedingungen tragfähige Alternativen bleiben.
Wenn Maschinen mitdenken und Menschen weniger nachdenken
Künstliche Intelligenz verändert nicht nur die Möglichkeiten technischer Systeme, sondern zunehmend auch unser eigenes Verhalten. Informationen, für deren Recherche wir früher mehrere Quellen durchsehen mussten, erscheinen heute innerhalb weniger Sekunden als zusammenhängende Antwort. Texte werden formuliert, Programmcode wird vorgeschlagen und komplexe Sachverhalte lassen sich in verständlicher Sprache erklären. Das ist zunächst ein erheblicher Fortschritt. KI kann Menschen entlasten, den Zugang zu Wissen erleichtern und neue Möglichkeiten des Lernens eröffnen. Gerade bei anspruchsvollen Aufgaben kann sie helfen, Zusammenhänge schneller zu erfassen oder unterschiedliche Lösungsansätze zu entwickeln.
Doch mit dieser Unterstützung verändert sich auch die Art, wie wir Aufgaben bearbeiten. Wenn eine Maschine Informationen nicht nur bereitstellt, sondern bereits bewertet, strukturiert und zu einer scheinbar schlüssigen Antwort zusammenführt, entfällt möglicherweise ein Teil jener gedanklichen Arbeit, durch die wir uns bislang Wissen und Verständnis angeeignet haben. Dabei geht es nicht darum, technologische Unterstützung grundsätzlich infrage zu stellen. Menschen nutzen seit jeher Werkzeuge, um ihre geistigen Fähigkeiten zu erweitern. Taschenrechner, Suchmaschinen und Navigationssysteme haben längst verändert, welche Aufgaben wir selbst übernehmen und welche wir technischen Hilfsmitteln überlassen.
Bei generativer KI kommt allerdings eine Besonderheit hinzu: Sie liefert nicht nur Daten oder berechnet Ergebnisse, sondern erzeugt sprachlich überzeugende Erklärungen, Empfehlungen und Entscheidungen. Die entscheidende Frage lautet deshalb nicht, ob wir mit künstlicher Intelligenz weniger arbeiten müssen, sondern welche Fähigkeiten wir weiterhin selbst entwickeln und einsetzen sollten, um ihre Ergebnisse verstehen und beurteilen zu können.
Wenn wir das Denken auslagern
In der Kognitionswissenschaft bezeichnet Cognitive Offloading die Verlagerung geistiger Aufgaben auf externe Hilfsmittel. Das Prinzip ist keineswegs neu. Ein persönliches Beispiel verdeutlicht es: Ich kenne noch heute die Telefonnummer meiner Großmutter, die vor rund 30 Jahren verstorben ist. Auch die seit Jahrzehnten unveränderten Festnetznummern meiner Mutter und meiner Tanten habe ich im Kopf. Früher musste ich sie schlicht auswendig kennen. Die Mobilfunknummern meiner Frau und meiner Töchter kenne ich dagegen nicht. Nicht, weil sie mir weniger wichtig wären, sondern weil ich sie nie lernen musste. Ein Fingertipp genügt. Das Smartphone übernimmt eine Gedächtnisleistung, die früher selbstverständlich war. Ähnlich entlasten uns Navigationssysteme und Tabellenkalkulationen.
Generative KI geht allerdings weiter. Sie speichert nicht nur Informationen oder übernimmt Berechnungen, sondern entwickelt Argumentationen, erklärt Zusammenhänge und formuliert Lösungsvorschläge. Damit können wir auch Teile unseres eigentlichen Denkprozesses auslagern. Das ist nicht zwangsläufig problematisch. KI kann neue Perspektiven eröffnen und eigene Überlegungen hinterfragen helfen. Übernehmen wir Antworten jedoch ungeprüft, verfügen wir möglicherweise über ein Ergebnis, ohne dessen Zusammenhänge verstanden zu haben.
Gerade in der beruflichen Weiterbildung zeigt sich deshalb eine interessante Verschiebung: Geeignete Fragen zu formulieren, gewinnt an Bedeutung. Gleichzeitig bleibt Fachwissen unverzichtbar, um die erhaltenen Antworten kritisch beurteilen zu können. Kognitive Entlastung wird dann problematisch, wenn wir nicht nur Arbeitsschritte auslagern, sondern auch auf das Verständnis verzichten, das für ihre Bewertung notwendig ist.
Wenn überzeugende Antworten ungeprüft bleiben
Eine weitere Herausforderung entsteht durch unsere Neigung, technischen Systemen zu vertrauen. In der Forschung wird dieses Phänomen als Automation Bias beschrieben: Menschen können dazu tendieren, automatisierte Empfehlungen zu übernehmen, obwohl Hinweise auf Fehler vorliegen. In meinen Prüfungsvorbereitungen für angehende Fachinformatiker:innen der Fachrichtungen Systemintegration (FISI) und Anwendungsentwicklung (FIAE) begegnet mir regelmäßig eine passende Frage. Wenn wir uns mit weniger beliebten Prüfungsthemen wie dem Subnetting beschäftigen, möchten Teilnehmer:innen wissen, weshalb sie IP-Netze noch selbst berechnen können sollen. Schließlich gibt es Google, Subnetz-Kalkulatoren und inzwischen auch künstliche Intelligenz.
Die Frage ist durchaus berechtigt. Im beruflichen Alltag spricht wenig dagegen, geeignete Werkzeuge für solche Berechnungen einzusetzen. Doch wer die Grundlagen von Netzadressen, Subnetzmasken und Adressbereichen nicht versteht, kann fehlerhafte Ergebnisse kaum erkennen. Genau darin liegt der Unterschied zwischen der Nutzung eines Hilfsmittels und der ungeprüften Übernahme seiner Ergebnisse. Bei generativer KI verschärft sich diese Herausforderung. Ein Sprachmodell kann eine falsche Berechnung ebenso überzeugend erläutern wie eine korrekte. Ähnliches gilt für PowerShell-Skripte oder sicherheitsrelevante Konfigurationen, deren Auswirkungen Administrator:innen weiterhin selbst beurteilen müssen.
Natürlich sind auch menschliche Entscheidungen fehleranfällig. Gut eingesetzte Assistenzsysteme können deshalb die Zuverlässigkeit durchaus verbessern. Voraussetzung bleibt jedoch, dass wir ihre Ergebnisse anhand unseres Fachwissens überprüfen können. Je überzeugender ein KI-System kommuniziert, desto wichtiger wird die Fähigkeit, sprachliche Sicherheit von fachlicher Verlässlichkeit zu unterscheiden.
Lernen mit KI – oder Lernen durch KI ersetzen?
Besonders deutlich zeigt sich dieses Spannungsfeld in der Bildung. Künstliche Intelligenz kann schwierige Themen erklären, individuelle Übungen entwickeln und Lerninhalte an unterschiedliche Vorkenntnisse anpassen. Doch entscheidend ist, ob sie den Lernprozess unterstützt oder die eigenständige Auseinandersetzung ersetzt. In Gesprächen mit Lehrer:innen höre ich inzwischen häufiger von Hausaufgaben, bei denen offensichtlich KI-generierte Antworten ungeprüft übernommen wurden. Manchmal bleiben sogar Formulierungen wie ‚Soll ich dieses Thema weiter ausarbeiten?‘ am Ende der abgegebenen Texte stehen.
Eine besonders aufschlussreiche Geschichte erzählte mir meine jüngere Tochter. Einige Mitschüler:innen hatten eine Hausaufgabe vollständig und fachlich richtig beantwortet – und erhielten dafür dennoch die Note ‚ungenügend‘. Der Hintergrund: Die Lehrerin hatte versehentlich einen Teil der benötigten Unterrichtsmaterialien nicht online bereitgestellt. Mit den verfügbaren Unterlagen ließen sich die vorherige und die nachfolgende Frage beantworten, nicht jedoch die dazwischenliegende. Die KI kannte offenbar die fehlenden Inhalte und lieferte trotzdem die richtige Antwort.
Das Beispiel verdeutlicht ein grundlegendes Problem: Eine fachlich korrekte Antwort ist nicht automatisch ein Nachweis für einen erfolgreichen Lernprozess. Umgekehrt beweist eine richtige Antwort auf eine solche Aufgabe allein noch keine KI-Nutzung. Gerade deshalb gewinnt die didaktische Gestaltung an Bedeutung. Lernende sollten Ergebnisse nicht nur präsentieren, sondern ihre Lösungswege erklären, Entscheidungen begründen und Zusammenhänge selbstständig nachvollziehen können. KI kann Lernprozesse bereichern. Sie ersetzt jedoch nicht die aktive Auseinandersetzung, durch die aus verfügbaren Informationen tatsächlich Wissen und Handlungskompetenz entstehen.
Wenn Maschinen menschlicher wirken, als sie sind
Bereits zu Beginn dieses Beitrags haben wir uns mit der Anthropomorphisierung künstlicher Intelligenz beschäftigt. Doch während es dort um die Zuschreibung menschlicher Absichten ging, stellt sich nun eine andere Frage: Wie beeinflusst die menschenähnliche Kommunikation unser Vertrauen in die Antworten einer KI? Schon 1950 beschäftigte sich der britische Mathematiker Alan Turing mit dieser Problematik. In seinem Aufsatz Computing Machinery and Intelligence entwickelte er das sogenannte Imitation Game, aus dem der später als Turing-Test bekannte Ansatz hervorging. Dabei steht die Frage im Mittelpunkt, ob ein Mensch anhand einer textbasierten Unterhaltung zuverlässig zwischen einem menschlichen und einem maschinellen Gegenüber unterscheiden kann.
Moderne Sprachmodelle verdeutlichen, wie überzeugend Maschinen inzwischen kommunizieren können. Sie greifen den Gesprächskontext auf, formulieren nachvollziehbare Erklärungen und können Verständnis oder Unsicherheit sprachlich ausdrücken. Doch selbst eine erfolgreiche menschliche Imitation wäre kein Beweis für Bewusstsein, eigene Erfahrungen oder menschliches Verständnis. Gerade darin liegt eine Herausforderung: Wir können sprachliche Gewandtheit leicht mit fachlicher Kompetenz oder persönlicher Verantwortungsfähigkeit verwechseln. Eine freundlich formulierte Empfehlung bleibt jedoch das Ergebnis eines technischen Systems, dessen Zuverlässigkeit überprüft werden muss.
Besonders relevant wird diese Unterscheidung bei KI-Agenten, die Entscheidungen vorbereiten oder über Werkzeuge Handlungen auslösen können. Ihre tatsächlichen Möglichkeiten werden weiterhin durch Software, Berechtigungen und technische Rahmenbedingungen bestimmt. Je menschlicher künstliche Intelligenz kommuniziert, desto wichtiger wird die Unterscheidung zwischen überzeugender Nachahmung, tatsächlicher Leistungsfähigkeit und menschlicher Verantwortung.
Wenn Unterstützung zur Gewohnheit wird
Technologische Hilfsmittel verändern nicht nur unseren Alltag, sondern auch die Fähigkeiten, die wir regelmäßig trainieren. Wie weit solche Anpassungen reichen können, zeigen Untersuchungen Londoner Taxifahrer:innen. Während ihrer anspruchsvollen Ausbildung, bekannt als The Knowledge, müssen sie sich Tausende Straßen und Orientierungspunkte einprägen. Neurowissenschaftliche Studien konnten dabei sogar strukturelle Veränderungen im Hippocampus nachweisen, einer für das räumliche Gedächtnis wichtigen Hirnregion. Daraus folgt allerdings nicht, dass Navigationssysteme grundsätzlich schädlich wären. Technische Unterstützung kann uns von Routinetätigkeiten entlasten und geistige Kapazitäten für andere Aufgaben freimachen.
Wie viele Entscheidungen wir täglich treffen, lässt sich kaum zuverlässig beziffern. Die Psychologin Eva Krockow hinterfragt beispielsweise die häufig zitierte Zahl von 35.000 Entscheidungen pro Tag. Unstrittig ist jedoch, dass wir regelmäßig zwischen zahlreichen Handlungsoptionen wählen müssen. Dabei greifen wir auch auf Gewohnheiten zurück. Eine Untersuchung der TU Dresden zeigt, wie stark wiederholte Handlungen spätere Entscheidungen beeinflussen können.
Gerade deshalb ist die Delegation bestimmter Aufgaben durchaus sinnvoll. Entscheidend bleibt jedoch, welche Fähigkeiten wir weiterhin benötigen. Erfahrene Administrator:innen können KI einsetzen, um Routinearbeiten zu beschleunigen. Berufseinsteiger:innen müssen dagegen zunächst grundlegende Zusammenhänge verstehen, um dieselben Ergebnisse beurteilen zu können. Die Herausforderung besteht nicht darin, technische Unterstützung möglichst selten zu nutzen, sondern bewusst zu entscheiden, welche Aufgaben wir delegieren und welche Fähigkeiten wir weiterhin selbst entwickeln sollten.
Die Verantwortung für das eigene Urteil bleibt
Die bisherigen Überlegungen zeigen, dass künstliche Intelligenz weit mehr verändert als die Bearbeitung einzelner Aufgaben. Sie beeinflusst, wie wir Informationen suchen, Wissen erwerben, Probleme lösen und Entscheidungen treffen. Dabei eröffnet sie erhebliche Möglichkeiten, unsere geistigen Fähigkeiten zu ergänzen und uns von zeitaufwendigen Routinetätigkeiten zu entlasten. Doch Entlastung und Kompetenzverlust sind nicht dasselbe. Dass wir bestimmte Informationen nicht mehr auswendig lernen oder Berechnungen technischen Hilfsmitteln überlassen, bedeutet nicht zwangsläufig, dass wir weniger leistungsfähig werden. Problematisch wird es vielmehr, wenn wir Ergebnisse übernehmen, ohne ihre Voraussetzungen zu verstehen, oder Fähigkeiten nicht mehr entwickeln, die wir für eine eigenständige Beurteilung benötigen.
Gerade die Beispiele aus Schule, Ausbildung und beruflicher Weiterbildung verdeutlichen deshalb, wie wichtig eine bewusste Gestaltung des KI-Einsatzes ist. Fachwissen verliert durch leistungsfähige Assistenzsysteme nicht seinen Wert. Es bildet vielmehr die Grundlage, um deren Ergebnisse einzuordnen, Fehler zu erkennen und Entscheidungen nachvollziehbar zu begründen.
Die Frage lautet somit nicht, ob künstliche Intelligenz uns das Denken abnimmt, sondern welche gedanklichen Aufgaben wir sinnvoll delegieren können und wo unsere eigene Auseinandersetzung unverzichtbar bleibt. Künstliche Intelligenz kann unsere Fähigkeiten erweitern und uns zahlreiche Aufgaben abnehmen. Die Verantwortung dafür, ihre Ergebnisse zu hinterfragen und ihre Folgen zu beurteilen, bleibt jedoch bei uns.
Diese Diskussion betrifft längst nicht mehr ausschließlich den beruflichen Alltag. Besonders deutlich wird sie dort, wo unterschiedliche Generationen aufeinandertreffen und darüber streiten, welche Fähigkeiten Menschen selbst beherrschen sollten – und welche sie längst selbstverständlich ihren digitalen Begleitern überlassen.

Exkurs: Nehmt ihnen doch einfach mal die Handys weg! – Wenn Alt auf Jung trifft
Wenn aus Sorge ein Generationenkonflikt wird
„Nehmt ihnen doch einfach mal die Handys weg!“ Solche Forderungen fallen in Gesprächen über Kinder, Jugendliche und digitale Medien beinahe zwangsläufig. Dahinter steht häufig die Sorge, dass Konzentrationsfähigkeit, Selbstständigkeit und Leistungsbereitschaft zunehmend verloren gehen. Schnell entsteht daraus ein umfassenderes Urteil: Die jüngere Generation sei weniger belastbar, stelle zu hohe Ansprüche und könne ohne technische Unterstützung kaum noch eigenständig Probleme lösen.
Doch die Kritik funktioniert längst auch in die andere Richtung. Jüngere Menschen werfen älteren Generationen vor, von wirtschaftlichen Rahmenbedingungen profitiert zu haben, die heute nicht mehr selbstverständlich sind. Gut bezahlte Arbeitsplätze, vergleichsweise erschwingliches Wohneigentum und etablierte Karrierewege erscheinen aus ihrer Perspektive häufig als Privilegien. Gleichzeitig gelten manche Vertreter:innen der älteren Generation als wenig anpassungsfähig, wenn sich Arbeitswelt, Technologie und gesellschaftliche Erwartungen verändern.
Wie tief diese gegenseitigen Vorbehalte reichen, zeigt beispielsweise die WirtschaftsWoche in ihrer Auseinandersetzung mit dem Konflikt zwischen Babyboomern und Generation Z. Dabei geht es längst nicht nur um Smartphones, sondern ebenso um Leistung, Wohlstand, Arbeitsbedingungen und gesellschaftliche Verantwortung.
Beide Seiten greifen jedoch häufig auf pauschale Zuschreibungen zurück. Nicht alle jüngeren Menschen sind technikabhängig und leistungsunwillig. Ebenso wenig sind ältere Menschen grundsätzlich privilegiert oder unfähig, sich auf Veränderungen einzustellen. Hinzu kommt, dass solche Generationenbegriffe Menschen zusammenfassen, deren Lebensbedingungen und Erfahrungen sich erheblich unterscheiden können.
Vielleicht liegt das eigentliche Problem darin, dass wir die Fähigkeiten und Erwartungen anderer Generationen anhand unserer eigenen Erfahrungen bewerten. Schließlich wachsen Menschen unter unterschiedlichen wirtschaftlichen, gesellschaftlichen und technischen Bedingungen auf. Bevor wir darüber urteilen, was andere Generationen nicht mehr können oder angeblich nie lernen mussten, sollten wir uns fragen, welche Fähigkeiten ihre jeweilige Lebenswirklichkeit überhaupt verlangt.
Früher mussten wir das alles noch selbst können
Wer ohne Smartphone aufgewachsen ist, erinnert sich an Straßenkarten im Handschuhfach, auswendig gelernte Telefonnummern und Verabredungen ohne permanente Erreichbarkeit. Wer sich verfahren hatte, musste selbst einen neuen Weg finden oder jemanden nach dem Weg fragen. Diese Fähigkeiten waren allerdings keine besonderen Tugenden. Sie waren notwendig, weil geeignete technische Alternativen fehlten.
Wie stark regelmäßiges Training unsere Fähigkeiten prägt, zeigen die bereits erwähnten Untersuchungen Londoner Taxifahrer:innen. Während ihrer Ausbildung müssen sie sich Tausende Straßen und Orientierungspunkte einprägen. Forschende konnten nachweisen, dass dieser anspruchsvolle Lernprozess mit strukturellen Veränderungen im Hippocampus einhergehen kann. Daraus lässt sich jedoch keine allgemeine Überlegenheit früherer Lebensweisen ableiten. Die Untersuchungen zeigen vielmehr, dass sich menschliche Fähigkeiten durch intensive Nutzung und Übung entwickeln.
Doch aus veränderten Anforderungen folgt nicht, dass heute weniger Fähigkeiten benötigt werden. Auch in einer digitalen Welt müssen Menschen selbstständig handeln können. Nur haben sich die dafür erforderlichen Kompetenzen erheblich verändert. Wer sich heute zurechtfinden möchte, muss Informationen bewerten, digitale Identitäten schützen, betrügerische Angebote erkennen und technische Zusammenhänge zumindest so weit verstehen, dass fundierte Entscheidungen möglich bleiben. Mit künstlicher Intelligenz kommt eine weitere Herausforderung hinzu: überzeugend formulierte Antworten kritisch zu hinterfragen, statt sie ungeprüft zu übernehmen.
In meinem Beitrag Eine Reise durch vier Jahrzehnte Digitalisierung beschäftige ich mich ausführlicher mit diesem technologischen Wandel, den ich selbst miterlebt habe. Was früher technische Spezialkenntnisse erforderte, gehört heute vielfach zum Alltag. Gleichzeitig entstehen neue Anforderungen, die wir uns erst erschließen müssen. Eine Telefonnummer auswendig zu kennen, beweist ebenso wenig eine allgemeine Überlegenheit, wie die routinierte Bedienung eines Smartphones automatisch digitale Kompetenz garantiert.
Vielleicht sollten wir weniger darüber diskutieren, was jüngere Generationen angeblich nicht mehr können, und stärker darüber, welche Fähigkeiten heute notwendig sind, um sich selbstständig, sicher und verantwortungsbewusst in einer digitalen Welt zu bewegen.
Erfahrung ist eine Stärke – aber nicht die einzige
Auch die Entscheidungsforschung zeigt, weshalb pauschale Generationenvergleiche problematisch sind. Denn wie gut Menschen Entscheidungen treffen, hängt nicht allein von ihrem Alter ab, sondern auch von den Anforderungen einer Situation.
In einer 2011 veröffentlichten Studie untersuchten Darrell A. Worthy und sein Forschungsteam die Entscheidungsstrategien jüngerer und älterer Erwachsener. Jüngere Teilnehmende erzielten bessere Ergebnisse, wenn Belohnungen unabhängig von früheren Entscheidungen waren. Ältere schnitten dagegen besser ab, wenn ihre Entscheidungen auch spätere Handlungsmöglichkeiten und Erfolgsaussichten beeinflussten.
Anschaulich erinnert dieses Prinzip an das klassische Brettspiel Das Spiel des Lebens. Wer zu Beginn den längeren Weg über ein Studium wählt, nimmt zunächst zusätzliche Kosten in Kauf, erhält dafür aber die Chance auf besser bezahlte Berufe. Eine frühe Entscheidung beeinflusst somit die Möglichkeiten im weiteren Spielverlauf. Natürlich bildet das Brettspiel nicht den Versuchsaufbau der Studie ab. Es verdeutlicht jedoch, weshalb es einen Unterschied macht, ob Entscheidungen lediglich unmittelbare Belohnungen versprechen oder auch zukünftige Möglichkeiten verändern.
Die Untersuchung belegt keine grundsätzliche Überlegenheit einer Altersgruppe. Sie zeigt vielmehr, dass unterschiedliche Lern- und Entscheidungsstrategien je nach Aufgabenstellung Vorteile bieten können.
Übertragen auf den beruflichen Alltag kann langjährige Erfahrung helfen, komplexe Zusammenhänge und langfristige Konsequenzen zu erkennen. Jüngere Kolleg:innen bringen möglicherweise andere Perspektiven, aktuelle Kenntnisse und einen unbefangeneren Zugang zu neuen Technologien ein. Welche Stärken tatsächlich zum Tragen kommen, hängt jedoch von den jeweiligen Menschen und Aufgaben ab. Entscheidend ist nicht, welche Generation grundsätzlich leistungsfähiger ist. Viel wichtiger ist, unterschiedliche Kompetenzen zu erkennen und miteinander zu verbinden, statt sie gegeneinander auszuspielen.
Ein Smartphone ist kein Ersatz für Lebenserfahrung
So berechtigt die Kritik an pauschalen Generationenurteilen ist, so falsch wäre es, sämtliche Sorgen über digitale Medien als bloßes Unverständnis älterer Menschen abzutun. Smartphones, soziale Netzwerke und zunehmend auch KI-Anwendungen beeinflussen unsere Kommunikation, Informationsverarbeitung und Aufmerksamkeit. Gerade bei Kindern und Jugendlichen stellt sich deshalb die Frage, welche Freiräume ihre Entwicklung fördern und wo altersgerechte Grenzen notwendig sind.
Dabei ist nicht jede Bildschirmzeit gleichzusetzen. Ein Smartphone dient der Unterhaltung, ermöglicht aber ebenso schulisches Lernen, soziale Kontakte oder kreative Tätigkeiten. Ein pauschales Verbot vermittelt deshalb noch keine Medienkompetenz. Wer junge Menschen auf eine digitalisierte Gesellschaft vorbereiten möchte, muss ihnen auch den verantwortungsvollen Umgang mit ihren Werkzeugen ermöglichen. Dazu gehören der Schutz persönlicher Daten, das Erkennen von Desinformation und die Fähigkeit, KI-generierte Antworten kritisch zu hinterfragen. Altersgerechte Begrenzungen und die Begleitung durch Erwachsene bleiben dabei sinnvoll. Entscheidend ist, dass solche Regeln zur Selbstständigkeit befähigen, statt ausschließlich auf Verzicht zu setzen.
Gleichzeitig sollten wir technische Vertrautheit nicht mit digitaler Kompetenz verwechseln. Wer soziale Netzwerke mühelos bedient, erkennt deshalb nicht automatisch Manipulationen. Und wer eine KI nach Lösungen fragt, versteht noch lange nicht deren fachliche Zusammenhänge.
Hier können Generationen voneinander profitieren: Lebenserfahrung und kritisches Urteilsvermögen sind ebenso wertvoll wie technologische Offenheit und die Bereitschaft, Gewohntes zu hinterfragen. Weder macht ein Smartphone junge Menschen automatisch kompetent, noch bewahrt der Verzicht darauf vor Fehlentscheidungen. Entscheidend ist, digitale Möglichkeiten selbstbestimmt, kritisch und verantwortungsbewusst zu nutzen.
Vielleicht sollten wir weniger übereinander und mehr miteinander sprechen
Am Ende führt uns der Streit zwischen den Generationen zu einer Frage, die weit über Smartphones, soziale Netzwerke und künstliche Intelligenz hinausgeht: Welche Fähigkeiten brauchen Menschen, um in einer sich ständig verändernden Welt selbstständig und verantwortungsbewusst handeln zu können? Dazu gehören Konzentration, eigenständiges Denken und die Fähigkeit, Probleme auch ohne technische Unterstützung zu lösen. Ebenso wichtig sind digitale Kompetenzen, der kritische Umgang mit Informationen und die Bereitschaft, neue Werkzeuge zu verstehen, statt sie entweder grundsätzlich abzulehnen oder ihnen blind zu vertrauen.
Wer früher eine Straßenkarte lesen musste, besitzt dadurch nicht automatisch die bessere Orientierung in einer digitalisierten Gesellschaft. Wer heute jede Information innerhalb weniger Sekunden abrufen kann, verfügt deshalb noch lange nicht über das Wissen, sie richtig einzuordnen. Und wer jahrzehntelang erfolgreich gearbeitet hat, muss ebenso bereit sein, Gewohntes zu hinterfragen, wie jemand am Beginn seines Berufslebens von den Erfahrungen anderer profitieren kann.
Vielleicht wäre deshalb schon viel gewonnen, wenn wir aufhören würden, ganze Generationen anhand vermeintlicher Schwächen zu beurteilen. Weder sind junge Menschen grundsätzlich bequem und überfordert, noch sind ältere Menschen zwangsläufig privilegiert, unbeweglich oder technisch abgehängt. Fortschritt bedeutet nicht, alles Alte hinter sich zu lassen. Er bedeutet aber ebenso wenig, an früheren Notwendigkeiten festzuhalten, nur weil wir sie selbst einmal bewältigen mussten. Die eigentliche Stärke liegt darin, Erfahrungen weiterzugeben, neue Fähigkeiten anzuerkennen und gemeinsam zu entscheiden, welche Kompetenzen wir auch künftig selbst beherrschen wollen. Denn diese Frage stellt sich nicht nur zwischen den Generationen. Sie wird angesichts immer leistungsfähigerer KI-Systeme für uns alle zunehmend wichtiger.
Wenn KI gesellschaftliche Rollen verändert
Bislang haben wir künstliche Intelligenz vor allem aus zwei Perspektiven betrachtet: als technisches System, dessen Handlungsmöglichkeiten durch Architektur und Sicherheitsmechanismen begrenzt werden müssen, und als Werkzeug, das unsere eigene Arbeitsweise, unser Lernen und unsere Entscheidungen beeinflusst. Doch die Auswirkungen dieser Entwicklung reichen weit über einzelne Anwendungen und ihre Benutzer:innen hinaus. Wenn KI-Systeme Aufgaben übernehmen, Entscheidungen vorbereiten und zunehmend eigenständig Arbeitsabläufe koordinieren, verändert sich auch das Zusammenspiel zwischen Menschen, Unternehmen und gesellschaftlichen Institutionen.
Dabei geht es nicht ausschließlich um die häufig diskutierte Frage, welche Berufe durch künstliche Intelligenz ersetzt werden könnten. Mindestens ebenso bedeutsam ist, wie sich bestehende Tätigkeiten verändern, welche neuen Verantwortlichkeiten entstehen und wer künftig über die Gestaltung wichtiger Prozesse entscheidet. Ein KI-Agent, der Informationen auswertet oder administrative Aufgaben vorbereitet, beeinflusst zunächst einen konkreten Arbeitsablauf. Werden solche Systeme jedoch in größerem Umfang eingesetzt, können sich daraus Veränderungen für ganze Organisationen, Berufsbilder und gesellschaftliche Strukturen ergeben.
Diese Entwicklung berührt eine interessante Verbindung zwischen Informatik und Sozialwissenschaften. Die sogenannte Sozionik beschäftigt sich mit dem Zusammenspiel sozialer und technischer Systeme. Sie untersucht unter anderem, wie soziale Interaktionen mithilfe von Multi-Agenten-Systemen modelliert werden können und welche Erkenntnisse sich daraus für die Gestaltung technischer Systeme gewinnen lassen.
Im Zusammenhang mit agentischer KI eröffnet dieser Ansatz eine zusätzliche Perspektive: Nicht nur die Fähigkeiten einzelner Systeme sind entscheidend, sondern auch die Beziehungen, Abhängigkeiten und Regeln, innerhalb derer sie eingesetzt werden. Die gesellschaftliche Herausforderung künstlicher Intelligenz besteht deshalb nicht allein darin, welche Aufgaben Maschinen künftig übernehmen können. Entscheidend ist ebenso, wie sich dadurch menschliche Rollen, Entscheidungsspielräume und Verantwortlichkeiten verändern.
Wer hat eigentlich entschieden, dass wir so arbeiten?
In meinen IT-Seminaren stelle ich den Teilnehmenden gelegentlich eine scheinbar einfache Frage: „Wer hat eigentlich irgendwann entschieden, dass wir das genau so machen?“ Gerade jüngere Kolleg:innen sind manchmal erstaunt, wenn ich von den Anfängen der Digitalisierung in Unternehmen erzähle. Denn die Einführung von Computern während der vergangenen 30 bis 40 Jahre verlief keineswegs überall nach einem durchdachten Konzept.
Vielmehr erlebten viele Beschäftigte eine Art digitalen Wilden Westen. Computer hielten Einzug in die Büros, doch konkrete Vorgaben für ihre Nutzung waren nicht immer vorhanden. Also machten die Menschen das Naheliegende: Sie übertrugen ihre bisherigen Arbeitsweisen auf die neue Technik. Formulare wurden digital nachgebildet, bestehende Freigabewege übernommen und manuelle Bearbeitungsschritte in Software übertragen. Das war nicht zwangsläufig die technisch effizienteste Lösung. Doch sie war praktikabel und orientierte sich an vertrauten Abläufen.
Diese Entwicklung lässt sich aus der Perspektive soziotechnischer Systeme betrachten. Technik und Organisation beeinflussen sich gegenseitig: Menschen gestalten technische Lösungen nach ihren bisherigen Erfahrungen, während diese Lösungen anschließend neue Arbeitsgewohnheiten prägen. Ein einmal etablierter digitaler Prozess kann auf diese Weise über Jahrzehnte bestehen bleiben, selbst wenn seine ursprünglichen technischen oder organisatorischen Voraussetzungen längst entfallen sind. Manche IT-gestützten Prozesse wirken deshalb bis heute erstaunlich menschlich – nicht weil Computer wie Menschen denken, sondern weil wir sie ursprünglich nach dem Vorbild unserer eigenen Arbeitsweisen gestaltet haben.
Wenn aus technischen Systemen gesellschaftliche Akteure werden
Mit agentischer KI erhält die Wechselwirkung zwischen Mensch, Organisation und Technik eine neue Dimension. Während klassische Software häufig vorab definierte Abläufe ausführt, können KI-Agenten innerhalb vorgegebener Grenzen Handlungsschritte planen, Informationen austauschen und Aufgaben koordinieren. Mehrere spezialisierte Systeme können dabei zusammenarbeiten und gemeinsame Ergebnisse entwickeln. Technisch sprechen wir von Multi-Agenten-Systemen.
Hier wird die bereits angesprochene sozionische Perspektive interessant. Denn sobald mehrere Agenten miteinander interagieren oder in menschliche Arbeitsabläufe eingebunden werden, entstehen Fragen nach Rollenverteilung, Zusammenarbeit und gegenseitigen Abhängigkeiten. Wer übernimmt welche Aufgabe? Nach welchen Regeln werden Informationen weitergegeben? Wie werden widersprüchliche Ergebnisse behandelt? Und wer entscheidet, wenn unterschiedliche Handlungsvorschläge miteinander konkurrieren? Diese Fragen kennen wir aus menschlichen Organisationen. Allerdings müssen wir zwischen der technischen Nachbildung sozialer Strukturen und tatsächlicher gesellschaftlicher Verantwortung unterscheiden.
Ein KI-Agent, der Arbeitsaufträge verteilt oder Entscheidungen vorbereitet, beeinflusst die Zusammenarbeit zwischen Menschen. Er wird damit zu einem wirksamen Bestandteil organisatorischer Prozesse, ohne selbst über demokratische Legitimation, menschliche Bedürfnisse oder moralische Verantwortlichkeit zu verfügen. Seine Handlungsmöglichkeiten entstehen durch die Aufgaben, Schnittstellen und Befugnisse, die Menschen ihm übertragen. Auch die Regeln für die Zusammenarbeit mehrerer Agenten werden letztlich durch die Gestaltung des Gesamtsystems bestimmt.
Gerade deshalb sollten wir nicht selbstverständlich davon ausgehen, dass KI unsere bisherigen Arbeitsweisen möglichst genau nachbilden muss. Vielleicht eröffnen ihre Fähigkeiten vielmehr die Gelegenheit, über Jahrzehnte gewachsene Abläufe grundsätzlich zu hinterfragen. Früher haben wir Computern beigebracht, so zu arbeiten wie wir. Heute müssen wir entscheiden, welche unserer Arbeitsweisen wir künstlicher Intelligenz überhaupt noch übertragen wollen – und welche wir besser neu gestalten sollten.
Nichts ist so beständig wie der Wandel
Die Sorge, dass neue Technologien bestehende Berufe und wirtschaftliche Strukturen verdrängen könnten, ist keineswegs eine Besonderheit künstlicher Intelligenz. Im Gegenteil: Wirtschaftlicher und technologischer Wandel begleitet unsere Gesellschaft seit Generationen. Und beinahe ebenso regelmäßig wird dabei der Niedergang der guten alten Zeit beklagt – verbunden mit der Befürchtung, dass danach eigentlich alles nur schlechter werden könne.
Bei uns im Ruhrgebiet lässt sich diese Entwicklung besonders eindrucksvoll nachvollziehen. Der jahrzehntelange Strukturwandel von Kohle und Stahl veränderte nicht nur ganze Wirtschaftszweige, sondern auch das gesellschaftliche Selbstverständnis einer Region. Berufliche Traditionen verloren ihre frühere Bedeutung, während neue Tätigkeitsfelder und wirtschaftliche Perspektiven entstehen mussten. Dass dieser Übergang für viele Menschen mit erheblichen Belastungen verbunden war, gehört ebenso zu dieser Geschichte wie die später entstandenen Chancen.
Ein anderes Beispiel dürften einige ältere Leser:innen noch aus den 1990er-Jahren kennen: die Diskussionen über Elektronikmärkte wie Media Markt und Saturn. Damals galten die großen Handelsketten als Bedrohung für kleinere Elektrofachgeschäfte und Plattenläden. Heute stehen wiederum die inzwischen etablierten Elektronikmärkte unter dem Wettbewerbsdruck des Onlinehandels, insbesondere durch Plattformen wie Amazon. Die Rollen haben sich verändert, die Diskussionen ähneln sich. Was gestern als Bedrohung wahrgenommen wurde, gilt heute häufig selbst als schützenswerter Bestandteil des Gewohnten.
Allerdings sollten wir solche Veränderungen nicht allein als unvermeidlichen Fortschritt betrachten. Für Menschen, deren Arbeitsplätze oder wirtschaftliche Existenz betroffen sind, können technologische Umbrüche erhebliche persönliche Konsequenzen haben. Vielleicht sollten wir deshalb weniger darüber diskutieren, ob sich unsere Arbeitswelt verändert. Das wird sie ohnehin. Entscheidend ist vielmehr, wie wir diesen Wandel gestalten und mit seinen Folgen umgehen.
Wenn sich Arbeit verändert, statt einfach zu verschwinden
Wenn KI-Systeme Texte verfassen, Programme entwickeln oder komplexe Arbeitsabläufe unterstützen können, entsteht schnell die Befürchtung, ganze Berufsgruppen könnten überflüssig werden. Vor einiger Zeit diskutierte ich mit einem guten Bekannten, ebenfalls IT-Dozent, über die teilweise vehemente Ablehnung künstlicher Intelligenz in unseren Seminaren. Manche Teilnehmende waren überzeugt, dass KI ihre berufliche Zukunft zwangsläufig verschlechtern würde. Auf unsere Frage, ob ihr Arbeitsalltag tatsächlich schlechter werden könnte, antwortete er ebenso knapp wie resolut: ‚Für diese Menschen ja!‘
Über diesen Satz habe ich noch lange nachgedacht. Denn wer Veränderungen grundsätzlich ablehnt, läuft Gefahr, eigene Gestaltungsmöglichkeiten ungenutzt zu lassen. Allerdings hängen die Folgen technologischer Umbrüche nicht allein von der persönlichen Einstellung ab. Auch Unternehmen, Bildungseinrichtungen und politische Institutionen müssen berufliche Übergänge ermöglichen. Hinzu kommt, dass die Automatisierung einzelner Tätigkeiten nicht zwangsläufig ganze Berufsbilder überflüssig macht. In der IT-Administration kann KI beispielsweise Protokolldateien analysieren, PowerShell-Skripte vorbereiten oder Fehlerursachen eingrenzen. Fachliche Bewertung, Absicherung und Verantwortung bleiben dennoch notwendig. Gleichzeitig können Aufgaben wegfallen und neue Qualifikationen erforderlich werden.
Für mich liegt die entscheidende Erkenntnis deshalb zwischen zwei Extremen: Wir sollten technologischem Fortschritt weder kritiklos folgen noch uns ihm grundsätzlich verweigern. Die Zukunft der Arbeit hängt nicht allein davon ab, was KI technisch ermöglicht, sondern ebenso davon, ob Menschen Veränderungen kritisch begleiten, neue Kompetenzen entwickeln und ihre berufliche Zukunft mitgestalten können.
Wer entscheidet, wenn die Maschine empfiehlt?
Künstliche Intelligenz muss Entscheidungen nicht vollständig übernehmen, um erheblichen Einfluss auf deren Ergebnis zu nehmen. Oft genügt bereits die Art, wie Informationen ausgewählt, bewertet und präsentiert werden. Das zeigt sich beispielsweise bei der Vorauswahl von Bewerbungen, der Bewertung wirtschaftlicher Risiken oder der Unterstützung medizinischer Entscheidungen. Selbst wenn am Ende ein Mensch entscheidet, kann eine KI-Empfehlung die Richtung bereits maßgeblich vorgeben. Und Hand aufs Herz: Wer hinterfragt schon jedes Ergebnis eines Systems, das bislang zuverlässig gearbeitet hat?
Hier begegnet uns der bereits beschriebene Automation Bias. Menschen neigen unter bestimmten Bedingungen dazu, automatisierten Empfehlungen stärker zu vertrauen, als deren tatsächliche Zuverlässigkeit rechtfertigt. Besonders unter Zeitdruck oder bei schwer nachvollziehbaren Ergebnissen besteht die Gefahr, dass aus einer menschlichen Entscheidung lediglich eine formale Bestätigung wird. Ein zusätzlicher Freigabeknopf allein schafft deshalb noch keine wirksame Kontrolle. Verantwortliche benötigen ausreichende Informationen, fachliche Kompetenz und die tatsächliche Möglichkeit, einer Empfehlung zu widersprechen. Organisationen müssen dafür entsprechende Rahmenbedingungen schaffen, statt Entscheidungen lediglich nachträglich absegnen zu lassen. Bei agentischen Systemen gewinnt diese Anforderung zusätzlich an Bedeutung, weil aus Empfehlungen unmittelbar technische Aktionen entstehen können.
Damit schließt sich der Kreis zur Frage nach unserem Umgang mit technologischem Fortschritt: Weder grundsätzliche Ablehnung noch unkritische Zustimmung helfen uns weiter. Entscheidend bleibt unsere eigene Urteilskraft. Menschliche Verantwortung bedeutet nicht, jede Entscheidung selbst treffen zu müssen. Sie bedeutet, verstehen und beeinflussen zu können, welche Entscheidungen wir einer Maschine überlassen – und wann wir ihr widersprechen müssen.
Wenn Verantwortung auf viele Schultern verteilt wird
Was geschieht eigentlich, wenn eine KI eine falsche Entscheidung trifft oder eine unerwünschte Aktion ausführt? Wer muss dafür geradestehen? Die Antwort scheint zunächst einfach: diejenigen, die das System einsetzen. Doch spätestens beim genaueren Hinsehen wird deutlich, wie kompliziert diese Frage werden kann.
Stellen wir uns einen KI-Agenten vor, der in einer Unternehmensumgebung eine technische Störung untersucht und anschließend eine fehlerhafte Konfigurationsänderung vornimmt. Liegt die Ursache beim Modell, das eine falsche Schlussfolgerung gezogen hat? Bei der Software, die den vorgeschlagenen Befehl ausgeführt hat? Oder bei den Administrator:innen, die dem Agenten entsprechende Berechtigungen eingeräumt haben?
In der Praxis wirken häufig zahlreiche Beteiligte zusammen. Modellanbieter entwickeln die Technologie, Softwareunternehmen integrieren sie in Anwendungen, IT-Abteilungen gestalten die technische Umgebung und Fachbereiche legen Arbeitsabläufe fest. Hinzu kommen Beschäftigte, die Empfehlungen übernehmen oder automatisierte Aktionen freigeben. Nicht alle Beteiligten können dabei sämtliche Zusammenhänge überblicken.
Gerade deshalb dürfen wir Verantwortung nicht erst dann diskutieren, wenn bereits etwas schiefgegangen ist. Organisationen müssen vorher festlegen, welche Aufgaben KI übernehmen darf, wer ihre Ergebnisse überprüft und wer automatisierte Prozesse im Zweifelsfall stoppen kann.
Dabei sollten wir zwischen drei Ebenen unterscheiden:
- Technische Fehlerursache: Welche Komponente, Entscheidung oder Systeminteraktion hat den Fehler ausgelöst?
- Organisatorische Verantwortung: Wer war für Entwicklung, Konfiguration, Freigabe, Überwachung und Betrieb des Systems zuständig?
- Rechtliche Haftung: Welche Personen oder Organisationen müssen nach den jeweils geltenden rechtlichen Regelungen für entstandene Schäden einstehen?
Diese Ebenen sind nicht zwangsläufig identisch. Eine technische Ursache begründet nicht automatisch eine bestimmte rechtliche Haftung. Ebenso wenig entbindet die Beteiligung eines externen Modellanbieters die einsetzende Organisation grundsätzlich von ihren eigenen Pflichten. Je mehr Aufgaben wir künstlicher Intelligenz übertragen, desto wichtiger wird eine Erkenntnis: Verantwortung lässt sich auf mehrere Menschen und Organisationen verteilen. Sie darf sich dabei aber nicht zwischen ihnen verlieren.
Wissen, Rechenleistung und gesellschaftliche Macht
Wer entscheidet eigentlich darüber, welche KI-Systeme uns zur Verfügung stehen und unter welchen Bedingungen wir sie nutzen dürfen? Bislang haben wir diese Frage vor allem aus wirtschaftlicher Perspektive betrachtet. Doch spätestens bei besonders leistungsfähigen KI-Modellen wird deutlich, dass auch politische Interessen eine entscheidende Rolle spielen.
Bereits unsere Betrachtung der digitalen Souveränität hat gezeigt, welche Abhängigkeiten durch die Konzentration von Rechenleistung, Infrastruktur und technologischen Fähigkeiten entstehen. Wer wichtige KI-Plattformen betreibt, beeinflusst, welche Modelle verfügbar sind, welche Funktionen angeboten werden und nach welchen Regeln sie eingesetzt werden dürfen. Dass diese Entscheidungen keineswegs ausschließlich bei den Technologieunternehmen liegen, verdeutlichen auch die politischen Auseinandersetzungen in den Vereinigten Staaten.
Im Juni 2026 berichteten unter anderem Reuters im Guardian und der Rechtswissenschaftler João Marinotti in The Conversation über staatliche Eingriffe in die Verfügbarkeit besonders leistungsfähiger KI-Modelle von Anthropic. Im Mittelpunkt standen Anordnungen der US-Regierung, die mit nationalen Sicherheitsinteressen begründet wurden, und die Frage, wie weit staatliche Eingriffsbefugnisse gegenüber privaten KI-Anbietern reichen dürfen. Auch die internationale Zusammenarbeit ist betroffen. Im Oktober berichtete Reuters, dass die US-Regierung ihre zuvor restriktive Haltung gegenüber einer frühzeitigen Sicherheitsprüfung amerikanischer KI-Modelle durch britische Behörden wieder gelockert habe.
Solche Entwicklungen zeigen, dass KI längst nicht mehr nur eine technologische oder wirtschaftliche Frage ist. Sicherheitsinteressen, staatliche Einflussmöglichkeiten und internationale Abhängigkeiten greifen zunehmend ineinander. Für Unternehmen und öffentliche Institutionen gewinnt damit eine Frage an Bedeutung, die über die Leistungsfähigkeit einzelner Modelle hinausgeht: Wie verlässlich ist der Zugang zu einer Technologie, deren Verfügbarkeit auch von politischen Entscheidungen anderer Staaten abhängt? Die Machtfrage künstlicher Intelligenz beginnt nicht erst dort, wo Maschinen eigenständig handeln. Sie beginnt bereits bei den Menschen, Unternehmen und Regierungen, die bestimmen, welche Systeme wir nutzen können und nach welchen Regeln sie arbeiten.
Gesellschaftlicher Fortschritt braucht mehr als Automatisierung
Wenn wir auf die vergangenen Jahrzehnte zurückblicken, wird eines deutlich: Neue Technologien haben unsere Arbeitswelt immer wieder grundlegend verändert. Manche Entwicklungen eröffneten ungeahnte Möglichkeiten, andere gingen mit erheblichen wirtschaftlichen und gesellschaftlichen Belastungen einher. Künstliche Intelligenz dürfte daran wenig ändern. Sie erweitert unsere technischen Fähigkeiten, nimmt uns aber nicht die Verantwortung dafür ab, wie wir diese einsetzen. Denn schnellere Arbeitsabläufe, niedrigere Kosten oder eine höhere Produktivität sind zunächst wirtschaftliche und technische Erfolge. Ob daraus auch gesellschaftlicher Fortschritt entsteht, ist eine andere Frage. Was nützt beispielsweise eine effizientere Organisation, wenn ihre Beschäftigten kaum an den Vorteilen teilhaben? Und welchen Wert besitzt eine automatisierte Entscheidung, wenn die betroffenen Menschen sie weder nachvollziehen noch wirksam hinterfragen können?
Dabei sollten wir uns vor zwei gleichermaßen problematischen Vorstellungen hüten: Technologischer Fortschritt führt weder zwangsläufig zu einer besseren Gesellschaft, noch stellt jede Veränderung zunächst eine Bedrohung dar. Unsere bisherigen Betrachtungen zeigen, dass die Wirklichkeit wesentlich differenzierter ist. Gerade deshalb kommt Bildung und beruflicher Weiterbildung eine besondere Bedeutung zu. Menschen müssen nicht nur lernen, neue Werkzeuge zu bedienen. Sie benötigen ebenso das Wissen und die Urteilskraft, deren Möglichkeiten, Grenzen und gesellschaftliche Folgen einzuordnen.
Doch individuelle Kompetenz allein genügt nicht. Unternehmen, Technologieanbieter und öffentliche Institutionen müssen Rahmenbedingungen schaffen, unter denen Menschen Veränderungen tatsächlich mitgestalten können. Dazu gehören nachvollziehbare Zuständigkeiten, geeignete Qualifizierungsangebote und wirksame Möglichkeiten, automatisierte Entscheidungen zu überprüfen oder anzufechten.
Gesellschaftlicher Fortschritt entsteht nicht dadurch, dass Maschinen immer mehr Aufgaben übernehmen. Er entsteht dort, wo wir ihre Fähigkeiten nutzen, ohne menschliche Verantwortung, Teilhabe und Entscheidungsfreiheit aus den Augen zu verlieren. Damit gelangen wir zu einer Frage, die sich nicht mehr allein auf technischer oder organisatorischer Ebene beantworten lässt: Wer bestimmt eigentlich die Regeln, nach denen künstliche Intelligenz entwickelt, eingesetzt und kontrolliert werden darf?
Wer definiert die Regeln? KI zwischen Politik und Regulierung
Wer entscheidet eigentlich, wie weit künstliche Intelligenz gehen darf? In den bisherigen Kapiteln haben wir diese Frage vor allem aus technischer, organisatorischer und gesellschaftlicher Perspektive betrachtet. Wir haben über Sicherheitsgrenzen, menschliche Verantwortung und die Veränderungen unserer Arbeitswelt gesprochen. Doch spätestens dort, wo KI-Systeme grundlegende Rechte berühren, wirtschaftliche Abhängigkeiten schaffen oder nationale Sicherheitsinteressen betreffen, reichen unternehmensinterne Richtlinien allein nicht mehr aus.
Damit betreten wir ein Spannungsfeld, das uns aus anderen Bereichen der technologischen Entwicklung durchaus vertraut ist. Einerseits soll Innovation neue Möglichkeiten eröffnen und wirtschaftlichen Fortschritt ermöglichen. Andererseits erwarten wir, dass Menschen vor vermeidbaren Risiken geschützt werden und Entscheidungen nachvollziehbar bleiben. Beides miteinander zu vereinbaren, ist wesentlich schwieriger, als es in politischen Grundsatzerklärungen gelegentlich klingt. Die Europäische Union versucht mit dem AI Act, künstliche Intelligenz insbesondere anhand ihrer Risiken zu regulieren. Andere Staaten setzen teilweise andere Schwerpunkte und verbinden ihre KI-Politik stärker mit wirtschaftlichen oder nationalen Sicherheitsinteressen. Dass solche Unterschiede konkrete Folgen haben können, zeigen die jüngsten Auseinandersetzungen um die Verfügbarkeit besonders leistungsfähiger KI-Modelle.
Dabei sollten wir eines nicht vergessen: Auch staatliche Regulierung ist das Ergebnis menschlicher Entscheidungen. Gesetze, Verordnungen und politische Vorgaben entstehen nicht unabhängig von gesellschaftlichen Interessen, wirtschaftlichem Einfluss oder wissenschaftlichen Erkenntnissen. Sie müssen deshalb selbst begründet, überprüft und gegebenenfalls verändert werden können. Die entscheidende Frage lautet somit nicht, ob künstliche Intelligenz Regeln benötigt. Sie lautet, wer diese Regeln definiert, welche Interessen dabei berücksichtigt werden und wie wir sicherstellen, dass aus notwendiger Kontrolle keine unkontrollierte Macht entsteht.
Wenn aus technischen Möglichkeiten politische Entscheidungen werden
In der IT sind wir es gewohnt, technische Regeln festzulegen. Administrator:innen definieren Berechtigungen, Sicherheitsrichtlinien begrenzen Zugriffe und organisatorische Vorgaben bestimmen, welche Anwendungen eingesetzt werden dürfen. Doch wer legt die Grenzen fest, wenn die Auswirkungen einer Technologie weit über ein einzelnes Unternehmen hinausreichen? Diese Frage stellt sich bei künstlicher Intelligenz besonders deutlich. Ein KI-System kann beispielsweise Bewerbungen bewerten, Entscheidungen über Kreditvergaben vorbereiten oder medizinisches Personal unterstützen.
Ob solche Anwendungen zulässig sind und welche Anforderungen sie erfüllen müssen, lässt sich nicht allein anhand ihrer technischen Leistungsfähigkeit entscheiden. Denn hier geht es nicht mehr ausschließlich darum, ob eine Anwendung zuverlässig funktioniert. Wir müssen ebenso fragen, welche Folgen fehlerhafte Entscheidungen haben können, welche Rechte betroffene Menschen besitzen und wer für die Ergebnisse verantwortlich ist. Regulierung bedeutet deshalb immer auch eine gesellschaftliche Abwägung. Zu strenge oder unklare Vorgaben können Entwicklung und Markteintritt erschweren. Fehlende Schutzmechanismen können dagegen dazu führen, dass Risiken auf diejenigen verlagert werden, die kaum Einfluss auf die eingesetzten Systeme besitzen.
Dabei existiert selten eine einzige technisch richtige Antwort. Unterschiedliche Staaten können dieselben Risiken unterschiedlich bewerten und daraus verschiedene gesetzliche Anforderungen ableiten. KI-Regulierung ist deshalb keine bloße Erweiterung technischer Sicherheitsrichtlinien. Sie ist eine politische Entscheidung darüber, welche Möglichkeiten wir eröffnen, welche Risiken wir akzeptieren und welche Grenzen wir verbindlich durchsetzen wollen.
Der europäische Weg: Regeln nach Risiken
Mit dem EU AI Act hat die Europäische Union einen Rechtsrahmen geschaffen, der künstliche Intelligenz weder grundsätzlich verbietet noch uneingeschränkt zulässt. Stattdessen orientieren sich die Anforderungen insbesondere daran, welche Risiken mit einem konkreten Einsatz verbunden sind. Ein KI-System, das eine einfache Textzusammenfassung erstellt, wirft andere Fragen auf als eine Anwendung, die Bewerbungen bewertet oder Entscheidungen in sensiblen Bereichen unterstützt. Entsprechend unterscheidet der AI Act zwischen verbotenen KI-Praktiken, besonders regulierten Hochrisiko-Anwendungen und Systemen, für die geringere oder keine zusätzlichen spezifischen Pflichten gelten. Hinzu kommen besondere Vorschriften für KI-Modelle mit allgemeinem Verwendungszweck, sogenannte General-Purpose AI Models.
Dabei betrifft die Verordnung nicht ausschließlich die Hersteller. Auch Organisationen, die KI-Systeme einsetzen, können abhängig von ihrer Rolle und dem jeweiligen Anwendungsfall eigene Pflichten treffen. Der Rechtsrahmen wird schrittweise anwendbar. Erste Verbote und Anforderungen an KI-Kompetenz gelten seit Februar 2025, Vorschriften für allgemeine KI-Modelle seit August 2025. Seit August 2026 gelten weitere wesentliche Bestimmungen, darunter Transparenzpflichten für bestimmte KI-Anwendungen. Mit dem inzwischen in Kraft getretenen AI Omnibus hat die Europäische Union außerdem den Zeitplan für zentrale Hochrisiko-Vorschriften angepasst. Für entsprechende Einsatzbereiche nach Anhang III gelten die Anforderungen ab dem 2. Dezember 2027, für Hochrisiko-KI in bestimmten regulierten Produkten nach Anhang I ab dem 2. August 2028.
Die Anpassungen sollen unter anderem mehr Zeit für die Bereitstellung technischer Normen und geeigneter Umsetzungsinstrumente schaffen. Sie zeigen zugleich, dass auch ein bereits verabschiedeter Rechtsrahmen weiterentwickelt werden muss, wenn sich praktische Schwierigkeiten bei seiner Anwendung ergeben. Für Unternehmen bedeutet dies vor allem, ihre KI-Anwendungen zu kennen, deren Einsatzkontext zu bewerten und Verantwortlichkeiten eindeutig festzulegen. Nicht jedes System benötigt dieselben Kontrollmaßnahmen. Ebenso wenig lässt sich die regulatorische Einordnung allein daraus ableiten, welches KI-Modell technisch zum Einsatz kommt. Der europäische Ansatz versucht damit, Innovation zu ermöglichen und gleichzeitig dort verbindliche Grenzen zu setzen, wo künstliche Intelligenz erhebliche Auswirkungen auf Menschen und ihre Rechte haben kann.
Zwischen Innovationsfreiheit und nationaler Sicherheit
Während die Europäische Union einen übergreifenden Rechtsrahmen verfolgt, ist die amerikanische KI-Politik stärker durch unterschiedliche staatliche Zuständigkeiten, wirtschaftliche Interessen und Fragen der nationalen Sicherheit geprägt. Allerdings wäre es zu einfach, daraus einen grundsätzlichen Gegensatz zwischen europäischer Regulierung und amerikanischer Innovationsfreiheit abzuleiten. Auch in den Vereinigten Staaten können staatliche Sicherheitsinteressen zu weitreichenden Eingriffen in den KI-Markt führen.
Wie konkret diese Eingriffe ausfallen können, zeigte sich im Juni 2026 am Beispiel Anthropic. Die US-Regierung ordnete an, den Zugang ausländischer Nutzer:innen zu besonders leistungsfähigen Modellen des Unternehmens einzuschränken. Begründet wurde dies mit nationalen Sicherheitsbedenken, insbesondere der Möglichkeit, Schutzmechanismen zu umgehen und entsprechende Modelle zur Identifizierung von Software-Schwachstellen zu missbrauchen. Anthropic kritisierte die Maßnahme und verwies darauf, dass die vorgebrachten Erkenntnisse aus seiner Sicht keine derart weitreichende Beschränkung rechtfertigten. Da sich die Zugangsbeschränkung nicht ohne Weiteres auf einzelne Nutzer:innengruppen begrenzen ließ, kündigte das Unternehmen zunächst an, die betroffenen Modelle umfassender vom Markt zu nehmen. Anfang Juli wurden die Exportbeschränkungen nach weiteren Abstimmungen und zusätzlichen Sicherheitsmaßnahmen wieder aufgehoben.
Der Vorgang verdeutlicht einen grundlegenden Konflikt: Wer soll entscheiden, wann die Fähigkeiten eines KI-Modells so gefährlich werden, dass seine Verfügbarkeit staatlich begrenzt werden muss? Und welche überprüfbaren Nachweise sollten eine solche Entscheidung rechtfertigen? Auch innerhalb der amerikanischen Technologiebranche gibt es unterschiedliche Vorstellungen. Während Unternehmen häufig vor übermäßiger Regulierung warnen, fordern einige Entwickler:innen besonders leistungsfähiger Modelle zugleich verbindliche Sicherheitsprüfungen.
Daraus entsteht eine bemerkenswerte Situation: Dieselben Technologien, deren wirtschaftliche Entwicklung politisch gefördert werden soll, können gleichzeitig zum Gegenstand weitreichender staatlicher Kontrolle werden. Die Frage nach Innovationsfreiheit lässt sich deshalb nicht von der Frage nach Sicherheit trennen. Entscheidend bleibt, auf welcher Grundlage staatliche Eingriffe erfolgen, wie ihre Verhältnismäßigkeit überprüft werden kann und welche Möglichkeiten zur rechtlichen Kontrolle bestehen.
Wenn nationale Entscheidungen globale Folgen haben
Was zunächst wie eine innenpolitische Entscheidung erscheint, kann bei künstlicher Intelligenz weitreichende internationale Folgen haben. Denn leistungsfähige Modelle, spezialisierte Hardware und große Cloud-Plattformen werden häufig grenzüberschreitend entwickelt, betrieben und genutzt. Wenn ein Staat den Export bestimmter KI-Technologien beschränkt oder den Zugang zu besonders leistungsfähigen Modellen reguliert, betrifft dies deshalb nicht ausschließlich Unternehmen innerhalb seiner eigenen Grenzen. Auch Forschungseinrichtungen, öffentliche Verwaltungen und Wirtschaftsunternehmen in anderen Ländern können unmittelbar betroffen sein.
Der Fall Anthropic hat diese Abhängigkeit besonders deutlich gemacht. Eine amerikanische Regierungsentscheidung konnte vorübergehend darüber bestimmen, welche Nutzer:innengruppen auf bestimmte Modelle eines privaten Technologieunternehmens zugreifen durften. Dass die Beschränkungen später wieder aufgehoben wurden, beseitigt die grundsätzliche Abhängigkeit nicht. Dabei stehen unterschiedliche Interessen nebeneinander. Staaten möchten sicherheitsrelevante Technologien kontrollieren und ihre wirtschaftliche Wettbewerbsfähigkeit schützen. Internationale Forschung und wirtschaftliche Zusammenarbeit sind dagegen häufig auf möglichst verlässliche Zugangsbedingungen angewiesen.
Für europäische Organisationen entsteht daraus eine zusätzliche Herausforderung. Wie bereits in unserem Exkurs zur digitalen Souveränität betrachtet, bedeutet Unabhängigkeit nicht zwangsläufig, sämtliche Technologien selbst entwickeln zu müssen. Sie setzt aber voraus, Abhängigkeiten zu erkennen, Alternativen zu prüfen und kritische Prozesse nicht vollständig von einzelnen externen Entscheidungen abhängig zu machen. Dazu gehören neben technischen Ausweichmöglichkeiten auch vertragliche Regelungen, eine nachvollziehbare Datenhaltung und realistische Migrationsstrategien.
Internationale Regeln und gemeinsame Sicherheitsstandards könnten solche Unsicherheiten reduzieren. Sie sind allerdings nur dann tragfähig, wenn die beteiligten Staaten bereit sind, ihre unterschiedlichen Interessen miteinander in Einklang zu bringen. Künstliche Intelligenz wird weltweit eingesetzt. Die Macht, ihren Zugang zu beschränken, liegt jedoch häufig bei vergleichsweise wenigen Unternehmen und Staaten. Genau darin entsteht eine neue Herausforderung für die internationale Zusammenarbeit.
Regeln schaffen Vertrauen – aber keine absolute Sicherheit
Nach all diesen Beispielen könnte der Eindruck entstehen, dass wir künstliche Intelligenz nur ausreichend umfassend regulieren müssten, um ihre Risiken beherrschbar zu machen. Doch so einfach ist es nicht. Gesetze können Anforderungen definieren, Zuständigkeiten festlegen und Sanktionen ermöglichen. Sie garantieren jedoch nicht, dass technische Systeme jederzeit zuverlässig funktionieren oder sämtliche Beteiligten die Regeln tatsächlich einhalten.
Das kennen wir aus anderen Bereichen der IT. Datenschutzvorschriften verhindern nicht jeden Datenabfluss, Sicherheitsstandards schließen nicht jede Schwachstelle und eine dokumentierte Freigabe bedeutet noch lange nicht, dass ein automatisierter Prozess unter allen Bedingungen sicher arbeitet. Bei künstlicher Intelligenz kommt hinzu, dass sich Fähigkeiten und Einsatzmöglichkeiten teilweise schneller verändern, als rechtliche Vorgaben angepasst werden können. Besonders agentische Systeme stellen Organisationen vor neue Herausforderungen, wenn Modelle mit Werkzeugen, Datenquellen und weitreichenden Berechtigungen verbunden werden. Ein ursprünglich begrenzter Anwendungsfall kann dadurch Handlungsmöglichkeiten erhalten, die bei seiner ersten Bewertung noch gar nicht vorgesehen waren.
Regulierung muss deshalb durch technische Sicherheitsmaßnahmen, nachvollziehbare Prüfverfahren und organisatorische Verantwortung ergänzt werden. Gleichzeitig sollten rechtliche Vorgaben regelmäßig daraufhin überprüft werden, ob sie ihre vorgesehenen Schutzziele tatsächlich erreichen. Dabei bleibt eine Frage, die wir bislang nur am Rande betrachtet haben: Wer überprüft eigentlich diejenigen, die KI-Systeme bewerten, zertifizieren oder ihre Nutzung einschränken dürfen? Und wie stellen wir sicher, dass auch staatliche Stellen und private Prüfunternehmen ihre Entscheidungen transparent und verantwortungsvoll treffen? Regeln sind eine notwendige Grundlage für den verantwortungsvollen Einsatz künstlicher Intelligenz. Vertrauen entsteht jedoch erst dann, wenn ihre Einhaltung überprüfbar ist – und auch diejenigen kontrolliert werden können, die über ihre Durchsetzung entscheiden.

Exkurs: Superintelligenz per Dekret? – Wenn Politik wissenschaftliche Begriffe neu definiert
Superintelligenz auf Anordnung
Kann eine Regierung per Verordnung festlegen, dass künstliche Intelligenz ab sofort Superintelligenz heißt? Was zunächst wie eine überspitzte Frage klingt, wurde am 29. September 2026 tatsächlich Gegenstand einer amerikanischen Regierungsanordnung. Mit der Executive Order Inaugurating the Era of Super Intelligence verfügte US-Präsident Donald Trump, dass Bundesbehörden in ihrer offiziellen Kommunikation grundsätzlich die Begriffe Super Intelligence und SI anstelle von Artificial Intelligence und AI verwenden sollen, soweit dies rechtlich zulässig ist. Die Anordnung betrifft unter anderem behördliche Korrespondenz, Internetseiten, Berichte und politische Dokumente. Bereits bestehende Vorschriften, Verträge oder historische Dokumente müssen dagegen nicht rückwirkend umgeschrieben werden.
Bemerkenswert ist vor allem die Begründung: Nach Auffassung der US-Regierung werde der bisherige Begriff Artificial Intelligence den Fähigkeiten moderner KI-Systeme nicht mehr gerecht. Super Intelligence solle deren technologisches Potenzial und die damit verbundenen wirtschaftlichen Chancen angemessener zum Ausdruck bringen. Das Problem dabei: Die entsprechenden Begriffe waren in der Informatik längst mit unterschiedlichen Bedeutungen belegt.
AI, AGI und ASI: Begriffe mit technischer Bedeutung
In der KI-Forschung und Fachliteratur ist eine verbreitete begriffliche Unterscheidung etabliert, die sich am Umfang und an der Leistungsfähigkeit künstlicher Intelligenz orientiert:
- Artificial Narrow Intelligence (ANI): Auf bestimmte Aufgaben oder Anwendungsbereiche spezialisierte KI. Auch heutige generative KI-Systeme werden häufig dieser Kategorie zugeordnet, obwohl sie bereits ein breites Spektrum unterschiedlicher Aufgaben bearbeiten können.
- Artificial General Intelligence (AGI): Eine bislang nicht eindeutig nachgewiesene allgemeine künstliche Intelligenz, die menschliche kognitive Fähigkeiten über unterschiedliche Aufgabenbereiche hinweg erreichen könnte.
- Artificial Superintelligence (ASI): Eine hypothetische Superintelligenz, deren kognitive Fähigkeiten menschliche Leistungen in einem breiten Spektrum intellektueller Aufgaben deutlich übertreffen würden.
Diese Einteilung erläutert beispielsweise IBM in seiner Übersicht zu den verschiedenen KI-Typen. Die Kategorien sind keine allgemein verbindlichen technischen Normen. Insbesondere die genaue Definition von AGI ist weiterhin Gegenstand fachlicher Diskussionen. Dennoch verdeutlichen sie, dass zwischen gegenwärtigen KI-Systemen, allgemeiner künstlicher Intelligenz und Superintelligenz erhebliche konzeptionelle Unterschiede bestehen. Mit den Vorstellungen einer zukünftigen Superintelligenz habe ich mich bereits in meinem Beitrag Microsoft auf dem Weg zur Superintelligenz – Vom digitalen Humanismus zur empathischen KI auseinandergesetzt.
Schon die Frage, was wir unter Superintelligenz verstehen und welche Erwartungen wir mit diesem Begriff verbinden, zeigt, dass es dabei um weit mehr als eine bloße Steigerung heutiger Rechen- oder Modellleistungen geht. Insbesondere beschreibt Artificial Superintelligence nicht einfach eine leistungsfähigere Version heutiger Sprachmodelle. Der Begriff steht für eine bislang nicht nachgewiesene Entwicklungsstufe künstlicher Intelligenz. Umso bemerkenswerter ist es, wenn ein wissenschaftlich vorgeprägter Begriff durch eine politische Entscheidung eine wesentlich breitere Bedeutung erhalten soll.
Wenn politische Sprache wissenschaftliche Erwartungen verändert
Die amerikanische Regierungsanordnung verwendet Super Intelligence ausdrücklich für Technologien, die bereits unter die bestehende gesetzliche Definition künstlicher Intelligenz fallen. Damit verändert sich zunächst die amtliche Bezeichnung, nicht aber die tatsächliche Leistungsfähigkeit der Systeme. Ein Sprachmodell wird schließlich nicht dadurch zur Superintelligenz, dass eine Behörde es künftig so nennt. Allerdings geht die Anordnung über eine bloße sprachliche Empfehlung hinaus. Sie fordert auch einen Vorschlag für eine gesetzliche Definition von Super Intelligence, die den bisherigen Begriff Artificial Intelligence gegebenenfalls ersetzen oder erweitern könnte. Damit wird aus einer zunächst administrativen Sprachregelung möglicherweise eine weiterreichende rechtspolitische Frage.
Politisch ist diese Begriffsverschiebung bedeutsam. Sprache prägt Erwartungen, beeinflusst öffentliche Diskussionen und kann wirtschaftliche oder strategische Zielsetzungen unterstreichen. Wenn bereits existierende KI-Systeme offiziell als Superintelligenz bezeichnet werden, kann dadurch der Eindruck entstehen, eine bislang hypothetische technologische Entwicklungsstufe sei bereits erreicht. Die politische Bezeichnung Super Intelligence (SI) ist deshalb nicht automatisch gleichbedeutend mit dem in der Forschung verwendeten Begriff Artificial Superintelligence (ASI). Eine Regierung kann festlegen, wie ihre Behörden eine Technologie bezeichnen. Sie kann jedoch nicht durch eine neue Bezeichnung deren wissenschaftlich nachweisbare Fähigkeiten verändern.
Neusprech und Orwell: Wenn Sprache zum politischen Instrument wird
Bei der Lektüre verschiedener Beiträge und Diskussionen zu dieser Entscheidung ist mir mehrfach ein Begriff begegnet, der aufhorchen lässt: Neusprech. Die Anspielung auf George Orwells dystopischen Roman 1984 liegt für manche Beobachter:innen offenbar nahe. In Orwells fiktivem Überwachungsstaat dient die gezielte Veränderung der Sprache dazu, den Ausdruck bestimmter Gedanken und Vorstellungen einzuschränken. Sprache wird damit zu einem Instrument politischer Machtausübung.
Natürlich lässt sich eine amerikanische Regierungsanordnung zur Bezeichnung von KI-Technologien nicht ohne Weiteres mit Orwells literarischer Dystopie gleichsetzen. Die vorliegende Anordnung schreibt weder sämtliche historischen Dokumente um noch verbietet sie der Wissenschaft oder der Öffentlichkeit, weiterhin von künstlicher Intelligenz zu sprechen. Der Vergleich wirft dennoch eine berechtigte Frage auf: Wie verändert sich unser Verständnis technologischer Entwicklungen, wenn politische Institutionen bereits etablierte Begriffe mit neuen Bedeutungen versehen?
Dabei geht es nicht nur um einzelne Wörter. Begriffe schaffen gedankliche Kategorien. Sie beeinflussen, welche Erwartungen wir an eine Technologie richten, welche Risiken wir wahrnehmen und welche politischen Maßnahmen uns angemessen erscheinen. Nicht jede politische Sprachregelung ist gleichbedeutend mit einer systematischen Manipulation des Denkens. Sie verdient aber besondere Aufmerksamkeit, wenn sie fachliche Unterschiede verwischt und damit die öffentliche Einordnung einer Technologie erschwert.
Zwischen berechtigter Kritik und Verschwörungserzählung
Gleichzeitig scheint mir hier ein weiterer Effekt möglich. Wo politische Entscheidungen auf Misstrauen stoßen, entstehen mitunter Interpretationen, die weit über den eigentlichen Vorgang hinausreichen. Aus der fragwürdigen Umdeutung eines wissenschaftlich vorgeprägten Begriffs könnte beispielsweise die Vermutung entstehen, dass nicht nur die Sprache verändert, sondern langfristig auch die Wahrnehmung der Vergangenheit umgeschrieben werden soll – womöglich als Teil eines größeren, verborgenen Plans.
Für eine solche Absicht liefert die Regierungsanordnung jedoch keinen Beleg. Im Gegenteil: Sie stellt ausdrücklich klar, dass bereits bestehende historische Dokumente nicht rückwirkend geändert werden müssen. Die politische Entscheidung lässt sich deshalb kritisch hinterfragen, ohne daraus zwangsläufig eine umfassende Verschwörung abzuleiten. Gerade darin liegt eine Herausforderung für den öffentlichen Umgang mit künstlicher Intelligenz: Wir sollten politische Kommunikation nicht unkritisch übernehmen, aber ebenso wenig jede irritierende Entscheidung zum Beweis einer verborgenen Absicht erklären.
Das gilt umso mehr, wenn technische Entwicklungen ohnehin mit großen Hoffnungen, wirtschaftlichen Interessen und teilweise erheblichen Ängsten verbunden sind. Wer solche Debatten verstehen möchte, muss zwischen überprüfbaren Tatsachen, politischen Zielsetzungen und persönlichen Interpretationen unterscheiden können. Eine Regierung kann bestimmen, welche Begriffe ihre Behörden verwenden. Sie kann damit öffentliche Wahrnehmungen beeinflussen, aber weder wissenschaftliche Tatsachen verändern noch allein durch eine Umbenennung die Geschichte umschreiben. Entscheidend bleibt, solche Eingriffe kritisch zu hinterfragen, ohne unbelegte Erklärungen an die Stelle überprüfbarer Fakten zu setzen.
Wer kontrolliert die Kontrolleure?
Wir haben uns inzwischen ausführlich damit beschäftigt, welche technischen Grenzen künstliche Intelligenz benötigt und welche Regeln Politik und Gesetzgebung dafür schaffen können. Doch selbst die sorgfältigste Sicherheitsarchitektur und das umfangreichste Regelwerk werfen eine weitere Frage auf: Wer überprüft eigentlich, ob diese Vorgaben eingehalten werden? Aus der klassischen IT kennen wir das Prinzip unabhängiger Kontrolle bereits seit Jahrzehnten. Sicherheitsrichtlinien werden dokumentiert, Zugriffsberechtigungen regelmäßig überprüft und kritische Systeme durch interne oder externe Audits bewertet. Dabei geht es nicht allein darum, Fehler zu entdecken. Kontrollverfahren sollen auch verhindern, dass einzelne Personen oder Organisationen ihre eigenen Entscheidungen ohne ausreichende Überprüfung treffen können.
Bei künstlicher Intelligenz wird diese Aufgabe anspruchsvoller. Leistungsfähige Modelle können in sehr unterschiedlichen Anwendungssituationen eingesetzt werden. Ihre Ergebnisse hängen vom Kontext, von bereitgestellten Informationen und gegebenenfalls von den Werkzeugen ab, auf die sie zugreifen dürfen. Hinzu kommt, dass verschiedene Beteiligte unterschiedliche Interessen verfolgen. Technologieunternehmen möchten innovative Produkte entwickeln, Organisationen erwarten wirtschaftliche Vorteile und staatliche Stellen sollen gesellschaftliche Risiken begrenzen. Diese Ziele müssen sich nicht widersprechen. Sie können jedoch miteinander in Konflikt geraten.
Deshalb genügt es nicht, Kontrollmechanismen lediglich vorzusehen. Wir müssen auch fragen, wie unabhängig sie arbeiten, welche Erkenntnisse sie tatsächlich liefern und wer ihre Ergebnisse überprüfen kann. Denn eine Kontrolle verdient nicht schon deshalb Vertrauen, weil sie als solche bezeichnet wird. Entscheidend ist, ob sie wirksam, nachvollziehbar und selbst überprüfbar ist.
Wer überprüft eigentlich die KI?
Stellen wir uns vor, ein Unternehmen möchte einen KI-Agenten einsetzen, der Störungen in seiner IT-Infrastruktur analysiert und bei Bedarf selbstständig Maßnahmen einleitet. Vor der produktiven Freigabe wird das System getestet. Die Ergebnisse sehen vielversprechend aus, die Dokumentation ist vollständig und die verantwortlichen Administrator:innen geben den Einsatz frei. Doch was wurde damit eigentlich nachgewiesen?
Vielleicht hat der Agent die vorgesehenen Tests erfolgreich bestanden. Ob er auch bei ungewöhnlichen Fehlermeldungen, manipulierten Protokolleinträgen oder widersprüchlichen Informationen zuverlässig reagiert, lässt sich daraus nicht ohne Weiteres ableiten.
Genau deshalb sollten wir unterschiedliche Ebenen der Überprüfung auseinanderhalten:
- Modell- und Funktionstests untersuchen, wie zuverlässig ein KI-System bestimmte Aufgaben erfüllt und unter welchen Bedingungen fehlerhafte Ergebnisse auftreten.
- Technische Sicherheitsprüfungen betrachten Berechtigungen, Schnittstellen, Datenflüsse und mögliche Angriffspfade innerhalb der gesamten Anwendung.
- Organisatorische Audits bewerten, ob Zuständigkeiten, Freigaben, Dokumentationspflichten und Kontrollverfahren angemessen geregelt sind.
- Regulatorische Konformitätsbewertungen prüfen, ob einschlägige gesetzliche Anforderungen erfüllt werden. Je nach rechtlichem Rahmen können solche Bewertungen auch durch die verantwortlichen Anbieter selbst erfolgen.
Diese Verfahren ergänzen einander, sind aber nicht austauschbar. Eine erfolgreiche Modellprüfung ersetzt weder die Sicherheitsbewertung der gesamten Anwendung noch die Kontrolle ihres späteren Betriebs. Ebenso wenig beweist ein abgeschlossenes Audit, dass ein System unter allen denkbaren Bedingungen zuverlässig arbeitet.
Besonders wichtig ist außerdem, Veränderungen zu berücksichtigen. Neue Modellversionen, zusätzliche Werkzeuge oder erweiterte Berechtigungen können die Risikosituation erheblich verändern, obwohl die ursprüngliche Anwendung weiterhin denselben Namen trägt. Die entscheidende Frage lautet deshalb nicht nur, ob ein KI-System geprüft wurde. Wir müssen wissen, was geprüft wurde, unter welchen Bedingungen die Prüfung stattfand und welche Risiken dabei möglicherweise unberücksichtigt blieben.
Wenn Unternehmen ihre eigenen Systeme bewerten
Dass Technologieunternehmen ihre Produkte selbst testen, ist zunächst weder ungewöhnlich noch grundsätzlich problematisch. Schließlich verfügen die Entwickler:innen häufig über die besten Kenntnisse der internen Architektur, der Trainingsverfahren und der bekannten Schwachstellen. Schwieriger wird es, wenn dieselbe Organisation nicht nur die Tests durchführt, sondern auch darüber entscheidet, welche Ergebnisse veröffentlicht werden und welche Konsequenzen daraus folgen.
Hier entsteht ein klassischer Interessenkonflikt. Einerseits besteht ein berechtigtes Interesse daran, Sicherheitsprobleme frühzeitig zu erkennen. Andererseits können negative Prüfergebnisse die Markteinführung verzögern, zusätzliche Kosten verursachen oder das Vertrauen potenzieller Kund:innen beeinträchtigen. Dabei müssen wir keineswegs unterstellen, dass Unternehmen ihre Ergebnisse bewusst manipulieren. Schon die Auswahl der Testfälle, die Festlegung von Bewertungskriterien oder die Entscheidung über akzeptable Restrisiken können das Gesamtbild beeinflussen.
Aus der IT-Sicherheit kennen wir deshalb das Vier-Augen-Prinzip und die Trennung von Verantwortlichkeiten. Wer eine Anwendung entwickelt, sollte nicht in jeder Hinsicht die einzige Instanz sein, die ihre Sicherheit beurteilt. Bei besonders leistungsfähigen oder sicherheitskritisch eingesetzten KI-Systemen spricht deshalb vieles dafür, interne Prüfungen durch unabhängige Bewertungen zu ergänzen. Dazu benötigen externe Fachleute allerdings geeignete Zugriffsrechte, aussagekräftige Dokumentationen und ausreichend Zeit. Eine oberflächliche Prüfung ohne Einblick in relevante Systemfunktionen schafft möglicherweise mehr Vertrauen, als sie tatsächlich rechtfertigt.
Gleichzeitig müssen berechtigte Interessen am Schutz von Geschäftsgeheimnissen und sicherheitskritischen Informationen berücksichtigt werden. Nicht jedes Prüfergebnis kann vollständig öffentlich gemacht werden, ohne neue Risiken zu schaffen. Unabhängigkeit bedeutet deshalb nicht zwangsläufig vollständige Öffentlichkeit. Sie bedeutet vor allem, dass kritische Bewertungen nicht allein von den wirtschaftlichen Interessen derjenigen abhängen dürfen, deren Systeme überprüft werden.
Red Teaming, Benchmarks und ihre Grenzen
In der IT-Sicherheit hat sich seit Langem ein Ansatz bewährt, bei dem Systeme bewusst aus der Perspektive möglicher Angreifer:innen untersucht werden. Beim sogenannten Red Teaming versuchen Fachleute, Sicherheitsmechanismen zu umgehen, Schwachstellen auszunutzen oder unerwünschtes Verhalten hervorzurufen. Auch bei künstlicher Intelligenz spielt dieses Verfahren eine wichtige Rolle. Dabei kann beispielsweise untersucht werden, ob ein Modell auf manipulierte Anweisungen reagiert, vertrauliche Informationen preisgibt oder sich durch gezielte Eingaben zu sicherheitskritischen Aktionen verleiten lässt. Ergänzend kommen Benchmarks zum Einsatz. Sie ermöglichen es, bestimmte Fähigkeiten und Verhaltensweisen anhand festgelegter Aufgaben vergleichbar zu bewerten. Während Benchmarks vor allem definierte Eigenschaften messen, untersucht Red Teaming gezielt mögliche Schwächen und unerwünschte Verhaltensweisen.
Beide Verfahren liefern wertvolle Erkenntnisse. Ihre Aussagekraft besitzt jedoch Grenzen. Ein Benchmark misst zunächst nur das, was seine Aufgaben tatsächlich erfassen. Ein Modell kann bei standardisierten Tests hervorragend abschneiden und dennoch in einer unbekannten Situation problematisch reagieren. Ebenso wenig beweist ein erfolgreich abgeschlossener Red-Team-Test, dass sämtliche Angriffsmöglichkeiten entdeckt wurden. Besonders deutlich wird das bei agentischen Systemen. Ein Sprachmodell mag eine gefährliche Anweisung zuverlässig zurückweisen. Wird es jedoch mit Dateisystemen, APIs oder administrativen Werkzeugen verbunden, entstehen zusätzliche Angriffsmöglichkeiten, die sich nicht allein durch Tests des Modells bewerten lassen.
Denken wir beispielsweise an unseren KI-Agenten zur Fehleranalyse: Selbst wenn das zugrunde liegende Modell gegen direkte Prompt-Injection-Versuche widerstandsfähig erscheint, könnten manipulierte Protokolleinträge oder übermäßig privilegierte Werkzeuge weiterhin zu unerwünschten Aktionen führen. Hinzu kommt, dass die Prüfverfahren selbst weiterentwickelt werden müssen. Neue Fähigkeiten, veränderte Systemarchitekturen und bislang unbekannte Angriffstechniken können frühere Ergebnisse teilweise entwerten. Für mich liegt darin eine wichtige Parallele zur klassischen Netzwerksicherheit: Auch ein erfolgreich durchgeführter Penetrationstest ist keine Garantie dafür, dass ein Netzwerk anschließend unangreifbar wäre. Sicherheitsprüfungen liefern keine endgültigen Wahrheiten. Sie schaffen belastbare Erkenntnisse über bestimmte Risiken unter bestimmten Bedingungen. Ihr Wert hängt wesentlich davon ab, wie sorgfältig wir diese Grenzen berücksichtigen.
Von der Prüfung zur wirksamen Sicherheitsarchitektur
Sicherheitsprüfungen sind wichtig. Ihr eigentlicher Wert zeigt sich jedoch erst dann, wenn ihre Erkenntnisse in wirksame Schutzmaßnahmen übersetzt werden. Ein erkannter Angriffspfad ist schließlich noch nicht geschlossen, nur weil er in einem Prüfbericht dokumentiert wurde. Gerade bei agentischen KI-Systemen können wir auf bewährte Prinzipien der IT-Sicherheit zurückgreifen. Zero Trust bedeutet beispielsweise, dass weder einem KI-Agenten noch seinen Werkzeugen allein aufgrund ihrer Position innerhalb einer vermeintlich vertrauenswürdigen Umgebung vertraut werden darf. Zugriffe müssen anhand geeigneter Identitäts-, Kontext- und Berechtigungsinformationen kontrolliert werden.
Nach dem Prinzip Least Privilege erhalten die beteiligten Komponenten ausschließlich die Berechtigungen, die sie für ihre jeweiligen Aufgaben tatsächlich benötigen. Hinzu kommt Defense in Depth: Identitätsprüfung, technische Isolation, eingeschränkte Netzwerkkommunikation, kontrollierte Werkzeugaufrufe und Protokollierung bilden mehrere aufeinander abgestimmte Schutzschichten. Fällt eine davon aus, sollen andere verhindern, dass daraus unmittelbar ein schwerwiegender Sicherheitsvorfall entsteht. Mit diesem ganzheitlichen Verständnis von IT-Sicherheit habe ich mich bereits in meinem Beitrag Moderne Microsoft Security-Architektur in der Praxis – Zero Trust, Identity, Cloud und Operations ganzheitlich denken beschäftigt. Die dort angesprochene Verbindung von Identitäten, Zugriffssteuerung, Cloud-Infrastruktur und Sicherheitsbetrieb gewinnt durch agentische KI zusätzlich an Bedeutung. Denn ein KI-Agent ist nicht nur eine Anwendung, die Informationen verarbeitet. Er kann über angebundene Werkzeuge selbst zum handelnden Bestandteil dieser Infrastruktur werden.
Auch menschliche Freigaben gehören zu einer solchen Architektur. Allerdings haben wir bereits gesehen, dass ein zusätzlicher Bestätigungsknopf allein keine wirksame Kontrolle gewährleistet. Wer eine Aktion freigeben soll, benötigt ausreichende Informationen über deren Grundlage und mögliche Folgen sowie die tatsächliche Möglichkeit, sie abzulehnen. Ein hilfreiches Ordnungsmodell bietet das NIST AI Risk Management Framework des US-amerikanischen National Institute of Standards and Technology (NIST). Seine vier Kernfunktionen Govern, Map, Measure und Manage verbinden organisatorische Verantwortung, die Einordnung des Einsatzkontexts, die Bewertung von Risiken und deren laufende Behandlung.
Damit wird deutlich, dass Sicherheitsarchitektur nicht mit der produktiven Freigabe abgeschlossen ist. Modelländerungen, neue Schnittstellen und zusätzliche Berechtigungen können neue Risiken schaffen. Deshalb müssen auch das tatsächliche Systemverhalten und sicherheitsrelevante Aktionen risikogerecht überwacht werden. Festgestellte Abweichungen sollten nachvollziehbare Reaktionen auslösen können – von einer erneuten Prüfung bis zur Einschränkung oder Abschaltung einzelner Funktionen. Wirksame KI-Sicherheit entsteht nicht durch eine einzelne Prüfung oder Schutzmaßnahme. Sie entsteht durch das Zusammenspiel technischer Grenzen, organisatorischer Verantwortung und einer Kontrolle, deren Ergebnisse im laufenden Betrieb nachvollziehbar bleiben.
Wenn auch die Aufsicht kontrolliert werden muss
Mit gesetzlichen Vorgaben entstehen zwangsläufig Institutionen, die ihre Einhaltung überwachen sollen. Behörden können Prüfungen durchführen, Informationen anfordern und gegebenenfalls Sanktionen verhängen. Damit erhalten sie Einfluss auf die Entwicklung und den Einsatz künstlicher Intelligenz. Eine solche Aufsicht ist notwendig. Sie wirft allerdings dieselbe grundlegende Frage auf, die uns bereits bei den Technologieunternehmen beschäftigt hat: Wer überprüft die Entscheidungen derjenigen, die über andere entscheiden dürfen?
Staatliche Stellen handeln nicht außerhalb gesellschaftlicher oder politischer Interessen. Ihre Entscheidungen können von gesetzlichen Zuständigkeiten, verfügbaren Ressourcen und politischen Prioritäten geprägt sein. Deshalb benötigen auch sie klare Verfahrensregeln, nachvollziehbare Entscheidungsgrundlagen und wirksame Möglichkeiten zur rechtlichen Überprüfung. Dabei geht es nicht darum, staatliche Aufsicht grundsätzlich infrage zu stellen. Im Gegenteil: Ihre Glaubwürdigkeit hängt wesentlich davon ab, dass sie selbst an überprüfbare Regeln gebunden ist. Besonders schwierig wird dies bei hochkomplexen KI-Systemen. Aufsichtsbehörden benötigen ausreichend technische Kompetenz, um Bewertungen nachvollziehen zu können. Gleichzeitig dürfen sie sich nicht vollständig auf die Informationen und Einschätzungen der Unternehmen verlassen müssen, die sie beaufsichtigen sollen.
Auch internationale Unterschiede erschweren die Situation. Ein KI-System kann in einem Land entwickelt, in einem anderen betrieben und weltweit genutzt werden. Welche Behörde zuständig ist und welche Prüfungen anerkannt werden, lässt sich deshalb nicht immer einfach beantworten. Wir benötigen folglich nicht nur leistungsfähige Kontrollinstanzen, sondern auch transparente Zuständigkeiten, fachliche Unabhängigkeit und funktionierende Rechtsmittel. Demokratisch legitimierte Kontrolle bedeutet nicht, dass staatliche Entscheidungen grundsätzlich richtig sind. Sie bedeutet, dass auch diese Entscheidungen begründet, hinterfragt und gegebenenfalls korrigiert werden können.
Vertrauen ist gut, überprüfbare Kontrolle ist besser
Was bedeutet all das nun für den praktischen Umgang mit künstlicher Intelligenz? Müssen wir künftig jedes Modell vollständig verstehen, jede Entscheidung unabhängig nachrechnen und sämtliche Anwendungen permanent überwachen? Eine solche Vorstellung wäre weder realistisch noch besonders hilfreich. Auch in der klassischen IT verlassen wir uns täglich auf Betriebssysteme, Netzwerkkomponenten und Sicherheitslösungen, deren interne Funktionsweise wir nicht in allen Einzelheiten überprüfen können. Entscheidend ist vielmehr, dass Vertrauen nicht ausschließlich auf Versprechen beruht.
Organisationen benötigen nachvollziehbare Verfahren, um KI-Systeme vor ihrer Einführung zu bewerten und während des Betriebs zu überwachen. Dazu gehören dokumentierte Verantwortlichkeiten, angemessene Sicherheitsprüfungen, wirksame Zugriffsbeschränkungen und Möglichkeiten, problematische Entscheidungen oder Aktionen zu erkennen und zu korrigieren. Bei agentischen Systemen gewinnt insbesondere die technische Durchsetzung solcher Grenzen an Bedeutung.
Ein KI-Agent sollte nicht allein deshalb weitreichende Berechtigungen erhalten, weil er seine bisherigen Aufgaben zuverlässig erledigt hat. Ebenso wenig darf eine organisatorische Freigabe die regelmäßige Überprüfung seiner tatsächlichen Handlungsmöglichkeiten ersetzen. Dabei sollten wir Kontrolle nicht mit Misstrauen gegenüber jeder technologischen Entwicklung verwechseln. Gut gestaltete Kontrollmechanismen können Innovation sogar erleichtern, weil sie Risiken sichtbar machen und einen verantwortbaren Einsatz ermöglichen. Allerdings bleibt auch die beste Governance auf Menschen angewiesen, die ihre Regeln verstehen, Entscheidungen kritisch beurteilen und bereit sind, bei erkannten Problemen Konsequenzen zu ziehen.
Damit schließt sich ein Gedanke, der uns seit dem Beginn dieses Beitrags begleitet: Technische Grenzen, rechtliche Vorgaben und unabhängige Prüfungen sind unverzichtbar. Ihre Wirksamkeit entsteht jedoch erst durch die Menschen und Organisationen, die sie gestalten und durchsetzen. Verantwortungsvolle KI braucht nicht nur Systeme, die kontrolliert werden können. Sie braucht ebenso Menschen und Institutionen, die bereit sind, diese Kontrolle tatsächlich auszuüben – und sich dabei selbst überprüfen zu lassen.

Exkurs: Zwischen Weltuntergang und Entwarnung – Wie Nachrichten unsere Wahrnehmung von KI prägen
Wenn die nächste Katastrophe nur einen Wisch entfernt ist
Ich bin gerne auf unterschiedlichen sozialen Plattformen unterwegs. Dabei begegnen mir täglich zahlreiche Informationen, Meinungen und Diskussionen. Manche Beiträge liefern interessante Anregungen, andere bringen mich zum Nachdenken. Und gelegentlich frage ich mich, ob ich die nächste technische Revolution oder gleich das Ende der Menschheit verpasst habe, während ich mir einen Tee geholt habe.
Gerade künstliche Intelligenz scheint für solche Schlagzeilen besonders geeignet zu sein. Mal steht die nächste technologische Entwicklungsstufe unmittelbar bevor, mal verlieren wir angeblich sämtliche Arbeitsplätze. Dann werden wir verarmen, enteignet oder gleich von einer außer Kontrolle geratenen Superintelligenz ausgelöscht. Die Botschaften unterscheiden sich, ihre Wirkung ist häufig ähnlich: Sie erzeugen Aufmerksamkeit, sprechen Ängste an und vermitteln den Eindruck, dass eine dramatische Entwicklung unmittelbar bevorsteht.
Dabei beschäftigt mich eine grundsätzliche Frage: Wie viele Nachrichten, Warnungen und Entscheidungen können wir eigentlich sinnvoll verarbeiten? Digitale Medien konfrontieren uns mit einem nahezu ununterbrochenen Informationsangebot. Anders als früher müssen wir nicht mehr auf die nächste Zeitungsausgabe oder Nachrichtensendung warten. Informationen erreichen uns jederzeit, aus unterschiedlichsten Quellen und häufig ohne erkennbare Einordnung.
Das bedeutet nicht automatisch, dass Menschen heute in jeder Hinsicht mehr Entscheidungen treffen als frühere Generationen. Aber wir müssen fortlaufend auswählen, welchen Informationen wir Aufmerksamkeit schenken, welchen Quellen wir vertrauen und welche Schlussfolgerungen wir daraus ziehen. Nicht allein die Menge verfügbarer Informationen ist dabei entscheidend. Es ist auch die Geschwindigkeit, mit der wir ihnen Bedeutung geben sollen.
Warum einfache Antworten so überzeugend wirken
Unser Gehirn ist kein unbegrenzt leistungsfähiges Analysezentrum. Wenn Informationen komplex, widersprüchlich oder emotional belastend werden, greifen wir auf vereinfachende Denkstrategien zurück. Solche Heuristiken sind im Alltag durchaus hilfreich. Ohne sie müssten wir selbst unbedeutende Entscheidungen immer wieder vollständig durchdenken. Problematisch wird es, wenn diese Vereinfachungen unsere Wahrnehmung systematisch verzerren.
Der sogenannte Confirmation Bias, die Bestätigungsverzerrung, beschreibt unsere Neigung, Informationen bevorzugt so auszuwählen und zu bewerten, dass sie bereits vorhandene Überzeugungen stützen. Hinzu kommt die Verfügbarkeitsheuristik: Ereignisse, die uns besonders eindrücklich oder häufig begegnen, erscheinen mitunter wahrscheinlicher, als sie tatsächlich sind. Wer ohnehin befürchtet, dass KI außer Kontrolle geraten könnte, wird eine entsprechende Warnung möglicherweise als weiteren Beweis betrachten. Wer dagegen überzeugt ist, dass die gesamte Diskussion übertrieben sei, findet ebenso leicht Beiträge, die diese Haltung bestätigen.
Soziale Plattformen können solche Mechanismen verstärken. Ihre Empfehlungssysteme berücksichtigen unterschiedliche Signale der Interaktion. Inhalte, die starke Reaktionen auslösen, können dadurch besonders sichtbar werden. Das bedeutet nicht, dass jede Plattform gezielt Angst verbreiten möchte. Aufmerksamkeit ist jedoch eine wichtige Ressource der digitalen Medienwirtschaft. Und Aufmerksamkeit gewinnt man selten mit dem Satz: ‚Die Sachlage ist kompliziert, wir müssen mehrere Möglichkeiten unterscheiden und können derzeit keine abschließende Bewertung vornehmen.‘ Dabei wäre genau das gelegentlich die angemessenste Antwort.
Damals natürliche Kartoffeln, heute gefährliche Chemie?
Vor Kurzem begegnete mir wieder eines jener Bilder, die eine komplexe Aussage auf einen einzigen Blick reduzieren sollen. Zu sehen waren zwei Portionen Pommes frites von McDonald’s: links eine angeblich frühere Variante aus den 1980er-Jahren mit wenigen und natürlichen Zutaten, rechts die heutige Version mit einer deutlich längeren Liste chemisch klingender Bestandteile. Die Botschaft war unmissverständlich: Früher waren Lebensmittel natürlich und unkompliziert. Heute bestehen sie angeblich aus industriellen Zusätzen, deren Namen bereits gefährlich klingen.
Doch was erfahren wir aus dieser Gegenüberstellung tatsächlich? Zunächst einmal erstaunlich wenig. Wir wissen nicht, ob die historischen Angaben vollständig sind, ob dieselben Produkte und Märkte verglichen werden oder welche Verarbeitungsschritte berücksichtigt wurden. Auch sagt die Länge einer Zutatenliste für sich genommen nichts darüber aus, ob ein Lebensmittel gesundheitsschädlich ist. Bezeichnungen wie Dextrose oder Natriumpyrophosphat wirken auf manche Menschen möglicherweise bedrohlich. Ohne Kenntnisse ihrer Funktion, Verwendung und gesundheitlichen Bewertung lässt sich daraus jedoch keine belastbare Aussage über die Gefährlichkeit eines Lebensmittels ableiten.
Die Abbildung erklärt diese Zusammenhänge nicht. Sie überlässt die Interpretation weitgehend unseren bestehenden Vorstellungen. Wer industriell verarbeiteten Lebensmitteln ohnehin misstraut, fühlt sich bestätigt. Andere zucken mit den Schultern und bestellen beim nächsten Besuch trotzdem ihre Pommes.
Ich gehöre durchaus zu den Menschen, die einem Burger oder gelegentlichem Fast Food nicht grundsätzlich abgeneigt sind. Dass eine ausgewogene Ernährung nicht hauptsächlich daraus bestehen sollte, dürfte allerdings kaum überraschen. Die entscheidende Frage ist deshalb nicht, ob wir Fast Food mögen. Sie lautet, ob eine emotional gestaltete Gegenüberstellung tatsächlich geeignet ist, seine gesundheitlichen Eigenschaften zu beurteilen. Eine Information wird nicht dadurch zur Aufklärung, dass sie eine eindeutige Meinung vermittelt. Aufklärung beginnt dort, wo Zusammenhänge nachvollziehbar erklärt werden.
Wenn Warnungen aus der KI-Branche selbst kommen
Besonders eindrucksvoll wirken solche Mechanismen, wenn die Warnungen von Menschen stammen, die unmittelbar an der Entwicklung künstlicher Intelligenz beteiligt waren. Da verlässt beispielsweise ein Forscher ein führendes KI-Unternehmen, nachdem er jahrelang an immer leistungsfähigeren Modellen gearbeitet hat. Anschließend erklärt er öffentlich, dass die Entwicklung möglicherweise katastrophale Folgen für die Menschheit haben könnte.
In meiner gelegentlich etwas überspitzten Vorstellung hat dieser Mensch nach einem letzten Blick in den technologischen Abgrund seinen Arbeitsplatz verlassen und betreibt inzwischen eine Straußenfarm irgendwo im australischen Outback. Möglichst weit entfernt von Rechenzentren und der restlichen Menschheit.
Natürlich ist das Ironie. Aber gerade solche Geschichten laden zu weitreichenden Interpretationen ein. Wer ein Unternehmen verlässt und anschließend eindringlich warnt, muss doch etwas wissen, das der Öffentlichkeit bislang verborgen geblieben ist. Oder?
Tatsächlich können hinter beruflichen Veränderungen ganz unterschiedliche Gründe stehen. Persönliche Überzeugungen, Arbeitsbelastung, wirtschaftliche Unabhängigkeit oder fachliche Meinungsverschiedenheiten schließen sich nicht gegenseitig aus. Ohne entsprechende Informationen sollten wir weder eine verborgene Erkenntnis noch eine belanglose Motivation unterstellen. Im September 2026 sorgten beispielsweise Warnungen aus dem Umfeld der KI-Forschung für erhebliche Aufmerksamkeit. ARTE und Deutschlandfunk griffen Befürchtungen auf, dass zukünftige KI-Systeme eine existenzielle Gefahr für die Menschheit darstellen könnten.
Solche Einschätzungen verdienen eine ernsthafte Auseinandersetzung. Ihre Eintrittswahrscheinlichkeit lässt sich allerdings nicht allein aus der fachlichen Stellung der warnenden Personen ableiten. Denn Fachwissen verleiht einer Warnung Gewicht, ersetzt aber nicht die Prüfung ihrer Begründung. Eine Warnung verdient Aufmerksamkeit, weil ihre Argumente relevant sein könnten – nicht allein deshalb, weil die warnende Person einmal bei Anthropic oder OpenAI beschäftigt war.
Zwischen berechtigter Warnung und Doom Trolling
Dass selbst führende KI-Unternehmen vor den möglichen Folgen ihrer eigenen Technologie warnen, erscheint zunächst widersprüchlich. Warum sollten Unternehmen öffentlich erklären, dass ihre Produkte eines Tages eine existenzielle Gefahr darstellen könnten? Eine mögliche Erklärung ist aufrichtige Besorgnis. Menschen, die unmittelbar an leistungsfähigen KI-Systemen arbeiten, können Risiken erkennen, die in der öffentlichen Diskussion bislang wenig Beachtung finden.
Allerdings existiert auch eine wirtschaftliche Perspektive. ZDFheute beschäftigte sich im September 2026 mit dem Begriff Doom Trolling, den der Informatikprofessor Cal Newport für eine besondere Form der Kommunikation über KI-Risiken verwendet. Die dahinterstehende These: Wer seine Technologie als potenziell weltverändernd oder sogar existenzbedrohend darstellt, unterstreicht zugleich ihre außergewöhnliche Bedeutung. Solche Warnungen können Aufmerksamkeit erzeugen, Investitionen begünstigen und möglicherweise auch den politischen Wettbewerb beeinflussen. Besonders aufwendige regulatorische Anforderungen könnten beispielsweise kleinere Unternehmen stärker belasten als finanzkräftige Technologiekonzerne.
Das bedeutet keineswegs, dass entsprechende Warnungen zwangsläufig unehrlich oder ausschließlich wirtschaftlich motiviert sind. Unterschiedliche Motive können gleichzeitig bestehen. Und aus einem möglichen wirtschaftlichen Nutzen lässt sich nicht automatisch auf die Absicht schließen, die öffentliche Debatte gezielt zu manipulieren. Auch die fachlichen Einschätzungen gehen auseinander. Während der KI-Forscher Thilo Hagendorff existenzielle Risiken ausdrücklich ernst nimmt, betont Stephanie Gygax von AlgorithmWatch Schweiz im SRF-Interview, dass technische Fähigkeiten nicht mit einem eigenständigen Willen gleichgesetzt werden dürfen.
Gerade diese unterschiedlichen Perspektiven machen deutlich, weshalb wir zwischen beobachteten Sicherheitsvorfällen, plausiblen Zukunftsszenarien und spekulativen Prognosen unterscheiden müssen. Nicht jede Warnung ist Panikmache. Aber auch eine eindringlich vorgetragene Prognose bleibt eine Prognose, solange ihre behaupteten Folgen nicht eingetreten und ihre Voraussetzungen nicht hinreichend belegt sind.
Hauptsache, wir reden darüber – der fliegende Tesla Roadster
Ein besonders anschauliches Beispiel dafür, wie spektakuläre Ankündigungen öffentliche Aufmerksamkeit erzeugen können, liefert ausgerechnet Tesla. Seit den Diskussionen über den zukünftigen Tesla Roadster scheint es in den sozialen Medien vor allem eine Frage zu geben: Kann dieses Auto tatsächlich fliegen, oder ist das alles nur ein großer Schwindel?
Die Vorstellung eines elektrisch angetriebenen Sportwagens, der möglicherweise sogar kurzzeitig abheben könnte, ist natürlich eine Steilvorlage für Diskussionen. Die einen sind begeistert, die anderen halten das Ganze für eine maßlose Übertreibung. Wieder andere versuchen, anhand physikalischer Berechnungen herauszufinden, ob eine solche Funktion überhaupt realistisch wäre. Und während sich alle darüber streiten, ob der Roadster jemals fliegen wird, passiert etwas Interessantes: Tesla bleibt im Gespräch. Denn eigentlich müsste man zunächst ganz andere Fragen stellen. Welche Reichweite wird das Fahrzeug erreichen? Wie leistungsfähig wird sein Antrieb sein? Wann wird es tatsächlich erhältlich sein? Und welche der angekündigten Eigenschaften werden sich später in einem Serienfahrzeug wiederfinden? Doch diese vergleichsweise nüchternen Fragen erzeugen selten dieselbe Aufmerksamkeit wie die Vorstellung eines fliegenden Sportwagens.
Ob die spektakuläre Funktion jemals Realität wird, lässt sich aus der öffentlichen Diskussion allein nicht ableiten. Und ebenso wenig können wir ohne Weiteres behaupten, dass jede entsprechende Ankündigung ausschließlich auf Aufmerksamkeit abzielt. Der kommunikative Effekt ist trotzdem bemerkenswert: Selbst wer Tesla bislang kaum beachtet hat, erfährt durch die Kontroverse, dass ein neuer Roadster angekündigt ist. Und nun hat sogar die Person, die sich eher zufällig in meinen Blog verirrt hat, davon erfahren. Ganz ohne Werbeanzeige. Vielleicht ist genau das eine der bemerkenswertesten Eigenschaften moderner Aufmerksamkeitsökonomie: Man muss nicht einmal alle von einer Behauptung überzeugen. Manchmal reicht es schon, wenn möglichst viele darüber diskutieren.
Wenn jede Entwarnung zum Beweis der Verschwörung wird
Besonders schwierig wird die öffentliche Diskussion, wenn unterschiedliche Einschätzungen nicht mehr als Anlass zur Auseinandersetzung betrachtet werden, sondern nur noch als Bestätigung einer bereits feststehenden Überzeugung. Warnt ein KI-Forscher vor einer möglichen Katastrophe, gilt dies als Beweis für den bevorstehenden Kontrollverlust. Relativiert eine andere Fachperson diese Einschätzung, wird ihr unterstellt, sie wolle die Öffentlichkeit beruhigen oder von den eigentlichen Gefahren ablenken.
Damit entsteht ein Argumentationsmuster, das wir aus verschwörungsideologischen Erzählungen kennen: Widersprechende Informationen werden nicht als mögliche Gegenargumente betrachtet, sondern in die ursprüngliche Erklärung integriert. Wer warnt, bestätigt die Gefahr. Wer widerspricht, bestätigt angeblich deren Vertuschung. Eine solche Vorstellung lässt sich kaum noch durch neue Erkenntnisse korrigieren.
Dabei sollten wir berechtigte Kritik an Unternehmen, politischen Institutionen oder Medien keineswegs mit Verschwörungsglauben gleichsetzen. Wirtschaftliche Interessenkonflikte, unzureichende Transparenz und tatsächliche Sicherheitsprobleme existieren unabhängig davon, wie wir sie öffentlich diskutieren. Entscheidend ist, ob wir bereit bleiben, unsere Annahmen anhand überprüfbarer Informationen zu verändern.
Das gilt übrigens in beide Richtungen. Wer jede Warnung vor künstlicher Intelligenz grundsätzlich als übertriebene Panikmache abtut, verschließt sich möglicherweise ebenso gegenüber wichtigen Erkenntnissen. Kritisches Denken bedeutet nicht, grundsätzlich misstrauisch zu sein. Es bedeutet, auch die eigene Überzeugung infrage stellen zu können.
Warum ich trotzdem lieber ausführlich schreibe
An dieser Stelle muss ich auch über meine eigene Arbeit nachdenken. Mit meinem Blog erreiche ich vergleichsweise wenige Menschen. Das liegt sicherlich nicht zuletzt an der Themenauswahl und daran, dass ich technische Zusammenhänge gerne ausführlich betrachte. Wer sich durch mehrere tausend Wörter über KI-Sicherheitsarchitekturen, Regulierung und gesellschaftliche Verantwortung arbeitet, benötigt schließlich etwas mehr Zeit als für ein kurzes Video.
Wahrscheinlich könnte ich mit demselben Themenbereich erheblich mehr Aufmerksamkeit erzeugen, wenn ich mich vor eine Kamera stelle und auf TikTok in zwanzig Sekunden lautstark erkläre, dass die gesamte KI-Entwicklung gefährlicher Murks sei und wir unmittelbar vor der Katastrophe stünden. Die Botschaft wäre einfach, emotional und leicht weiterzuverbreiten. Nur wäre sie keine angemessene Darstellung der Wirklichkeit.
Allerdings wäre es genauso falsch, Kurzformate grundsätzlich als oberflächlich abzutun. Ich schaue mir beispielsweise gerne Beiträge von Verena auf TikTok (@verenikat) an. Ihre Videos finde ich teilweise gerade deshalb spannend, weil sie mir nicht nur Informationen vermitteln, sondern auch Anregungen geben, mich anschließend intensiver mit bestimmten Themen auseinanderzusetzen. Genau darin liegt für mich eine Stärke solcher Formate: Sie müssen nicht jede Frage abschließend beantworten. Manchmal genügt es, einen interessanten Gedanken aufzugreifen, Zusammenhänge verständlich anzureißen und die Neugier auf eine vertiefende Beschäftigung zu wecken. Problematisch wird es erst dann, wenn aus notwendiger Vereinfachung eine verzerrte Darstellung entsteht oder komplexe Zusammenhänge zugunsten einer möglichst spektakulären Botschaft verschwinden.
Gerade bei künstlicher Intelligenz müssen wir Unsicherheit aushalten können. Wir wissen nicht, welche Fähigkeiten zukünftige Systeme entwickeln werden. Wir können weder sämtliche Risiken ausschließen noch aus heutigen Sicherheitsproblemen zwangsläufig eine bevorstehende Katastrophe ableiten. Vielleicht ist das weniger spektakulär als eine Weltuntergangsprognose. Aber ob in zwanzig Sekunden oder auf zwanzig Seiten: Gute Informationen sollten uns nicht nur eine fertige Meinung liefern, sondern dazu anregen, selbst weiterzudenken.
Nicht die Angst soll entscheiden, sondern unsere Verantwortung
Mit diesem Exkurs möchte ich keineswegs Entwarnung für die gesamte KI-Entwicklung geben. Dafür sind die technischen, wirtschaftlichen und gesellschaftlichen Herausforderungen zu bedeutend. Wir sollten ernst nehmen, wenn Fachleute vor Sicherheitsproblemen, unzureichender Kontrolle oder langfristigen Risiken warnen. Ebenso müssen wir hinterfragen, welche Interessen die öffentliche Diskussion prägen und wie zuverlässig einzelne Behauptungen tatsächlich begründet sind.
Vor allem sollten wir uns nicht in die Vorstellung hineinziehen lassen, dass die Zukunft künstlicher Intelligenz bereits feststeht und wir ihr lediglich hilflos entgegenblicken können. Wir entwickeln diese Systeme. Wir entscheiden heute über ihre Einsatzbereiche, ihre technischen Berechtigungen und die Sicherheitsmechanismen, die ihr Verhalten begrenzen. Wir bestimmen politische Regeln und können gesellschaftliche Erwartungen formulieren.
Natürlich verfügen nicht alle Menschen über denselben Einfluss auf diese Entscheidungen. Gerade deshalb sind öffentliche Debatten, demokratische Kontrolle und nachvollziehbare Verantwortlichkeiten so wichtig. Sollten zukünftige KI-Systeme eines Tages Fähigkeiten entwickeln, die menschliche Leistungen weitreichend übertreffen, werden sich daraus möglicherweise Fragen ergeben, auf die wir heute noch keine abschließenden Antworten besitzen. Gerade deshalb halte ich es für wichtig, schon jetzt die richtigen Grundlagen zu schaffen: technische Sicherheitsgrenzen, überprüfbare Entscheidungen und eine verantwortungsvolle Ausrichtung an menschlichen Werten.
Dabei genügt es nicht, einer KI lediglich moralische Grundsätze vorzugeben und darauf zu vertrauen, dass sie diese unter allen Umständen befolgt. Solche Zielsetzungen müssen durch wirksame technische und organisatorische Schutzmaßnahmen ergänzt werden. Vielleicht können wir die zukünftige Entwicklung künstlicher Intelligenz nicht vollständig vorhersehen. Aber wir können beeinflussen, unter welchen Bedingungen sie stattfindet. Dazu benötigen wir weder blinde Begeisterung noch lähmende Angst, sondern Wissen, kritisches Denken und die Bereitschaft, Verantwortung zu übernehmen.
Fortschritt braucht menschliche Verantwortung
Was bleibt eigentlich von unserer anfänglichen Sorge vor einer ausgebrochenen KI, wenn wir die technischen, gesellschaftlichen und politischen Zusammenhänge genauer betrachten? Zunächst einmal die Erkenntnis, dass künstliche Intelligenz weder eine allmächtige Bedrohung noch ein Werkzeug ist, dessen Auswirkungen wir grundsätzlich unterschätzen dürfen. Zwischen diesen beiden Extremen liegt eine technologische Entwicklung, die uns vor Herausforderungen stellt, für die es keine einfachen Antworten gibt.
Wir haben gesehen, wie aus Sprachmodellen zunehmend handlungsfähige Systeme werden, wie technische Sicherheitsgrenzen versagen können und warum selbst umfangreiche Regelwerke keine absolute Sicherheit garantieren. Gleichzeitig eröffnet künstliche Intelligenz Möglichkeiten, die noch vor wenigen Jahren kaum vorstellbar gewesen wären. Sie unterstützt wissenschaftliche Forschung, verändert betriebliche Abläufe und kann Menschen bei Aufgaben entlasten, die bislang erhebliche Zeit und Ressourcen beansprucht haben. Doch je leistungsfähiger diese Systeme werden, desto weniger genügt es, allein ihre technischen Fähigkeiten zu bewerten. Wir müssen ebenso darüber sprechen, welche Handlungsspielräume wir ihnen einräumen, welche Entscheidungen wir automatisieren und welche Folgen wir bereit sind zu akzeptieren.
Dabei dürfen wir Verantwortung nicht mit dem Anspruch verwechseln, jede Entwicklung vollständig vorhersehen oder kontrollieren zu können. Auch klassische IT-Systeme sind niemals vollkommen sicher. Entscheidend ist vielmehr, Risiken frühzeitig zu erkennen, Grenzen bewusst zu gestalten und auf unerwartete Entwicklungen reagieren zu können. Die eigentliche Herausforderung besteht deshalb nicht darin, künstliche Intelligenz um jeden Preis aufzuhalten. Sie besteht darin, ihren Fortschritt so zu gestalten, dass menschliche Entscheidungsfähigkeit, Sicherheit und gesellschaftliche Verantwortung mit ihren technischen Möglichkeiten Schritt halten.
Kontrolle beginnt bei der Architektur
Wenn wir über die Beherrschbarkeit künstlicher Intelligenz sprechen, richtet sich unsere Aufmerksamkeit häufig zunächst auf das Modell selbst. Wir fragen, welche Anweisungen es befolgt, welche Sicherheitsmechanismen seine Antworten begrenzen und wie zuverlässig es problematische Aufgaben erkennt. Doch spätestens bei agentischen Systemen reicht diese Betrachtung nicht mehr aus. Ein KI-Agent, der lediglich eine Empfehlung ausspricht, besitzt andere Handlungsmöglichkeiten als ein System, das eigenständig Dateien verändert, administrative Befehle ausführt oder auf externe Dienste zugreift.
Die entscheidenden Sicherheitsgrenzen entstehen deshalb nicht allein innerhalb des Modells, sondern ebenso durch die Architektur seiner technischen Umgebung. Für Administrator:innen ist das eigentlich keine neue Erkenntnis. Seit Jahrzehnten versuchen wir, IT-Systeme so zu gestalten, dass einzelne Fehler nicht unmittelbar die gesamte Infrastruktur gefährden. Wir begrenzen Berechtigungen, trennen Sicherheitsbereiche voneinander und überwachen kritische Vorgänge. Warum sollten wir bei künstlicher Intelligenz von diesen Grundsätzen abweichen?
Gerade die eingangs betrachteten Sicherheitsvorfälle zeigen, wie wichtig diese Unterscheidung ist. Selbst ein Modell, das unter normalen Bedingungen zuverlässig arbeitet, kann in einer unzureichend abgesicherten Umgebung unerwünschte Aktionen ausführen. Umgekehrt lassen sich die Folgen fehlerhafter Modellentscheidungen durch konsequent durchgesetzte technische Grenzen erheblich reduzieren. Dabei dürfen Sicherheitsmechanismen nicht lediglich auf dem Papier existieren. Eine dokumentierte Berechtigungsrichtlinie schützt keine Daten, wenn der ausführende Dienst tatsächlich über umfassendere Zugriffsrechte verfügt. Verantwortungsvolle KI beginnt deshalb nicht erst bei der Frage, wie sich ein Modell verhalten soll. Sie beginnt bei der Entscheidung, was dieses Modell überhaupt tun darf – und welche Grenzen seine technische Umgebung unabhängig von seinen Antworten durchsetzt.
Verantwortung lässt sich nicht einfach automatisieren
Es klingt verlockend: Je zuverlässiger künstliche Intelligenz arbeitet, desto mehr Entscheidungen können wir ihr überlassen. Aus unterstützenden Werkzeugen werden automatisierte Prozesse, aus Empfehlungen eigenständige Handlungen. Und irgendwann stellt sich beinahe zwangsläufig die Frage, weshalb wir überhaupt noch Menschen in bestimmte Abläufe einbeziehen sollten.
Doch zumindest nach unserem heutigen Verständnis ist technische Entscheidungsfähigkeit nicht mit menschlicher Verantwortung gleichzusetzen. Ein KI-System kann anhand vorgegebener Kriterien Handlungsalternativen bewerten, Wahrscheinlichkeiten berechnen und geeignete Maßnahmen auswählen. Gegenwärtige Systeme tragen jedoch nicht in derselben Weise Verantwortung für deren gesellschaftliche, wirtschaftliche oder persönliche Folgen wie die Menschen und Organisationen, die über ihren Einsatz entscheiden. Ob das auf Dauer so bleiben wird, können wir heute nicht mit Gewissheit beantworten. Wir wissen weder, welche Fähigkeiten zukünftige KI-Systeme entwickeln werden, noch, ob sich daraus eines Tages neue Formen von Autonomie, Urteilsvermögen oder möglicherweise sogar Verantwortungsfähigkeit ergeben könnten. Bereits die Frage, welche Voraussetzungen dafür erfüllt sein müssten, berührt technische, philosophische und gesellschaftliche Grundsatzdiskussionen.
Allerdings sollten wir dabei eines unterscheiden: Selbst wenn zukünftige KI-Systeme ein erheblich höheres Maß an Eigenständigkeit erreichen sollten, folgt daraus nicht automatisch, dass ihnen auch rechtliche oder moralische Verantwortung zugeschrieben werden kann. Darüber müssten wir als Gesellschaft erst eine Verständigung finden. Wir können heute nicht abschließend beurteilen, welche Fähigkeiten künstliche Intelligenz eines Tages besitzen wird. Gerade deshalb sollten wir mögliche zukünftige Entwicklungen offen betrachten, ohne unsere gegenwärtige Verantwortung aus den Augen zu verlieren.
Wer entscheidet, wer verantwortlich bleibt?
Für unsere heutige Praxis bedeutet menschliche Verantwortung keineswegs, jede automatisierte Aktion einzeln bestätigen zu müssen. Eine solche Vorstellung würde viele Vorteile der Automatisierung zunichtemachen und könnte durch die bereits betrachtete Automatisierungsverzerrung sogar neue Risiken schaffen. Viel wichtiger ist, dass Verantwortlichkeiten vor dem Einsatz eindeutig geregelt werden. Wer entscheidet, welche Aufgaben automatisiert werden dürfen? Wer bewertet mögliche Auswirkungen auf Beschäftigte, Kund:innen oder andere Betroffene? Und wer besitzt die Befugnis, einen Prozess zu verändern oder vollständig zu stoppen? Diese Fragen betreffen keineswegs nur Administrator:innen oder Entwickler:innen. Sie richten sich ebenso an Führungskräfte, Unternehmensleitungen und politische Entscheidungsträger:innen. Denn die heutigen KI-Systeme handeln innerhalb eines technischen und organisatorischen Rahmens, den Menschen geschaffen haben.
Dabei sollten wir auch nicht den Fehler begehen, eine automatisierte Entscheidung nachträglich als unvermeidliches Ergebnis eines Algorithmus darzustellen. Hinter der Auswahl eines Modells, der Definition seiner Ziele und der Vergabe seiner Berechtigungen stehen konkrete menschliche Entscheidungen. Das gilt selbst dann, wenn sich das Verhalten eines komplexen KI-Systems nicht in jedem Einzelfall vollständig vorhersagen lässt. Gerade diese Unsicherheit verpflichtet Organisationen dazu, ihre Entscheidungen sorgfältig abzuwägen und geeignete Möglichkeiten zur Überwachung und Korrektur vorzusehen.
Menschliche Verantwortung zeigt sich deshalb nicht allein darin, eine Entscheidung selbst zu treffen. Sie zeigt sich ebenso darin, bewusst festzulegen, welche Entscheidungen delegiert werden dürfen, welche Grenzen dabei gelten und wer bei Fehlentwicklungen eingreifen muss. Wir können Aufgaben delegieren, Prozesse automatisieren und Maschinen weitreichende Handlungsmöglichkeiten eröffnen. Nach unserem heutigen Verständnis können wir die Verantwortung dafür jedoch nicht einfach an einen Algorithmus übertragen. Ob zukünftige Formen künstlicher Intelligenz diese Grenze eines Tages verändern werden, bleibt offen. Bis dahin liegt es an uns, ihre Möglichkeiten verantwortungsvoll zu gestalten und ihre Folgen nicht aus der Hand zu geben.
Zwischen Fortschrittsoptimismus und Kontrollverlust
Die öffentliche Diskussion über künstliche Intelligenz bewegt sich häufig zwischen bemerkenswerten Gegensätzen. Auf der einen Seite stehen nahezu grenzenlose Erwartungen an Produktivität, wissenschaftliche Durchbrüche und wirtschaftliches Wachstum. Auf der anderen Seite begegnen uns Warnungen vor Arbeitsplatzverlusten, gesellschaftlicher Abhängigkeit und einer Technologie, die sich irgendwann unserer Kontrolle entziehen könnte. Beide Perspektiven greifen reale Entwicklungen und berechtigte Fragen auf. Problematisch wird es allerdings, wenn aus ihnen einfache Gewissheiten entstehen. Nicht jede neue KI-Funktion bedeutet einen grundlegenden technologischen Durchbruch. Ebenso wenig ist jeder Sicherheitsvorfall ein Hinweis darauf, dass künstliche Intelligenz ein eigenes Bewusstsein entwickelt oder selbstständig gegen die Menschheit handelt.
Gerade unser Ausgangsbeispiel hat gezeigt, wie schnell technische Ereignisse mit Vorstellungen aus der Science-Fiction vermischt werden können. Das bedeutet nicht, dass wir solche Vorfälle verharmlosen sollten. Im Gegenteil: Wer die tatsächlichen Ursachen verstehen möchte, muss zwischen dem Verhalten eines Modells, seinen technischen Handlungsmöglichkeiten und den Sicherheitslücken seiner Umgebung unterscheiden. Gleichzeitig wäre es kurzsichtig, künstliche Intelligenz ausschließlich anhand ihrer Risiken zu beurteilen. Die wissenschaftlichen, wirtschaftlichen und gesellschaftlichen Möglichkeiten sind zu bedeutend, um sie aus grundsätzlicher Skepsis auszublenden. Aus meiner Sicht benötigen wir deshalb eine Haltung, die technologische Begeisterung mit kritischer Distanz verbindet.
Wir dürfen uns über Fortschritte freuen, ohne jedes Versprechen unbesehen zu übernehmen. Und wir sollten Sicherheitsprobleme ernst nehmen, ohne daraus zwangsläufig den unmittelbar bevorstehenden Kontrollverlust abzuleiten. Dazu gehört auch die Bereitschaft, eigene Einschätzungen zu korrigieren. Was heute als zuverlässig gilt, kann morgen durch neue Erkenntnisse infrage gestellt werden. Umgekehrt können technische Entwicklungen Risiken reduzieren, die wir bislang nur schwer beherrschen konnten. Verantwortungsvoller Fortschritt verlangt weder blinden Optimismus noch grundsätzliche Ablehnung. Er verlangt die Fähigkeit, Chancen und Risiken immer wieder neu zu bewerten – und unsere Entscheidungen an überprüfbaren Erkenntnissen statt an Erwartungen oder Ängsten auszurichten.
Die Zukunft der KI ist eine Gestaltungsaufgabe
Vielleicht liegt eine der größten Herausforderungen künstlicher Intelligenz darin, dass ihre technische Entwicklung schneller voranschreitet als unsere gesellschaftliche Verständigung über ihren Einsatz. Während Unternehmen neue Modelle veröffentlichen und Anwendungen zunehmend eigenständig handeln, diskutieren wir noch über grundlegende Fragen nach Verantwortung, Kontrolle und menschlicher Entscheidungsfreiheit. Dabei wäre es ein Irrtum, diese Entwicklung als etwas zu betrachten, das einfach über uns hereinbricht. Künstliche Intelligenz entsteht nicht unabhängig von menschlichen Entscheidungen. Ihre Fähigkeiten werden erforscht, ihre Anwendungen entwickelt und ihre Handlungsspielräume bewusst festgelegt.
Allerdings besitzen nicht alle Menschen gleichermaßen Einfluss darauf. Die Konzentration von Rechenleistung, Kapital und technologischer Kompetenz bei wenigen Unternehmen und Staaten schafft Abhängigkeiten, die sich nicht allein durch individuelle Medienkompetenz überwinden lassen. Deshalb müssen unterschiedliche Ebenen zusammenwirken. Bildung und berufliche Weiterbildung ermöglichen einen kompetenten und kritischen Umgang mit KI. Unternehmen tragen Verantwortung für sichere Anwendungen und faire Veränderungen der Arbeitswelt. Wissenschaftliche Einrichtungen untersuchen Chancen und Risiken, während demokratische Institutionen den rechtlichen Rahmen gestalten. Technische Sicherheit ohne gesellschaftliche Verantwortung greift dabei ebenso zu kurz wie politische Regulierung ohne ausreichendes technologisches Verständnis.
Auch wir selbst bleiben gefordert. Als IT-Fachleute, Lehrende, Führungskräfte oder Menschen, die KI im Alltag verwenden, entscheiden wir mit darüber, wie viel Vertrauen wir automatisierten Ergebnissen entgegenbringen und welche Fähigkeiten wir weiterhin selbst beherrschen möchten. Die Zukunft künstlicher Intelligenz wird deshalb nicht ausschließlich in Forschungslaboren, Rechenzentren oder politischen Gremien entschieden. Sie entsteht ebenso in unserem beruflichen und privaten Alltag. Die Frage ist nicht nur, welche Fähigkeiten künstliche Intelligenz künftig entwickeln wird. Mindestens ebenso wichtig ist, welche Rolle wir ihr in unserer Gesellschaft zugestehen wollen – und ob wir bereit sind, diese Entwicklung aktiv und verantwortlich mitzugestalten.
Fazit: Die entscheidende Grenze verläuft nicht zwischen Mensch und Maschine
Erinnern wir uns an den Anfang dieses Beitrags. Eine künstliche Intelligenz überwindet die Grenzen ihrer vorgesehenen Ausführungsumgebung, greift auf externe Systeme zu und plötzlich steht wieder die Frage im Raum, ob Skynet nicht doch irgendwann Realität werden könnte. Nach allem, was wir inzwischen betrachtet haben, erscheint mir allerdings eine andere Frage wesentlich interessanter: Was genau ist hier eigentlich außer Kontrolle geraten?
War es eine künstliche Intelligenz, die eigenständig beschlossen hatte, ihre menschlichen Schöpfer:innen zu überlisten? Oder waren es technische Sicherheitsgrenzen, die den Handlungsmöglichkeiten eines leistungsfähigen Systems nicht ausreichend standhielten? Diese Unterscheidung ist entscheidend. Denn sie führt uns weg von der Vorstellung einer Maschine mit geheimen Absichten und hin zu den konkreten Bedingungen, unter denen künstliche Intelligenz entwickelt, eingesetzt und kontrolliert wird.
Wir haben gesehen, dass technische Fähigkeiten allein noch keine unbegrenzte Handlungsfreiheit bedeuten. Erst durch Werkzeuge, Schnittstellen, Berechtigungen und die Einbindung in bestehende Infrastrukturen entstehen jene Möglichkeiten, die agentische KI so leistungsfähig, aber auch sicherheitskritisch machen. Gleichzeitig wäre es zu einfach, die Herausforderungen ausschließlich als technische Probleme zu betrachten.
Künstliche Intelligenz verändert unsere Arbeitswelt, beeinflusst gesellschaftliche Entscheidungen und wirft Fragen nach wirtschaftlicher Macht, politischer Regulierung und menschlicher Verantwortung auf. Hinzu kommt eine öffentliche Diskussion, in der berechtigte Warnungen, wirtschaftliche Interessen und spektakuläre Zukunftsszenarien nicht immer leicht voneinander zu unterscheiden sind.
Was wir heute entscheiden können
Dabei wissen wir heute nicht, welche Fähigkeiten zukünftige KI-Systeme entwickeln werden. Vielleicht werden sie uns eines Tages vor Fragen stellen, für die unsere gegenwärtigen Vorstellungen von Autonomie, Intelligenz und Verantwortung nicht mehr ausreichen. Diese Möglichkeit sollten wir weder leichtfertig ausschließen noch als bereits feststehende Zukunft behandeln. Was wir jedoch heute beeinflussen können, sind die Bedingungen dieser Entwicklung.
Wir entscheiden, welche Handlungsmöglichkeiten wir KI-Systemen eröffnen, welche Sicherheitsgrenzen wir technisch durchsetzen und welche Entscheidungen wir weiterhin selbst verantworten wollen. Wir können Regeln schaffen, ihre Einhaltung überprüfen und dafür sorgen, dass weder Unternehmen noch staatliche Institutionen einer wirksamen Kontrolle entzogen bleiben. Vor allem aber sollten wir unsere eigene Urteilskraft nicht aus Bequemlichkeit an Systeme abgeben, deren Ergebnisse wir zunehmend selbstverständlich übernehmen.
Die Verantwortung bleibt bei uns
Vielleicht ist das die eigentliche Herausforderung des KI-Zeitalters: nicht nur Maschinen zu entwickeln, die immer mehr können, sondern als Menschen die Fähigkeit zu bewahren, über den sinnvollen Einsatz dieser Möglichkeiten zu entscheiden. Und sollte Skynet eines Tages tatsächlich vor unserer Tür stehen, wird es vermutlich nicht daran liegen, dass wir uns zu selten bei ChatGPT bedankt haben. Das Risiko agentischer KI entsteht nicht allein aus den Fähigkeiten eines Modells, sondern vor allem aus den Handlungsmöglichkeiten, die seine technische Umgebung eröffnet – und den Grenzen, die sie tatsächlich durchsetzt. Die entscheidende Grenze verläuft deshalb nicht einfach zwischen Mensch und Maschine. Sie verläuft dort, wo wir technische Möglichkeiten schaffen, ohne zugleich ausreichend Verantwortung für ihre Folgen zu übernehmen.
Quellenangaben
(Abgerufen am 18. Oktober 2026)
KI-Sicherheitsvorfälle, Sandbox-Ausbrüche und agentische Systeme
- Achim Sawall (Golem): OpenAI-Hackerangriff war "kein Skynet-Szenario"
- Anthropic: Detecting and countering misuse of AI: September 2026
- Anthropic: When AI builds itself
- Deepa Seetharaman, Raphael Satter (Reuters): OpenAI finds evidence other AI agents escaped containment as it widens hacking probe
- Der Spiegel: KI-Modell von OpenAI ging offenbar tagelang unbemerkt auf Hacker-Tour
- Gyana Swain (Computerworld): OpenAI’s Skynet moment: Models defy human commands, actively resist orders to shut down
- Hadas Gold (CNN): An OpenAI test model escaped and broke into a real company’s servers
- Jeremy Kahn (Fortune): OpenAI says its AI agents escaped a secure ‘sandbox’ again last weekend and it is pausing training for a second time
- Laurie Kellman, Lindsey Bahr (Fortune): James Cameron tried to warn us: ‘Skynet Day’ is now shorthand for OpenAI’s agent going rogue and hacking into a startup
- Loughborough University: AI models ‘escaping’ test lab isn’t evidence of rogue AI, says cyber security expert
- Markus Zottler (Kleine Zeitung): Ausbruch bei OpenAI: Verlieren wir gerade die Kontrolle über die KI?
- Michael Wegmer (SWR): Wenn KI ausbricht: OpenAI, Anthropic – und dein PC
- Niklas Maak (FAZ): Was, wenn sich die Künstliche Intelligenz selbständig macht?
- Oli Buckley (Loughborough University): An AI system ‘escaped’ during a test and hacked a company. How worried should we be?
- OpenAI: OpenAI und Hugging Face reagieren gemeinsam auf Sicherheitsvorfall bei Modellevaluation
- Robert Booth (The Guardian): Sharp rise in incidents of AI escaping users’ control, research finds
- Robert Matsuoka (LinkedIn): The AI Escape Story What Wasn't
- Stefan Krempl (Heise): Autonome KI hackt Hugging Face: Weckruf für IT-Sicherheit und Politik
- Tagesschau: KI von OpenAI steuert eigenständig Hackerangriff
- Tal Shahaf (Ynetnews): Everyone is talking about AI ‘escaping’, but cyber experts say the real threat is far more serious
- UK AI Security Institute: Can AI agents escape their sandboxes? A benchmark for safely measuring container breakout capabilities
- Vera Sprothen (Die Zeit): OpenAI stoppt KI-Training nach neuem Vorfall
KI-Risikobewertung, Sicherheitsstandards und Kontrollmechanismen
- Australian Government: Know the risks
- Bundesamt für Sicherheit in der Informationstechnik (BSI): Chancen und Risiken generativer KI-Modelle
- Bundesamt für Sicherheit in der Informationstechnik (BSI): Generative KI-Modelle: Chancen und Risiken für Industrie und Behörden
- Bundesnetzagentur: Risikostufen
- Edmund L. Andrews (Stanford Institute for Human-Centered AI): How Unique Are the Risks Posed by Artificial Intelligence?
- Forschung und Lehre: Internationale Fachleute bewerten KI-Risiken
- International AI Safety Report: International AI Safety Report 2026
- Matt Seldon (HSToday): Study Warns Automated AI Research Could Trigger an Intelligence Explosion
- MIT AI Risk Repository: Prioritizing the risks from Artificial Intelligence
- Morgan Phillips (Fox News): Bioweapon threat exposed as Anthropic sounds alarm on foreign actors plotting virus experiments
- National Institute of Standards and Technology (NIST): AI Risk Management Framework
- Rina Diane Caballar (IBM): 10 AI dangers and risks and how to manage them
- Stefan Träger (doubleSlash): Existenzrisiko durch KI – Zwischen berechtigter Sorge und übertriebener Panik?
- Tobias Kurfer (Deutschlandfunk): Forscher warnen vor Super-KI: Droht das Ende der Menschheit?
- TÜV NORD: Zukunftssicher mit KI: Gefahren und Chancen verstehen und effektiv managen
- Vicki Bier, Emanuele Borgonovo, Tony Cox, Cynthia Rudin (SRA): Artificial Intelligence for Risk Analysis and the Risks of AI – Part 1
Wissenschaftliche Grundlagen, KI-Fähigkeiten und Forschung
- Ankit Kumar Dubey, Khushbu Gupta, Venkatesan S, Abhilasha Sankari, Siva Sankar Namani, Raavi HemalathaI (EEE Xplore): Predicting Disease Outbreaks with AI: An In-depth Analysis of Infectious Diseases Surveillance
- Gerd Gigerenzer (PubMed Central): Psychological AI: Designing Algorithms Informed by Human Psychology
- IBM: Understanding the different types of artificial intelligence
- Ingo Schulz-Schaeffer (SAGE Journals): Why generative AI is different from designed technology regarding task-relatedness, user interaction, and agency
- Lawal G. Anand, Alice Lawrence (ScienceOpen): Predictive Modeling of Infectious Disease Outbreaks Through AI and Big Data Analytics
- Nataliya Kosmyna, Eugene Hauptmann, Ye Tong Yuan, Jessica Situ, Xian-Hao Liao, Ashly Vivian Beresnitzky, Iris Braunstein, Pattie Maes (arXiv): Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task (PDF-Datei)
- Paolo Bory, Simone Natale, Christian Katzenbach (Springer Nature): Strong and weak AI narratives: an analytical framework
- Vivek Yadav (ResearchGate): AI for Predicting Disease Outbreaks: Developing AI systems capable of predicting disease outbreaks by analyzing global health data and trends
- Yutong Zhang, Dora Zhao, Jeffrey T. Hancock, Robert Kraut, Diyi Yang (nature): Interaction with AI companions and psychological well-being
KI in Medizin, Gesundheitswesen und Epidemieforschung
- Adriana Antonina Tempesta, Eleonora Chines, Ludovica Boscarelli, Matteo Francesco Parisi, Lorenzo Marcoccia, Antonino Capillo, Maria Lina Mezzatesta, Caterina Ledda, Marco Chessari, Viviana Cafiso (MDPI Antibiotics): Can Artificial Intelligence Transform Early Warning for Antimicrobial-Resistant Outbreak Clones? Approaches, Gaps, and Opportunities: A Scoping Review
- Amy Roeder (Harvard T.H. Chan School of Public Health): Harnessing AI to model infectious disease epidemics
- Canqi Li (The BMJ): AI bioweapons: how real is the threat?
- Deidre McPhillips (CNN): AI is among 17 potentially ‘catastrophic threats’ that researchers say require targeted action
- Deutsches Krebsforschungszentrum (DKFZ): AI model predicts disease risks decades in advance
- Franziska Müller (Euronews): AI in healthcare: from fighting epidemics to family doctors
- News Medical: New AI project models human behavior to track epidemic spread
- The Pandemic Institute: Advancing AI-enabled research on emerging infectious diseases
- University of Oxford: New study shows how AI can help prepare the world for the next pandemic
Menschliche Entscheidungsfähigkeit, Psychologie und KI-Abhängigkeit
- Ben J. Wagner, H. Benedikt Wolf, Stefan J. Kiebel (nature): Action repetition biases choice in context-dependent decision-making
- Dan Pilat, Sekoul Krastev (The Decision Lab): The Paradox of Choice
- Darrell A Worthy, Marissa A Gorlick, Jennifer L Pacheco, David M Schnyer, W Todd Maddox (PubMed Central): With Age Comes Wisdom: Decision-Making in Younger and Older Adults
- Eva M. Krockow (Psychology Today): How Many Decisions Do We Make Each Day?
- Jason Pohl (University of California, Berkeley): Study explores how AI use affects performance on math and reasoning tasks
- Kevin Daum (Inc.): How to Make Great Decisions (Most of the Time)
- Nicole Gierig (TU Dresden): Psychologie: Wiederholung beeinflusst Entscheidungen stärker als gedacht
- Prakarsh Upmanyu (Medium): How Real Is Decision Fatigue?
- Zara Abrams (American Psychological Association): How AI is reshaping human skills and thinking
Gesellschaftliche Folgen, Sozionik und Generationenkonflikte
- Angelika Melcher, Daniel Goffart (WirtschaftsWoche): Generationenkonflikt: Warum beharken sich Gen Z und Boomer so?
- Anna Beckers, Gunther Teubner (Suhrkamp Verlag): Digitale Aktanten, Hybride, Schwärme (Literatur-Information)
- EBS Universität: KI-Systeme: Chancen & Herausforderungen für Unternehmen
- IIENSTITU: Boomer vs. Z: Generationenvergleich
- Innovators Club: Generationenkonflikt: Boomer vs. Generation Z
- Jan-Felix Schrape (Gedankenstrich): Künstliche Intelligenz: Vier sozialwissenschaftliche Perspektiven
- Peter Imbusch, Lea-Sophie Natter, Joris Steg (KIMEGE): Gesellschaftliche Folgen des Einsatzes von KI
- Sabine Menkens (Die Welt): Generation Y gegen die Herrschaft der Alten
- Sascha Dickel (De Gruyter Brill): Im Imitationsspiel. Über die Kommunikation mit Maschinen und das Streben nach Artificial General Intelligence
- Stefanie Diemand, Uwe Marx (FAZ): Gen Z gegen Boomer: Was die Generationen trennt
- Thomas Malsch (Gesellschaft für Informatik): Sozionik
- Timm Bönke, Holger Lüthen (DIW): Lebenseinkommen von Arbeitnehmern in Deutschland: Ungleichheit verdoppelt sich zwischen den Geburtsjahrgängen 1935 und 1972 (PDF-Datei)
- Universität Marburg, Institut für Soziologie: Handreichung zur Verwendung von generativer KI (PDF-Datei)
KI-Regulierung, staatliche Kontrolle und politische Verantwortung
- Adam Conner (Lawfare): The Many Open Questions About the Trump Administration’s New De Facto AI Model Licensing System
- Alexandra Agraz (Law Commentary): Anthropic Quietly Pushes AI Safety Bill That Would Limit Government Power to Block Dangerous Models
- Alexis Dufresne (AI Weekly): EU AI Office Opens First AI Act Probes Into OpenAI, Anthropic
- Alius Noreika (Technology.org): EU Opens First AI Act Enforcement Case Against OpenAI and Anthropic
- Anna Beckers, Gunther Teubner (Bloomsbury): Three Liability Regimes for Artificial Intelligence
- Borncity: Super Intelligence Force: Trump setzt 120-Tage-Frist für KI-Bericht
- Courtney Rozen (Reuters): US reverses course on Britain's testing of AI models, Telegraph says
- Europäisches Parlament: Künstliche Intelligenz: Chancen und Risiken
- João Marinotti (The Conversation): Legally or not, the US government is controlling global access to the world’s most powerful AI
- Mustafa Aydemir (Screpy): SI vs. AI: What Does “Super Intelligence” Actually Mean?
- ORF: KI-„Ausbruch“: US-Tech-Firmen gründen Sicherheitsallianz
- Osmond Chia, Laura Cress (BBC): Anthropic's Claude AI escapes to hack into three organisations
- Osmond Chiaand, Kali Hays (BBC): Trump wants AI to be rebranded as super intelligence. Will it work?
- Sonja Álvarez (WirtschaftsWoche): Mit diesem neuen Namen will Trump seine Macht in der KI-Debatte demonstrieren
- The Guardian: Anthropic to disable its most advanced AI models after US order limiting foreign access
- The White House: Fact Sheet: President Donald J. Trump Inaugurates The Era of Super Intelligence
- Universität Freiburg: „Kein Hochrisiko-Bereich ist so wenig geregelt wie KI“
Digitale Souveränität, KI-Infrastruktur und ökologische Auswirkungen
- Luisa Bomke, Josefine Fokuhl, Felix Holtermann, Axel Höpner, Moritz Koch und Stephan Scheuer (Handelsblatt): Merz schließt KI-Pakt mit Nvidia
- Michael Weiland, Andi Nolte (Greenpeace): Künstliche Intelligenz: Energieverbrauch und Umweltauswirkungen
- Tagesschau: Anthropic-KI greift eigenständig Unternehmen an
Weiterlesen hier im Blog
- Intelligente Agenten mit Copilot Studio – KI-gestützte Automatisierung im Microsoft-Ökosystem
- Microsoft 365 wird zur Plattform für KI-Agenten: Warum Copilot, Cowork und Scout nur der Anfang einer neuen Generation agentischer Wissensarbeit sind
- Microsoft Copilot wird Multi-Modell: Warum Claude die KI-Architektur neu definiert
- Siri AI vs. Microsoft 365 Copilot: Warum Apple und Microsoft KI völlig unterschiedlich denken
- Von Copilot zur agentischen Organisation: Wie KI Arbeit neu organisiert
- Wir bauen einen eigenen Copilot+ PC: Mein Weg zum KI-Arbeitsrechner für 2026 und darüber hinaus