
Wenn lokale Kommunikation nicht mehr ausreicht
Hinweis zur Aktualisierung
Dieser Beitrag wurde ursprünglich am 12. Juli 2025 veröffentlicht und am 31. August 2026 umfassend überarbeitet. Dabei habe ich nicht nur einzelne Inhalte aktualisiert, sondern den Beitrag fachlich, strukturell und redaktionell grundlegend weiterentwickelt. Die Erläuterungen zu IPv4-Adressierung, Netzwerkerkennung, Routing, Subnetting und CIDR wurden deutlich vertieft und um historische Zusammenhänge ergänzt. NAT und PAT, IPv6 sowie TCP, UDP und QUIC werden nun wesentlich differenzierter betrachtet. Hinzugekommen sind außerdem vertiefende Abschnitte zu MTU und Path MTU Discovery, Fragmentierung, ICMP, Multicast und Anycast sowie zur praktischen Bedeutung dieser Mechanismen in modernen Netzwerkarchitekturen.
Auch die historische Entwicklung wurde erweitert – unter anderem um die Entstehung von TCP/IP, die Entwicklung von der klassenbasierten IPv4-Adressierung zu CIDR und einen Exkurs zur vermeintlich übersprungenen Protokollversion IPv5. Zahlreiche Beispiele, Binärdarstellungen und Praxisbezüge wurden neu aufgebaut oder präzisiert.
Im Zuge der Überarbeitung habe ich zudem die Quellenbasis erheblich erweitert und stärker auf RFCs sowie Dokumentationen von IETF, IANA und weiteren fachlich relevanten Institutionen ausgerichtet. Der Beitrag fügt sich damit zugleich klarer als zweiter Teil in meine Artikelreihe zur technischen Entwicklung moderner Netzwerkkommunikation ein.
In meinem letzten Beitrag habe ich erläutert, wie elektrische und optische Signale, physikalische Verbindungen, Ethernet-Frames und MAC-Adressen die Grundlage moderner Netzwerkkommunikation bilden. Auf Layer 1 und 2 des OSI-Modells bewegen wir uns dabei zunächst in einer lokalen Welt: Bits werden übertragen, Frames weitergeleitet und Geräte innerhalb eines gemeinsamen Netzes miteinander verbunden.
Doch an den Grenzen dieses Netzes endet die Aufgabe von Ethernet nicht etwa erfolglos – vielmehr beginnt eine neue Ebene der Kommunikation. Ein Rechner in Dortmund muss nicht wissen, über welche Switches und Übertragungsmedien ein Server in Frankfurt, Dublin oder Singapur physisch erreichbar ist. Stattdessen benötigt er eine logische Adresse und einen Mechanismus, mit dem Daten über viele unterschiedliche Netze hinweg an ihr Ziel gelangen können.
Genau hier übernimmt die Vermittlungsschicht, Layer 3. Mit dem Internet Protocol erhält Kommunikation eine netzübergreifende Adressierung. Hosts entscheiden, ob ein Ziel unmittelbar erreichbar ist oder ein Router die Weiterleitung übernehmen muss. Router wiederum treffen auf jedem Abschnitt des Weges neue Entscheidungen darüber, wohin ein Paket als Nächstes weitergeleitet wird.
Damit ist die Kommunikation allerdings noch nicht vollständig beschrieben. Eine IP-Adresse identifiziert schließlich keinen Webserver, keinen DNS-Dienst und keine konkrete Anwendung. Auf Layer 4, der Transportschicht, kommen deshalb unter anderem Ports und Transportprotokolle ins Spiel.

TCP kann eine zuverlässige, geordnete Übertragung zwischen Endpunkten bereitstellen, während UDP bewusst ein schlankeres, verbindungsloses Modell verfolgt. Mit QUIC begegnet uns später zudem ein moderner Ansatz, der zeigt, wie sich die Grenzen klassischer Transportkonzepte weiterentwickeln.
Von der lokalen Verbindung zur Ende-zu-Ende-Kommunikation
Dieser zweite Teil der Reihe setzt genau dort an, wo der erste aufgehört hat: an der Grenze des lokalen Netzes. Ethernet und MAC-Adressen verschwinden dabei keineswegs. Ein IP-Paket muss auf jedem einzelnen Übertragungsabschnitt weiterhin über die jeweils vorhandene Netzzugangstechnologie transportiert werden. Die Perspektive verändert sich jedoch: Statt eines einzelnen Links oder LANs betrachten wir nun den Weg zwischen Netzen und schließlich zwischen Anwendungen.
Dabei führt dieser Weg zwangsläufig auch durch die Geschichte des Internets. IPv4, Subnetting, CIDR und NAT lassen sich kaum sinnvoll verstehen, wenn man nur ihren heutigen Zustand betrachtet. Viele dieser Mechanismen sind Antworten auf Herausforderungen, die erst mit dem enormen Wachstum des Internets entstanden sind. IPv6 wiederum zeigt, welche Entscheidungen anders getroffen werden können, wenn Adressierung und Paketvermittlung für eine wesentlich größere Infrastruktur entworfen werden.
Von IPv4 und Routing bis zu IPv6
Wir werden deshalb untersuchen, wie Hosts zwischen lokalen und entfernten Zielen unterscheiden, wie Router Weiterleitungsentscheidungen treffen und wie sich die IPv4-Adressierung vom klassenbasierten Modell zu CIDR entwickelt hat. Dabei betrachten wir Subnetting, NAT und die zunehmende Knappheit öffentlicher IPv4-Adressen ebenso wie die Architektur von IPv6.
Ein historischer Exkurs führt außerdem zu ST und ST-II und damit zu der Frage, weshalb zwischen IPv4 und IPv6 scheinbar eine Versionsnummer fehlt. Gerade diese Entwicklung lässt sich anhand der ursprünglichen RFCs nachvollziehen und zeigt, dass viele heute selbstverständliche Strukturen das Ergebnis einer jahrzehntelangen technischen Evolution sind.
Wenn Layer 4 die Anwendungen verbindet
Anschließend wechseln wir konsequent auf Layer 4: zu TCP und UDP, Ports und Verbindungen sowie zu der Frage, wie Anwendungen Transportdienste nutzen. Mit QUIC reicht die Betrachtung bis zu einer Transportarchitektur, die längst Bestandteil moderner Internetkommunikation ist. RFC 768, die historische TCP-Spezifikation RFC 793, deren heutiger Nachfolger RFC 9293 sowie RFC 9000 für QUIC bilden dafür eine belastbare technische Grundlage.
Der Anspruch bleibt dabei derselbe wie im ersten Teil der Reihe: Es geht nicht darum, möglichst viele Protokolle und RFC-Nummern aufzuzählen. Entscheidend ist, warum diese Mechanismen existieren, wie sie zusammenspielen und was dieses Wissen für Administration und Fehlersuche in heutigen Netzwerken bedeutet. Denn bevor Anwendungen miteinander sprechen, Identitäten geprüft oder Verbindungen abgesichert werden können, müssen zwei grundlegende Fragen beantwortet sein: Wohin müssen die Daten – und mit welchen Eigenschaften werden sie zwischen den beteiligten Anwendungen transportiert?
Mit diesen beiden Fragen bewegen wir uns mitten in der Welt von Layer 3 und Layer 4 – und damit in der Welt der Pakete, die reisen lernen.
TCP/IP – vom ARPANET zum Fundament des Internets
Bevor wir uns mit IP-Adressierung, Routing und Transportmechanismen beschäftigen, lohnt sich ein Blick zurück. Denn viele Eigenschaften von TCP/IP lassen sich besser verstehen, wenn deutlich wird, welches Problem diese Architektur ursprünglich lösen sollte.
Die Wurzeln des heutigen Internets reichen bis in die 1960er Jahre zurück. Die damalige Advanced Research Projects Agency (ARPA) des US-Verteidigungsministeriums förderte Forschungsprojekte zur Vernetzung räumlich getrennter Computersysteme. Die 1958 gegründete Behörde war selbst eine Reaktion auf den technologischen Wettbewerb des Kalten Krieges und insbesondere auf den sowjetischen Sputnik-Erfolg von 1957.
Aus dieser Forschungsarbeit entstand das ARPANET. 1969 verband es zunächst vier Standorte: die University of California in Los Angeles, das Stanford Research Institute, die University of California in Santa Barbara und die University of Utah. Die Dimensionen erscheinen aus heutiger Sicht beinahe bescheiden: vier angeschlossene Hosts und ein Backbone mit 50 Kbit/s markieren den Ausgangspunkt einer Entwicklung, aus der später eine globale Kommunikationsinfrastruktur entstehen sollte.
Das ARPANET war damit ein entscheidender Meilenstein der Paketvermittlung und eine wesentliche Grundlage für das spätere Internet. Die häufig verwendete Bezeichnung als schlicht erstes paketvermittelndes Computernetz der Welt greift allerdings zu kurz. Konzepte und praktische Arbeiten zur Paketvermittlung entstanden in dieser Zeit auch an anderer Stelle.
Für unsere Betrachtung ist ohnehin etwas anderes entscheidend: Das ARPANET zeigte, dass sich unterschiedliche Computersysteme über eine gemeinsame paketvermittelnde Infrastruktur miteinander verbinden ließen.
Vom Netzwerk zum Netzwerk der Netzwerke
Zunächst kommunizierten die Systeme im ARPANET über das Network Control Protocol (NCP). Doch mit der weiteren Entwicklung entstand eine wesentlich größere Herausforderung. Nicht mehr nur unterschiedliche Computer innerhalb eines gemeinsamen Netzes sollten Daten austauschen. Vielmehr sollten unterschiedliche paketvermittelnde Netze und Übertragungstechnologien miteinander verbunden werden können.
Genau an diesem Punkt beginnt die eigentliche Geschichte des Internetworking. In den 1970er Jahren arbeiteten unter anderem Robert Kahn und Vinton Cerf an einer Architektur, die Kommunikation über die Grenzen einzelner Netze hinweg ermöglichen sollte. Dabei durfte nicht vorausgesetzt werden, dass alle beteiligten Netze dieselbe Übertragungstechnologie, Geschwindigkeit oder interne Struktur verwendeten. Der entscheidende Gedanke bestand deshalb nicht darin, ein einziges immer größeres Netzwerk zu bauen. Stattdessen sollten eigenständige Netze miteinander kommunizieren können. Dieser Architekturgedanke steckt bis heute im Begriff Internet: Es handelt sich um ein Netzwerk von Netzwerken.
Für unseren Blick auf Layer 3 ist das entscheidend. IP soll nicht die Eigenschaften jedes einzelnen Übertragungsmediums vereinheitlichen. Stattdessen schafft das Protokoll eine gemeinsame logische Ebene, über die Daten unterschiedliche Netze durchqueren können. Was darunter auf dem jeweiligen Link geschieht, kann sich von Abschnitt zu Abschnitt deutlich unterscheiden.
Aus TCP werden TCP und IP
Auch TCP und IP entstanden nicht sofort in der Form, in der wir sie heute kennen. Die frühen Arbeiten von Cerf und Kahn gingen zunächst von einem umfassenderen Transmission Control Program aus. Im weiteren Verlauf wurden dessen Aufgaben voneinander getrennt: Das Internet Protocol übernahm die grundlegende Adressierung und Vermittlung von Datagrammen, während TCP darüber Transportfunktionen bereitstellte. Diese Trennung gehört zu den wichtigsten Architekturentscheidungen des Internets. Sie ermöglicht es, Vermittlung und Transport unabhängig voneinander zu betrachten und weiterzuentwickeln.
Im September 1981 erschienen mit RFC 791 für IPv4 und RFC 793 für TCP zwei Spezifikationen, die für die weitere Entwicklung prägend wurden. RFC 793 ist inzwischen vor allem eine historische Referenz: Seit 2022 bildet RFC 9293 die konsolidierte Basisspezifikation für TCP.
Daran zeigt sich bereits etwas, das uns im weiteren Verlauf dieses Beitrags häufiger begegnen wird: TCP/IP ist keine seit den frühen 1980er Jahren unverändert gebliebene Technologie. Die grundlegende Architektur hat sich als außerordentlich langlebig erwiesen, ihre Protokolle und Mechanismen wurden jedoch kontinuierlich präzisiert und weiterentwickelt.
1983: Der entscheidende Wechsel zu TCP/IP
Am 1. Januar 1983 erfolgte schließlich die Umstellung des ARPANET von NCP auf TCP/IP. Dieser Stichtag wird häufig als Flag Day bezeichnet: Die angeschlossenen Systeme mussten für die weitere Kommunikation TCP/IP unterstützen, das bisher verwendete NCP wurde abgelöst. Anders als bei vielen heutigen Migrationen war damit ein klar definierter Zeitpunkt für den Wechsel auf die neue Protokollarchitektur vorgegeben. Dieses Datum wird deshalb häufig auch als eine Art Geburtstag des modernen Internets bezeichnet. Treffender ist es jedoch, darin einen entscheidenden architektonischen Wendepunkt zu sehen: TCP/IP schuf eine gemeinsame Grundlage, auf der unterschiedliche Netze miteinander kommunizieren konnten.
Die Dimensionen waren zu diesem Zeitpunkt noch vergleichsweise überschaubar. 1983 waren rund 562 Hosts verzeichnet. Nur gut ein Jahrzehnt zuvor, 1972, waren es 23 gewesen; Ende der 1970er und Anfang der 1980er Jahre lag ihre Zahl bereits bei über 200. Was zunächst nach einem stetigen Wachstum aussieht, entwickelte jedoch schnell eine ganz andere Dynamik. Mitte der 1980er Jahre wurde die Marke von 1.000 Hosts überschritten, für den Zeitraum 1986 bis 1988 waren bereits rund 56.000 Hosts verzeichnet. 1990 waren es etwa 313.000, Anfang der 1990er Jahre schließlich mehr als eine Million. Damit begann eine Architektur, die für die Verbindung unterschiedlicher Netze entwickelt worden war, in eine völlig neue Größenordnung hineinzuwachsen.
Eine Architektur beginnt zu skalieren
Diese Entwicklung ist weit mehr als eine historische Randnotiz. Sie erklärt einen erheblichen Teil der technischen Evolution, mit der wir uns in den folgenden Kapiteln beschäftigen werden. Innerhalb weniger Jahre musste dieselbe grundlegende Architektur nicht mehr Hunderte, sondern Zehntausende und schließlich Millionen miteinander verbundener Systeme tragen. Mehr Hosts bedeuteten einen steigenden Bedarf an IP-Adressen. Mehr Netze bedeuteten zugleich mehr Informationen, die zwischen Routern ausgetauscht und bei Weiterleitungsentscheidungen berücksichtigt werden mussten.
Damit zeichneten sich zwei Skalierungsprobleme ab, die uns noch mehrfach begegnen werden: Wie lässt sich ein begrenzter Adressraum effizient nutzen – und wie lässt sich eine ständig wachsende Zahl von Netzen effizient vermitteln? Subnetting, CIDR und Route Aggregation sind vor diesem Hintergrund keine isolierten technischen Kunstgriffe. Auch die spätere Verbreitung von NAT und schließlich die Entwicklung von IPv6 lassen sich besser verstehen, wenn man diese Wachstumsgeschichte berücksichtigt.
Das ARPANET selbst wurde 1990 außer Betrieb genommen. Die Idee des Internetworking hatte sich zu diesem Zeitpunkt längst von ihrem ursprünglichen Forschungsnetz gelöst. Das Internet benötigte das ARPANET nicht mehr – wohl aber die grundlegenden Architekturprinzipien, die in dieser Entwicklungsphase entstanden waren.
TCP und IP – bewusst getrennte Aufgaben
Obwohl wir meistens gemeinsam von TCP/IP sprechen, erfüllen beide Protokolle grundlegend unterschiedliche Aufgaben. IP stellt die netzübergreifende Adressierung und Vermittlung von Datagrammen bereit. Es arbeitet nach dem Best-Effort-Prinzip. IP garantiert weder, dass ein Datagramm sein Ziel erreicht, noch dass mehrere Datagramme in der ursprünglichen Reihenfolge eintreffen.
TCP setzt auf dieser Grundlage auf und stellt Anwendungen einen verbindungsorientierten und zuverlässigen Byte-Stream zur Verfügung. Dazu nutzt es unter anderem Sequenznummern, Bestätigungen und erneute Übertragungen. Weitere Mechanismen kümmern sich um Fluss- und Überlastkontrolle.
Diese Trennung ist architektonisch entscheidend: IP muss nicht wissen, welche Transporteigenschaften eine Anwendung benötigt. Umgekehrt muss eine Anwendung nicht zwangsläufig TCP verwenden. Benötigt sie andere Eigenschaften, stehen andere Transportmechanismen zur Verfügung. Mit UDP und später QUIC werden wir genau darauf noch zurückkommen. An dieser Stelle genügt zunächst die Erkenntnis, dass Adressierung und Vermittlung einerseits und Ende-zu-Ende-Transport andererseits bewusst getrennte Aufgaben darstellen.
TCP/IP und OSI – zwei Perspektiven auf Kommunikation
In dieser Blogreihe verwenden wir überwiegend die sieben Schichten des OSI-Modells. Das Internet und seine Protokolle sind allerdings nicht aus diesem Modell hervorgegangen. Deshalb sollten OSI und TCP/IP auch nicht so behandelt werden, als ließen sich ihre Schichten exakt übereinanderlegen. In einer verbreiteten vereinfachten Darstellung unterscheidet die TCP/IP-Architektur die Bereiche Link, Internet, Transport und Application. IP gehört zur Internet-Schicht, während TCP und UDP der Transport-Schicht zugeordnet werden.

Für unsere Betrachtung lassen sich diese Funktionen sinnvoll mit Layer 3, der Vermittlungsschicht, und Layer 4, der Transportschicht des OSI-Modells in Beziehung setzen. Es handelt sich dabei jedoch um eine funktionale Zuordnung und nicht um zwei identische Architekturmodelle. Das OSI-Modell erfüllt in diesem Beitrag deshalb vor allem eine didaktische Aufgabe: Es hilft dabei, Funktionen und Verantwortlichkeiten voneinander zu trennen und bei der Fehlersuche systematisch vorzugehen.
Damit sind wir bei der entscheidenden Frage für das nächste Kapitel angekommen: Wenn IP Daten über Netzwerkgrenzen hinweg vermitteln soll, muss es Netze und Endpunkte adressieren und voneinander unterscheiden können. Genau dafür arbeitet IPv4 mit einem 32 Bit großen Adressraum. Wie dieser Adressraum ursprünglich organisiert wurde, betrachten wir als Nächstes. Dabei wird auch deutlich, warum diese Organisation mit dem rasanten Wachstum des Internets zunehmend unter Druck geriet.

Exkurs: Robert Kahn und Vinton Cerf – Architekten des Internetworking
Wenn heute von den Vätern des Internets gesprochen wird, fallen häufig die Namen Robert Kahn und Vinton Cerf. Die Bezeichnung ist eingängig, verkürzt aber eine Entwicklung, an der zahlreiche Wissenschaftler:innen und Ingenieur:innen beteiligt waren. Kahn und Cerf kommt dennoch eine besondere Rolle zu: Ihre Arbeiten in den 1970er Jahren schufen wesentliche konzeptionelle Grundlagen für die Kommunikation zwischen unterschiedlichen paketvermittelnden Netzen.
Robert Kahn beschäftigte sich bei DARPA mit der Frage, wie verschiedene Netztechnologien miteinander verbunden werden konnten, ohne ihre jeweilige interne Funktionsweise vereinheitlichen zu müssen. Gemeinsam mit Vinton Cerf entwickelte er daraus eine Architektur für das Internetworking. 1974 beschrieben beide in ihrer Veröffentlichung A Protocol for Packet Network Intercommunication (PDF-Datei) grundlegende Prinzipien für die Kommunikation über Netzwerkgrenzen hinweg.
Aus dem zunächst umfassender gedachten Transmission Control Program entwickelte sich später die Trennung in TCP und IP. Damit wurden zwei Aufgaben voneinander entkoppelt, die bis heute das Internet prägen: IP übernimmt Adressierung und Vermittlung zwischen Netzen, während TCP darauf aufbauend einen zuverlässigen Transport zwischen Endpunkten bereitstellen kann.
Gerade diese Trennung erwies sich als bemerkenswert langlebig. Neue Übertragungstechnologien konnten entstehen, Netze konnten wachsen und Anwendungen sich grundlegend verändern, ohne dass dafür die grundlegende Idee des Internetworking aufgegeben werden musste.
IPv4 – wie Adressen Struktur in Netzwerke bringen
Mit TCP/IP entstand eine Architektur, die unterschiedliche Netze miteinander verbinden konnte. Damit stellte sich jedoch unmittelbar die nächste Frage: Wie lassen sich diese Netze und die darin erreichbaren Systeme eindeutig adressieren? IPv4 beantwortet diese Frage mit einem 32 Bit großen Adressraum. Eine IPv4-Adresse besteht damit aus 32 binären Stellen. Für Menschen ist eine Folge wie 11000000101010000000000100001010 allerdings wenig handlich. Deshalb werden IPv4-Adressen üblicherweise in vier Gruppen zu jeweils acht Bit aufgeteilt und dezimal dargestellt: 11000000.10101000.00000000.01100100 wird zu: 192.168.0.100.
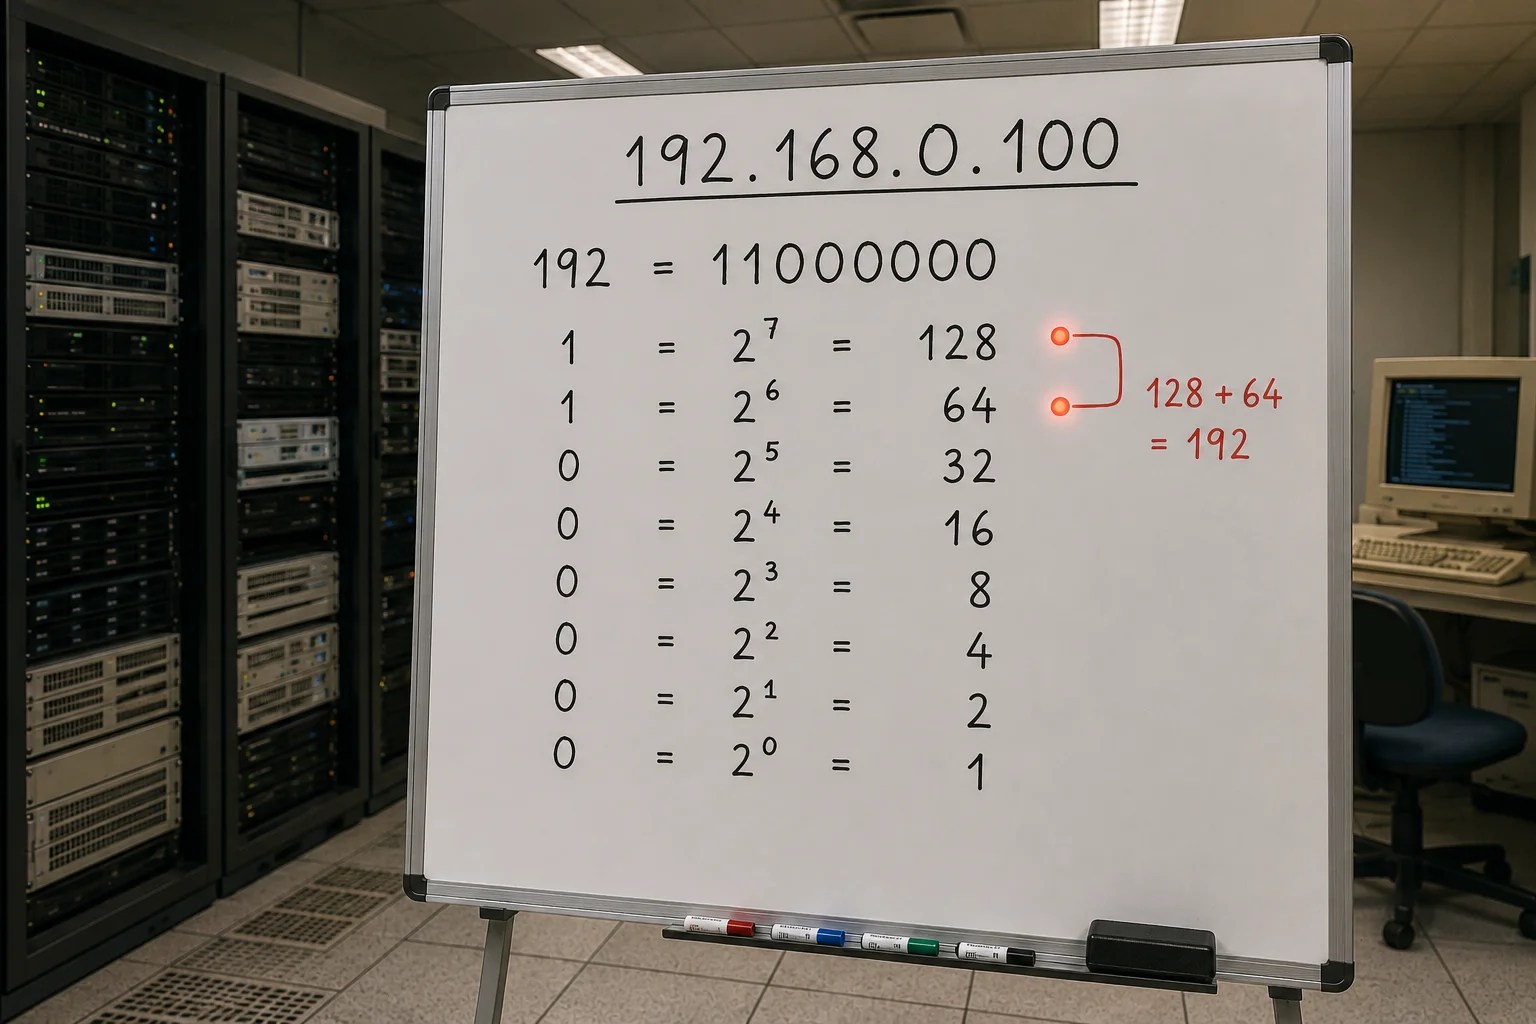
Die vier Zahlen werden als Oktette bezeichnet. Jedes Oktett besteht aus acht Bit, deren Stellenwerte von 2⁰ bis 2⁷ reichen. Sind alle acht Bit auf 0 gesetzt, ergibt sich der Dezimalwert 0. Sind dagegen alle Bit auf 1 gesetzt, werden ihre Stellenwerte addiert:
128 + 64 + 32 + 16 + 8 + 4 + 2 + 1 = 255
Ein Oktett kann damit 2⁸ = 256 unterschiedliche Werte darstellen, die von 0 bis 255 reichen. Da eine IPv4-Adresse aus vier solchen Oktetten und damit insgesamt 32 Bit besteht, ergeben sich theoretisch 2³² und damit 4.294.967.296 unterschiedliche Bitkombinationen. Entscheidend ist jedoch nicht allein die Größe dieses Adressraums. Eine IP-Adresse muss zugleich ausdrücken können, zu welchem Netz ein System gehört und welches System innerhalb dieses Netzes gemeint ist. Genau dafür wurde der Adressraum ursprünglich hierarchisch strukturiert.
Netzwerk und Host – die grundlegende Idee
Eine IPv4-Adresse lässt sich logisch in einen Netzwerkanteil und einen Hostanteil unterteilen. Der Netzwerkanteil identifiziert das IP-Netz, der Hostanteil einen Anschluss beziehungsweise ein Interface innerhalb dieses Netzes. Damit unterscheidet sich die IP-Adresse grundlegend von der MAC-Adresse, die uns im vorherigen Beitrag dieser Reihe begegnet ist. Während Ethernet zunächst die Kommunikation auf einem lokalen Link ermöglicht, schafft IP eine Adressierungsstruktur, die über einzelne Netzwerksegmente hinausreicht.
Genau diese Hierarchie macht Routing überhaupt erst skalierbar. Router müssen nicht jeden einzelnen erreichbaren Host des Internets kennen. Sie können Weiterleitungsentscheidungen anhand von Netzwerkpräfixen treffen.
Heute bestimmen wir die Grenze zwischen Netzwerk- und Hostanteil über eine Präfixlänge, beispielsweise /24, beziehungsweise traditionell über eine Subnetzmaske wie 255.255.255.0. Historisch begann IPv4 allerdings mit einem deutlich starreren Modell. Die Größe des Netzwerkanteils war nicht beliebig wählbar, sondern ergab sich aus der Adressklasse.
Warum IPv4 ursprünglich Adressklassen verwendete
In der frühen Internetentwicklung erschien eine Einteilung in unterschiedlich große Netze zunächst sinnvoll. Kleine Organisationen benötigten schließlich erheblich weniger Adressen als große Forschungsinstitutionen oder weit verzweigte Netze. Der IPv4-Adressraum wurde deshalb in verschiedene Adressklassen eingeteilt. Für die normale Unicast-Kommunikation waren insbesondere die Klassen A, B und C relevant. Klasse D wurde später für Multicast verwendet, Klasse E für experimentelle beziehungsweise reservierte Zwecke vorgesehen.
| Klasse | Führende Bits | Historische Netzgröße | Adressbereich | Adressen pro Netz | Ursprüngliche Verwendung |
| A | 0 | /8 | 0.0.0.0 – 127.255.255.255 | 16.777.216 | sehr große Netze |
| B | 10 | /16 | 128.0.0.0 – 191.255.255.255 | 65.536 | mittlere Netze |
| C | 110 | /24 | 192.0.0.0 – 223.255.255.255 | 256 | kleine Netze |
| D | 1110 | – | 224.0.0.0 – 239.255.255.255 | – | Multicast |
| E | 1111 | – | 240.0.0.0 – 255.255.255.255 | – | reserviert/experimentell |
Dabei sind Adressbereich und tatsächlich für Hosts nutzbarer Adressraum nicht identisch. In einem klassischen Klasse-C-Netz mit 256 Adressen konnten beispielsweise üblicherweise 254 Hostadressen verwendet werden, weil die Netzwerkadresse und die Broadcastadresse besondere Funktionen besitzen. Auch bei Klasse A und B reduzieren sich die klassisch nutzbaren Hostadressen entsprechend. Auf diese Besonderheiten kommen wir beim Subnetting noch ausführlicher zurück.
Die ersten Bits verrieten die Klasse
Das Interessante am Classful Addressing war, dass sich die Adressklasse unmittelbar aus der IPv4-Adresse ableiten ließ. Dafür waren die führenden Bits fest vorgegeben. Jede Adressklasse besaß somit ein eindeutiges Bitmuster am Anfang der IPv4-Adresse:
-
Klasse A: 0xxxxxxx – dezimal 0 bis 127
-
Klasse B: 10xxxxxx – dezimal 128 bis 191
- Klasse C: 110xxxxx – dezimal 192 bis 223
- Klasse D: 1110xxxx – dezimal 224 bis 239
- Klasse E: 1111xxxx – dezimal 240 bis 255
Dadurch ließ sich allein anhand der ersten Bits erkennen, zu welcher Klasse eine IPv4-Adresse gehörte. Bei einer Adresse, deren erstes Oktett beispielsweise mit 110 begann, handelte es sich um eine Adresse der Klasse C. Gleichzeitig war damit grundsätzlich vorgegeben, wie viele Bit den Netzwerk- und wie viele den Hostanteil bildeten.
Genau hier liegt ein wichtiger Unterschied zur heutigen IP-Adressierung: Die Grenze zwischen Netzwerk- und Hostanteil musste ursprünglich nicht separat durch eine Präfixlänge beschrieben werden. Sie ergab sich aus der Adressklasse. Diese Eigenschaft machte das Modell vergleichsweise einfach. Gleichzeitig legte sie aber bereits die Grundlage für eines seiner größten Probleme: Zwischen den verfügbaren Netzgrößen gab es kaum Flexibilität.
Kein Planungsfehler, sondern ein Kind seiner Zeit
Aus heutiger Perspektive wirken rund 4,3 Milliarden IPv4-Adressen erstaunlich wenig. Dabei darf jedoch nicht übersehen werden, für welche Größenordnung IPv4 ursprünglich entwickelt wurde. 1969 bestand das ARPANET aus gerade einmal vier Hosts. 1983 bewegte sich die dokumentierte Größenordnung noch im Bereich einiger Hundert Hosts. Erst anschließend beschleunigte sich das Wachstum erheblich. Ein 32 Bit großer Adressraum war deshalb zunächst keineswegs offensichtlich zu klein. Im Gegenteil: Gegenüber der damaligen Zahl vernetzter Systeme bot er eine gewaltige Reserve.
Das spätere Problem bestand zudem nicht allein darin, dass immer mehr Geräte Adressen benötigten. Auch die Art, wie der vorhandene Adressraum aufgeteilt und vergeben wurde, erwies sich zunehmend als ineffizient. Damit lohnt sich ein genauerer Blick auf die drei Klassen, die ursprünglich für reguläre Host- und Netzwerkadressierung vorgesehen waren.
Wenn 254 Adressen zu wenig und 65.534 zu viel sind
Das starre Klassenmodell bot im Wesentlichen drei sehr unterschiedliche Größenordnungen. Ein klassisches Klasse-C-Netz stellte 256 Adressen bereit, von denen typischerweise 254 für Hosts nutzbar waren. Ein Klasse-B-Netz umfasste dagegen bereits 65.536 Adressen mit klassisch 65.534 nutzbaren Hostadressen. Dazwischen gab es zunächst keine passende Klasse. Benötigte eine Organisation beispielsweise 1.000 oder 5.000 Hostadressen, war ein einzelnes Klasse-C-Netz offensichtlich zu klein. Ein Klasse-B-Netz stellte dagegen einen Adressraum für mehr als 65.000 Adressen bereit. Ein erheblicher Teil davon konnte ungenutzt bleiben.
Bei Klasse A wurde das Missverhältnis noch deutlicher: Ein einziges solches Netz umfasste mehr als 16 Millionen IPv4-Adressen. Solange das Internet klein blieb, ließ sich diese Großzügigkeit verkraften. Mit dem schnellen Wachstum der 1980er und frühen 1990er Jahre wurde jedoch deutlich, dass der vorhandene Adressraum wesentlich effizienter strukturiert werden musste.
Nicht nur die Adressen wurden zum Problem
Die zunehmende Größe des Internets stellte noch eine zweite Herausforderung. Jede weitere Organisation brachte nicht nur zusätzliche Hosts, sondern auch weitere Netze und damit zusätzliche Routinginformationen mit sich. Das Problem hatte deshalb zwei miteinander verbundene Seiten: Einerseits musste der begrenzte IPv4-Adressraum effizienter vergeben werden. Andererseits musste verhindert werden, dass die Zahl der zu verarbeitenden Netzwerkeinträge im globalen Routing unkontrolliert anwuchs.
Die starre Bindung von Netzgrößen an die Klassen A, B und C passte immer weniger zu dieser Entwicklung. Die langfristige Antwort darauf bestand darin, Adressklassen für Routingentscheidungen hinter sich zu lassen und stattdessen mit frei wählbaren Netzwerkpräfixen zu arbeiten. Mit Classless Inter-Domain Routing, kurz CIDR, wurde dieser Schritt Anfang der 1990er Jahre schließlich vollzogen.
Bevor wir uns CIDR genauer ansehen, fehlt uns allerdings noch ein entscheidendes Puzzleteil. Ein Host mit der Adresse 192.168.0.100 muss schließlich feststellen können, ob sich ein Ziel im eigenen IP-Netz oder in einem anderen Netz befindet. Erst dann kann er entscheiden, ob er direkt mit dem Ziel kommunizieren kann oder das Paket an einen Router übergeben muss. Genau dieser Entscheidung widmet sich das nächste Kapitel: Wie kommunizieren Hosts in IP-Netzwerken?

Exkurs: IANA, IAB & Co – Die Gremien des Internets und ihre Rollen
Hinter IP-Adressen, AS-Nummern, Portnummern und DNS-Namen stehen weltweit koordinierte Verwaltungsprozesse. Sie sorgen beispielsweise dafür, dass globale Adressbereiche eindeutig vergeben werden und Protokollparameter eine gemeinsame Bedeutung besitzen.
Das wirkt zunächst wie ein Widerspruch: Das Internet ist dezentral aufgebaut und kennt keine zentrale technische Leitstelle. Trotzdem benötigt eine globale Infrastruktur gemeinsame Regeln und eindeutig verwaltete Ressourcen.
Genau dafür hat sich über Jahrzehnte ein Geflecht verschiedener Organisationen entwickelt. IANA, IETF, IAB, ICANN und die Regional Internet Registries übernehmen dabei unterschiedliche Aufgaben. Keine dieser Organisationen kontrolliert das Internet als Ganzes. Vielmehr verteilen sich Standardisierung, technische Koordination und Ressourcenverwaltung auf verschiedene Institutionen.
IANA – die Register des Internets
Die Internet Assigned Numbers Authority (IANA) ist eng mit der frühen Geschichte des Internets und insbesondere mit Jon Postel verbunden. Hinter dem Namen verbirgt sich heute kein einzelnes Gremium, sondern eine Reihe zentraler Koordinationsfunktionen. Zu den IANA-Funktionen gehören insbesondere die Verwaltung beziehungsweise Koordination von Internet Number Resources, Protocol Parameters und der DNS Root Zone. Dazu zählen beispielsweise globale IPv4- und IPv6-Adressressourcen, AS-Nummern sowie zahlreiche Werte, die in Internetprotokollen eindeutig festgelegt sein müssen. Ein bekanntes Beispiel sind die Service Names und Port Numbers. Dadurch ist unter anderem festgelegt, dass HTTP traditionell TCP-Port 80 und HTTPS TCP-Port 443 verwendet.
Historisch wurden viele dieser Aufgaben von Jon Postel am Information Sciences Institute der University of Southern California wahrgenommen. Heute werden die operativen IANA-Funktionen von Public Technical Identifiers (PTI) erbracht, einer Tochtergesellschaft der ICANN. Damit ist IANA weniger eine klassische Organisation als vielmehr eine technische Koordinationsfunktion für global eindeutige Ressourcen und Parameter.
IETF und IAB – Standards und Architektur
Eine andere Aufgabe übernimmt die Internet Engineering Task Force (IETF). Sie entwickelt und pflegt viele der technischen Standards, auf denen das Internet basiert. Die Ergebnisse dieser Arbeit begegnen uns in diesem Beitrag ständig: RFCs beschreiben unter anderem IPv4, IPv6, TCP, UDP, BGP und zahlreiche weitere Protokolle und Verfahren. Innerhalb dieses Ökosystems übernimmt das Internet Architecture Board (IAB) übergeordnete Aufgaben. Es beschäftigt sich unter anderem mit langfristigen architektonischen Fragestellungen des Internets, begleitet die Standardisierungsprozesse und nimmt bestimmte Aufsichts- und Ernennungsfunktionen wahr.
Dabei sollte man sich das IAB nicht als technischen Vorstand vorstellen, der neue Internetstandards einfach beschließt. Die Internetstandardisierung beruht wesentlich auf offenen Prozessen, technischer Diskussion und Konsensbildung. Auch hier zeigt sich ein grundlegendes Prinzip der Internet-Governance: Zuständigkeiten werden verteilt, statt sie in einer einzigen zentralen Institution zusammenzuführen.
ICANN und die IANA-Funktionen
Mit dem starken Wachstum und der zunehmenden wirtschaftlichen Bedeutung des Internets mussten auch dessen Verwaltungsstrukturen weiterentwickelt werden. 1998 wurde die Internet Corporation for Assigned Names and Numbers (ICANN) gegründet. ICANN ist eine gemeinnützige Organisation und übernimmt Koordinationsaufgaben rund um das Domain Name System, eindeutige Internetkennungen und die IANA-Funktionen. Die operativen IANA-Dienste werden, wie bereits beschrieben, heute durch PTI erbracht.
Auch ICANN ist damit kein Internetministerium. Sie kann weder den weltweiten Datenverkehr kontrollieren noch darüber entscheiden, welche Inhalte über das Internet transportiert werden dürfen. Ihre Aufgabe liegt vielmehr darin, gemeinsam mit den beteiligten technischen und organisatorischen Communities dafür zu sorgen, dass bestimmte global eindeutige Ressourcen koordiniert bleiben.
Von IANA zu den Regional Internet Registries
Bei IP-Adressen zeigt sich die verteilte Struktur besonders deutlich. IANA verwaltet die globalen Nummernressourcen auf oberster Ebene. Große Adressblöcke werden jedoch nicht von IANA einzeln an Unternehmen oder Benutzer:innen vergeben.
Dafür existieren fünf Regional Internet Registries (RIRs):
|
Kürzel |
Organisation |
Zuständigkeitsbereich |
|
AFRINIC |
African Network Information Centre |
Afrika |
|
APNIC |
Asia Pacific Network Information Centre |
Asien und Pazifik |
|
ARIN |
American Registry for Internet Numbers |
USA, Kanada und Teile der Karibik |
|
LACNIC |
Latin American and Caribbean Internet Addresses Registry |
Lateinamerika und Teile der Karibik |
|
RIPE NCC |
Réseaux IP Européens Network Coordination Centre |
Europa, Naher Osten und Teile Zentralasiens |
Für uns in Europa ist damit vor allem das RIPE NCC mit Sitz in Amsterdam relevant. Die RIRs verwalten die ihnen zugeordneten Nummernressourcen nach regional entwickelten Richtlinien und vergeben beziehungsweise registrieren Ressourcen für ihre Mitglieder und andere berechtigte Organisationen. Darunter können wiederum Provider Adressbereiche an ihre Kund:innen weitergeben. Es entsteht also eine hierarchische Verteilung, ohne dass jede einzelne öffentliche IP-Adresse zentral von IANA vergeben werden müsste.
Niemand besitzt das Internet – aber jemand muss es bezahlen
Gerade diese Struktur macht die Organisation des Internets bemerkenswert. Es gibt keine einzelne Institution, die das Internet besitzt oder vollständig kontrolliert. Stattdessen arbeiten verschiedene technische, organisatorische und regionale Strukturen zusammen. Die IETF entwickelt Standards. Das IAB beschäftigt sich mit übergeordneten architektonischen und prozessbezogenen Fragen. Die IANA-Funktionen koordinieren global eindeutige Ressourcen und Protokollparameter. ICANN stellt dafür einen institutionellen Rahmen bereit, während die RIRs die Verwaltung der Internet-Nummernressourcen regional fortsetzen.
Doch wenn niemand das Internet besitzt, stellt sich eine durchaus praktische Frage: Wer bezahlt das alles? Auch darauf gibt es keine zentrale Antwort. Die beteiligten Organisationen finanzieren ihre Arbeit auf unterschiedliche Weise. Die administrative Infrastruktur der IETF wird beispielsweise über die IETF Administration LLC organisiert. Zu ihren Finanzierungsquellen gehören die Unterstützung durch die Internet Society, Teilnahmegebühren für Meetings, Sponsoring und Spenden.
Bei den Regional Internet Registries funktioniert das Modell wiederum anders. Das RIPE NCC ist beispielsweise eine Non-Profit-Mitgliederorganisation und finanziert einen wesentlichen Teil seiner Arbeit über Beiträge seiner Mitglieder. Hinter der Verwaltung von IP-Adressressourcen stehen also durchaus reale Kosten für Personal, technische Systeme, Register, Sicherheitsmaßnahmen und weitere Dienste.
Auch ICANN verfügt über ein eigenes Finanzierungsmodell und veröffentlicht Budgets sowie geprüfte Finanzberichte. Die technische Koordination des Internets wird somit nicht nur organisatorisch, sondern auch finanziell auf mehrere voneinander getrennte Strukturen verteilt. Diese Aufgabenteilung ist nicht immer einfach und durchaus Gegenstand technischer, organisatorischer und politischer Diskussionen. Internet Governance bewegt sich ausdrücklich im Spannungsfeld zwischen Technik, Wirtschaft, Zivilgesellschaft und staatlichen Interessen.
Für unseren weiteren Weg reicht zunächst eine zentrale Erkenntnis: IP-Adressierung funktioniert global nur deshalb, weil technische Dezentralität mit koordinierter Verwaltung kombiniert wird. Und diese Koordination muss organisiert, betrieben und letztlich auch finanziert werden.
Wie kommunizieren Hosts in IP-Netzwerken?
Eine IPv4-Adresse identifiziert nicht nur einen Endpunkt. Zusammen mit der Information über den zugehörigen Netzwerkanteil ermöglicht sie einem Host eine grundlegende Entscheidung: Liegt das Ziel in einem direkt erreichbaren IP-Netz oder muss das Paket über einen Router dorthin gelangen? Diese Unterscheidung gehört zu den zentralen Prinzipien von Layer 3. Ein Host muss den vollständigen Weg zum Ziel dabei noch gar nicht kennen. Für ihn genügt zunächst die Entscheidung zwischen lokaler beziehungsweise direkter Zustellung und Weitergabe an einen Router.
Damit begegnen uns zwei unterschiedliche Formen der Kommunikation:
- Lokales Ziel: Der Zielhost befindet sich aus Sicht der IP-Konfiguration in einem direkt angeschlossenen Netz. Der Sender kann das Paket unmittelbar auf dem entsprechenden Link zustellen.
- Entferntes Ziel: Das Ziel gehört nicht zu einem direkt angeschlossenen Netz. Der Sender benötigt eine passende Route und übergibt das Paket normalerweise an einen Router als nächsten Hop.
Das klingt zunächst einfach. Dahinter steckt jedoch eine der wichtigsten Entscheidungen, die ein IP-Stack für nahezu jedes zu versendende Paket treffen muss.
Der Netzwerkanteil entscheidet
Nehmen wir zunächst ein historisches Beispiel aus der klassenbezogenen IPv4-Welt:
192.168.10.25
Das erste Oktett hat den Wert 192 und beginnt binär mit 110. Damit handelt es sich nach dem klassischen Adressschema um eine Klasse-C-Adresse. Ohne weitere Unterteilung des Netzes ergab sich daraus eine Netzgrenze nach 24 Bit:
192.168.10 | .25
Der linke Teil identifiziert das Netzwerk, der rechte Teil den Host innerhalb dieses Netzes. In heutiger Präfixnotation könnten wir diese historische Netzgrenze als /24 beschreiben. Für die Adresse ergibt sich damit das Netz 192.168.10.0/24. Dabei besitzt die Adresse 192.168.10.0 eine besondere Bedeutung. Sie ist die Netzwerkadresse und bezeichnet das Netz selbst. Bei einem /24 bilden die ersten 24 Bit den Netzwerkanteil und die verbleibenden acht Bit den Hostanteil. Sind alle Bit des Hostanteils auf 0 gesetzt, entsteht die Netzwerkadresse: 192.168.10.00000000 → 192.168.10.0.
Diese Adresse wird deshalb nicht regulär an einen Host innerhalb dieses Subnetzes vergeben. Sie dient vielmehr dazu, das gesamte IP-Netz eindeutig zu bezeichnen. Genau deshalb sprechen wir beispielsweise vom Netz 192.168.10.0/24.
Am anderen Ende des Adressbereichs finden wir einen zweiten Sonderfall. Sind alle Bit des Hostanteils auf 1 gesetzt, ergibt sich: 192.168.10.11111111 → 192.168.10.255. Dies ist die gerichtete Broadcastadresse des Subnetzes. Ein an diese Adresse gerichtetes IPv4-Paket adressiert grundsätzlich alle Hosts innerhalb dieses Subnetzes. Damit erklärt sich auch, warum bei unserem klassischen /24 von den insgesamt 256 möglichen Adressen normalerweise nur 254 als reguläre Hostadressen zur Verfügung stehen: 192.168.10.0 bezeichnet das Netz und 192.168.10.255 den Broadcast.
Der reguläre Hostbereich reicht damit von 192.168.10.1 bis 192.168.10.254. Soll unser Host 192.168.10.25 nun ein Paket an 192.168.10.66 senden, liegt diese Zieladresse innerhalb desselben Netzes. Der Sender erkennt damit: Das Ziel ist direkt erreichbar.
Wichtig ist dabei die Perspektive. Der Sender muss nicht wissen, ob der Zielhost tatsächlich eingeschaltet oder physisch vorhanden ist. Er stellt zunächst lediglich anhand seiner Netzkonfiguration fest, dass er dieses Ziel direkt erreichen können sollte.


Exkurs: Deep Dive in die Netzwerkerkennung
Die bisherige Betrachtung lässt sich noch einen Schritt weiterführen. Denn hinter der scheinbar einfachen Frage ‘Ist das Ziel lokal oder entfernt?‘ steckt eine konkrete Berechnung. Bleiben wir zunächst bewusst in der historischen, klassenbezogenen IPv4-Welt und betrachten zwei Hosts:
Host A: 192.168.5.10
Host B: 172.16.0.35
Host A möchte ein IP-Paket an Host B senden. Bevor überhaupt ARP ins Spiel kommt oder ein Ethernet-Frame erzeugt werden kann, muss der IP-Stack eine grundlegende Entscheidung treffen: Kann ich das Ziel über ein direkt angeschlossenes Netz erreichen oder benötige ich einen Router? Dafür können wir den Vorgang gedanklich in drei Schritte zerlegen:
- In welchem Netzwerk befindet sich der sendende Host?
- In welchem Netzwerk befindet sich das Ziel?
- Handelt es sich aus Sicht des Senders um ein direkt erreichbares Ziel?
Schauen wir uns diese Entscheidung auf Bit-Ebene an.
Schritt 1: In welchem Netzwerk befinde ich mich?
Host A besitzt die IPv4-Adresse:
192.168.5.10
Binär dargestellt ergibt sich:
11000000.10101000.00000101.00001010
Die Adresse beginnt mit 110. Nach dem historischen Klassenschema handelt es sich damit um eine Klasse-C-Adresse. Die ersten 24 Bit bilden den Netzwerkanteil, die verbleibenden acht Bit den Hostanteil:
11000000.10101000.00000101.00001010
NNNNNNNN.NNNNNNNN.NNNNNNNN.HHHHHHHH
Um die Netzwerkadresse zu bestimmen, werden alle Bit des Hostanteils auf 0 gesetzt:
11000000.10101000.00000101.00001010
NNNNNNNN.NNNNNNNN.NNNNNNNN.HHHHHHHH
11000000.10101000.00000101.00000000
Dezimal:
192.168.5.0
Host A kann daraus ableiten: Mein direkt angeschlossenes Netz ist 192.168.5.0. In heutiger Präfixschreibweise würden wir die historische Klasse-C-Netzgrenze als 192.168.5.0/24 darstellen.
Schritt 2: Liegt das Ziel in meinem Netzwerk?
Nun kennt Host A seine eigene Situation: 192.168.5.10 ist eine Klasse-C-Adresse. Für die lokale Kommunikation arbeitet der Host damit mit einer 24 Bit langen Netzwerkkennung.
Nun soll das Ziel 172.16.0.35 erreicht werden. An dieser Stelle muss der Quellhost für seine Local-or-Remote-Entscheidung nicht zunächst eine vollständige zweite Klassenanalyse durchführen. Seine Fragestellung ist wesentlich einfacher: Wenn ich mich in einem Klasse-C-Netz mit 24 Bit Netzwerkkennung befinde, müsste ein lokal erreichbares Ziel dieselbe 24-Bit-Netzwerkkennung besitzen. Ist das bei dieser Zieladresse der Fall? Genau diese Logik wenden wir nun auf die Zieladresse an.
Host B besitzt die IPv4-Adresse:
172.16.0.35
Binär dargestellt lautet sie:
10101100.00010000.00000000.00100011
Da der Quellhost mit einer 24 Bit langen Netzwerkkennung arbeitet, betrachten wir für den Vergleich ebenfalls die ersten 24 Bit:
10101100.00010000.00000000.00100011
NNNNNNNN.NNNNNNNN.NNNNNNNN.HHHHHHHH
Die Hostbits werden für die Ermittlung der zu vergleichenden Netzwerkkennung auf 0 gesetzt:
10101100.00010000.00000000.00100011
NNNNNNNN.NNNNNNNN.NNNNNNNN.HHHHHHHH
10101100.00010000.00000000.00000000
Daraus ergibt sich:
172.16.0.0
Interessant ist dabei, was der Host nicht wissen muss. Für diese Entscheidung ist es nicht erforderlich, zunächst festzustellen, dass 172.16.0.35 aufgrund seiner führenden Bits 10 historisch eigentlich eine Klasse-B-Adresse ist. Aus Sicht des sendenden Hosts lautet die Frage nicht: ‘Zu welcher Klasse gehört das Ziel?‘, sondern: ‘Gehört das Ziel zu meinem direkt erreichbaren Netz?‘
Warum diese Vereinfachung sinnvoll war
Gerade im historischen Kontext ist diese Denkweise interessant. Die frühen TCP/IP-Implementierungen liefen auf Systemen, deren Prozessorleistung und Arbeitsspeicher mit heutigen Maßstäben kaum vergleichbar sind. Netzwerkverarbeitung sollte deshalb möglichst einfach und effizient erfolgen.
Nachdem die eigene Netzstruktur bekannt war, musste für die Local-or-Remote-Entscheidung nicht unnötig eine zweite vollständige Betrachtung der Adressklasse aufgebaut werden. Der Host benötigte letztlich nur die Antwort auf eine binäre Frage: Mein Netz oder nicht mein Netz? Ist die ermittelte Netzwerkkennung identisch, kann das Ziel als lokal behandelt werden. Ist sie unterschiedlich, muss für das Ziel ein anderer Weg gesucht werden.
Damit ist die Klassenlogik vor allem für die Bestimmung der eigenen Netzgrenze relevant. Anschließend kann diese Grenze für die Prüfung der Zieladresse verwendet werden.
Schritt 3: Die Entscheidung fällt
Nun stehen sich die beiden ermittelten Kennungen gegenüber:
Eigene Netzwerkkennung: 192.168.5.0
Aus der Zieladresse abgeleitete Netzwerkkennung: 172.16.0.0
Der Vergleich fällt eindeutig aus:
192.168.5.0 ≠ 172.16.0.0
Damit ist die entscheidende Frage beantwortet: Host B befindet sich aus Sicht von Host A nicht im eigenen lokalen IP-Netz. Eine direkte Zustellung auf dem lokalen Netzwerkabschnitt ist deshalb nicht möglich. Wichtig ist, was daraus folgt – und was nicht. Host A verwirft das IP-Paket nicht allein deshalb, weil die beiden Netzwerkkennungen voneinander abweichen. Er hat zunächst lediglich festgestellt: Das Ziel ist nicht lokal. Ich benötige einen anderen Weg dorthin.
An diesem Punkt wechselt die Entscheidung von der direkten Zustellung zur Weiterleitung. Host A benötigt nun eine passende Route für die Zieladresse. In einer typischen Client-Konfiguration kann dafür die Standardroute verwendet werden, die auf einen Router als Next Hop verweist. Wären die beiden Netzwerkkennungen dagegen identisch, würde Host A das Ziel als lokal erreichbar behandeln. Auf einem Ethernet-Netz müsste er anschließend ermitteln, unter welcher MAC-Adresse der Zielhost auf diesem lokalen Link erreichbar ist.
Aus der Netzwerkerkennung ergeben sich somit genau zwei mögliche nächste Schritte:
- Netzwerkkennungen stimmen überein: lokale Zustellung zum Zielhost
- Netzwerkkennungen unterscheiden sich: passende Route und gegebenenfalls Weitergabe an einen Router als Next Hop
Die eigentliche Kommunikation hat damit allerdings noch nicht begonnen. Bis zu diesem Punkt hat Layer 3 lediglich entschieden, ob das Ziel direkt oder über einen anderen Weg erreicht werden muss. Für die tatsächliche Übertragung auf unserem Ethernet-Netz benötigt der Host nun Layer 2.
Lokales Ziel: Layer 3 benötigt Layer 2
Mit der Feststellung ‚Das Ziel ist lokal‘ ist das Paket allerdings noch nicht übertragen. IPv4 kennt nun zwar die Zieladresse 192.168.10.66, Ethernet benötigt für die tatsächliche Übertragung auf dem lokalen Link jedoch eine MAC-Adresse. Genau hier treffen Layer 3 und Layer 2 unmittelbar aufeinander. Und genau hier schließt sich zugleich der Kreis zum vorherigen Beitrag Warum jedes Bit seinen Weg braucht – Der Weg zur intelligenten Kommunikation: Eine IP-Adresse beschreibt das logische Ziel einer Kommunikation. Die tatsächliche Übertragung innerhalb eines Ethernet-Netzes erfolgt jedoch mithilfe von MAC-Adressen.
Man kann sich das ein wenig wie die persönliche Zustellung eines Pakets vorstellen. Ich packe ein Paket und vermerke darauf meinen Namen sowie den Namen der Person, die es erhalten soll. Damit habe ich festgelegt, von wem das Paket stammt und für wen es bestimmt ist. In unserer Netzwerkkommunikation entspricht dies vereinfacht den Quell- und Zielinformationen auf Layer 3. Damit befindet sich das Paket aber noch immer bei mir.
Von der logischen Adresse zur tatsächlichen Zustellung
Nun muss ich das Paket tatsächlich zustellen. Wohnt die Empfängerin in meiner unmittelbaren Umgebung und kann ich sie direkt erreichen, gehe ich von meiner Haustür zu ihrer Haustür und lege das Paket dort ab. Für diesen konkreten Zustellvorgang benötige ich also nicht nur die Information, wer das Paket erhalten soll. Ich muss auch wissen, wo ich es auf diesem Abschnitt tatsächlich abgeben kann. Eine ähnliche Aufgabe übernimmt Ethernet auf Layer 2. Unser Host weiß bereits: Ziel-IP ist 192.168.10.66. Nun benötigt er zusätzlich die MAC-Adresse der Netzwerkschnittstelle, über die dieses Ziel im lokalen Ethernet erreichbar ist.
Bei IPv4 kommt dafür das Address Resolution Protocol (ARP) zum Einsatz. Der Sender prüft zunächst, ob ihm bereits eine Zuordnung zwischen der IPv4-Adresse 192.168.10.66 und der zugehörigen MAC-Adresse bekannt ist. Eine solche Information kann sich beispielsweise im ARP-Cache befinden. Ist die Zuordnung noch nicht bekannt, kann der Host über eine ARP-Anfrage ermitteln, welche Netzwerkschnittstelle die betreffende IPv4-Adresse verwendet. Erst wenn diese Information vorliegt, kann das IP-Paket für die lokale Übertragung in einen Ethernet-Frame gekapselt werden:
Ziel-IP im IP-Paket: 192.168.10.66
Ziel-MAC im Ethernet-Frame: MAC-Adresse des Zielhosts
Damit existieren zwei Adressierungsebenen gleichzeitig. Das IP-Paket beschreibt das logische Kommunikationsziel, während der Ethernet-Frame die konkrete Zustellung auf dem lokalen Link ermöglicht.
IP bestimmt das Ziel, Ethernet übernimmt die Zustellung
Diese Unterscheidung ist für das Verständnis von TCP/IP wesentlich. Wenn wir umgangssprachlich davon sprechen, dass zwei IP-Adressen miteinander kommunizieren, verkürzen wir den tatsächlichen Vorgang erheblich. Auf einem Ethernet-Netzwerkabschnitt wird der Frame letztlich von einer MAC-Adresse zu einer anderen MAC-Adresse übertragen. Das darin transportierte IP-Paket enthält wiederum die IP-Adressen, anhand derer Layer 3 das logische Quell- und Zielsystem beziehungsweise deren Interfaces beschreibt.
Für unser lokales Beispiel fallen beide Perspektiven besonders einfach zusammen: Die Ziel-IP-Adresse gehört zum gewünschten Endpunkt und die Ziel-MAC-Adresse gehört zur Netzwerkschnittstelle genau dieses Endpunkts. Layer 3 bestimmt also, wohin das Paket gelangen soll. Layer 2 sorgt dafür, dass es auf dem aktuellen Netzwerkabschnitt tatsächlich beim richtigen nächsten Interface ankommt.

Noch interessanter wird diese Trennung, sobald das Ziel nicht mehr im lokalen Netz liegt. Dann bleibt die Ziel-IP-Adresse weiterhin die Adresse des eigentlichen Empfängers. Die Ziel-MAC-Adresse kann dagegen nicht mehr die MAC-Adresse dieses entfernten Hosts sein. Genau an diesem Punkt kommt das Default Gateway als nächster Hop ins Spiel.
Entferntes Ziel: Der Empfänger liegt in einem anderen Netz
Nun ändern wir lediglich die Zieladresse: Das Paket soll von der Quelladresse: 192.168.10.25 zur Zieladresse: 172.16.0.35 wandern. Im historischen Klassenmodell gehört die Quelladresse zu einem Klasse-C-Netz, während 172.16.0.35 eine Klasse-B-Adresse ist. Entscheidend ist jedoch nicht allein, dass beide Adressen unterschiedlichen Klassen angehören. Entscheidend ist vielmehr: Die Zieladresse gehört nicht zu einem direkt angeschlossenen Netz des Senders. Damit können wir unsere Paketanalogie fortsetzen. Stellen wir uns vor, die Person, der ich regelmäßig Pakete persönlich vorbeigebracht habe, zieht aus meiner Nachbarschaft in eine andere Stadt. Ich kenne weiterhin ihren Namen und ihre neue Adresse. Eine persönliche Zustellung von Haustür zu Haustür ist nun jedoch nicht mehr praktikabel.
Also ändere ich mein Vorgehen. Ich beschrifte das Paket weiterhin mit dem eigentlichen Empfänger, bringe es nun aber zu einem lokalen Paketdienstleister. Für mich ist dieser die nächste erreichbare Station auf dem Weg zum Ziel. Eine vergleichbare Aufgabe übernimmt in unserem IP-Netz der Router. Der Host 192.168.10.25 kann das entfernte Ziel 172.16.0.35 nicht direkt auf seinem lokalen Ethernet erreichen. Er benötigt deshalb eine passende Route, die ihn zu einem Next Hop führt.
Nehmen wir an, die Standardroute verweist auf den Router 192.168.10.1. Dieser Router ist für unseren Host zunächst die nächste Station auf dem Weg zum eigentlichen Empfänger.
Ziel-IP und Ziel-MAC zeigen nun auf unterschiedliche Systeme
An dieser Stelle wird das Zusammenspiel zwischen Layer 3 und Layer 2 besonders deutlich. Auch wenn ich mein Paket bei einem Paketdienstleister abgebe, ändere ich den eigentlichen Empfänger auf dem Paket nicht. Das Paket soll weiterhin die Person erreichen, die inzwischen in einer anderen Stadt wohnt. Der Paketdienstleister ist lediglich die nächste Station, der ich die Sendung übergeben kann.
Bei der IP-Kommunikation geschieht etwas Vergleichbares. Das IP-Paket bleibt für den entfernten Host bestimmt:
Ziel-IP: 172.16.0.35
Auf dem lokalen Ethernet kann der Sender diesen entfernten Host jedoch nicht unmittelbar erreichen. Der Ethernet-Frame muss deshalb zunächst zum Router 192.168.10.1 gelangen. Dafür benötigt der Sender dessen MAC-Adresse. Ist sie noch nicht bekannt, kann sie bei IPv4 wiederum über ARP ermittelt werden.
Für die erste Übertragung ergibt sich damit eine zunächst vielleicht überraschende Kombination:
Ziel-IP im IP-Paket: 172.16.0.35
Ziel-MAC im Ethernet-Frame: MAC-Adresse des Routers 192.168.10.1
Das IP-Paket sagt damit sinngemäß: ‘Mein endgültiges Ziel ist 172.16.0.35.‘ Der Ethernet-Frame sagt für den aktuellen lokalen Abschnitt dagegen: ‘Als Nächstes muss dieses Paket zum Interface des Routers 192.168.10.1.‘ Genau diese Unterscheidung gehört zu den wichtigsten Grundlagen für das Verständnis von IP-Kommunikation.
Der Sender muss den vollständigen Weg nicht kennen
Unsere Paketanalogie führt noch zu einem weiteren wichtigen Punkt. Nachdem ich die Sendung beim Paketdienstleister abgegeben habe, muss ich nicht wissen, wie sie anschließend transportiert wird. Vielleicht fährt sie zunächst zu einem regionalen Verteilzentrum, anschließend zu einem überregionalen Hub und von dort in die Zielregion. Welche Straßen, Fahrzeuge oder Zwischenstationen dabei verwendet werden, muss ich weder kennen noch selbst festlegen. Für mich zählt zunächst nur, wo ich das Paket übergeben kann und welches endgültige Ziel darauf angegeben ist.
Ähnlich verhält es sich mit unserem Host. 192.168.10.25 muss nicht die gesamte Route zu 172.16.0.35 kennen. Für seine unmittelbare Weiterleitungsentscheidung genügt eine passende Route und damit die Information, welcher nächste Schritt für dieses Ziel vorgesehen ist. Der Router übernimmt anschließend die nächste Entscheidung. Auch er muss dabei nicht zwingend den vollständigen Ende-zu-Ende-Pfad kennen. Er betrachtet die Ziel-IP-Adresse und entscheidet anhand seiner Routinginformationen, wohin das Paket als Nächstes weitergeleitet werden soll. So kann sich ein IP-Paket Schritt für Schritt durch mehrere Netze bewegen.
Layer 2 ist lokal, Layer 3 verbindet die Netze
Damit wird auch der Unterschied zwischen den beiden Adressierungsebenen deutlicher. Bei der direkten Kommunikation in unserem lokalen Ethernet gehörte die Ziel-MAC-Adresse zum eigentlichen Zielhost 192.168.10.66. Bei der Kommunikation mit 172.16.0.35 gehört die Ziel-MAC-Adresse auf dem ersten Ethernet-Abschnitt dagegen zum Router. Die IP-Zieladresse beschreibt das eigentliche Kommunikationsziel. Die MAC-Zieladresse beschreibt auf einem Ethernet-Link, welches direkt erreichbare Interface den Frame als Nächstes erhalten soll.
Auf dem nächsten Ethernet-Link kann deshalb eine andere Layer-2-Kapselung mit anderen MAC-Adressen verwendet werden. Das ursprüngliche Ethernet-Frame reist nicht unverändert durch das gesamte Internet. Ein Router nimmt das IP-Paket aus der für ihn bestimmten Layer-2-Kapselung entgegen und kapselt es für den nächsten Link erneut passend ein.
Unsere Paketanalogie passt auch hier: Der lokale Paketshop, das Verteilzentrum und der Zusteller am Zielort übernehmen jeweils nur einen Abschnitt des Transports. Der Empfänger der Sendung bleibt derselbe, die unmittelbar beteiligten Übergabestellen ändern sich dagegen auf dem Weg. Am Zielort erfolgt schließlich wieder eine lokale Zustellung. So wie der Paketdienst die Sendung auf dem letzten Abschnitt zur Haustür des Empfängers bringt, muss auch das letzte IP-Netz das Paket schließlich zum tatsächlichen Zielhost übertragen.

Damit schließt sich der Kreis: Layer 3 hält das eigentliche Ziel über Netzwerkgrenzen hinweg im Blick. Layer 2 übernimmt auf jedem einzelnen Link die konkrete lokale Zustellung zum nächsten erreichbaren Interface.
Das Gateway ist der nächste Schritt, nicht das Ziel
Unsere Paketdienst-Analogie macht eine häufige Fehlvorstellung sichtbar: Nur weil Max sein Paket beim lokalen Paketdienst abgibt, wird der Paketdienst dadurch nicht zum Empfänger. Anna bleibt das eigentliche Ziel der Sendung. Der Paketdienst ist lediglich die nächste erreichbare Station, die den weiteren Transport übernimmt.
Bei der IP-Kommunikation gilt dasselbe Prinzip. Der Router 192.168.10.1 ist für unseren Host zunächst nur der Next Hop auf dem Weg zum entfernten Ziel 172.16.0.35. Der Host verändert deshalb die Ziel-IP-Adresse des Pakets nicht: Ziel-IP: 172.16.0.35. Für die Übertragung auf dem lokalen Ethernet-Link kapselt er dieses IP-Paket jedoch in einen Ethernet-Frame, dessen Ziel-MAC-Adresse zum Router 192.168.10.1 gehört: Ziel-MAC: MAC-Adresse des Routers 192.168.10.1. Damit transportiert der Ethernet-Frame ein IP-Paket, dessen logisches Ziel ein völlig anderes System ist als das unmittelbare Layer-2-Ziel.
An jedem Netzwerkabschnitt beginnt Layer 2 neu
Erreicht der Ethernet-Frame den Router, endet dort zunächst seine Aufgabe. Der Router verarbeitet die für sein Interface bestimmte Layer-2-Kapselung und betrachtet anschließend die Ziel-IP-Adresse des enthaltenen IP-Pakets. Nun trifft er seine eigene Weiterleitungsentscheidung: Über welches Interface und gegebenenfalls welchen nächsten Hop führt der weitere Weg zu 172.16.0.35?
Für den nächsten Netzwerkabschnitt benötigt das IP-Paket wieder eine zum jeweiligen Link passende Layer-2-Kapselung. Handelt es sich erneut um Ethernet, enthält der neu erzeugte Frame die für diesen Abschnitt benötigten Quell- und Ziel-MAC-Adressen. Dieser Vorgang kann sich auf dem Weg durch mehrere Netze mehrfach wiederholen. Die MAC-Adressen sind damit lokale Wegbegleiter. Sie können sich von Link zu Link ändern. Die IP-Zieladresse beschreibt dagegen weiterhin das eigentliche Kommunikationsziel.
Auch unsere Paketdienst-Analogie passt dazu: Max kennt zunächst nur die lokale Annahmestelle. Von dort gelangt die Sendung vielleicht zu einem regionalen Verteilzentrum, anschließend zu einem weiteren Hub und schließlich zum lokalen Zusteller in Annas neuer Stadt. An jeder Station ändert sich der nächste Übergabepunkt. Anna bleibt dennoch die Empfängerin.
Damit lässt sich die zentrale Trennung auf einen Satz verdichten: Layer 2 organisiert die Zustellung auf dem jeweiligen lokalen Link. Layer 3 hält das Ziel über die Grenzen dieser einzelnen Netze hinweg adressierbar. Wie ein Router aus der Ziel-IP-Adresse ableitet, welcher dieser nächsten Schritte der richtige ist, betrachten wir anschließend beim Routing.
Was passiert, wenn der Weg nach draußen fehlt?
Unsere Paketdienst-Analogie lässt sich noch einen Schritt weiterführen. Anna wohnt inzwischen in einer anderen Stadt, eine persönliche Zustellung ist also nicht mehr möglich. Was aber geschieht, wenn Max weder einen Paketdienst noch einen anderen Weg kennt, über den er die Sendung weitergeben könnte? Das Paket bleibt bei Max.
Ganz ähnlich verhält sich unser Host 192.168.10.25. Hat er bereits festgestellt, dass 172.16.0.35 nicht über ein direkt angeschlossenes Netz erreichbar ist, benötigt er einen anderen Weg zum Ziel. Dafür betrachtet der IP-Stack seine Routingtabelle. Findet sich dort eine passende Route, kann diese festlegen, über welches Interface und gegebenenfalls über welchen Next Hop das Paket weitergegeben werden soll. Existiert jedoch weder eine passende spezifische Route noch eine verwendbare Standardroute, fehlt dem Host diese Information.
Er kann das Paket nicht einfach auf Verdacht in das lokale Ethernet übertragen und darauf hoffen, dass irgendein Router die weitere Zustellung übernimmt. Ohne passenden Eintrag in der Routingtabelle gibt es für dieses entfernte Ziel keinen bekannten Weiterleitungsweg. Die lokale Kommunikation bleibt davon unberührt. Direkt angeschlossene Netze erscheinen selbst als entsprechende Routen in der Routingtabelle. Andere Hosts im eigenen Netz können deshalb weiterhin erreichbar sein, auch wenn überhaupt kein Standardgateway konfiguriert wurde.
Kein Default Gateway bedeutet nicht automatisch keine Remote-Kommunikation
An dieser Stelle lohnt sich eine begriffliche Präzisierung. Die häufig verwendete Aussage ‘Ohne Default Gateway ist keine Kommunikation mit anderen Netzen möglich‘ beschreibt zwar viele typische Client-Konfigurationen, ist technisch aber zu pauschal. Ein Host kann schließlich mehrere Einträge in seiner Routingtabelle besitzen. Beispielsweise könnte eine spezifische Route für ein bestimmtes entferntes Netz bereits auf einen passenden Next Hop verweisen. In diesem Fall wäre dieses Netz auch ohne konfigurierte Standardroute erreichbar.
Entscheidend ist deshalb nicht allein die Existenz eines Default Gateways, sondern die Frage: Kennt der Host eine passende Route für die Ziel-IP-Adresse? Erst wenn keine spezifische oder anderweitig passende Route existiert, kommt typischerweise die Standardroute ins Spiel. Und genau sie sorgt bei gewöhnlichen Client-Systemen dafür, dass nicht für jedes mögliche entfernte Netzwerk eine eigene Route konfiguriert werden muss. Damit lässt sich die Situation präzise zusammenfassen: Für lokale Ziele kennt der Host den direkten Weg. Für entfernte Ziele benötigt er eine passende Route. Fehlt auch diese, endet der bekannte Weg am eigenen Netz.
Die Standardroute ist der Weg für den unbekannten Rest
In einem typischen Client-Netz wäre es kaum praktikabel, auf jedem Endgerät eine eigene Route für jedes erreichbare entfernte IP-Netz zu hinterlegen. Ein Host müsste andernfalls eine enorme Zahl möglicher Zielnetze kennen, obwohl für die meisten davon ohnehin derselbe erste Weg aus dem lokalen Netz herausführt. Genau hier kommt die Standardroute ins Spiel. Unter IPv4 wird sie durch das Präfix 0.0.0.0/0 beschrieben. Die Präfixlänge /0 bedeutet, dass kein einziges Bit der Zieladresse fest vorgegeben ist. Die Route kann damit grundsätzlich auf jede IPv4-Zieladresse passen. Sinngemäß lässt sie sich deshalb so lesen: ‘Wenn ich keinen spezifischeren Weg zum Ziel kenne, verwende diesen.‘
Für unseren Host 192.168.10.25 könnte eine solche Standardroute beispielsweise auf den Router 192.168.10.1 als Next Hop verweisen. Möchte der Host 172.16.0.35 erreichen und findet er keine spezifischere passende Route, übergibt er das Paket über diesen Weg an den Router.
Das Default Gateway ist Teil der Routinglogik
Damit verliert auch der Begriff Default Gateway etwas von seiner vermeintlichen Sonderstellung. Das in einer typischen IPv4-Konfiguration angegebene Default Gateway ist keine zusätzliche Vermittlungsinstanz neben dem Routing. Es bezeichnet üblicherweise den Next Hop, der für die Standardroute verwendet wird. Auch ein gewöhnlicher Windows- oder Linux-Host besitzt deshalb eine Routingtabelle. Noch bevor ein Paket das System verlässt, muss der IP-Stack entscheiden, welcher vorhandene Routeneintrag zur Zieladresse passt und welcher Ausgangspfad daraus folgt.
Die Standardroute ist dabei gewissermaßen das Auffangnetz der Routingtabelle: Sie passt sehr allgemein, kommt aber erst dann zum Zuge, wenn keine spezifischere passende Route vorhanden ist. Unsere Paketdienst-Analogie funktioniert auch hier: Max muss nicht wissen, welche Straßen, Verteilzentren und Transportwege zu jeder denkbaren Adresse führen. Es genügt, dass er für unbekannte entfernte Ziele eine allgemeine Anlaufstelle kennt: ‘Wenn ich die Sendung nicht selbst lokal zustellen kann und keinen spezielleren Versandweg kenne, gebe ich sie dort ab.‘
Damit treffen bereits Endgeräte eine grundlegende Routingentscheidung. Routing beginnt also nicht erst am Router. Der sendende Host entscheidet zunächst selbst, ob das Ziel direkt erreichbar ist oder welchem bekannten Weg er das Paket für die weitere Reise übergibt.
Aus Klassen wurden Netzmasken und Präfixe
Bis hierhin haben wir bewusst mit der historischen klassenbezogenen IPv4-Logik gearbeitet. Für unseren Host 192.168.10.25 ergab sich aus der Klasse C zunächst eine klare Grenze: 24 Bit beschreiben das Netzwerk, acht Bit den Host. Daraus entstand das Netz 192.168.10.0. Diese Logik war einfach, aber zugleich starr. Moderne IPv4-Netze sind deshalb längst nicht mehr an die ursprünglichen Grenzen der Adressklassen gebunden. Die Netzgrenze wird stattdessen durch eine Subnetzmaske beziehungsweise Präfixlänge beschrieben.
Unser Host könnte beispielsweise folgendermaßen konfiguriert sein: 192.168.10.25/26. Das /26 bedeutet, dass die ersten 26 Bit zur Netzwerkkennung gehören. Für den Hostanteil verbleiben damit nur noch sechs Bit. Das entsprechende Präfix lautet: 192.168.10.0/26. Mit sechs Hostbits lassen sich 2⁶ = 64 Adressen abbilden. Dieses Subnetz umfasst damit den Bereich von 192.168.10.0 bis 192.168.10.63.
Die Adresse 192.168.10.25 liegt innerhalb dieses Bereichs. Ein Ziel wie 192.168.10.50 würde ebenfalls dazugehören. Anders sieht es beispielsweise mit 192.168.10.100 aus. Auf den ersten Blick ähneln sich beide Adressen erheblich. Die ersten drei Oktette sind sogar identisch:
192.168.10.25
192.168.10.100
Mit einem /26 reicht diese Gemeinsamkeit jedoch nicht aus. 192.168.10.100 liegt außerhalb des Präfixes 192.168.10.0/26 und gehört damit nicht zum selben Subnetz. Der Host darf dieses Ziel folglich nicht einfach als lokalen Nachbarn behandeln.
Die Netzgrenze steht nicht mehr in der Adresse
Genau hier liegt ein wesentlicher Unterschied zur historischen Klassenlogik. Aus einer IPv4-Adresse allein lässt sich heute nicht mehr zuverlässig ableiten, wie groß das zugehörige Netz ist. Die IP-Adresse 192.168.10.25 könnte beispielsweise Bestandteil eines /24, eines /26 oder eines noch anders aufgeteilten Netzes sein. Erst die zusätzliche Präfixinformation beschreibt, welche Bit zur Netzwerkkennung gehören und welche für Hosts zur Verfügung stehen.
Damit verändert sich auch unsere zuvor betrachtete Local-or-Remote-Entscheidung. Das grundlegende Prinzip bleibt gleich: Der Host muss feststellen, ob die Zieladresse über ein direkt angeschlossenes Netz erreichbar ist oder ob er für sie eine andere Route benötigt. Nur die Grundlage dieser Entscheidung ist flexibler geworden. Nicht mehr die historische Adressklasse bestimmt die Netzgrenze. Entscheidend sind die konfigurierten Präfixe und die daraus entstehenden Einträge in der Routingtabelle.
Die Klassenlogik erklärt damit sehr anschaulich, woher die Trennung zwischen Netzwerk- und Hostanteil stammt. Subnetting löste diese Trennung zunehmend von den starren Klassengrenzen, während CIDR das Prinzip schließlich konsequent auf frei wählbare Präfixlängen übertrug. Wie weit diese Flexibilisierung reicht und warum sie für die weitere Entwicklung von IPv4 so wichtig wurde, betrachten wir später noch ausführlicher bei Subnetting und CIDR.
Lokal oder entfernt ist eine Routingentscheidung
Damit lässt sich der gesamte bisher betrachtete Ablauf auf eine grundlegende Entscheidung reduzieren: Wie kann die Ziel-IP-Adresse erreicht werden? Der sendende Host gleicht die Zieladresse mit den ihm bekannten Routen ab. Führt eine passende Route über ein direkt angeschlossenes Netz, kann das Ziel auf diesem Link unmittelbar erreicht werden. In einem IPv4-Ethernet-Netz wird dafür gegebenenfalls mithilfe von ARP die zur Ziel-IP-Adresse gehörende MAC-Adresse ermittelt und das IP-Paket anschließend in einen passenden Ethernet-Frame gekapselt.
Ist das Ziel dagegen nicht direkt erreichbar, benötigt der Host einen anderen Weg. Eine passende Route kann auf einen Router als Next Hop verweisen. Existiert keine spezifischere Route, übernimmt in typischen Client-Konfigurationen die Standardroute diese Aufgabe.
Damit gelangen wir zu einer Erkenntnis, die im Netzwerkalltag leicht übersehen wird: Bereits der sendende Host trifft eine Routingentscheidung. Routing beginnt nicht erst an einem Router, einer Firewall oder einem Layer-3-Switch. Auch ein gewöhnlicher Client muss entscheiden, über welches Interface und gegebenenfalls über welchen Next Hop ein IP-Paket weitergegeben werden soll.
Unsere Paketdienst-Analogie führt uns damit ein letztes Mal zu Max zurück. Solange Anna in seiner Nachbarschaft wohnt, kann er das Paket selbst bis zu ihrer Haustür bringen. Zieht sie in eine andere Stadt, benötigt er einen geeigneten Übergabepunkt. Max muss dabei nicht wissen, welchen vollständigen Weg das Paket nehmen wird. Er muss lediglich entscheiden können, ob er es selbst lokal zustellen kann oder wem er es als Nächstes übergibt.
Mit der Übergabe endet jedoch nur die Verantwortung des sendenden Hosts für die Auswahl des ersten Weges. Die Reise des Pakets hat gerade erst begonnen. An jeder weiteren Netzwerkgrenze muss erneut entschieden werden, welcher nächste Schritt das Paket seinem Ziel näherbringt. Aus der zunächst einfachen Frage lokal oder entfernt? wird damit eine wesentlich größere Aufgabe: Aus vielen möglichen Wegen muss immer wieder ein geeigneter Pfad zum Ziel gefunden werden.

Exkurs: Jon Postel – eine prägende Persönlichkeit des frühen Internets
Eine Schlüsselfigur hinter den Kulissen
Wenn eine Person wie kaum eine andere für die technische Koordination des frühen Internets steht, führt an Jonathan Bruce Postel, besser bekannt als Jon Postel, kaum ein Weg vorbei. Postel gehörte nicht zu den öffentlich bekanntesten Persönlichkeiten der Computergeschichte. Innerhalb der Internet-Community nahm er jedoch über Jahrzehnte eine außergewöhnliche Stellung ein. Er arbeitete an grundlegenden Internetprotokollen mit, war lange Zeit Editor der RFC-Reihe und übernahm zentrale Aufgaben bei der Verwaltung von Protokollparametern, Portnummern, IP-Adressräumen und später auch der DNS-Root-Zone.
Viele dieser Tätigkeiten wurden unter dem Begriff Internet Assigned Numbers Authority, kurz IANA, zusammengefasst – jener Koordinationsfunktion, die uns bereits zuvor begegnet ist.
Ein Netzwerker im ursprünglichen Sinn
Jon Postel wurde 1943 geboren und arbeitete später am Information Sciences Institute der University of Southern California. Seine Bedeutung für das entstehende Internet lag dabei nicht allein in einzelnen technischen Entwicklungen. Postel befand sich an einer entscheidenden Schnittstelle zwischen Protokolldesign, Standardisierung und praktischer Koordination. Besonders eng ist sein Name mit den Request for Comments, den RFCs, verbunden. Von 1969 bis zu seinem Tod 1998 fungierte er als RFC Editor und begleitete damit einen wesentlichen Teil der Entwicklung jener Dokumentenreihe, in der zahlreiche Grundlagen des heutigen Internets beschrieben wurden.
Auch an zentralen Protokollspezifikationen war Postel beteiligt. Sein Name findet sich unter anderem bei frühen Spezifikationen von IP, TCP, UDP und weiteren grundlegenden Internetprotokollen. Dabei entstand auch ein Grundsatz, der später als Postel's Law oder Robustness Principle bekannt wurde: ‚Be conservative in what you do, be liberal in what you accept from others.‘ Sinngemäß: Implementierungen sollten selbst möglichst regelkonform senden, beim Empfang aber mit gewissen Abweichungen anderer Implementierungen umgehen können.
Dieser Ansatz war für die Interoperabilität des frühen Internets ausgesprochen einflussreich. Aus heutiger Sicht wird er allerdings differenzierter betrachtet: Zu großzügige Akzeptanz fehlerhafter Eingaben kann Mehrdeutigkeiten erzeugen und insbesondere aus Sicherheitsgründen problematisch sein. Auch daran zeigt sich, wie sich die Anforderungen an Internetprotokolle seit den frühen Jahren weiterentwickelt haben.
Koordination durch Vertrauen
Bemerkenswert ist vor allem, wie stark die frühe Internetverwaltung zunächst von Personen, fachlichem Vertrauen und einer vergleichsweise kleinen technischen Community geprägt war. Aufgaben, für die heute institutionelle Strukturen, definierte Prozesse und mehrere Organisationen existieren, liefen über lange Zeit an wenigen Stellen zusammen. Postel spielte dabei eine zentrale Rolle. Die Verwaltung technischer Parameter war für ihn keine abstrakte Verwaltungsaufgabe: Ohne eindeutige Protokollnummern, Portnummern und Adresszuweisungen konnte ein wachsendes Netz aus unterschiedlichen Systemen schlicht nicht zuverlässig zusammenarbeiten.
Damit verkörperte seine Tätigkeit ein Prinzip, das für das Internet bis heute entscheidend ist: Dezentrale Netze benötigen gemeinsame Regeln und eine verlässliche Koordination dort, wo globale Eindeutigkeit erforderlich ist.
1998: Als die Grenzen informeller Strukturen sichtbar wurden
Wie ungewöhnlich Postels Position geworden war, zeigte sich besonders deutlich Anfang 1998. Im Rahmen eines Tests bat er Betreiber mehrerer DNS-Root-Server, ihre Systeme vorübergehend nicht mehr an der bis dahin maßgeblichen Root-Server-Autorität auszurichten, sondern an einem von IANA kontrollierten System. Mehrere Betreiber folgten seiner Aufforderung.
Technisch funktionierte der Versuch – politisch berührte er jedoch eine ausgesprochen sensible Frage. Denn die Autorität über die DNS-Root-Zone war zu diesem Zeitpunkt eng mit der US-Regierung verbunden. IANA führte unter Postel zwar wesentliche Koordinationsaufgaben aus, die letztliche administrative Autorität über Änderungen an der Root-Zone lag jedoch nicht allein bei IANA. Im Hintergrund standen vertragliche und institutionelle Beziehungen zur US-Regierung und zum US-Handelsministerium.
Postels Test demonstrierte damit mehr als eine technische Umschaltung: Er zeigte, dass ein erheblicher Teil der Root-Server-Betreiber bereit war, einer von Postel beziehungsweise IANA ausgehenden technischen Anweisung zu folgen.
Wer besitzt eigentlich die Autorität im Internet?
Damit stand plötzlich eine grundsätzliche Frage im Raum: Entsteht Autorität im Internet durch formale und staatliche Zuständigkeit – oder dadurch, dass die Betreiber der Infrastruktur einer technisch anerkannten Instanz tatsächlich folgen? Genau darin lag die politische Brisanz. Wer die maßgebliche Root-Zone kontrolliert, beeinflusst einen zentralen Koordinationspunkt des globalen Domain Name Systems. Dass sich die technische Autorität faktisch durch das Handeln einer kleinen, stark auf gegenseitigem Vertrauen beruhenden Community verschieben ließ, machte die Grenzen der bisherigen Strukturen sichtbar. Postel wurde aufgefordert, den Versuch zu beenden, und die Root-Server kehrten zur vorherigen Konfiguration zurück.
Der Vorgang sollte dabei nicht vorschnell als Versuch verstanden werden, die Kontrolle über das Internet zu übernehmen. Vielmehr offenbarte er die ungewöhnliche Mischung aus formaler Zuständigkeit, technischer Kontrolle und persönlichem Vertrauen, auf der wichtige Teile des frühen Internets noch beruhten.
Gleichzeitig hatte sich das Internet längst von einem Forschungsnetz zu einer globalen Infrastruktur mit erheblichen wirtschaftlichen und politischen Interessen entwickelt. Entscheidungen über Domainnamen, Adressräume und technische Koordination betrafen nicht mehr nur eine überschaubare Fachcommunity. Die informellen und stark personenbezogenen Strukturen der Anfangsjahre stießen damit zunehmend an ihre Grenzen. Die Ereignisse von 1998 machten besonders anschaulich, warum für das weiter wachsende Internet institutionellere und nachvollziehbare Formen der globalen Koordination notwendig wurden.
Ein Vermächtnis, das bis heute sichtbar bleibt
Jon Postel starb am 16. Oktober 1998 überraschend nach einer Herzoperation. Sein Tod fiel damit in eine Phase, in der sich auch die Strukturen des Internets grundlegend veränderten. Nur wenige Wochen zuvor war ICANN gegründet worden. Aufgaben, die über viele Jahre stark durch persönliche Verantwortung, fachliches Vertrauen und vergleichsweise informelle Strukturen geprägt waren, sollten zunehmend in institutionell geregelte und international nachvollziehbare Prozesse überführt werden.
Postels Einfluss reicht jedoch weit über einzelne Protokolle oder Verwaltungsaufgaben hinaus. Er steht exemplarisch für eine Phase des Internets, in der technische Entwicklung, Standardisierung und gemeinschaftliche Koordination besonders eng miteinander verbunden waren. Vieles funktionierte, weil eine überschaubare Fachcommunity gemeinsame technische Ziele verfolgte und einzelnen Persönlichkeiten außergewöhnlich großes Vertrauen entgegenbrachte.
Wie eng Postel selbst mit dieser frühen Kultur des Internets verbunden war, zeigt der nach seinem Tod veröffentlichte RFC 2468 mit dem ungewöhnlich persönlichen Titel I REMEMBER IANA. Darin erinnerte Vinton Cerf nicht nur an einen langjährigen Kollegen und Freund, sondern an eine Persönlichkeit, deren Arbeit tief mit der Entstehung und Organisation des Internets verwoben war.
Gerade die Ereignisse seines letzten Lebensjahres zeigen dabei beide Seiten dieses Vermächtnisses. Persönliches Vertrauen und gemeinschaftliche Verantwortung hatten den Aufbau des Internets wesentlich mit ermöglicht. Gleichzeitig war das Netz inzwischen so groß und gesellschaftlich relevant geworden, dass diese informellen Strukturen allein nicht mehr ausreichen konnten.
Vielleicht liegt genau darin Postels eigentliches Vermächtnis: Das Internet funktioniert nicht allein deshalb, weil Router Pakete weiterleiten und Protokolle technisch sauber spezifiziert sind. Es funktioniert auch deshalb, weil Menschen gemeinsame Regeln entwickeln, sich auf deren Anwendung verständigen und Verantwortung für jene Strukturen übernehmen, die einzelne Netze zu einem globalen Internet verbinden.
Routing – Von der Netzwerkgrenze zum globalen Pfad
Unser Host hat seine Entscheidung getroffen. Das Ziel liegt nicht im direkt angeschlossenen Netz, eine passende Route verweist auf einen Router und das IP-Paket wurde auf dem ersten Netzwerkabschnitt an diesen Next Hop übergeben. Für den sendenden Host ist damit zunächst alles erledigt. Er muss weder wissen, wie viele Router noch folgen, noch durch welche Netze das Paket reisen wird. Doch für den Router beginnt nun dieselbe grundlegende Frage erneut: Wie erreiche ich die Ziel-IP-Adresse von hier aus?
Genau darin besteht die zentrale Aufgabe des Routings. Router verbinden unterschiedliche IP-Netze miteinander und treffen auf Grundlage ihrer verfügbaren Routinginformationen Entscheidungen darüber, über welches Interface und gegebenenfalls welchen nächsten Hop ein Paket weitergeleitet werden soll.
Der Router betrachtet die Ziel-IP-Adresse
Erreicht ein Paket einen Router, endet zunächst die Layer-2-Übertragung des vorherigen Links. Der Router verarbeitet die entsprechende Kapselung und betrachtet anschließend auf Layer 3 insbesondere die Ziel-IP-Adresse des enthaltenen Pakets. Nun führt er eine Suche in seinen Routinginformationen durch. Dabei geht es nicht darum, für jede einzelne mögliche IP-Adresse einen eigenen Eintrag vorzuhalten. Routing arbeitet mit Netzpräfixen.
Ein Router könnte beispielsweise Routen zu folgenden Präfixen kennen:
10.0.0.0/8
172.16.0.0/16
192.168.20.0/24
Liegt die Zieladresse innerhalb eines bekannten Präfixes, kann der zugehörige Routeneintrag bestimmen, wie das Paket weitergeleitet werden soll. Das Ergebnis kann beispielsweise auf ein direkt angeschlossenes Netz, ein Ausgangsinterface oder einen weiteren Next Hop verweisen.
Routing funktioniert Hop für Hop
Damit setzt sich auf jedem Router ein Prinzip fort, das wir bereits beim sendenden Host kennengelernt haben. Für die Weiterleitung muss nicht an jeder Station der vollständige physische Weg bis zum Ziel feststehen. Entscheidend ist zunächst, welcher nächste Schritt aufgrund der vorhandenen Routinginformationen gewählt wird. Ein Paket kann auf seiner Reise deshalb zahlreiche Router passieren. Jeder dieser Router verarbeitet es aus seiner eigenen Perspektive: Wo liegt das Ziel und welcher meiner bekannten Wege führt dorthin?
Nach der Entscheidung wird das Paket über den entsprechenden Ausgangspfad weitergeleitet. Auf dem nächsten Link übernimmt erneut Layer 2 die lokale Zustellung. Handelt es sich um Ethernet, entsteht dafür eine neue Ethernet-Kapselung mit den für diesen Netzwerkabschnitt benötigten MAC-Adressen. So wechseln die lokalen Layer-2-Verbindungen auf dem Weg, während Layer 3 die Vermittlung zwischen den Netzen ermöglicht.

Unsere Paketdienst-Analogie lässt sich auch hier fortsetzen: Max hat seine Sendung an der lokalen Annahmestelle abgegeben. Diese muss nicht bereits den Lieferwagen kennen, der später vor Annas Haustür stehen wird. Sie benötigt zunächst einen geeigneten Weg zum nächsten Verteilzentrum. Dort wird erneut entschieden, wohin die Sendung weitertransportiert wird.
Nicht jede passende Route ist gleich gut
Interessant wird Routing dann, wenn mehrere Routeneinträge zur selben Zieladresse passen. Angenommen, ein Router kennt unter anderem die folgenden Pfade: 172.16.0.0/16 und 172.16.10.0/24. Nun erhält er ein Paket für die IP-Adresse 172.16.10.35. Beide Präfixe passen zur Zieladresse. Trotzdem sind sie nicht gleich spezifisch. Das /24 beschreibt einen kleineren und genauer definierten Adressbereich als das /16. Der Router bevorzugt deshalb grundsätzlich den spezifischsten passenden Präfixeintrag. Dieses Prinzip wird als Longest Prefix Match bezeichnet.
Damit begegnet uns auch die Standardroute 0.0.0.0/0 aus dem vorherigen Abschnitt in einem neuen Zusammenhang. Sie kann grundsätzlich auf jede IPv4-Adresse passen, ist mit /0 aber die unspezifischste mögliche Route. Sie wird deshalb nur verwendet, wenn keine spezifischere passende Route vorhanden ist. Routing ist somit keine Suche nach irgendeinem passenden Eintrag, sondern nach dem besten passenden Präfix.
Woher kennt ein Router seine Wege?
Die benötigten Routinginformationen können auf unterschiedliche Weise entstehen. Direkt angeschlossene Netze kennt ein Router durch die Konfiguration seiner eigenen Interfaces. Weitere Wege können Administrator:innen statisch konfigurieren oder mithilfe dynamischer Routingprotokolle erlernen lassen.
Innerhalb eines Unternehmens- oder Providernetzes kommen dafür sogenannte Interior Gateway Protocols (IGP) zum Einsatz. Dazu gehören beispielsweise RIP, OSPF und EIGRP. Historisch spielte im Cisco-Umfeld außerdem IGRP eine wichtige Rolle. Zwischen unterschiedlichen Autonomen Systemen (AS) übernimmt dagegen BGP als Exterior Gateway Protocol eine zentrale Aufgabe im globalen Internet.
Dabei verfolgen diese Protokolle keineswegs dieselbe Strategie. Sie unterscheiden sich darin, welche Informationen sie austauschen, wie sie Veränderungen erkennen und anhand welcher Kriterien sie geeignete Wege bestimmen. BGP sucht beispielsweise nicht schlicht nach dem „kürzesten“ Weg, sondern ermöglicht eine wesentlich stärker policybasierte Pfadauswahl.
Für unsere Betrachtung genügt zunächst die gemeinsame Grundlage: Routingprotokolle liefern Informationen über erreichbare Netze und mögliche Wege. Aus diesen Informationen entstehen Routen, die anschließend für die Weiterleitungsentscheidung eines Routers herangezogen werden können.
Wer hier tiefer einsteigen möchte: Der Beitrag Externes Routing im Internet und WAN – Architektur, Historie und Bedeutung von BGP betrachtet ausführlicher, wie BGP Autonome Systeme miteinander verbindet und welche Bedeutung externes Routing für die Architektur des Internets besitzt. Das interne Routing steht dagegen im Mittelpunkt von Wenn Router Entscheidungen treffen – Routingprotokolle im Cisco-Netzwerk verstehen. Dort werden unter anderem RIP, IGRP, EIGRP und OSPF sowie ihre unterschiedlichen Ansätze zur Ermittlung und Auswahl von Routen näher betrachtet.
Vom lokalen Router durch das Internet
Damit können wir die Reise eines Pakets weiterverfolgen. Ein Client hat festgestellt, dass sein Ziel außerhalb des eigenen Netzes liegt, und das Paket an seinen Router übergeben. Dieser findet eine passende Route und reicht es an den nächsten Router weiter. Im Providernetz folgen weitere Routingentscheidungen, bis das Paket gegebenenfalls die Grenzen zwischen unterschiedlichen Autonomen Systemen überschreitet.
An solchen Grenzen spielt BGP eine wesentliche Rolle. Netzbetreiber tauschen Informationen darüber aus, welche IP-Präfixe über ihre jeweiligen autonomen Systeme erreichbar sind. Daraus entsteht jedoch keine einzige zentrale Routingtabelle des Internets. Das globale Routing ist vielmehr das Ergebnis verteilter Informationen und Entscheidungen vieler miteinander verbundener Netze.
Schließlich erreicht das Paket einen Router, für den das Zielpräfix über ein direkt angeschlossenes Netz erreichbar ist. Nun schließt sich der Kreis zu unserer bisherigen Betrachtung: Auf dem letzten Netzwerkabschnitt muss das Paket wieder lokal zum Zielhost zugestellt werden. Aus einer anfänglichen Local-or-Remote-Entscheidung des Clients ist damit eine Kette von Routingentscheidungen geworden.

Und wenn kein Weg bekannt ist?
Routing kann allerdings nur mit den Informationen arbeiten, die tatsächlich vorhanden sind. Findet ein Router für die Ziel-IP-Adresse weder eine passende spezifische Route noch eine verwendbare Standardroute, besitzt er keinen bekannten Weiterleitungsweg. Das Paket wird dann verworfen. Abhängig von Situation und Protokoll kann der Router den Absender darüber mittels ICMP informieren, beispielsweise durch eine entsprechende Destination Unreachable-Meldung.
Der Router beginnt also nicht auf Verdacht, Pakete über beliebige Interfaces zu verteilen. Routing basiert auf bekannten Erreichbarkeitsinformationen und definierten Weiterleitungsentscheidungen.
Routing muss skalieren
Damit wird zugleich sichtbar, warum Routing nicht nur eine Frage der korrekten Weiterleitung einzelner Pakete ist. Je größer ein Netzwerk wird, desto mehr Präfixe, alternative Wege und Änderungen müssen verarbeitet werden. Spätestens im globalen Internet wäre es kaum beherrschbar, wenn für immer kleinere Adressbereiche unzählige einzelne Routen unabhängig voneinander bekannt gemacht werden müssten. Routing und Adressierung sind deshalb eng miteinander verbunden. Wie wir Netzgrenzen definieren, beeinflusst unmittelbar, wie effizient sich Erreichbarkeitsinformationen zusammenfassen und verteilen lassen.
Die starren Grenzen der ursprünglichen IPv4-Adressklassen erwiesen sich dafür zunehmend als Hindernis. Mit dem Wachstum des Internets entstand der Bedarf, Netzgrößen flexibler festzulegen und zusammenhängende Adressbereiche effizienter als Präfixe zu behandeln.
CIDR – Abschied von den Adressklassen
Das rasante Wachstum des Internets Anfang der 1990er Jahre setzte IPv4 gleich an mehreren Stellen unter Druck. Einerseits wurden immer mehr Adressbereiche benötigt. Andererseits mussten Router eine stetig wachsende Zahl von Netzen unterscheiden und entsprechende Erreichbarkeitsinformationen verarbeiten. Die ursprünglichen Adressklassen erwiesen sich für beide Herausforderungen als zunehmend ungeeignet. Wer mehr Adressen benötigte, als ein Klasse-C-Netz bereitstellen konnte, landete schnell bei einem Klasse-B-Netz mit 65.536 Adressen – selbst wenn tatsächlich nur einige Hundert oder wenige Tausend benötigt wurden. Gleichzeitig erschwerten viele einzeln bekannt gemachte Netze die Skalierung des Routings.
Gesucht war deshalb ein Verfahren, das Netzgrenzen flexibler definiert und gleichzeitig eine effizientere Zusammenfassung von Routinginformationen ermöglicht. Die Antwort darauf war Classless Inter-Domain Routing, kurz CIDR.
Die Netzgrenze steht nicht mehr in der Adressklasse
Mit den 1993 veröffentlichten RFC 1518 und RFC 1519 wurde die bis dahin grundlegende Verbindung zwischen IPv4-Adresse und Adressklasse für das Inter-Domain-Routing aufgebrochen. Statt aus den führenden Bits einer Adresse abzuleiten, wo die Netzwerkkennung endet, wird die Netzgrenze nun explizit durch eine Präfixlänge beschrieben.
Eine Adresse beziehungsweise ein Netz erscheint damit beispielsweise als: 192.168.10.0/24. Die Angabe /24 bedeutet: Die ersten 24 Bit gehören zum Präfix. Die verbleibenden acht Bit stehen innerhalb dieses Präfixes für weitere Adressierung zur Verfügung. Dass /24 exakt der historischen Grenze eines Klasse-C-Netzes entspricht, ist dabei nur noch eine Übereinstimmung mit dem alten Schema. CIDR ist keineswegs auf diese Grenze beschränkt.
Auch Präfixe wie 192.168.10.0/25, 192.168.10.0/26 oder 192.168.10.0/27 sind möglich. Damit war die entscheidende Beschränkung gefallen: Netzgrenzen mussten nicht länger bei 8, 16 oder 24 Bit liegen.
Von der Netzmaske zur Präfixlänge
Die Präfixnotation beschreibt dabei dieselbe grundlegende Information, die auch eine Subnetzmaske ausdrücken kann.
Ein /24 entspricht 255.255.255.0
Ein /26 entspricht 255.255.255.192
Ein /20 entspricht 255.255.240.0
Die CIDR-Schreibweise macht jedoch unmittelbar sichtbar, wie viele zusammenhängende Bit von links zum Präfix gehören. Gerade bei Routinginformationen ist diese Darstellung wesentlich kompakter und hat sich deshalb als natürliche Schreibweise für IPv4-Präfixe etabliert. Die vertrauten /8, /16 und /24 verschwanden dabei keineswegs. Sie entsprechen weiterhin gültigen Präfixlängen:
| Historische Klasse | Historische Standardmaske | Präfixlänge | Adressen pro klassischem Netz |
| A | 255.0.0.0 | /8 | 16.777.216 |
| B | 255.255.0.0 | /16 | 65.536 |
| C | 255.255.255.0 | /24 | 256 |
Der entscheidende Unterschied liegt in ihrer Bedeutung: Ein /24 ist heute nicht automatisch ein Klasse-C-Netz. Es ist schlicht ein Präfix mit 24 Bit Länge. Damit sollten wir auch sprachlich sauber zwischen historischem und modernem IPv4 unterscheiden.

Exkurs: Deep Dive Netzwerkerkennung – Reloaded
Im ersten Deep Dive haben wir die Local-or-Remote-Entscheidung noch in der historischen, klassenbezogenen IPv4-Welt betrachtet. Inzwischen haben wir uns von den starren Adressklassen verabschiedet. Die grundlegende Frage eines Hosts ist jedoch dieselbe geblieben: Liegt das Ziel in einem direkt angeschlossenen Netz oder benötige ich einen anderen Weg dorthin?
Auch unsere beiden Hosts bleiben unverändert:
Host A: 192.168.5.10/24
Host B: 172.16.0.35
Der entscheidende Unterschied steckt diesmal in der Konfiguration von Host A. Die Netzgrenze wird nicht mehr aus den ersten Bit seiner IPv4-Adresse und einer daraus abgeleiteten Adressklasse bestimmt. Sie ist mit /24 explizit vorgegeben. In klassischer Dezimalschreibweise entspricht dieses Präfix der Netzmaske: 255.255.255.0. Damit können wir unseren bekannten Entscheidungsprozess erneut in drei Schritten durchlaufen – diesmal klassenlos.
Schritt 1: In welchem Netzwerk befinde ich mich?
Host A besitzt die IPv4-Adresse:
192.168.5.10/24
Binär dargestellt:
11000000.10101000.00000101.00001010
Die zu /24 gehörende Netzmaske lautet:
11111111.11111111.11111111.00000000
Nun kommt eine grundlegende binäre Operation ins Spiel: das logische UND. Dabei gelten vier einfache Regeln:
- 1 UND 1 = 1
- 1 UND 0 = 0
- 0 UND 1 = 0
- 0 UND 0 = 0
IPv4-Adresse und Netzmaske werden Bit für Bit miteinander verknüpft:
11000000.10101000.00000101.00001010
11111111.11111111.11111111.00000000
===================================
11000000.10101000.00000101.00000000 = 192.168.5.0
Dezimal ergibt das 192.168.5.0. Damit kennt Host A sein direkt angeschlossenes Präfix:
192.168.5.0/24
Der entscheidende Unterschied zu unserem ersten Deep Dive ist bereits sichtbar: Wir mussten keine Adressklasse bestimmen. Die /24-Konfiguration beziehungsweise die entsprechende Netzmaske liefert die Information darüber, welche Bit für die Ermittlung des Netzwerkanteils relevant sind.
Schritt 2: Liegt das Ziel in meinem Netzwerk?
Nun möchte Host A das Ziel 172.16.0.35 erreichen. Auch hier interessiert ihn nicht, welcher historischen Adressklasse diese Adresse einmal zugeordnet worden wäre oder welche Netzwerkmaske der klassenlose Zielhost wirklich verwendet. Für die Local-or-Remote-Entscheidung zählt ausschließlich die eigene Netzgrenze. Host A arbeitet mit /24. Also wendet er dieselbe Netzmaske auch auf die Zieladresse an.
Binär lautet die Zieladresse:
10101100.00010000.00000000.00100011
Wieder führen wir das logische UND mit der Netzmaske von Host A aus:
10101100.00010000.00000000.00100011
11111111.11111111.11111111.00000000
===================================
10101100.00010000.00000000.00000000 = 172.16.0.0
Das Ergebnis lautet dezimal 172.16.0.0. Aus Sicht von Host A ergibt sich für den Vergleich damit:
Aus der eigenen Adresse: 192.168.5.0
Aus der Zieladresse: 172.16.0.0
Auch hier ist wichtig, was nicht passiert: Host A stellt nicht fest, dass 192.168.x.x historisch Klasse C und 172.16.x.x historisch Klasse B wäre. Die Klassen spielen für diese Berechnung keine Rolle mehr. Auch ist die Netzwerkmaske von Host B in diesem Zusammenhang irrelevant. Die Frage lautet ausschließlich: ‘Erhalte ich mit meiner Netzmaske für Quelle und Ziel dieselbe Netzwerkkennung?‘
Schritt 3: Die Entscheidung fällt – erneut
Nun können wir die Ergebnisse miteinander vergleichen:
192.168.5.0 ≠ 172.16.0.0
Damit steht fest: Das Ziel liegt aus Sicht von Host A nicht im direkt angeschlossenen Netz 192.168.5.0/24. Die Konsequenz kennen wir bereits. Host A darf 172.16.0.35 nicht wie einen lokalen Nachbarn behandeln. Stattdessen benötigt er eine passende Route und gegebenenfalls einen Router als Next Hop. Wären die Ergebnisse dagegen identisch, würde das Ziel über das direkt angeschlossene Präfix als lokal erreichbar gelten. Auf unserem Ethernet-Netz könnte anschließend die für die lokale Zustellung benötigte Layer-2-Adresse ermittelt werden.
Die Entscheidung selbst hat sich durch den Wechsel zur klassenlosen Adressierung also kaum verändert: Gleiches direkt angeschlossenes Präfix → lokale Zustellung.
Anderes Präfix → Routingentscheidung für einen anderen Weg. Verändert hat sich vielmehr, wie die dafür notwendige Netzgrenze bestimmt wird.
Was hat sich gegenüber der Klassenlogik verändert?
Genau an diesem Punkt wird der eigentliche Fortschritt von CIDR greifbar. In der historischen Klassenwelt musste der Host zunächst aus seiner IPv4-Adresse ableiten, welche Adressklasse und damit welche feste Netzgrenze für ihn galt. Eine Klasse-C-Adresse führte beispielsweise zu einer 24 Bit langen Netzwerkkennung.
In der klassenlosen Welt entfällt diese Ableitung. Die Netzgrenze ist Bestandteil der Konfiguration: 192.168.5.10/24 kann mit einer 24 Bit langen Netzwerkkennung arbeiten. Derselbe Host könnte aber genauso als 192.168.5.10/26 konfiguriert sein. Dann würde die Local-or-Remote-Berechnung mit einer anderen Netzmaske erfolgen: 255.255.255.192.
Und genau das kann zu einem anderen Ergebnis führen, obwohl sich weder die eigene IPv4-Adresse noch die Zieladresse verändert haben. Das ist der entscheidende Perspektivwechsel: Nicht die IPv4-Adresse bestimmt die Netzgrenze. Das konfigurierte Präfix bestimmt, welche Adressen aus Sicht des Hosts zu seinem direkt angeschlossenen Netz gehören.
CIDR macht Adressierung bedarfsgerechter
Die flexible Präfixlänge ermöglichte wesentlich feinere Abstufungen bei der Vergabe von Adressräumen. Zwischen einem /24 mit 256 Adressen und einem /16 mit 65.536 Adressen liegen beispielsweise zahlreiche mögliche Größen. Ein /23 umfasst 512 Adressen, ein /22 1.024 und ein /21 bereits 2.048. Statt bei wachsendem Bedarf sofort auf die nächste historische Adressklasse ausweichen zu müssen, konnten zusammenhängende Adressbereiche wesentlich bedarfsgerechter zugeteilt werden.
CIDR beseitigte die Knappheit des 32-Bit-Adressraums damit natürlich nicht. Es half aber dabei, diesen vorhandenen Adressraum effizienter zu strukturieren und zu vergeben. Und noch eine zweite Wirkung war für das wachsende Internet mindestens ebenso wichtig: die Entlastung der immer umfangreicher werdenden Routingtabellen durch eine effizientere Zusammenfassung von Präfixen.
CIDR verändert das Routing
Erinnern wir uns an die vorherige Betrachtung: Router arbeiten mit Präfixen. Je mehr einzelne Präfixe bekannt gemacht werden müssen, desto umfangreicher werden die Routinginformationen. CIDR ermöglicht es, mehrere zusammenhängende Netze unter bestimmten Voraussetzungen durch ein gemeinsames, kürzeres Präfix zu beschreiben.
Nehmen wir beispielsweise die 256 aufeinanderfolgenden /24-Netze von 192.168.0.0/24 bis 192.168.255.0/24. Sie teilen sich die ersten 16 Bit und lassen sich deshalb grundsätzlich durch 192.168.0.0/16 zusammenfassen. Statt vieler einzelner Präfixe kann damit ein aggregiertes Präfix bekannt gemacht werden. Dieses Prinzip wird als Route Aggregation beziehungsweise Route Summarization bezeichnet.
Allerdings bedeutet das nicht, dass CIDR die Routingtabellen des Internets einfach dauerhaft klein gemacht hätte. Entscheidend war vielmehr, dass es überhaupt einen Mechanismus bereitstellte, mit dem zusammenhängende und entsprechend vergebene Adressbereiche hierarchisch aggregiert werden konnten. Ohne diese Möglichkeit wäre das weitere Wachstum des globalen Routings noch wesentlich schwieriger zu beherrschen gewesen.
Adressvergabe und Routing greifen ineinander
Damit zeigt sich, warum CIDR weit mehr als eine neue Schreibweise für Subnetzmasken ist. Wenn ein Provider beispielsweise einen größeren zusammenhängenden Adressblock erhält und daraus kleinere Präfixe an Kund:innen vergibt, kann er diese intern differenziert behandeln. Gegenüber anderen Netzen lässt sich unter geeigneten Voraussetzungen trotzdem nur der größere gemeinsame Adressblock bekannt machen.
Genau darin liegt eine wesentliche Stärke hierarchischer Adressierung: Viele detaillierte interne Informationen können nach außen durch eine kleinere Zahl zusammengefasster Präfixe repräsentiert werden. Adressplanung beeinflusst damit unmittelbar die Skalierbarkeit des Routings. Werden Adressbereiche sinnvoll und zusammenhängend vergeben, lassen sie sich besser aggregieren. Stark fragmentierte Adressräume erschweren dagegen eine solche Zusammenfassung.
CIDR verbindet deshalb zwei zunächst getrennt wirkende Aufgaben: effizientere Nutzung des IPv4-Adressraums und skalierbareres Routing.
Klassen verschwinden – das Klassendenken bleibt
Technisch ersetzte CIDR die klassenbezogene Betrachtung im Routing. Trotzdem begegnen uns die alten Klassen bis heute. Ein /24 wird umgangssprachlich noch immer gern als Klasse-C-Netz bezeichnet. Bei 10.0.0.0/8 liegt die Assoziation mit Klasse A nahe, während /16 häufig gedanklich mit Klasse B verbunden wird.
Für die historische Einordnung ist dieses Wissen hilfreich. Für die technische Bewertung eines modernen Präfixes kann es jedoch sogar in die Irre führen.
Betrachten wir beispielsweise:
10.20.30.0/24
Die erste Adresse 10.x.x.x hätte historisch zum Klasse-A-Bereich gehört. Trotzdem beschreibt /24 hier eindeutig eine 24 Bit lange Netzgrenze. Die Frage ‚Welche Klasse ist das?‘ spielt für die moderne Routingentscheidung keine Rolle mehr. Entscheidend ist: ‚Welches Präfix ist definiert?‘ Damit schließt sich auch der Kreis zu unserer Local-or-Remote-Entscheidung. Was wir zunächst anhand historischer Klassen nachvollzogen haben, wird in modernen IPv4-Netzen anhand expliziter Präfixe und der daraus resultierenden Routen entschieden.
Flexibilität schafft neue Möglichkeiten
Mit dem Ende der starren Klassengrenzen entstand zugleich wesentlich mehr Freiheit bei der Strukturierung eigener Netze. Ein vorhandener Adressbereich kann in kleinere Präfixe zerlegt werden. Unterschiedliche Bereiche können – sofern ihre binären Grenzen passen – wiederum zu größeren Präfixen zusammengefasst werden.
Damit begegnen uns zwei eng verwandte, aber unterschiedliche Perspektiven: Beim Subnetting wird ein vorhandener Adressraum in kleinere Netze unterteilt. Beim Supernetting beziehungsweise bei der Aggregation werden mehrere geeignete zusammenhängende Präfixe unter einem größeren gemeinsamen Präfix zusammengefasst. Aus der einfachen Trennung zwischen Netzwerk- und Hostanteil wird damit ein flexibles Werkzeug für die Netzplanung. Wo genau die Grenze zwischen beiden verläuft, ist nicht mehr durch eine historische Adressklasse vorgegeben, sondern wird entsprechend der benötigten Netzstruktur festgelegt.
Das schafft die Grundlage dafür, IPv4-Netze gezielt an Standorte, technische Bereiche und unterschiedliche Größenanforderungen anzupassen – und führt von der Theorie der klassenlosen Adressierung unmittelbar zur praktischen Berechnung und Aufteilung von Präfixen.

Exkurs: Als das Internet seinen Adressraum neu ordnen musste
Ein Adressraum mit Geschichte
CIDR löste nicht nur ein mathematisches Problem bei der Aufteilung von IPv4-Netzen. Hinter der Umstellung stand eine wesentlich größere Herausforderung: Das Internet musste lernen, einen Adressraum zu verwalten, der bereits eine Geschichte hatte. Und diese Geschichte begann lange bevor Milliarden Menschen, Unternehmen und Geräte miteinander vernetzt waren.
Als 16 Millionen Adressen noch nicht verschwenderisch wirkten
In der Frühzeit des Internets war die Zahl der angeschlossenen Netze überschaubar. Universitäten, Forschungseinrichtungen, Behörden und einige Unternehmen gehörten zu den frühen Teilnehmern. Entsprechend anders wurde mit IPv4-Adressen umgegangen. Ein besonders eindrucksvolles Beispiel ist das Massachusetts Institute of Technology (MIT). Ihm war die Netzwerknummer 18 zugeordnet. In der später etablierten klassenbezogenen Betrachtung entsprach dies dem vollständigen Klasse-A-Bereich 18.0.0.0/8 und damit einem Adressraum von 16.777.216 IPv4-Adressen.
Auch andere frühe Teilnehmer erhielten Adressräume dieser Größenordnung. Die Stanford University verfügte beispielsweise über 36.0.0.0/8, bevor dieser Bereich im Jahr 2000 zurückgegeben wurde.
Aus heutiger Perspektive erscheinen solche Zuweisungen geradezu verschwenderisch. Historisch wäre diese Bewertung allerdings unfair. Die Verantwortlichen verteilten damals keine Ressource, von der bereits bekannt war, dass sie wenige Jahrzehnte später knapp und wirtschaftlich wertvoll sein würde. Sie adressierten eine vergleichsweise kleine Zahl großer Netze. Genau diese frühen Zuweisungen hinterließen jedoch ein Erbe, das mit dem Wachstum des Internets immer deutlicher sichtbar wurde. Das IANA-Verzeichnis dokumentiert noch heute zahlreiche /8-Bereiche, deren Ursprung auf solche frühen beziehungsweise Legacy-Zuweisungen zurückgeht.
Aus einem Forschungsnetz wird eine globale Infrastruktur
Das Problem entstand deshalb weniger durch einzelne vermeintlich zu große Zuweisungen als durch die völlig veränderten Dimensionen des Internets. Neue Unternehmen und Provider kamen hinzu, immer mehr Länder wurden angeschlossen und insbesondere außerhalb der frühen Internetregionen entstand ein rasant wachsender Bedarf an öffentlichen IPv4-Adressen.
Gleichzeitig entwickelte sich die Verwaltung weiter. Mit den Regional Internet Registries (RIR) entstand schrittweise eine regionale Struktur für die Vergabe von Internetressourcen. RIPE NCC übernahm ab 1992 diese Aufgabe für Europa und angrenzende Regionen, APNIC etablierte sich 1993 für den asiatisch-pazifischen Raum. ARIN folgte 1997 für Nordamerika, später kamen LACNIC (2002) für Lateinamerika und die Karibik sowie AFRINIC (2005) für Afrika hinzu. Diese Regionen starteten jedoch nicht mit einem frisch aufgeteilten IPv4-Adressraum. Je später eine RIR ihre Arbeit aufnahm, desto stärker musste sie mit den Entscheidungen und Zuweisungen aus der Frühzeit des Internets leben.
Das führte zwangsläufig zu einer historischen Schieflage. Während einzelne frühe Organisationen Adressbestände in Millionenhöhe erhalten hatten, musste der verbliebene IPv4-Raum inzwischen wesentlich sparsamer und bedarfsgerechter vergeben werden. Die gelegentlich erzählte Zuspitzung, für Afrika seien schließlich praktisch nur noch Klasse-C-Netze übrig gewesen, beschreibt diese Schieflage zwar anschaulich, ist technisch jedoch nicht korrekt. Auch die später entstandenen RIRs erhielten große zusammenhängende Adressblöcke. Das eigentliche Problem lag tiefer: Der IPv4-Adressraum war bereits historisch vorgeprägt und konnte nicht einfach noch einmal gleichmäßig über die Welt verteilt werden.
Nicht nur die Adressen waren das Problem
Hinzu kam eine zweite Altlast. IPv4-Adressblöcke waren über viele Jahre im Wesentlichen chronologisch und damit weitgehend unabhängig von der späteren Netztopologie vergeben worden. RFC 2101 beschreibt die Konsequenz sehr deutlich: Die Routingtabellen wuchsen kontinuierlich – und dieses Modell skalierte nicht. Genau hier treffen unsere beiden bisherigen Themen wieder aufeinander. Es gab einen begrenzten IPv4-Adressraum, der effizienter genutzt werden musste. Gleichzeitig durfte eine feinere Aufteilung dieses Adressraums nicht dazu führen, dass im Internet immer mehr einzelne Präfixe bekannt gemacht werden mussten.
Eine reine Neuverteilung der verbliebenen Adressen hätte deshalb nicht ausgereicht. Das Internet benötigte eine neue Architektur für Adressvergabe und Routing.
CIDR macht aus Adressen eine Hierarchie
CIDR lieferte einen entscheidenden Teil dieser Architektur. RFC 2101 beschreibt rückblickend, dass die klassenbezogene Struktur angesichts des Wachstums sowohl für die Nutzung des Adressraums als auch für die Skalierung des Routings unzureichend geworden war. CIDR umfasste deshalb weit mehr als die Schreibweise /8, /16 oder /24: Dazu gehörten eine neue Struktur der IP-Adressierung, eine neue Architektur der Adressvergabe und entsprechende Veränderungen im Routing. Der entscheidende Gedanke war die Hierarchie.
Statt Adressbereiche möglichst unabhängig voneinander zu verteilen, konnten größere zusammenhängende Präfixe vergeben und anschließend strukturiert weiter unterteilt werden. Vereinfacht gedacht könnte eine Registry einen größeren Bereich an einen Provider vergeben. Der Provider unterteilt diesen Bereich wiederum und weist kleinere Präfixe seinen Kund:innen zu. Damit entsteht eine Hierarchie: IANA → RIR → Provider → Kundennetz. Die einzelnen Kundennetze benötigen weiterhin ihre eigenen Präfixe. Für das globale Routing muss daraus aber nicht zwangsläufig dieselbe Anzahl unabhängiger Routen entstehen.
Aus vielen Routen kann eine werden
Nehmen wir an, ein Provider verfügt über einen zusammenhängenden Adressbereich und vergibt daraus zahlreiche kleinere Präfixe an seine Kund:innen. Innerhalb seines Netzes muss er diese Präfixe unterscheiden können. Gegenüber anderen Netzen kann er jedoch unter geeigneten Voraussetzungen den übergeordneten gemeinsamen Präfix bekannt machen. Genau das ist die Aggregation, die wir zuvor bereits kennengelernt haben.
RFC 2101 beschreibt diese Skalierung auf mehreren Ebenen: Nicht nur einzelne Subnetze und Netze können zusammengefasst werden. Auch Organisationen können ihre internen Ziele aggregieren und Provider wiederum die Netze ihrer angeschlossenen Kund:innen.
Damit bekommt die Vergabe einer IPv4-Adresse eine zusätzliche Bedeutung. Woher ein Präfix stammt und wo es innerhalb der Netztopologie verwendet wird, beeinflusst, wie gut sich Routinginformationen hierarchisch zusammenfassen lassen. Adressverwaltung und Routingarchitektur werden damit unmittelbar miteinander verzahnt.
Auf der Datenautobahn Richtung Hamburg
Eine Analogie aus dem Straßenverkehr macht dieses Prinzip anschaulicher. Wer in München auf die Autobahn in Richtung Hamburg fährt, benötigt dort noch keine Wegweiser zu jedem einzelnen Stadtteil und jeder kleinen Ortschaft im Hamburger Umland. In rund 700 Kilometern Entfernung genügt zunächst die Information: Hamburg – diese Richtung.
Je näher die Reise ihrem Ziel kommt, desto detaillierter werden die Wegweiser. Zunächst reicht die Richtung Hamburg, später unterscheiden Schilder zwischen verschiedenen Autobahnen und Stadtteilen, und im unmittelbaren Zielgebiet werden schließlich einzelne Straßen und Ausfahrten relevant. Die notwendige Information wird also detaillierter, je näher wir dem konkreten Ziel kommen.
Ganz ähnlich funktioniert hierarchisch aggregiertes Routing. Ein weit entfernter Router muss nicht zwangsläufig jedes einzelne Kundennetz eines Providers kennen. Ihm kann ein größerer gemeinsamer Präfix genügen, der sinngemäß sagt: ‚Alle diese Ziele erreichst du in dieser Richtung.‘ Erst innerhalb der entsprechenden Netzhierarchie werden die Routinginformationen zunehmend spezifischer.
Adressbereiche müssen zusammenpassen
Damit dieses Prinzip funktioniert, müssen allerdings auch die Adressen sinnvoll vergeben werden. Stellen wir uns vor, die Postleitzahlen einzelner Hamburger Stadtteile würden beliebig über München, Köln und Hamburg verteilt. Eine gemeinsame Richtungsangabe Hamburg würde dann nicht mehr genügen. Die einzelnen Ziele müssten bereits aus großer Entfernung voneinander unterschieden werden.
Bei IP-Präfixen verhält es sich ähnlich. Adressbereiche, die routingtechnisch zusammengehören, sollten möglichst auch in zusammenhängenden Präfixen organisiert sein. Werden benachbarte Adressbereiche dagegen unabhängig über weit voneinander entfernte Teile der Netztopologie verteilt, lassen sie sich nicht mehr ohne Weiteres unter einer gemeinsamen Route zusammenfassen.
Der Preis der Aggregation: Adressen folgen der Topologie
Die enge Verbindung zwischen Adressvergabe und Routingtopologie bringt allerdings eine Konsequenz mit sich. Erhält eine Organisation ihren öffentlichen Adressbereich aus einem größeren Präfix ihres Providers, ist dieser Bereich zugleich Teil dessen hierarchischer Routingstruktur. Problematisch wird das beispielsweise bei einem Providerwechsel. Behält die Organisation ihren bisherigen Adressbereich, befindet sich dieser routingtechnisch plötzlich an einer anderen Stelle. Der neue Provider müsste das Präfix gegebenenfalls separat bekannt machen, damit der Verkehr weiterhin sein Ziel erreicht. Eine zuvor mögliche Aggregation wird damit durch eine zusätzliche spezifische Route durchbrochen.
RFC 2101 beschreibt genau diesen Zielkonflikt. Soll die Skalierbarkeit des globalen Routings erhalten bleiben, kann ein Providerwechsel deshalb bedeuten, dass ein angeschlossenes Netz neu adressiert werden muss. Die Adressen aus dem Präfix des bisherigen Providers werden aufgegeben und durch Adressen aus dem Adressraum des neuen Providers ersetzt. Dahinter steckt ein grundlegender Perspektivwechsel: Öffentliche IPv4-Adressen sind in einer hierarchischen Routingarchitektur nicht zwangsläufig dauerhafte Identitäten einer Organisation. Sie können zugleich topologische Informationen darüber transportieren, an welcher Stelle ein Netz in die übergeordnete Routingstruktur eingebunden ist.
Für Administrator:innen war das keine besonders angenehme Vorstellung. Eine Änderung öffentlicher Adressen konnte schließlich Anpassungen an zahlreichen Systemen, Diensten und Konfigurationen nach sich ziehen. Aus Sicht des globalen Routings hatte diese Kopplung jedoch einen wichtigen Zweck: Adressbereiche sollten möglichst dort verbleiben, wo sie sich gemeinsam mit benachbarten Präfixen effizient aggregieren lassen. Das ist ein bemerkenswerter Wandel gegenüber den frühen Jahren des Internets.
Das Internet konnte seine Vergangenheit nicht löschen
Die Einführung von CIDR bedeutete nicht, dass die historisch gewachsene Verteilung des IPv4-Adressraums noch einmal von Grund auf neu geordnet werden konnte. Bestehende Zuweisungen ließen sich weder einfach einsammeln noch anschließend nach einem neuen Schema über Regionen, Provider und Organisationen verteilen. Die neue Architektur musste deshalb mit dem bereits vorhandenen Internet weiterarbeiten. Legacy-Zuweisungen blieben bestehen, während neue Adressbereiche zunehmend bedarfsgerechter, hierarchischer und mit Blick auf ihre spätere Aggregierbarkeit vergeben wurden.
Gerade darin liegt eine bemerkenswerte Leistung dieser Entwicklung. Das Internet wurde nicht auf der grünen Wiese neu entworfen. Eine bereits weltweit genutzte und kontinuierlich wachsende Infrastruktur musste während des laufenden Betriebs auf ein skalierbareres Adressierungs- und Routingmodell umgestellt werden.
CIDR war deshalb weit mehr als die technische Ablösung der Adressklassen. Es veränderte grundlegend, wie Netzgrößen definiert, Adressräume strukturiert und Routinginformationen hierarchisch zusammengefasst werden konnten. Gleichzeitig musste dieses neue Modell mit den Strukturen koexistieren, die aus den ersten Jahrzehnten des Internets erhalten geblieben waren. Was wir dabei auf globaler Ebene betrachtet haben, lässt sich nun auf einen wesentlich kleineren Maßstab übertragen. Auch innerhalb eines Unternehmensnetzes stellt sich die Frage, wie ein vorhandener Adressraum möglichst sinnvoll strukturiert werden kann. Ein Präfix lässt sich in kleinere Netze zerlegen, um unterschiedliche Anforderungen abzubilden. Umgekehrt können geeignete zusammenhängende Präfixe wieder unter einem größeren gemeinsamen Präfix zusammengefasst werden. Aus der globalen Herausforderung, IPv4 skalierbar zu organisieren, wird damit eine ganz praktische Aufgabe der Netzplanung: Wie schneiden wir einen vorhandenen Adressraum so zu, dass daraus passende Netze entstehen?
Subnetting und Supernetting – wenn die Netzgrenze flexibel wird
CIDR hat uns von den starren Grenzen der historischen Adressklassen befreit. Ein IPv4-Netz muss nicht bei /8, /16 oder /24 enden. Die Präfixlänge kann wesentlich genauer an die benötigte Netzstruktur angepasst werden. Damit erhalten Administrator:innen ein mächtiges Werkzeug: Ein vorhandener Adressbereich lässt sich in mehrere kleinere Präfixe unterteilen. Umgekehrt können geeignete zusammenhängende Präfixe unter einem größeren gemeinsamen Präfix zusammengefasst werden. Beide Vorgänge beruhen auf derselben binären Grundlage: Subnetting verlängert den Präfix – Supernetting beziehungsweise Aggregation verkürzt ihn.
Was zunächst nach einfacher Bit-Arithmetik klingt, verursacht in der Praxis allerdings regelmäßig Verständnisprobleme. Denn mit jeder Veränderung der Präfixlänge verändern sich gleichzeitig die Netzgrenzen, die Größe der einzelnen Netze sowie die darin enthaltenen Netzwerk-, Host- und Broadcastadressen.
Warum teilen wir Netze überhaupt auf?
Stellen wir uns ein Unternehmen vor, dem intern der Adressbereich 192.168.10.0/24 zur Verfügung steht. Dieser Bereich umfasst 256 IPv4-Adressen. Technisch könnten viele Systeme zunächst gemeinsam innerhalb dieses einen Netzes betrieben werden. Aus Sicht einer strukturierten Netzarchitektur ist das jedoch nicht zwangsläufig sinnvoll.
Vielleicht sollen unterschiedliche Gebäude, VLANs oder technische Funktionsbereiche eigene IP-Netze erhalten. Server sollen von Arbeitsplatzsystemen getrennt werden, Netzwerkmanagement erhält einen eigenen Bereich und weitere Netze werden für andere Aufgaben benötigt. Subnetting ermöglicht es, den vorhandenen Adressraum dafür systematisch in kleinere Präfixe zu zerlegen. Wichtig ist dabei eine Unterscheidung: Subnetting allein erzeugt noch keine Sicherheitsgrenze. Es schafft zunächst unterschiedliche Layer-3-Netze. Welche Kommunikation zwischen ihnen erlaubt ist, bestimmen anschließend Router, Firewalls, ACLs und andere Sicherheitsmechanismen.
Subnetting bedeutet: Wir verschieben die Netzgrenze
Betrachten wir unser Ausgangsnetz:
192.168.10.0/24
Die /24 sagt uns, dass 24 Bit zum Präfix gehören. Für den Hostanteil verbleiben damit: 32 - 24 = 8 Bit. Mit acht variablen Bit lassen sich 2⁸ = 256 unterschiedliche Bitkombinationen darstellen. Nun möchten wir aus diesem /24 vier gleich große Subnetze erzeugen.
Vier entspricht: 2² = 4
Wir benötigen also zwei zusätzliche Bit, um die vier Subnetze voneinander unterscheiden zu können. Diese Bit werden dem bisherigen Hostanteil entnommen und dem Präfix zugeschlagen: /24 + 2 Bit = /26
Aus dem ursprünglichen /24 entstehen damit vier /26-Präfixe. Genau das ist der Kern des Subnettings: Wir leihen uns keine geheimnisvollen Subnetzbits. Wir verlängern den Präfix und reduzieren dadurch die Zahl der verbleibenden Hostbits.
Was passiert auf Bit-Ebene?
Schauen wir nur auf das letzte Oktett unseres /24.
Ursprünglich gehören alle acht Bit zum variablen Anteil:
192.168.10.00000000
Bei /26 werden die ersten beiden dieser acht Bit Bestandteil des Präfixes:
192.168.10.00|000000
192.168.10.01|000000
192.168.10.10|000000
192.168.10.11|000000
Die beiden zusätzlichen Präfixbits können vier Kombinationen annehmen: 00, 01, 10 und 11. Damit entstehen vier Netze. Für Adressen innerhalb jedes dieser Netze verbleiben sechs variable Bit: 2⁶ = 64. Jedes /26 umfasst also 64 IPv4-Adressen und daraus können wir unmittelbar die Netzgrenzen ableiten.
Vier Netze entstehen
Unser ursprüngliches Netz 192.168.10.0/24 zerfällt in:
| Präfix | Netzwerkadresse | Hostbereich | Broadcastadresse |
| 192.168.10.0/26 | .0 | .1 – .62 | .63 |
| 192.168.10.64/26 | .64 | .65 – .126 | .127 |
| 192.168.10.128/26 | .128 | .129 – .190 | .191 |
| 192.168.10.192/26 | .192 | .193 – .254 | .255 |
Hier wird ein häufiges Missverständnis unmittelbar sichtbar: Eine Netzwerkadresse muss nicht auf .0 und eine Broadcastadresse nicht auf .255 enden. Die IP-Adresse 192.168.10.64 ist beispielsweise die Netzwerkadresse des zweiten /26, während 192.168.10.127 dessen Broadcastadresse ist. Entscheidend ist nicht die dezimale Darstellung des letzten Oktetts, sondern die durch den Präfix definierte Bitgrenze.
Woher kommen 0, 64, 128 und 192?
Diese Werte muss niemand auswendig lernen. Ein /26 entspricht der Netzmaske: 255.255.255.192. Das interessante Oktett ist damit das letzte. Binär lautet es: 11000000. Die ersten beiden Bit gehören zum Präfix, sechs Bit verbleiben variabel. Diese sechs Bit ermöglichen 64 unterschiedliche Kombinationen.
Damit beträgt die Blockgröße 64. Die möglichen Netzgrenzen im letzten Oktett liegen folglich bei: 0 → 64 → 128 → 192. Nach jeweils 64 Adressen beginnt das nächste Präfix. Alternativ lässt sich die Blockgröße bei einer klassischen Subnetzmaske auch über 256 - 192 = 64 ermitteln.
Diese Methode ist für viele IPv4-Berechnungen ausgesprochen praktisch. Wichtiger als die Formel ist jedoch das Verständnis dahinter: Die Blockgröße entsteht aus der Anzahl der Bit, die nach der Präfixgrenze noch variieren können.
Netzwerkadresse, Hostadressen und Broadcastadresse
Innerhalb eines klassischen IPv4-Subnetzes besitzen die möglichen Bitkombinationen unterschiedliche Bedeutungen. Sind alle Hostbits 0, beschreibt die Adresse das Präfix selbst. Bei 192.168.10.64/26 lautet die entsprechende Bitkombination im letzten Oktett: 01|000000. Das ergibt dezimal .64 – unsere Netzwerkadresse. Sind dagegen alle Hostbits 1, erhalten wir: 01|111111. Das ergibt .127 – die gerichtete Broadcastadresse dieses Subnetzes.
Zwischen beiden liegen die regulär an Hosts vergebbaren Adressen .65 bis .126. Damit ergibt sich für ein konventionelles IPv4-Subnetz die bekannte Berechnung: Nutzbare Hostadressen = 2ᴴ − 2 wobei H für die Anzahl der Hostbits steht. Bei /26 verbleiben sechs Hostbits: 2⁶ - 2 = 62. Ein /26 besitzt damit 64 Adressen, von denen klassisch 62 regulär Hostinterfaces zugewiesen werden können.
Zwei Adressen weniger – aber nicht immer
Diese Regel ist wichtig, sollte aber nicht als unveränderliches IPv4-Naturgesetz vermittelt werden. Für typische IPv4-LANs gilt beispielsweise:
- /24 → 256 Adressen → 254 reguläre Hostadressen
- /26 → 64 Adressen → 62 reguläre Hostadressen
- /27 → 32 Adressen → 30 reguläre Hostadressen
- /30 → 4 Adressen → 2 reguläre Hostadressen
Mit /31 stoßen wir jedoch auf einen wichtigen Sonderfall. Für klassische Mehrfachzugriffsnetze würde kein regulärer Hostbereich mehr übrig bleiben: 2¹ - 2 = 0. Auf Point-to-Point-Verbindungen können /31-Präfixe nach RFC 3021 dennoch sinnvoll verwendet werden. Dort gibt es nur zwei Endpunkte und keinen Bedarf für eine klassische Netzwerk- und Broadcastsemantik wie in einem gewöhnlichen LAN. Beide Adressen können deshalb als Endpunktadressen verwendet werden.
Auch /32 besitzt eine eigene Bedeutung: Es bezeichnet genau eine einzelne IPv4-Adresse und begegnet uns beispielsweise bei Hostrouten oder Loopback-Adressen. Die Formel 2ᴴ − 2 ist deshalb eine wichtige Grundlage für klassische IPv4-Subnetze – aber keine universelle Regel für jede mögliche Präfixlänge und jeden Einsatzzweck.
Warum kleine Subnetze relativ mehr Adressraum kosten
Nun zeigt sich eine interessante Konsequenz des Subnettings. Ein /24 besitzt 256 Adressen. Zwei davon entfallen klassisch auf Netzwerk- und Broadcastadresse. Der Anteil beträgt damit lediglich: 2 / 256 = 0,78125 %. Bei einem /27 sind es weiterhin zwei Adressen – diesmal aber von nur 32: 2 / 32 = 6,25 %, bei /30 schließlich: 2 / 4 = 50 %.
Je kleiner wir klassische IPv4-Subnetze schneiden, desto größer wird also der relative Anteil des Adressraums, der nicht als reguläre Hostadresse verwendet werden kann. Das bedeutet allerdings nicht, dass kleine Subnetze grundsätzlich schlecht geplant sind. Ein Netz sollte nicht künstlich größer gestaltet werden, nur um den prozentualen Adressverlust zu reduzieren. VLAN-Struktur, erwartetes Wachstum, Broadcast-Verhalten, Routingdesign, Redundanz und betriebliche Anforderungen können wesentlich wichtiger sein. Gute Subnetzplanung sucht deshalb nicht das mathematisch sparsamste Netz, sondern einen sinnvollen Kompromiss zwischen benötigter Größe, Struktur, Wachstum und administrativer Beherrschbarkeit.
Subnet Zero und All-Ones Subnet – wenn zwei ganze Netze verloren gingen
Unsere bisherige Rechnung entspricht der heutigen Praxis: Teilen wir 192.168.5.0/24 in vier /26-Netze, können grundsätzlich alle vier Subnetze verwendet werden. Historisch war das nicht immer selbstverständlich. RFC 950 empfahl 1985, zwei besondere Werte des Subnetzfeldes nicht für tatsächliche Subnetze zu verwenden: den Wert, bei dem alle Subnetzbits 0 sind, und den Wert, bei dem alle Subnetzbits 1 sind. Daraus entstanden die Begriffe Subnet Zero beziehungsweise All-Zeros Subnet und All-Ones Subnet.
Warum diese Unterscheidung wichtig ist, zeigt unser /26-Beispiel besonders anschaulich. Ausgehend von einem historischen Klasse-C-Netz 192.168.5.0/24 verwenden wir zwei zusätzliche Bit zur Bildung von vier Subnetzen:
00|000000 → 192.168.5.0/26
01|000000 → 192.168.5.64/26
10|000000 → 192.168.5.128/26
11|000000 → 192.168.5.192/26
Die ersten beiden dargestellten Bit sind unsere Subnetzbits, die verbleibenden sechs Bit die Hostbits. Nach der damaligen Empfehlung wären 00 und 11 als Subnetzwerte problematisch gewesen. Nutzbar blieben damit lediglich die beiden mittleren Subnetze 01 und 10.
Warum ausgerechnet das erste und letzte Subnetz?
Der Hintergrund dieser Einschränkung liegt in der Abwärtskompatibilität zur ursprünglichen klassenbezogenen Interpretation von IPv4-Adressen. Subnetting und später CIDR veränderten die Art, wie Netzgrenzen bestimmt wurden. Die zuvor etablierten Bedeutungen bestimmter Adressmuster verschwanden damit jedoch nicht schlagartig aus Protokollen, Implementierungen und vorhandenen Netzwerken. Bereits RFC 950 empfahl deshalb, die Werte aus ausschließlich Nullen beziehungsweise Einsen im Subnetzfeld nicht für tatsächliche Subnetze zu verwenden. Die besondere Bedeutung von ‚all zeros‘ für dieses Netz und ‚all ones‘ für alle Hosts sollte auch in subnettierten Netzen erhalten bleiben.
Beim Subnet Zero lässt sich das daraus entstehende Problem unmittelbar erkennen. Unser ursprüngliches Netz lautet: 192.168.5.0/24. Teilen wir dieses Netz in /26-Subnetze, beginnt das erste davon ebenfalls mit: 192.168.5.0/26. Die Netzwerkadresse des übergeordneten Netzes und die Netzwerkadresse seines ersten Subnetzes sind damit in ihrer reinen Dezimalschreibweise identisch. Erst die Netzmaske beziehungsweise Präfixlänge macht deutlich, welche Netzgrenze tatsächlich gemeint ist. Cisco beschreibt genau diese nicht unterscheidbaren Netzwerk- und Subnetzadressen als historischen Grund dafür, die Verwendung von Subnet Zero zu vermeiden.
Am anderen Ende des Adressraums entsteht ein vergleichbares Problem. Der Broadcast des letzten /26 lautet: 192.168.5.255. Doch auch der Broadcast des übergeordneten /24 lautet: 192.168.5.255. Beim All-Ones Subnet fallen damit der Broadcast des letzten Subnetzes und der Broadcast des übergeordneten klassenbezogenen Netzes zusammen. Auch hier konnte ohne eindeutigen Kontext nicht ohne Weiteres unterschieden werden, auf welche Ebene sich die Adresse beziehen sollte.
Standards ändern sich schneller als reale Netzwerke
Mit der Entwicklung hin zu classless addressing verloren solche Mehrdeutigkeiten zunehmend ihre praktische Bedeutung. Die Netzgrenze wurde nun explizit durch Netzmaske beziehungsweise Präfix beschrieben. Das bedeutete jedoch nicht, dass alle vorhandenen Router, Hosts, Routingprotokolle und Konfigurationen über Nacht nach denselben neuen Regeln arbeiteten. Klassenbezogene und zunehmend klassenlose Strukturen mussten über einen längeren Zeitraum miteinander koexistieren. Gerade in einer solchen Übergangsphase war es sinnvoll, bei Adresskonstruktionen vorsichtig zu sein, die ältere Implementierungen möglicherweise anders interpretierten.
Wie lange diese Historie praktisch nachwirkte, zeigt ausgerechnet Cisco sehr anschaulich. Vor Cisco IOS 12.0 war Subnet Zero auf Cisco-Routern standardmäßig nicht für Interface-Adressen zugelassen. Administrator:innen mussten die Verwendung mit ‚ip subnet-zero‘ explizit aktivieren. Erst mit IOS 12.0 wurde ip subnet-zero zur Standardeinstellung. Die umgekehrte Konfiguration ‚no ip subnet-zero‘ blieb erhalten, um die Verwendung von Subnet Zero wieder einzuschränken.
Wer über viele Jahre mit Cisco IOS gearbeitet hat, konnte damit noch lange einem Konfigurationsbefehl begegnen, dessen Ursprung in einer wesentlich älteren Phase der IPv4-Adressierung lag. Genau darin zeigt sich ein typisches Muster der Netzwerktechnik: Ein neuer Standard kann ein technisches Problem lösen – bis die letzte ältere Implementierung aus produktiven Netzen verschwunden ist, können die bisherigen Regeln trotzdem noch lange relevant bleiben.
Zwei unterschiedliche Arten von Adressverlust
Damit können wir nun eine Unterscheidung treffen, die für die weitere Rechnung entscheidend ist. In einem verwendbaren klassischen IPv4-Subnetz verlieren wir normalerweise lediglich die beiden bekannten Adressen: Netzwerkadresse und Broadcastadresse. Nach der historischen Regel gingen beim Subnetting zusätzlich das erste und letzte Subnetz vollständig für die reguläre Nutzung verloren.
Bei unserem /26-Beispiel sieht die Rechnung deshalb drastisch anders aus. Das ursprüngliche /24 enthält insgesamt: 256 Adressen. Ohne Subnetting können davon klassisch 254 als Hostadressen genutzt werden.
Nach der Unterteilung in vier /26-Netze umfasst jedes Subnetz 64 Adressen. Nach der alten Regel würden das erste und letzte Subnetz nicht verwendet: 64 + 64 = 128 Adressen. Übrig bleiben die beiden mittleren /26-Netze. In jedem davon entfallen zusätzlich Netzwerk- und Broadcastadresse: 2 × 2 = 4 Adressen. Damit bleiben lediglich: 256 - 128 - 4 = 124 regulär nutzbare Hostadressen. Gegenüber den 256 Adressen des ursprünglichen Blocks sind damit 132 Adressen nicht als reguläre Hostadressen nutzbar. Das ist erheblich mehr als die acht Adressen, die bei heutiger Nutzung aller vier /26-Subnetze durch deren jeweilige Netzwerk- und Broadcastadressen gebunden wären.
Kann kleineres Subnetting den Verlust reduzieren?
Unter den damaligen Regeln entstand daraus eine interessante mathematische Konsequenz. Wenn ohnehin das erste und letzte Subnetz vollständig entfielen, konnte es vorteilhaft erscheinen, diese beiden Subnetze kleiner zu machen. Teilen wir unser /24 nicht in vier /26, sondern in acht /27, umfasst jedes Subnetz nur noch 32 Adressen.
Nach der historischen Regel entfallen wieder das erste und letzte Subnetz vollständig: 2 × 32 = 64. Von den sechs verbleibenden Subnetzen verlieren wir jeweils Netzwerk- und Broadcastadresse: 6 × 2 = 12. Insgesamt sind damit: 64 + 12 = 76 Adressen nicht als reguläre Hostadressen nutzbar.
Das ist bereits erheblich weniger als die 132 Adressen unseres /26-Beispiels. Gehen wir einen Schritt weiter und verwenden /28, entstehen 16 Subnetze mit jeweils 16 Adressen. Erstes und letztes Subnetz kosten zusammen nur noch 32 Adressen. In den verbleibenden 14 Subnetzen entfallen jeweils zwei weitere Adressen: 32 + (14 × 2) = 60. Der Verlust sinkt also nochmals.
Irgendwann kehrt sich der Effekt um
Damit könnte der Eindruck entstehen: Je kleiner die Subnetze, desto besser. Doch genau das stimmt nicht. Bei jeder weiteren Unterteilung werden zwar das ausgeschlossene erste und letzte Subnetz kleiner. Gleichzeitig steigt aber die Anzahl der verwendbaren Subnetze, und jedes davon benötigt wiederum eine eigene Netzwerk- und Broadcastadresse.
Das lässt sich für unseren ursprünglichen /24 sehr schön gegenüberstellen:
| Aufteilung | Subnetze | Adressen je Subnetz | Verlust nach alter Regel | regulär nutzbare Hostadressen |
| /26 | 4 | 64 | 132 | 124 |
| /27 | 8 | 32 | 76 | 180 |
| /28 | 16 | 16 | 60 | 196 |
| /29 | 32 | 8 | 76 | 180 |
| /30 | 64 | 4 | 132 | 124 |
Damit sehen wir einen bemerkenswerten Effekt: In diesem konkreten Szenario liegt das rechnerische Optimum der alten 2ⁿ − 2-Subnetzregel bei /28. Ab diesem Punkt überwiegt der Verlust durch die immer zahlreicher werdenden Netzwerk- und Broadcastadressen. Die Kurve dreht sich wieder um.
Aus einer Regel wird ein Relikt
Diese Einschränkung gehört heute nicht mehr zur regulären IPv4-Netzplanung. RFC 1878 dokumentierte 1995 die Verwendung aller definierbaren Subnetze und bezeichnete die Berechnung unter Ausschluss des All-Zeros- und All-Ones-Subnetzes bereits als obsolete Praxis. Damit änderte sich auch eine Rechenregel, die sich über viele Jahre in Lehrmaterialien und Prüfungsfragen gehalten hatte. Historisch begegnet uns für die Anzahl nutzbarer Subnetze häufig: 2ⁿ − 2 Subnetze.
Das erste und das letzte Subnetz wurden abgezogen. Nach heutiger Betrachtung stehen grundsätzlich alle durch die zusätzlichen Subnetzbits darstellbaren Kombinationen zur Verfügung: 2ⁿ Subnetze. Die historische Regel bleibt dennoch interessant, weil sie erklärt, warum ältere Netzpläne mitunter auffallend kleinteilig aufgebaut sind. Wie unser Rechenbeispiel gezeigt hat, konnte eine feinere Unterteilung unter den damaligen Bedingungen tatsächlich dabei helfen, den Adressverlust durch das nicht verwendete erste und letzte Subnetz zu reduzieren.
Daraus sollte heute allerdings keine pauschale Empfehlung für möglichst kleine IPv4-Subnetze abgeleitet werden. Kleine Netze können weiterhin sinnvoll sein – beispielsweise für eine klare VLAN-Struktur, die Begrenzung von Broadcast-Domänen oder die funktionale Trennung unterschiedlicher Systeme. Ihre Größe sollte sich jedoch aus den aktuellen technischen und betrieblichen Anforderungen ergeben und nicht aus einer Adressierungsregel, die längst keine praktische Notwendigkeit mehr darstellt.
Umgekehrt ist auch ein historisch gewachsenes Netzdesign nicht allein deshalb schlecht, weil es viele kleine Subnetze enthält. Sind deren Grenzen jedoch nur noch das Ergebnis längst überholter Subnetting-Regeln, lohnt sich im Rahmen einer Modernisierung durchaus die Frage, ob diese Struktur weiterhin einen technischen Zweck erfüllt. Gerade bei gewachsenen Netzwerken ist deshalb nicht nur interessant, wie ein Adressplan aufgebaut ist, sondern auch, warum er irgendwann genau so aufgebaut wurde.
Supernetting – die Präfixgrenze wandert zurück
Beim Subnetting haben wir einen vorhandenen Präfix verlängert. Aus einem /24 wurden beispielsweise mehrere /26-Netze. Die Präfixgrenze wanderte nach rechts: Bit, die zuvor zum Hostanteil gehörten, wurden Bestandteil des Präfixes. Beim Supernetting bewegen wir uns in die entgegengesetzte Richtung. Mehrere benachbarte Netze können unter einem gemeinsamen, kürzeren Präfix zusammengefasst werden – vorausgesetzt, ihre Adressen stimmen in den dafür benötigten Präfixbits überein.
Nehmen wir vier aufeinanderfolgende /24-Netze:
192.168.0.0/24
192.168.1.0/24
192.168.2.0/24
192.168.3.0/24
Bei /24 gehören jeweils die ersten 24 Bit zur Netzwerkkennung. Schauen wir uns jedoch die vier Netzwerkadressen binär an, fällt eine Gemeinsamkeit auf:
192.168.0.0 → 11000000.10101000.00000000.00000000
192.168.1.0 C 11000000.10101000.00000001.00000000
192.168.2.0 → 11000000.10101000.00000010.00000000
192.168.3.0 → 11000000.10101000.00000011.00000000
Die ersten 22 Bit sind bei allen vier Adressen identisch. Erst im 23. und 24. Bit unterscheiden sich die bisherigen Netzwerkkennungen:
11000000.10101000.000000|00
11000000.10101000.000000|01
11000000.10101000.000000|10
11000000.10101000.000000|11
Genau diese beiden Bit haben zuvor dafür gesorgt, dass wir vier unterschiedliche /24-Netze betrachten. Verschieben wir nun die Präfixgrenze von /24 auf /22, gehören das 23. und 24. Bit nicht mehr zum gemeinsamen Präfix. Sie werden Bestandteil des variablen Adressanteils:
11000000.10101000.000000|00.00000000
Aus vier unterschiedlichen /24-Netzen entsteht damit ein gemeinsamer Adressbereich: 192.168.0.0/22. Der neue /22-Präfix besitzt zehn variable Bit und umfasst deshalb: 2¹⁰ = 1.024 Adressen. Der Bereich reicht von 192.168.0.0 bis 192.168.3.255.
Damit wird das Prinzip des Supernettings unmittelbar sichtbar: Wir fügen die vier Netze nicht nachträglich irgendwie zusammen. Wir verschieben die Präfixgrenze so weit nach links, bis die zuvor unterschiedlichen Netzwerkbits außerhalb des gemeinsamen Präfixes liegen. Aus vier Netzwerkkennungen wird dadurch eine gemeinsame Netzwerkkennung.
Benachbart bedeutet noch nicht aggregierbar
An dieser Stelle lauert allerdings eine typische Falle. Es genügt nicht, dass zwei Netze im Adressraum unmittelbar aufeinander folgen. Entscheidend ist, ob sie einen gemeinsamen Präfix besitzen, der beide Netze vollständig und ohne zusätzliche Adressbereiche beschreibt.
Betrachten wir zunächst die Netzwerke 192.168.0.0/24 und 192.168.1.0/24. In Binärdarstellung unterscheiden sich die beiden Netzwerkadressen erst im 24. Bit:
192.168.0.0 → 11000000.10101000.0000000|0.00000000
192.168.1.0 → 11000000.10101000.0000000|1.00000000
Die ersten 23 Bit sind identisch. Das 24. Bit unterscheidet die beiden bisherigen /24-Netze. Verschieben wir die Präfixgrenze um ein Bit nach links, wird genau dieses unterschiedliche Bit zum variablen Anteil. Beide Netze lassen sich damit unter einem gemeinsamen /23 zusammenfassen: 192.168.0.0/23. Dieser Präfix umfasst den gesamten Bereich von 192.168.0.0 bis 192.168.1.255.
Das funktioniert ebenso mit den beiden /24-Netzen 192.168.2.0/24 und 192.168.3.0/24.
Binär betrachtet:
192.168.2.0 → 11000000.10101000.0000001|0.00000000
192.168.3.0 → 11000000.10101000.0000001|1.00000000
Auch hier sind die ersten 23 Bit identisch. Daraus entsteht: 192.168.2.0/23 mit dem Adressbereich von 192.168.2.0 bis 192.168.3.255.
Warum funktionieren .1 und .2 dann nicht?
Interessant wird es, wenn wir zwei ebenfalls unmittelbar benachbarte Netze auswählen – 192.168.1.0/24 und 192.168.2.0/24. Dezimal betrachtet könnte die Zusammenfassung zunächst plausibel erscheinen. Schließlich folgt .2 unmittelbar auf .1.
Die Binärdarstellung zeigt jedoch das Problem:
192.168.1.0 → 11000000.10101000.00000001.00000000
192.168.2.0 → 11000000.10101000.00000010.00000000
Markieren wir die ersten 23 Bit, wird der Unterschied deutlicher:
192.168.1.0 → 11000000.10101000.0000000|1.00000000
192.168.2.0 → 11000000.10101000.0000001|0.00000000
Diesmal unterscheiden sich die Adressen bereits innerhalb der ersten 23 Bit. Es existiert deshalb kein gemeinsamer /23-Präfix, der exakt diese beiden /24-Netze umfasst. Genau deshalb bilden sich die gültigen /23-Blöcke paarweise:
192.168.0.0/23 → .0.0 bis .1.255
192.168.2.0/23 → .2.0 bis .3.255
192.168.4.0/23 → .4.0 bis .5.255
Die IP-Adresse 192.168.1.0 liegt nicht am Anfang eines solchen /23-Blocks, sondern innerhalb des Bereichs 192.168.0.0/23. Die Adresse 192.168.2.0 bildet dagegen bereits den Beginn des nächsten /23. Zusammenhängende Adressbereiche allein reichen für eine Aggregation also nicht aus. Die beteiligten Netze müssen auch über die benötigte Anzahl gemeinsamer führender Bit verfügen. Erst diese gemeinsamen Bit bestimmen, welcher größere Präfix tatsächlich gebildet werden kann.
Aggregation darf keine fremden Netze einschließen
Damit ergibt sich eine zweite wichtige Konsequenz. Eine Zusammenfassung ist nur dann korrekt, wenn der aggregierte Präfix tatsächlich den Adressbereich beschreibt, der über diesen Weg erreichbar sein soll.
Angenommen, ein Router kennt lediglich:
192.168.0.0/24
192.168.1.0/24
192.168.3.0/24
Ein vermeintliches 192.168.0.0/22 wäre hier problematisch, denn dieser Präfix umfasst automatisch auch: 192.168.2.0/24. Die zusammengefasste Route würde damit einen Adressbereich als erreichbar ausweisen, der möglicherweise überhaupt nicht über diesen Router erreichbar ist.
Das führt zu einer wichtigen Erkenntnis: Eine mathematisch mögliche Zusammenfassung ist nicht automatisch eine routingtechnisch sinnvolle Zusammenfassung. Adressplanung und Routingdesign müssen deshalb zusammenpassen. Genau diese Verbindung haben wir bereits bei der Entwicklung von CIDR auf globaler Ebene kennengelernt.
Vom einzelnen Präfix zur Route Summarization
In der Routingpraxis begegnet uns dieses Prinzip vor allem als Route Summarization beziehungsweise Route Aggregation. Statt viele einzelne Präfixe an andere Router weiterzugeben, kann ein Router unter geeigneten Voraussetzungen einen gemeinsamen übergeordneten Präfix bekannt machen.
Aus 192.168.0.0/24, 192.168.1.0/24, 192.168.2.0/24 und 192.168.3.0/24 wird gegenüber einem anderen Teil des Netzes beispielsweise nur noch: 192.168.0.0/22. Der empfangende Router benötigt damit nicht mehr vier einzelne Informationen. Für seine Entscheidung genügt zunächst die Aussage: ‘Alle Adressen innerhalb dieses /22 erreichst du über diesen Weg.‘ Erst näher am Ziel wird wieder zwischen den spezifischeren /24-Präfixen unterschieden. Damit begegnet uns auf Unternehmensebene genau das hierarchische Prinzip wieder, das wir zuvor mit unserer Fahrt auf der Datenautobahn Richtung Hamburg beschrieben haben.
Route Summarization kann Routinginformationen reduzieren und eine Netzarchitektur übersichtlicher gestalten. In großen hierarchischen Unternehmensnetzen und insbesondere beim Routing zwischen autonomen Systemen ist dieses Prinzip ein wichtiger Baustein skalierbarer Architekturen. Dabei geht es allerdings nicht einfach darum, möglichst viele Routen um jeden Preis zu einer einzigen zusammenzufassen. Eine sinnvolle Aggregation setzt voraus, dass Adressplanung, Netztopologie und Erreichbarkeit zueinander passen.
Zwei Richtungen, ein binäres Prinzip
Subnetting und Supernetting erscheinen zunächst als zwei gegensätzliche Verfahren. Tatsächlich beruhen beide auf demselben Prinzip: Wir verändern die Position der Präfixgrenze innerhalb einer IP-Adresse.
Beim Subnetting verschieben wir diese Grenze nach rechts. Bit, die zuvor zum Hostanteil gehörten, werden Bestandteil des Präfixes. Aus einem größeren Netz entstehen dadurch mehrere kleinere Netze. Beim Supernetting beziehungsweise bei der Aggregation bewegen wir uns in die andere Richtung. Die Präfixgrenze wandert nach links. Unterschiede zwischen mehreren kleineren Präfixen werden damit Teil des variablen Adressbereichs, sodass geeignete Netze unter einem gemeinsamen kürzeren Präfix zusammengefasst werden können.
Die IPv4-Adresse selbst verändert dabei weder ihre Länge noch ihre grundlegende Struktur. Entscheidend ist allein, wie viele ihrer 32 Bit wir als gemeinsamen Präfix interpretieren. Damit wird aus der vermeintlichen Subnetting-Arithmetik ein grundlegendes Prinzip der IP-Kommunikation. Präfixe bestimmen, welche Adressen zu einem Netz gehören, wann ein Host ein Ziel als lokal betrachtet, welche Routen zu einer Zieladresse passen und welche Netze sich hierarchisch zusammenfassen lassen.
Subnetting schafft dort Granularität, wo unterschiedliche Netze benötigt werden. Aggregation reduziert diese Granularität dort wieder, wo mehrere Präfixe aus übergeordneter Sicht gemeinsam behandelt werden können. Gute Layer-3-Adressplanung muss beide Perspektiven zusammendenken. Die entscheidende Frage lautet damit nicht nur, ob sich Präfixe korrekt berechnen lassen. Viel wichtiger ist, ob wir verstehen, welche Auswirkungen eine verschobene Präfixgrenze auf die Kommunikation im IP-Netzwerk hat.

Exkurs: Subnetting – Prüfungsqual und Praxisrelevanz
Muss man das wirklich noch von Hand können?
Subnetting gehört vermutlich nicht zu den Themen, auf die sich Teilnehmer:innen eines Netzwerkseminars besonders freuen. Spätestens wenn IPv4-Adressen binär zerlegt, Präfixgrenzen verschoben und Netzwerk- sowie Broadcastadressen ohne technische Hilfsmittel bestimmt werden sollen, stellt sich regelmäßig eine durchaus berechtigte Frage: Muss man das heute wirklich noch von Hand können?
Schließlich gibt es seit vielen Jahren zuverlässige Subnetzkalkulatoren. Netzwerkmanagement- und IPAM-Systeme übernehmen große Teile der Adressplanung, Skripte können Präfixe automatisiert berechnen und inzwischen genügt häufig schon eine entsprechende Frage an eine KI, um Netzwerkadresse, Broadcastadresse und Hostbereich eines Präfixes bestimmen zu lassen.
Hinzu kommt eine weitere Frage: Welche Bedeutung hat eine möglichst sparsame Aufteilung öffentlicher IPv4-Adressen im Unternehmensnetz überhaupt noch, wenn dort überwiegend private Adressbereiche verwendet werden und NAT den Übergang zum öffentlichen Internet übernimmt?
Beide Einwände sind berechtigt. Und trotzdem wäre es ein Fehler, daraus zu schließen, Subnetting sei nur noch historischer Ballast.
Für Prüfungen ist Subnetting nahezu ideal
Zunächst gibt es einen ausgesprochen pragmatischen Grund, sich weiterhin damit zu beschäftigen: Subnetting ist ein hervorragendes Prüfungsthema. Das gilt sowohl in der beruflichen Ausbildung, beispielsweise für Fachinformatiker:innen, als auch für zahlreiche technische Zertifizierungen. Aus einer einzigen IPv4-Adresse und einem Präfix lassen sich problemlos unterschiedliche Aufgabenstellungen entwickeln: Netzwerkadresse bestimmen, Broadcastadresse berechnen, Hostbereich erkennen, Anzahl möglicher Hosts ermitteln oder entscheiden, ob zwei Adressen zum selben Netz gehören.
Für Prüfungsautor:innen hat das einen entscheidenden Vorteil: Die Aufgaben lassen sich variieren, verlangen mehrere gedankliche Schritte und besitzen am Ende meistens eine ziemlich eindeutige Lösung. 192.168.10.70/26 liegt entweder im Netz 192.168.10.64/26 – oder eben nicht. Zwischen richtig und falsch bleibt wenig Interpretationsspielraum. Für Prüfungsszenarien ist das ausgesprochen praktisch. Für Prüflinge macht genau das die Sache nicht unbedingt sympathischer.
In der Praxis darf der Taschenrechner gewinnen
Bei der täglichen Arbeit sieht die Situation anders aus. Es gibt wenig Grund, größere Adresspläne ausschließlich mit Papier und Bleistift zu entwickeln oder bei jeder Änderung Netzwerk- und Broadcastadressen mühsam im Kopf auszurechnen. Werkzeuge zu verwenden ist keine fachliche Schwäche. Im Gegenteil: Bei umfangreichen Adressplänen reduzieren geeignete Werkzeuge Flüchtigkeitsfehler und erleichtern Dokumentation sowie konsistente Planung. Niemand gewinnt etwas dadurch, wenn Administrator:innen 40 Präfixe manuell berechnen, nur um zu beweisen, dass sie es könnten.
Das gilt erst recht für neue Netze. Moderne Netzplanung umfasst weit mehr als die Frage, wie viele Hosts gerade in ein Subnetz passen. VLAN-Strukturen, Routing, Redundanz, Standortkonzepte, Wachstum, IPv6, Cloud-Netze und Sicherheitsarchitekturen müssen gemeinsam betrachtet werden. Der Subnetzkalkulator darf also ruhig geöffnet bleiben.
Aber jemand sollte verstehen, was er ausrechnet
Der entscheidende Unterschied liegt zwischen Berechnen und Verstehen. Wer einen Subnetzkalkulator verwendet, ohne die zugrunde liegende Präfixlogik zu verstehen, kann zwar ein Ergebnis ablesen – aber nur schwer beurteilen, ob dieses Ergebnis zur eigenen Netzarchitektur passt. Das zeigt sich besonders beim Troubleshooting.
Ein Client besitzt beispielsweise die IP-Adresse 192.168.10.70/26 und soll einen Server unter 192.168.10.130/26 erreichen. Wer Subnetting verstanden hat, erkennt relativ schnell: Diese beiden Systeme befinden sich nicht im selben /26. Der Client betrachtet das Ziel deshalb als remote und benötigt eine passende Route beziehungsweise einen Next Hop.
Dafür müssen nicht erst beide Adressen vollständig in Binärzahlen umgerechnet werden. Irgendwann wird aus der Rechnung ein mentales Modell. Und genau dort liegt für mich die eigentliche Praxisrelevanz.
Irgendwann sieht man nicht mehr die einzelnen Bit
Im Film The Matrix gibt es eine schöne Szene, in der Tank auf den über die Monitore laufenden Matrix-Code blickt. Für Außenstehende besteht die Anzeige lediglich aus einer kaum verständlichen Folge von Zeichen. Tank beschreibt seine Erfahrung sinngemäß damit, dass er sich daran gewöhnt habe und inzwischen nicht mehr den Code selbst wahrnehme.
Mit IP-Adressierung verhält es sich ein wenig ähnlich. Wer gerade Subnetting lernt, sieht zunächst: 192.168.10.130/26. Dann beginnt die Rechnerei: /26, also sechs Hostbits. 64 Adressen pro Block. Netzgrenzen bei 0, 64, 128 und 192. Die 130 liegt also im Bereich ab 128. Netzwerkadresse .128, Broadcastadresse .191.
Mit zunehmender Erfahrung verschwindet ein Teil dieser bewussten Rechnung. Bei /26 springen die Grenzen 0, 64, 128 und 192 irgendwann beinahe automatisch ins Auge. Ein /30 bedeutet Viererblöcke, ein /28 Sechzehnerblöcke und bei einem /23 muss der Blick eine Oktettgrenze weiterwandern. Man sieht irgendwann nicht mehr zuerst die Rechnung – man sieht das Netz. Das bedeutet nicht, dass jede Präfixgröße im Kopf berechnet werden muss. Entscheidend ist, ein Gefühl dafür zu entwickeln, was ein Präfix mit einer Adresse macht.
Subnetting steckt in wesentlich mehr als Subnetting
Genau deshalb reicht die Bedeutung dieses Themas weit über die Planung kleinerer IPv4-Netze hinaus. Routing basiert auf Präfixen. Die Entscheidung, ob ein Ziel lokal oder remote ist, basiert auf Präfixen. Route Summarization basiert auf gemeinsamen Präfixbits. Bei Fehlkonfigurationen entscheidet eine falsche Präfixlänge möglicherweise darüber, ob ein Host sein Ziel direkt auf dem lokalen Link sucht oder das Paket an einen Router übergibt. Auch bei ACLs, VPN-Konfigurationen, Cloud-Netzen und vielen Firewall-Regeln begegnen uns Adressbereiche in Präfixnotation.
Und selbst IPv6 befreit uns nicht von diesem Denken. Im Gegenteil: Dort wird die Präfixnotation noch selbstverständlicher Bestandteil der täglichen Adressierung. Wer Subnetting verstanden hat, lernt deshalb nicht lediglich, aus einem /24 vier /26 zu erzeugen. Es entsteht ein grundlegendes Verständnis dafür, wie IP-Netze durch Präfixe strukturiert werden und wie Geräte diese Strukturen interpretieren.
Rechnen lassen – aber selbst verstehen
Damit lässt sich die Ausgangsfrage vielleicht etwas differenzierter beantworten. Müssen Administrator:innen im Jahr 2026 jeden beliebigen IPv4-Adressbereich ohne Hilfsmittel binär zerlegen und daraus einen vollständigen Adressplan erstellen können? In der täglichen Praxis eher selten.
Sollten sie verstehen, warum 192.168.10.70/26 und 192.168.10.130/26 unterschiedliche Netze beschreiben, warum 192.168.0.0/22 vier passende /24-Netze zusammenfassen kann und warum eine falsche Präfixlänge zu erstaunlichen Kommunikationsproblemen führen kann? Unbedingt.
Subnetzkalkulatoren, Automatisierung und KI können uns die Rechenarbeit abnehmen. Sie sollten uns aber nicht das Verständnis dafür abnehmen, was diese Zahlen für die Kommunikation eines IP-Hosts tatsächlich bedeuten. Vielleicht ist genau das die versöhnlichste Perspektive auf eines der unbeliebtesten Themen vieler Netzwerkkurse: Das Ziel ist nicht, für immer Subnetting-Aufgaben zu rechnen. Das Ziel ist, lange genug damit gearbeitet zu haben, bis man hinter den Adressen die Struktur des Netzes erkennt.
NAT als Notlösung – wenn öffentliche Adressen knapp werden
CIDR konnte den vorhandenen IPv4-Adressraum wesentlich effizienter nutzbar machen. Adressblöcke ließen sich bedarfsgerechter vergeben und Routinginformationen besser aggregieren. An einer grundlegenden Grenze änderte das jedoch nichts: Eine IPv4-Adresse besitzt weiterhin nur 32 Bit. Damit stehen theoretisch 2³², also rund 4,3 Milliarden unterschiedliche Adressen zur Verfügung. Tatsächlich kann dieser Raum nicht vollständig für global adressierbare Endgeräte verwendet werden. Zahlreiche Bereiche besitzen besondere Funktionen, sind reserviert oder wurden für andere Zwecke vorgesehen.
Mit dem rasanten Wachstum des Internets wurde deshalb bereits Anfang der 1990er-Jahre deutlich, dass eine effizientere Verteilung allein das Problem nicht dauerhaft lösen würde. Die entscheidende Frage lautete zunehmend: Muss eigentlich jedes Gerät eine eigene öffentliche IPv4-Adresse besitzen, nur weil es mit dem Internet kommunizieren möchte? Eine der Antworten darauf war Network Address Translation – kurz NAT.
NAT verändert eine grundlegende Annahme von IP
Bis hierhin haben wir IP-Adressen als logische Adressen von Kommunikationsendpunkten betrachtet. Ein Host erzeugt ein IP-Paket mit einer Quell- und einer Zieladresse. Router transportieren dieses Paket anhand der Zieladresse durch unterschiedliche Netze. NAT greift in dieses Prinzip ein.
Ein NAT-System kann IP-Adressen eines Pakets verändern, wenn dieses die Grenze zwischen zwei Adressräumen überschreitet. Bei einer typischen ausgehenden IPv4-Kommunikation könnte beispielsweise aus 192.168.1.100 auf der externen Seite 203.0.113.45 werden. Das Paket verlässt das interne Netz damit nicht mehr mit der ursprünglichen Quelladresse. Der NAT-Router ersetzt sie durch eine Adresse, die im externen Netz verwendet werden kann.
Für den Rückweg muss das Gerät die Übersetzung entsprechend zuordnen können. NAT ist deshalb nicht einfach nur ein einmaliges Umschreiben einer Zahl, sondern benötigt Zustand über die angelegten Übersetzungen.
Inside Local und Inside Global
Gerade aus dem Cisco-Umfeld stammen einige Begriffe, die beim Verständnis klassischer NAT-Konfigurationen bis heute hilfreich sind. Im Kern beschreiben sie, unter welcher Adresse ein Kommunikationspartner auf der jeweiligen Seite des NAT-Systems erscheint.
Betrachten wir zunächst unseren internen Host mit der Adresse 192.168.1.100. Diese Adresse verwendet der Host innerhalb seines lokalen Netzes. In der klassischen NAT-Terminologie handelt es sich um die Inside Local Address.
Übersetzt der NAT-Router diese Adresse für die Kommunikation mit dem Internet beispielsweise in 203.0.113.45 wird daraus die Inside Global Address. Es handelt sich weiterhin um denselben internen Kommunikationspartner – lediglich seine Adresse unterscheidet sich abhängig davon, auf welcher Seite der NAT-Grenze wir ihn betrachten.
Entsprechend kennt die Terminologie auch zwei Perspektiven auf den externen Kommunikationspartner: Outside Local und Outside Global. Bei einem typischen Zugriff aus einem Unternehmens- oder Heimnetz auf einen öffentlich erreichbaren Server unterscheiden sich diese beiden Adressen allerdings nicht.
Greift unser Host 192.168.1.100 beispielsweise auf einen Server unter 198.51.100.20 zu, ergibt sich:
Inside Local: 192.168.1.100
Outside Local: 198.51.100.20
Nach der Übersetzung:
Inside Global: 203.0.113.45
Outside Global: 198.51.100.20
Der entscheidende Punkt ist gut zu erkennen: Nur die Adresse des internen Hosts verändert sich. Vor der NAT-Übersetzung sendet er an 198.51.100.20, und auch nach der Übersetzung bleibt 198.51.100.20 das Ziel des Pakets. Der interne Host und der NAT-Router verwenden für den externen Server also dieselbe öffentlich erreichbare IPv4-Adresse. Outside Local und Outside Global sind in diesem typischen Szenario deshalb identisch. Erst wenn das NAT-System zusätzlich die Adresse des externen Kommunikationspartners übersetzt, können auch hier zwei unterschiedliche Adressen auftreten. Das ist technisch möglich, beim gewöhnlichen Zugriff eines internen Clients auf das Internet jedoch nicht der Regelfall.
Die vier Begriffe wirken zunächst etwas sperrig. Inhaltlich steckt dahinter aber eine vergleichsweise einfache Frage: Wie sieht die Adresse eines Kommunikationspartners vor und nach der Übersetzung aus? NAT kann damit denselben Endpunkt abhängig von der betrachteten Seite unter unterschiedlichen IPv4-Adressen repräsentieren.
NAT benötigt nicht zwingend private Adressen
Eine häufige gedankliche Verkürzung lautet: Private IPv4-Adresse + öffentliche IPv4-Adresse = NAT. So begegnet uns NAT heute zwar besonders häufig, technisch ist NAT aber nicht auf RFC-1918-Adressen beschränkt. Der grundlegende Mechanismus übersetzt einen Adressraum in einen anderen. Auch zwischen zwei sich überschneidenden oder anderweitig getrennten Adressräumen kann eine Übersetzung notwendig sein.
Für die Geschichte der IPv4-Adressknappheit wurden private Adressen und NAT jedoch zu einem ausgesprochen wirkungsvollen Gespann: Interne Hosts benötigen keine weltweit eindeutigen IPv4-Adressen mehr, solange eine Übersetzung den Übergang zum öffentlichen Internet übernimmt. Damit kommen wir zum zweiten Baustein.
Private IPv4-Adressen – Eindeutigkeit nur dort, wo sie benötigt wird
RFC 1918 definierte 1996 drei IPv4-Adressbereiche für private Internets:
| Präfix | Adressen | Umfang |
| 10.0.0.0/8 | 16.777.216 | 1 × /8 |
| 172.16.0.0/12 | 1.048.576 | 16 × /16 |
| 192.168.0.0/16 | 65.536 | 256 × /24 |
Diese Adressen müssen innerhalb des jeweiligen privaten Netzes eindeutig, aber nicht weltweit einmalig sein. Ein Rechner in Dortmund kann deshalb 192.168.1.100 verwenden, während gleichzeitig ein Rechner in München, London oder Tokio dieselbe Adresse besitzt. Solange diese privaten Adressräume nicht unmittelbar miteinander verbunden werden, entsteht daraus zunächst kein Konflikt. Das ist ein fundamentaler Unterschied zu öffentlichen IPv4-Adressen: Globale Eindeutigkeit wird durch lokale Eindeutigkeit ersetzt.
Private Adressen sind dabei nicht für die Weiterleitung im öffentlichen Internet vorgesehen. Provider sollen entsprechende Routen nicht über die öffentlichen Interdomain-Routingstrukturen verbreiten. Für Unternehmens- und Heimnetze entstand damit ein gewaltiger wiederverwendbarer Adressraum.
RFC 1918 kam nicht aus dem Nichts
Auch hier lohnt sich der historische Blick. RFC 1918 war nicht der Beginn privater IPv4-Adressierung. Bereits RFC 1597 hatte 1994 Adressbereiche für private Netze beschrieben. RFC 1918 ersetzte diese Spezifikation 1996 und etablierte die heute vertrauten Bereiche.
Fast zeitgleich entstand ein weiterer wichtiger Baustein: RFC 1631 beschrieb 1994 den IP Network Address Translator. Private Adressierung und NAT entwickelten sich damit im selben historischen Problemraum: Das Internet wuchs schneller, als es der begrenzte IPv4-Adressraum langfristig zuließ.
Static NAT – eine Adresse gegen eine Adresse
Die einfachste Form der Übersetzung ist eine feste Zuordnung. Ein interner Host 192.168.1.100 wird beispielsweise dauerhaft auf 203.0.113.45 abgebildet. Damit besteht eine 1:1-Zuordnung: 192.168.1.100 ↔ 203.0.113.45. Das kann sinnvoll sein, wenn ein bestimmtes internes System unter einer festen externen Adresse repräsentiert werden soll.
Ein weiterer Vorteil liegt in der Entkopplung der internen Adressierung vom öffentlichen Adressraum. Das wird beispielsweise bei einem Providerwechsel interessant. Ein Unternehmen kann intern Adressen verwenden, die vollständig unabhängig davon sind, welche öffentlichen IPv4-Präfixe der aktuelle Internetprovider bereitstellt. Wechselt der Provider, kann der interne Server weiterhin unter 192.168.1.100 betrieben werden. Lediglich seine externe Repräsentation wird angepasst: 192.168.1.100 ↔ 203.0.113.45 beim bisherigen Provider kann beispielsweise zu 192.168.1.100 ↔ 198.51.100.80 beim neuen Provider werden.
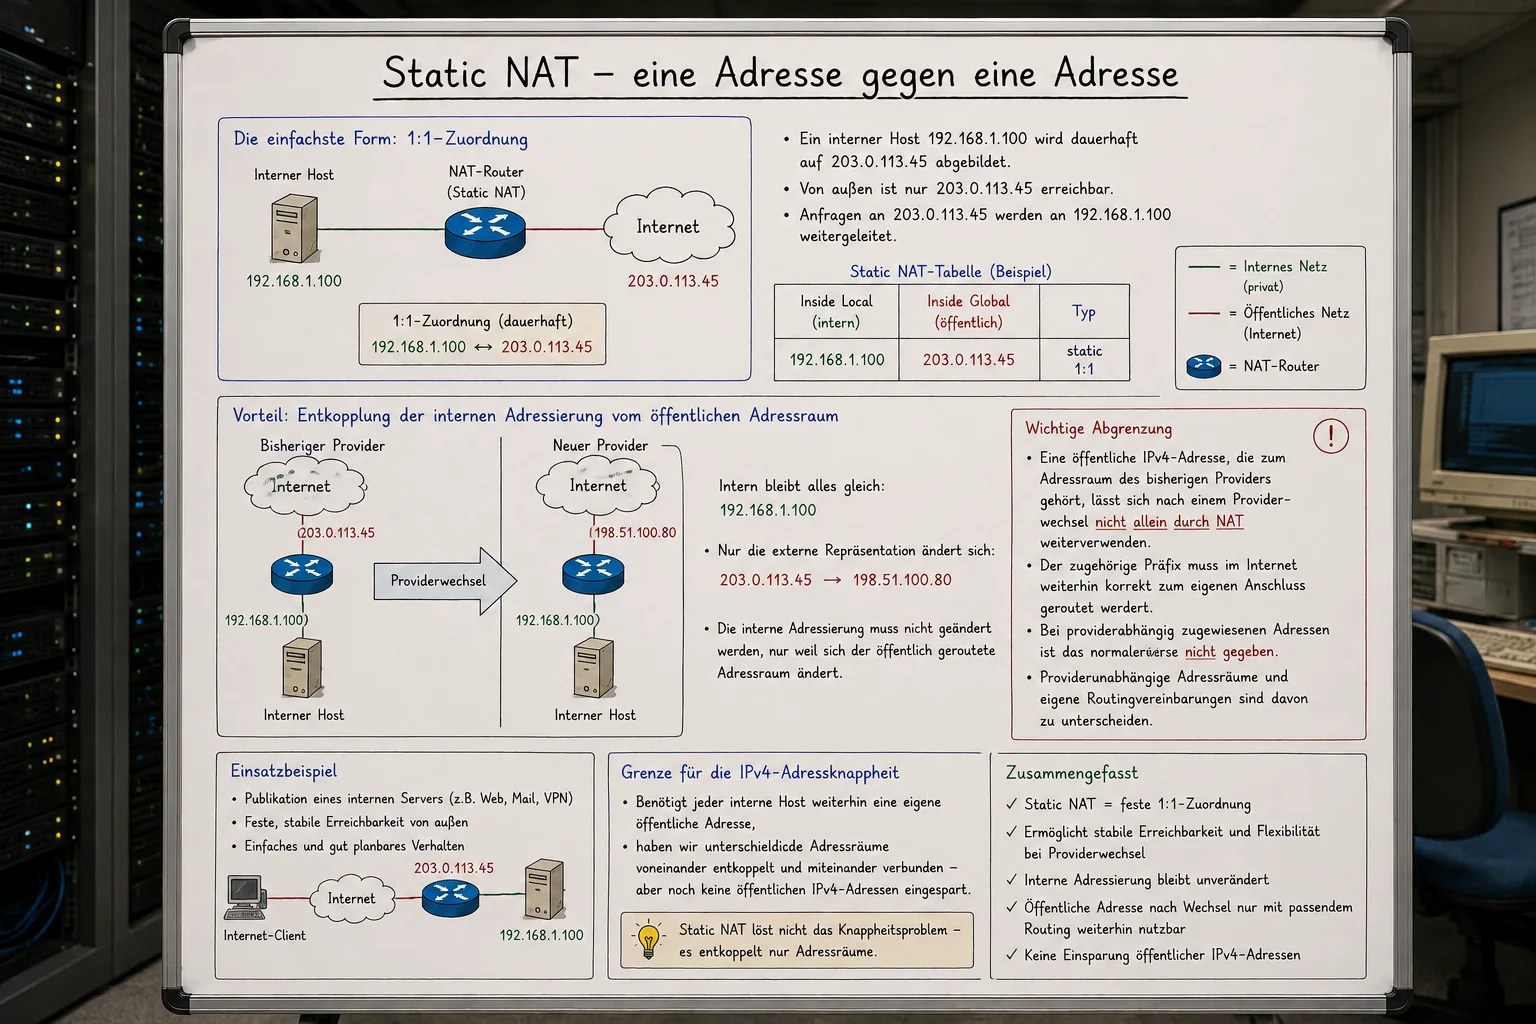
Die interne Adressierung muss deshalb nicht geändert werden, nur weil sich der öffentlich geroutete Adressraum ändert. Gerade bei historisch gewachsenen Netzen war und ist diese Entkopplung ein durchaus attraktiver Nebeneffekt von NAT. Wichtig ist allerdings die umgekehrte Abgrenzung: Eine öffentliche IPv4-Adresse, die zum Adressraum des bisherigen Providers gehört, lässt sich nach einem Providerwechsel nicht allein durch NAT weiterverwenden. Der zugehörige Präfix muss im Internet weiterhin korrekt zum eigenen Anschluss geroutet werden. Bei providerabhängig zugewiesenen Adressen ist das normalerweise nicht gegeben. Providerunabhängige Adressräume und eigene Routingvereinbarungen sind davon zu unterscheiden.
Für die eigentliche Lösung der IPv4-Adressknappheit bleibt der Effekt von Static NAT ohnehin begrenzt. Benötigt jeder interne Host weiterhin eine eigene öffentliche Adresse, haben wir zwar unterschiedliche Adressräume voneinander entkoppelt und miteinander verbunden – aber noch keine öffentlichen IPv4-Adressen eingespart.
Dynamic NAT – öffentliche Adressen aus einem Pool
Dynamic NAT löst die feste Bindung zwischen internem und externem Host. Angenommen, ein Unternehmen besitzt einen Pool öffentlicher Adressen: 203.0.113.40 – 203.0.113.49. Beginnt ein interner Host eine Kommunikation nach außen, kann ihm temporär eine freie Adresse aus diesem Pool zugeordnet werden. Ein anderer Host erhält eine weitere Adresse. Damit können mehr interne Systeme existieren, als öffentliche Adressen dauerhaft einzelnen Hosts zugeordnet sind – vorausgesetzt, nicht alle benötigen gleichzeitig eine Übersetzung.
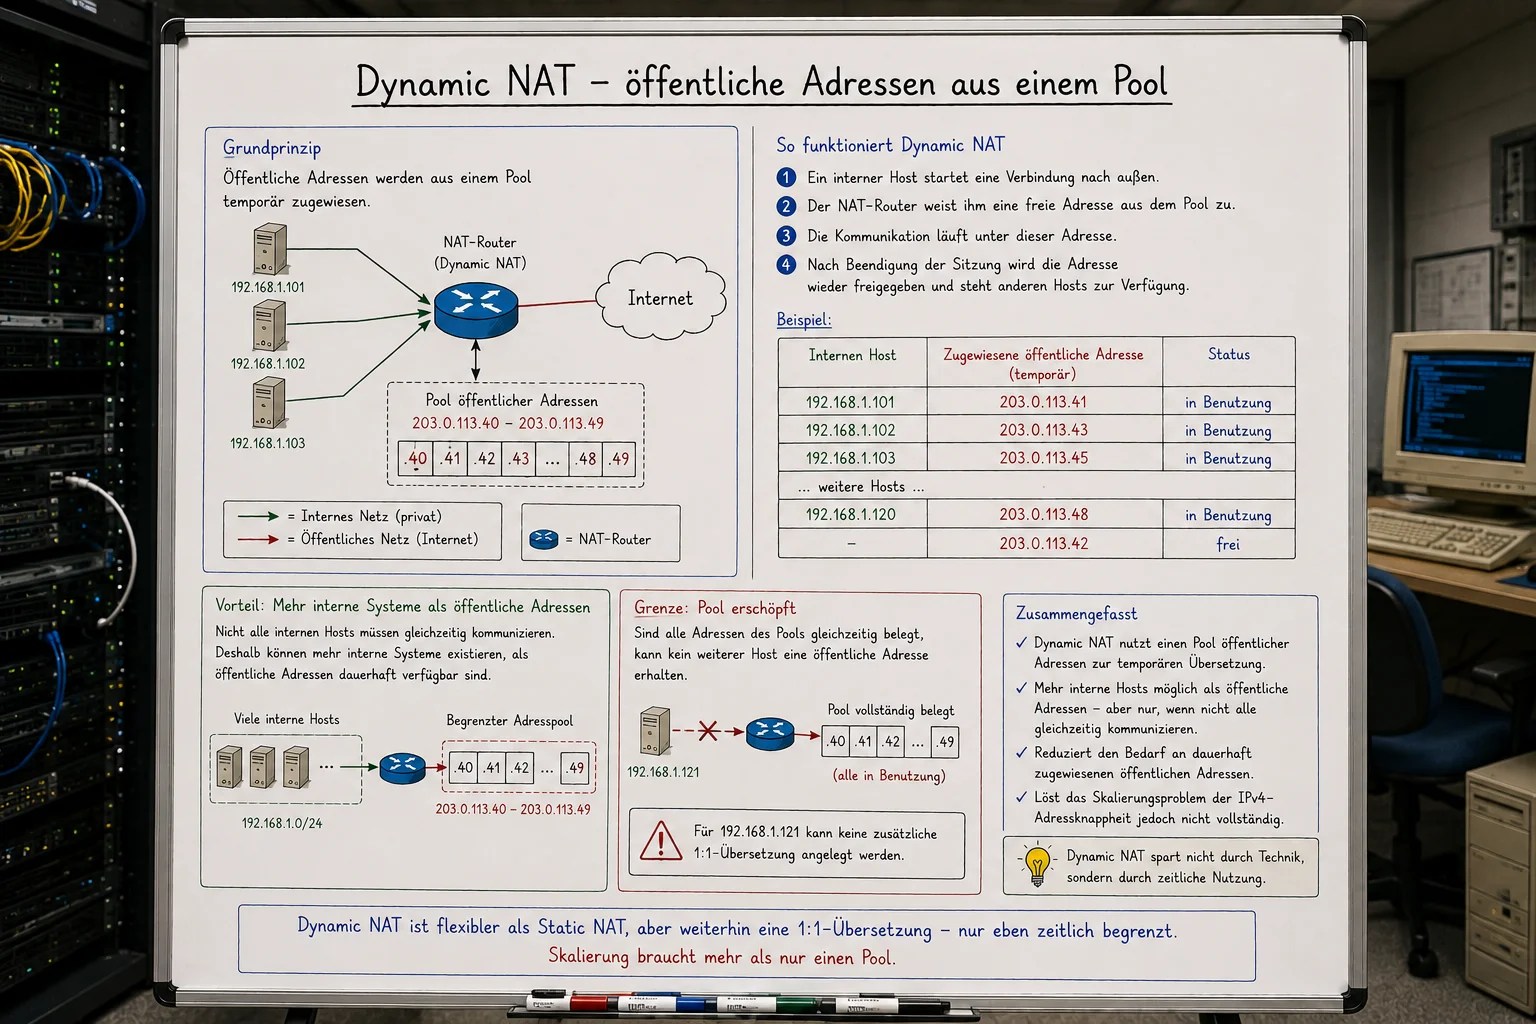
Genau hier liegt aber auch die Grenze dieses Modells. Sind sämtliche Adressen des Pools gleichzeitig belegt, kann für einen weiteren internen Host keine zusätzliche 1:1-Übersetzung angelegt werden. Dynamic NAT reduziert damit den Bedarf an dauerhaft zugewiesenen öffentlichen Adressen, löst das Skalierungsproblem aber noch nicht vollständig.
PAT – wenn eine öffentliche Adresse für viele Hosts genügt
Der entscheidende Schritt für die heute vertraute Internetnutzung besteht darin, nicht nur die IP-Adresse, sondern zusätzlich Informationen der Transportschicht in die Übersetzung einzubeziehen. Dafür begegnen uns unterschiedliche Bezeichnungen: Network Address and Port Translation (NAPT), Port Address Translation (PAT) oder im Cisco-Umfeld NAT Overload.
Nehmen wir zwei interne TCP-Verbindungen zum gleichen Webserver 198.51.100.20:
192.168.1.10:51000 → 198.51.100.20:443
192.168.1.20:57000 → 198.51.100.20:443
Bei einer klassischen 1:1-Adressübersetzung müsste für beide Hosts jeweils eine eigene öffentliche IPv4-Adresse zur Verfügung stehen. PAT löst diese Bindung auf: Beide Verbindungen können über dieselbe öffentliche IPv4-Adresse kommunizieren, weil der NAT-Router zusätzlich die Portinformationen in seine Übersetzungen einbezieht.
Beispielsweise könnten daraus werden:
192.168.1.10:51000 → 203.0.113.45:61001
192.168.1.20:57000 → 203.0.113.45:61002
Der NAT-Router kann die ursprünglichen Quellports dabei grundsätzlich beibehalten oder – wie in unserem Beispiel – durch andere Portnummern ersetzen. Entscheidend ist, dass die einzelnen Kommunikationsbeziehungen auf der öffentlichen Seite eindeutig voneinander unterschieden werden können. Von außen erscheinen beide TCP-Verbindungen deshalb mit derselben Quell-IP-Adresse 203.0.113.45. Sie lassen sich dennoch anhand ihrer Portinformationen auseinanderhalten.
Damit können viele interne Kommunikationsbeziehungen gleichzeitig eine einzige öffentliche IPv4-Adresse verwenden. Genau diese Many-to-One-Übersetzung erklärt, warum an einem typischen Internetanschluss zahlreiche interne Geräte gleichzeitig über nur eine öffentliche IPv4-Adresse mit dem Internet kommunizieren können.
PAT verbindet Layer 3 und Layer 4
Klassisches NAT verändert IPv4-Adressen und arbeitet damit unmittelbar mit Informationen der Vermittlungsschicht. Bei PAT beziehungsweise NAPT reicht die IP-Adresse allein jedoch nicht mehr aus. Das NAT-System bezieht zusätzlich die Portnummern von TCP oder UDP und damit Informationen der Transportschicht in die Übersetzung ein. Damit entsteht eine Verbindung zwischen Layer 3 und Layer 4: Die IPv4-Adresse beschreibt den beteiligten Host beziehungsweise dessen Repräsentation im jeweiligen Adressraum, während die Portnummer dabei hilft, unterschiedliche Kommunikationsbeziehungen auseinanderzuhalten.
In unserem vorherigen Beispiel wurden aus 192.168.1.10:51000 → 198.51.100.20:443 und 192.168.1.20:57000 → 198.51.100.20:443 zwei Verbindungen, die nach der Übersetzung dieselbe öffentliche Quelladresse 203.0.113.45 verwenden. Dass die zurückkehrenden Daten trotzdem wieder der richtigen internen Kommunikation zugeordnet werden können, liegt daran, dass das NAT-System nicht nur die übersetzte IP-Adresse betrachtet, sondern die zugehörigen Transportinformationen in seiner Zuordnung berücksichtigt.

PAT ist damit weit mehr als eine Variante, die lediglich noch einen Port umschreibt. Der Mechanismus zeigt sehr anschaulich, dass reale Netzwerkfunktionen die abstrakten Grenzen des OSI-Modells nicht immer so sauber einhalten, wie es eine Schichtengrafik zunächst vermuten lässt. Eine Funktion kann Informationen mehrerer Schichten auswerten, um ihre Aufgabe zu erfüllen. Die genaue Bedeutung von TCP- und UDP-Ports werden wir später noch ausführlich betrachten. Für den Moment genügt ein zentraler Gedanke: Erst die gemeinsame Betrachtung von IP-Adressen und Transportinformationen ermöglicht es PAT, zahlreiche parallele Kommunikationsbeziehungen über dieselbe öffentliche IPv4-Adresse eindeutig auseinanderzuhalten.
NAT muss sich Übersetzungen merken
Damit wird auch verständlich, warum ein NAT-Router Zustandsinformationen über seine Übersetzungen benötigt. Schließlich muss er nicht nur ausgehende Kommunikation übersetzen, sondern auch eintreffende Antworten wieder dem richtigen internen Endpunkt zuordnen können. Greifen wir dazu unser vorheriges Beispiel mit zwei internen Hosts auf, die denselben Webserver 198.51.100.20 über TCP-Port 443 erreichen:
| Interner Endpunkt | Extern dargestellt | Ziel |
| 192.168.1.10:51000 | 203.0.113.45:61001 | 198.51.100.20:443 |
| 192.168.1.20:57000 | 203.0.113.45:61002 | 198.51.100.20:443 |
Sendet der Webserver eine Antwort an 203.0.113.45:61002, kann das NAT-System anhand seiner bestehenden Zuordnung erkennen, dass diese Kommunikation zum internen Endpunkt 192.168.1.20:57000 gehört. Für die Weiterleitung in das interne Netz werden die entsprechenden Adress- und Portinformationen wieder zurückübersetzt. Die tatsächlichen Übersetzungstabellen eines NAT-Systems können dabei mehr Informationen enthalten als diese vereinfachte Darstellung. Neben interner und externer Adresse sowie den zugehörigen Ports kann beispielsweise auch das verwendete Transportprotokoll relevant sein. Schließlich bilden TCP-Port 61002 und UDP-Port 61002 nicht automatisch dieselbe Kommunikationsbeziehung.
Damit wird ein wichtiger Unterschied zum einfachen Static NAT sichtbar: Bei PAT wird nicht lediglich dauerhaft eine IPv4-Adresse durch eine andere ersetzt. Das NAT-System verwaltet dynamisch Zuordnungen für einzelne Kommunikationsbeziehungen und entfernt diese wieder, wenn sie nicht mehr benötigt werden beziehungsweise entsprechende Zeitlimits ablaufen. Nach außen ist dabei zunächst nur die öffentliche Repräsentation 203.0.113.45 mit den jeweiligen Portinformationen sichtbar. Welche private IPv4-Adresse der betreffende Host intern verwendet, lässt sich aus dem externen Paket allein nicht unmittelbar ablesen.
PAT funktioniert deshalb nicht nur durch das Umschreiben von Adressen und Ports, sondern durch das Zusammenspiel von Übersetzung und Zustandsverwaltung. Diese Zustandsverwaltung führt allerdings schnell zu einer weiteren verbreiteten Annahme: Wenn ein NAT-System eingehende Pakete nur anhand vorhandener Zuordnungen nach innen übersetzen kann, wirkt das zunächst ähnlich wie eine Sicherheitsfunktion. NAT ist deshalb aber noch keine Firewall.
NAT und Firewall sind nicht dasselbe
Die Zustandsverwaltung von PAT führt zu einer Beobachtung, die NAT seit Jahrzehnten den Ruf einer Sicherheitsfunktion eingebracht hat: Ein interner Host ist aus dem Internet normalerweise nicht ohne Weiteres erreichbar. Der Grund dafür liegt zunächst im Übersetzungsmechanismus selbst. Beginnt ein interner Host eine Kommunikation mit einem externen Ziel, erzeugt das NAT-System eine passende Zuordnung. Treffen anschließend Antwortpakete ein, können diese anhand der bestehenden Übersetzung wieder dem richtigen internen Endpunkt zugeordnet werden.
Anders sieht es bei einer unerwarteten Verbindung aus dem Internet aus. Erreicht beispielsweise ein Paket 203.0.113.45:62000 ohne eine dazu passende bestehende Übersetzung den NAT-Router, weiß dieser zunächst nicht, an welchen internen Host und Port er den Verkehr übersetzen soll. Ohne zusätzliche Konfiguration kann das Paket deshalb nicht einfach an irgendein System im privaten Netz weitergegeben werden.
Das hat durchaus einen praktischen Nebeneffekt: Interne Systeme sind hinter einer typischen PAT-Konfiguration nicht unmittelbar unter ihrer privaten IPv4-Adresse aus dem Internet adressierbar. Aus diesem Verhalten folgt jedoch nicht, dass NAT eine Firewall ist.
Adressübersetzung ist keine Sicherheitsrichtlinie
NAT und Firewalling erfüllen unterschiedliche Aufgaben. NAT verändert Adress- und gegebenenfalls Portinformationen, um Kommunikation zwischen unterschiedlichen Adressräumen zu ermöglichen. Eine Firewall setzt dagegen eine Sicherheitsrichtlinie durch: Sie entscheidet anhand definierter Kriterien, welcher Netzwerkverkehr zugelassen oder verworfen werden soll.
In typischen Heim- oder Unternehmensroutern treten beide Funktionen häufig gemeinsam auf. PAT verwaltet die Übersetzungen, während eine Stateful Firewall Kommunikationszustände verfolgt und anhand ihrer Regeln entscheidet, welcher Verkehr die Netzwerkgrenze passieren darf. Weil beide Mechanismen auf demselben Gerät arbeiten und unerwartete eingehende Kommunikation im Alltag häufig blockiert wird, verschmelzen ihre Wirkungen in der Wahrnehmung leicht miteinander.
Technisch bleiben es jedoch unterschiedliche Funktionen: NAT übersetzt – eine Firewall kontrolliert.
Die Trennung wird mit IPv6 besonders wichtig
Wie grundlegend diese Unterscheidung ist, zeigt sich, wenn wir beide Funktionen getrennt betrachten. Ein Netzwerk kann NAT einsetzen, ohne dass damit automatisch eine entsprechende Firewall-Funktion verbunden ist. Umgekehrt benötigt eine Firewall kein NAT, um Netzwerkverkehr zu kontrollieren.
Gerade mit IPv6 wird dieser Unterschied wichtig. Der weitgehende Verzicht auf die klassische Adressübersetzung bedeutet keineswegs, dass interne Systeme ohne Schutzmechanismen mit dem Internet verbunden werden müssen. Eine Firewall kann den zulässigen Verkehr unabhängig davon kontrollieren, ob Adressen unterwegs übersetzt werden.
NAT kann als Nebeneffekt die direkte Erreichbarkeit interner Systeme erschweren. Sicherheit entsteht daraus aber nicht automatisch. NAT ist Adressübersetzung – Firewalling ist die gezielte Kontrolle von Netzwerkverkehr anhand einer Sicherheitsrichtlinie.
Und wie erreicht das Internet einen internen Dienst?
Bei einer von innen initiierten Kommunikation kann PAT die benötigte Übersetzung dynamisch anlegen. Der interne Client startet die Verbindung, das NAT-System erzeugt eine passende Zuordnung und kann eintreffende Antworten anschließend wieder dem richtigen internen Endpunkt zuweisen. Schwieriger wird es, wenn die Kommunikation von außen beginnen soll. Angenommen, im internen Netz läuft auf 192.168.1.50 ein Webserver, der aus dem Internet erreichbar sein soll. Ein externer Client kennt dessen private Adresse nicht – und selbst wenn er sie kennen würde, wäre sie über das öffentliche Internet nicht erreichbar.
Das NAT-System benötigt deshalb eine vorher festgelegte Übersetzung. Beispielsweise: 203.0.113.45:443 → 192.168.1.50:443. Erreicht nun eine Verbindung die öffentliche IPv4-Adresse 203.0.113.45 auf TCP-Port 443, besitzt das NAT-System eine eindeutige Anweisung: Dieser Verkehr soll an den internen Endpunkt 192.168.1.50:443 übersetzt werden. Im Alltag begegnet uns dieses Verfahren meist als Port Forwarding beziehungsweise Portweiterleitung. Dabei müssen externer und interner Port keineswegs identisch sein. Eine Zuordnung könnte beispielsweise auch lauten: 203.0.113.45:8443 → 192.168.1.50:443.
Von außen wird der Dienst dann über Port 8443 angesprochen, während der interne Server weiterhin auf Port 443 arbeitet. NAT übersetzt in diesem Fall neben der Adresse auch die Portinformation. Damit zeigt sich eine grundlegende Konsequenz der Adressübersetzung: Ein interner Dienst ist hinter PAT nicht allein aufgrund seiner privaten IP-Adresse aus dem Internet erreichbar. Soll eine Kommunikation von außen initiiert werden, muss das NAT-System wissen, welchem internen Endpunkt der eingehende Verkehr zugeordnet werden soll.
Port Forwarding schafft diese Zuordnung statisch. Andere Verfahren können sie dynamisch herstellen oder Anwendungen dabei unterstützen, eine NAT-Grenze zu überwinden. Genau diese zusätzlichen Mechanismen werden relevant, sobald Anwendungen nicht mehr ausschließlich dem einfachen Muster Client innen startet Verbindung zu Server außen folgen.
NAT verändert das Ende-zu-Ende-Modell
Der Erfolg von NAT hat einen technischen Preis. In der ursprünglichen IP-Architektur bilden die Endsysteme die eigentlichen Kommunikationsendpunkte. Das Netz übernimmt die Weiterleitung der IP-Pakete zwischen ihnen, während die IP-Adressen die beteiligten Endpunkte über die Netzwerkgrenzen hinweg identifizieren.
NAT verändert dieses Modell. Zwischen die Kommunikationspartner tritt ein System, das die im Paket enthaltenen Adressinformationen – bei PAT zusätzlich die Portinformationen – während der Übertragung verändert und entsprechende Zuordnungen verwaltet. Damit sieht ein Kommunikationspartner auf der einen Seite der NAT-Grenze einen Endpunkt unter einer anderen Adresse als ein Kommunikationspartner auf der anderen Seite.
Solange die Kommunikation von innen beginnt
Für das klassische Nutzungsmuster funktioniert dieses Verfahren ausgesprochen gut: Ein Client im privaten Netz startet eine Verbindung zu einem öffentlich erreichbaren Server. Das NAT-System legt die benötigte Übersetzung an und kann die Antworten anschließend wieder dem richtigen internen Endpunkt zuordnen.
Komplizierter wird es, sobald Anwendungen von diesem einfachen Muster abweichen. Das betrifft beispielsweise Peer-to-Peer-Kommunikation, von außen initiierte Verbindungen oder Protokolle, die IP-Adressen und Portinformationen zusätzlich innerhalb ihrer Nutzdaten übertragen. In solchen Fällen genügt es unter Umständen nicht, lediglich die Angaben im IP- beziehungsweise Transport-Header zu übersetzen. Die Anwendung selbst kann Annahmen über Adressen oder Erreichbarkeit treffen, die hinter einer NAT-Grenze nicht mehr stimmen.
Anwendungen mussten lernen, NAT zu überwinden
Als NAT eine immer größere Verbreitung erfuhr, entstanden deshalb zusätzliche Verfahren, mit denen Anwendungen die vorhandene Übersetzungsgrenze erkennen oder überwinden können. Unter dem Oberbegriff NAT Traversal finden sich unterschiedliche Mechanismen, mit denen beispielsweise öffentliche Adress- und Portzuordnungen ermittelt, geeignete Kommunikationspfade aufgebaut oder Verbindungen über vermittelnde Systeme ermöglicht werden.
Auf einzelne Verfahren müssen wir an dieser Stelle noch nicht eingehen. Entscheidend ist zunächst die architektonische Konsequenz: NAT sparte öffentliche IPv4-Adressen – dafür musste ein Teil der Protokoll- und Anwendungswelt lernen, mit der Adressübersetzung umzugehen. Damit wurde aus einer vergleichsweise einfachen Idee zur Entlastung des IPv4-Adressraums ein Mechanismus, der zunehmend beeinflusste, wie Anwendungen miteinander kommunizieren können. Je selbstverständlicher NAT zum Bestandteil von IPv4-Netzen wurde, desto stärker musste seine Existenz auch bei der Entwicklung von Protokollen und Anwendungen berücksichtigt werden.
Wenn eine öffentliche Adresse pro Anschluss nicht mehr reicht
PAT hat den Bedarf an öffentlichen IPv4-Adressen drastisch reduziert. Statt für jedes Endgerät eine eigene öffentliche Adresse bereitzustellen, können zahlreiche Systeme eines Unternehmens oder Haushalts gemeinsam über eine einzige öffentliche IPv4-Adresse kommunizieren. Doch mit zunehmender IPv4-Knappheit geriet selbst dieses Modell unter Druck. Was geschieht, wenn ein Internetprovider nicht einmal mehr jedem Kundenanschluss eine eigene öffentliche IPv4-Adresse bereitstellen kann? Die naheliegende Antwort folgt einem inzwischen vertrauten Prinzip: Die Adressübersetzung wird um eine weitere Ebene ergänzt.
NAT wandert in das Netz des Providers
Bei Carrier-Grade NAT (CGNAT) beziehungsweise Carrier-Scale NAT findet eine zusätzliche Adressübersetzung innerhalb der Infrastruktur des Internetproviders statt. Mehrere Kundenanschlüsse können dadurch dieselbe öffentliche IPv4-Adresse beziehungsweise einen begrenzten Pool öffentlicher Adressen gemeinsam nutzen. Im heimischen Netz kann der eigene Router zunächst wie gewohnt die privaten IPv4-Adressen der Endgeräte übersetzen. Seine externe Schnittstelle erhält vom Provider jedoch nicht zwingend eine eigene öffentliche IPv4-Adresse. Stattdessen kann sie eine Adresse aus einem gemeinsam genutzten Provider-Adressraum erhalten.
Vereinfacht entsteht damit eine Kette aus zwei Übersetzungen: privates Heimnetz → Shared Address Space des Providers → öffentliches Internet. Aus einem Endgerät mit beispielsweise 192.168.1.100 könnte am Kundenrouter zunächst 100.64.10.25 und an der NAT-Grenze des Providers schließlich 203.0.113.45 werden. Die erste Übersetzung findet am eigenen Router statt, die zweite innerhalb des Providernetzes.
100.64.0.0/10 – ein Adressraum zwischen privat und öffentlich
Für solche Szenarien definiert RFC 6598 den Shared Address Space: 100.64.0.0/10. Er umfasst den Bereich von 100.64.0.0 bis 100.127.255.255 und damit 2²² beziehungsweise 4.194.304 IPv4-Adressen. Dieser Bereich gehört weder zu den privaten Adressbereichen aus RFC 1918 noch handelt es sich um gewöhnlichen global routbaren öffentlichen IPv4-Adressraum. Er wurde speziell dafür vorgesehen, Adressen zwischen Providerinfrastruktur und Kundenseite in entsprechenden Shared-Address-Szenarien verwenden zu können.
Die Unterscheidung ist praktisch wichtig: Eine Adresse aus 100.64.0.0/10 auf der WAN-Schnittstelle eines Routers ist deshalb ein deutlicher Hinweis darauf, dass sich zwischen dem eigenen Anschluss und dem öffentlichen Internet noch eine weitere Adressübersetzung befinden kann.
Die öffentliche IPv4-Adresse gehört nicht mehr einem Anschluss allein
Damit verändert sich gegenüber dem klassischen PAT-Szenario ein entscheidender Punkt. Eine öffentliche IPv4-Adresse repräsentiert nun nicht mehr nur zahlreiche Endgeräte eines privaten Netzes. Sie kann gleichzeitig Kommunikationsbeziehungen mehrerer Kundenanschlüsse repräsentieren. Das hat insbesondere für eingehende Verbindungen Konsequenzen. Eine Portweiterleitung am eigenen Router allein genügt nicht mehr, wenn bereits die öffentliche IPv4-Adresse erst an einer NAT-Grenze des Providers auf den eigenen Anschluss abgebildet wird. Die vorgelagerte Übersetzung befindet sich schließlich außerhalb der eigenen administrativen Kontrolle.
CGNAT treibt die ursprüngliche Idee von NAT damit konsequent weiter: Zunächst teilten sich mehrere Endgeräte eine öffentliche IPv4-Adresse. Mit CGNAT können sich schließlich sogar mehrere Kundenanschlüsse öffentliche IPv4-Adressen teilen.
Aus Übergangstechnik wird Infrastruktur
NAT entstand nicht als grundlegende Neugestaltung des Internetprotokolls. Bereits RFC 1631 stellte den Network Address Translator 1994 in den Kontext eines schnell wachsenden Internets, knapper werdender IPv4-Adressen und der Suche nach Lösungen, die sich vergleichsweise kurzfristig einsetzen ließen. Parallel dazu lief mit IPng bereits die Entwicklung eines langfristigen Nachfolgers für IPv4. Die Kombination aus privaten Adressräumen, NAT und später PAT erwies sich jedoch als ausgesprochen wirkungsvoll. Unternehmen konnten umfangreiche interne IPv4-Netze betreiben, ohne jedem Endgerät eine öffentliche Adresse zuweisen zu müssen. Heimanschlüsse ermöglichten zahlreichen Geräten den gemeinsamen Internetzugang über eine einzige öffentliche IPv4-Adresse. Mit CGNAT konnten Provider dieses Prinzip schließlich auf ganze Kundenanschlüsse ausweiten.
Aus einer Antwort auf die Adressknappheit wurde damit nach und nach ein selbstverständlicher Bestandteil der IPv4-Netzarchitektur. Und genau daraus entstand ein bemerkenswertes Paradox: Je erfolgreicher NAT die unmittelbaren Folgen der IPv4-Adressknappheit abmilderte, desto geringer wurde zugleich der praktische Druck, IPv4 kurzfristig vollständig zu ersetzen. Netze, Anwendungen und Betriebsprozesse richteten sich zunehmend auf eine Welt ein, in der Adressübersetzung schlicht zum Alltag gehörte. Neue Verfahren entstanden, um NAT-Grenzen zu erkennen oder zu überwinden, Router und Firewalls integrierten entsprechende Funktionen und ganze Netzwerkarchitekturen wurden auf private Adressräume mit Übersetzung zum Internet ausgerichtet.
Damit veränderte NAT nicht nur den Umgang mit knappen IPv4-Adressen. Sein eigener Erfolg trug dazu bei, die Lebensdauer von IPv4 erheblich zu verlängern. Aus einer pragmatischen Antwort auf ein Skalierungsproblem wurde Infrastruktur – und aus einer zunächst naheliegenden Übergangstechnik ein Mechanismus, auf den sich ein erheblicher Teil der IPv4-Welt dauerhaft eingestellt hat.
NAT löst die Knappheit nicht – es versteckt sie
Private Adressräume, NAT, PAT und schließlich CGNAT haben die Lebensdauer von IPv4 erheblich verlängert. Eines haben all diese Mechanismen jedoch nicht getan: Sie haben den IPv4-Adressraum nicht vergrößert. Eine IPv4-Adresse besteht weiterhin aus 32 Bit. Verändert hat sich vielmehr die Art, wie wir mit diesem begrenzten Adressraum umgehen.
Private IPv4-Adressen können in voneinander getrennten Netzen immer wieder verwendet werden. PAT ermöglicht zahlreichen Kommunikationsbeziehungen die gemeinsame Nutzung einer einzigen öffentlichen IPv4-Adresse. Mit CGNAT lässt sich dieses Prinzip sogar über die Grenzen einzelner Kundenanschlüsse hinaus fortsetzen. Wir haben also keine neuen IPv4-Adressen geschaffen. Wir sind lediglich immer besser darin geworden, globale Eindeutigkeit nur noch dort einzusetzen, wo sie tatsächlich benötigt wird.
Genau darin liegt der enorme Erfolg von NAT. Ein Internet, in dem jedes Endgerät zwingend eine eigene öffentliche IPv4-Adresse benötigt hätte, wäre sehr viel früher an die Grenzen des 32-Bit-Adressraums gestoßen. Stattdessen lernte die Netzwerkwelt, Adressen wiederzuverwenden, Kommunikationsbeziehungen zu übersetzen und die knappe Ressource der öffentlichen IPv4-Adresse mit immer mehr Systemen zu teilen.
Irgendwann reicht geschickteres Teilen nicht mehr
Der Preis dafür ist eine zunehmend komplexe Übersetzungsarchitektur zwischen den Kommunikationspartnern. Aus einer NAT-Grenze am Unternehmens- oder Heimrouter können mehrere Übersetzungsebenen werden. Anwendungen benötigen NAT-Traversal-Mechanismen, eingehende Kommunikation erfordert besondere Zuordnungen und die ursprüngliche Ende-zu-Ende-Adressierung wird zunehmend überlagert.
Damit stoßen wir auf eine Grenze, die sich mit noch ausgefeilterer Adressübersetzung nicht beseitigen lässt: IPv4 besitzt weiterhin nur 32 Bit. Die langfristige Antwort auf die Adressknappheit konnte deshalb nicht darin bestehen, immer neue Möglichkeiten zu entwickeln, denselben Adressraum noch häufiger wiederzuverwenden. Sie musste an der Ursache ansetzen und den verfügbaren Adressraum selbst grundlegend erweitern.
Genau diesen Weg beschritt die Entwicklung bereits parallel zu den Mechanismen, die IPv4 immer länger am Leben hielten. Mit IPv6 wächst die Adresse von 32 auf 128 Bit. Doch IPv6 ist weit mehr als lediglich IPv4 mit längeren Adressen. Mit dem neuen Protokoll verändern sich Adressierung, lokale Kommunikation und einige grundlegende Mechanismen der Vermittlungsschicht. Nachdem wir gesehen haben, wie weit die Netzwerkwelt gehen musste, um mit 32 Bit auszukommen, können wir nun betrachten, was sich verändert, wenn Adressknappheit nicht mehr die bestimmende Grenze des Protokolldesigns ist.
IPv6 – wenn 32 Bit nicht mehr reichen
Die Geschichte von IPv4 ist auch eine Geschichte zunehmender Effizienz. Adressklassen wurden durch flexiblere Präfixe abgelöst, CIDR verbesserte die Vergabe und Aggregation von Adressräumen, private Adressen ermöglichten ihre Wiederverwendung und NAT, PAT sowie schließlich CGNAT sorgten dafür, dass immer mehr Systeme mit immer weniger öffentlichen IPv4-Adressen auskommen konnten.
Doch all diese Verfahren änderten nichts an der grundlegenden Grenze: IPv4 besitzt weiterhin nur 32 Bit. Während die Netzwerkwelt immer besser darin wurde, mit diesem begrenzten Adressraum umzugehen, entstand deshalb bereits ein langfristiger Nachfolger. Unter dem Arbeitstitel IP Next Generation (IPng) entwickelte die IETF ein neues Internetprotokoll. Eine erste IPv6-Spezifikation erschien 1995 mit RFC 1883. RFC 2460 löste sie 1998 ab; seit 2017 bildet RFC 8200 die grundlegende Spezifikation von IPv6.
Die auffälligste Veränderung steckt bereits in der Adresse: IPv6 erweitert sie von 32 auf 128 Bit. Doch IPv6 ist nicht einfach IPv4 mit längeren Adressen. Die neue Protokollgeneration verändert zugleich einige Mechanismen, mit denen Hosts ihre Netzwerkumgebung kennenlernen und miteinander kommunizieren.
128 Bit verändern die Perspektive
Mit 32 Bit kann IPv4 theoretisch 2³² = 4.294.967.296 unterschiedliche Adressen darstellen. Bei IPv6 stehen dagegen 2¹²⁸ ≈ 3,4 × 10³⁸ mögliche Adressen zur Verfügung.
Ausgeschrieben entspricht das einer Größenordnung von rund 340 Sextillionen IPv6-Adressen. Die Zahl ist so groß, dass anschauliche Vergleiche schnell eher spektakulär als hilfreich werden. Für die Netzplanung ist eine andere Konsequenz wesentlich wichtiger: Adressknappheit muss nicht mehr die bestimmende Größe bei der Strukturierung eines Netzes sein.
Damit verändert sich auch die Perspektive auf Subnetting. Bei IPv4 haben wir zuvor intensiv darüber nachgedacht, wie viele Hostadressen ein /24, /26 oder /28 bereitstellt und wie effizient sich der vorhandene Raum aufteilen lässt. IPv6 schafft wesentlich großzügigere Voraussetzungen. Adressplanung bleibt wichtig – aber vor allem als Planung hierarchischer Präfixstrukturen, nicht als möglichst sparsames Verteilen einzelner Adressen. Die entscheidende Frage lautet damit weniger: Wie viele Adressen können wir einsparen? Vielmehr geht es darum, wie sich der verfügbare Adressraum sinnvoll, übersichtlich und aggregierbar strukturieren lässt.
Wer tiefer in IPv6-Adressierung, Präfixbildung und die unterschiedlichen Adressbereiche einsteigen möchte, findet dies ausführlicher im Beitrag Adresswelten im Wandel – der strukturierte Einstieg in TCP/IPv6.
Hexadezimal statt vier Dezimalzahlen
128 Bit in der von IPv4 bekannten dezimalen Schreibweise darzustellen, wäre ausgesprochen unhandlich. IPv6-Adressen werden deshalb hexadezimal geschrieben. Eine vollständig ausgeschriebene Adresse könnte beispielsweise lauten: 2001:0db8:85a3:0000:0000:8a2e:0370:7334. Sie besteht aus acht Gruppen mit jeweils vier hexadezimalen Stellen. Jede hexadezimale Stelle repräsentiert vier Bit. Eine Gruppe entspricht damit 16 Bit: 8 × 16 Bit = 128 Bit. Auch bei IPv6 bleibt die Adresse also letztlich eine Binärzahl. Die hexadezimale Darstellung macht sie lediglich handhabbarer.
Lange Adressen dürfen kürzer werden
Für die Schreibweise gelten zwei wichtige Vereinfachungen. Führende Nullen innerhalb einer Gruppe können weggelassen werden. Aus 0db8 wird beispielsweise db8, aus 0370 wird 370. Zusammenhängende Gruppen, die ausschließlich aus Nullen bestehen, können zusätzlich durch :: ersetzt werden. Diese Komprimierung darf innerhalb einer Adresse nur einmal verwendet werden, damit die vollständige Adresse weiterhin eindeutig rekonstruiert werden kann.
Aus 2001:0db8:85a3:0000:0000:8a2e:0370:7334 wird damit 2001:db8:85a3::8a2e:370:7334. Die Adresse ist kürzer geworden – ihr binärer Wert natürlich nicht.
Auch IPv6 denkt in Präfixen
Ein vertrautes Konzept aus IPv4 bleibt vollständig erhalten: die Präfixlänge. Eine IPv6-Adresse kann beispielsweise als 2001:db8:1234:5678::10/64 geschrieben werden. Das /64 bedeutet genau dasselbe wie bei IPv4: Die ersten 64 Bit bilden den Präfix. Die verbleibenden 64 Bit stehen innerhalb dieses Subnetzes für die weitere Adressbildung zur Verfügung. Damit gilt weiterhin ein Grundsatz, den wir bereits bei CIDR und Subnetting kennengelernt haben: Nicht die Adresse allein bestimmt die Netzgrenze. Der Präfix bestimmt, welche Bit zum Netz gehören.
Ein /64 stellt dabei 2⁶⁴ = 18.446.744.073.709.551.616 mögliche Interface-Identifier bereit. Aus IPv4-Perspektive erscheint diese Größenordnung zunächst geradezu absurd. Sie zeigt aber, warum sich IPv6-Adressplanung nicht einfach mit den aus IPv4 gewohnten Maßstäben beurteilen lässt. Ein /64 ist für gewöhnliche IPv6-Subnetze keine verschwenderische Ausnahme, sondern ein grundlegendes Designmuster, auf das verschiedene IPv6-Mechanismen abgestimmt sind.
Ein Interface, mehrere Adressen
Auch von einer zweiten IPv4-geprägten Vorstellung sollten wir uns lösen: ‘Welche IP-Adresse hat dieser Rechner?‘ Bei IPv6 kann diese Frage schnell zu kurz greifen. Ein Interface kann gleichzeitig mehrere IPv6-Adressen besitzen. Dazu können Adressen unterschiedlicher Gültigkeitsbereiche und Funktionen gehören.
Ein System kann beispielsweise über eine Link-Local-Adresse und gleichzeitig über eine oder mehrere Global-Unicast-Adressen verfügen. Zusätzlich können weitere Adressen für bestimmte Kommunikations- oder Datenschutzanforderungen hinzukommen. IPv6 bedeutet damit nicht einfach, dass jeder Host eine längere IP-Adresse bekommt. Das Adressmodell ist darauf ausgelegt, dass ein Interface mehrere Adressen gleichzeitig verwenden kann.
Unicast, Multicast und Anycast
IPv6 unterscheidet drei grundlegende Adresstypen:
|
Adresstyp |
Bedeutung |
|
Unicast |
adressiert ein einzelnes Interface |
|
Multicast |
adressiert eine Gruppe von Interfaces |
|
Anycast |
dieselbe Adresse wird mehreren Interfaces zugeordnet; das Routing führt das Paket zu einem davon |
Gerade bei Anycast ist die häufig verwendete Beschreibung des nächstgelegenen Empfängers mit Vorsicht zu verstehen. Gemeint ist nicht zwangsläufig die geografische Entfernung. Welcher Endpunkt erreicht wird, ergibt sich aus der jeweiligen Routingtopologie und Routingentscheidung. Einen aus IPv4 vertrauten Adresstyp sucht man dagegen vergeblich: IPv6 kennt keinen Broadcast. Aufgaben, für die IPv4 Broadcast verwendet, werden bei IPv6 gezielter über Multicast gelöst.
Kein Broadcast bedeutet nicht keine Gruppenkommunikation
Der Wegfall von Broadcast bedeutet natürlich nicht, dass IPv6 keine Möglichkeit besitzt, mehrere Systeme gleichzeitig anzusprechen. Ein wichtiges Beispiel ist die IPv6-Adresse ff02::1. Diese Adresse bezeichnet die All-Nodes-Multicast-Gruppe auf dem lokalen Link. IPv6-Nodes gehören auf ihren entsprechenden Interfaces zu dieser Gruppe.
Für IPv6-Router existiert unter anderem: ff02::2 als All-Routers-Multicast-Adresse mit Link-Local-Scope. IPv6 ersetzt den allgemeinen Broadcast damit durch gezieltere Multicast-Gruppen und unterschiedliche Gültigkeitsbereiche. Das wird gleich noch wichtig, wenn wir betrachten, wie ein IPv6-Host andere Systeme auf seinem lokalen Link findet.
Von Link-Local bis Global Unicast
Nicht jede IPv6-Adresse erfüllt dieselbe Aufgabe. Einige Präfixe begegnen im Netzwerkbetrieb besonders häufig:
|
Präfix |
Bedeutung |
|
::/128 |
Unspecified Address |
|
::1/128 |
Loopback |
|
fe80::/10 |
Link-Local Unicast |
|
fc00::/7 |
Unique Local Addresses |
|
2000::/3 |
derzeit für Global Unicast verwendeter Bereich |
|
ff00::/8 |
Multicast |
Besonders wichtig für unseren Layer-3-Blick sind Link-Local- und Global-Unicast-Adressen.
Link-Local – Kommunikation auf dem eigenen Link
IPv6-Interfaces verfügen über Link-Local-Adressierung aus dem Bereich fe80::/10. Diese Adressen besitzen nur auf dem jeweiligen Link Gültigkeit und werden nicht über Router hinweg weitergeleitet. Trotzdem sind sie keineswegs Adressen zweiter Klasse. Im Gegenteil: Sie spielen bei grundlegenden IPv6-Mechanismen eine zentrale Rolle.
Über Link-Local-Adressen können beispielsweise Hosts und Router auf demselben Link miteinander kommunizieren, ohne dafür eine global routbare Adresse zu benötigen. Damit besitzt IPv6 von Beginn an eine lokale Adressierungsebene, die unabhängig davon funktioniert, welcher globale Präfix einem Netz zugewiesen wurde.
Global Unicast – Kommunikation über Netzwerkgrenzen hinweg
Für global routbare Kommunikation kommen typischerweise Global-Unicast-Adressen zum Einsatz. Auch hier bleibt das bereits bekannte Prinzip erhalten: Adressen werden hierarchisch in Präfixe gegliedert. Ein Unternehmen kann beispielsweise einen größeren IPv6-Präfix erhalten und daraus zahlreiche Subnetze bilden. Nach außen lässt sich dieser Adressraum wiederum aggregiert bekannt geben.
Damit begegnet uns erneut eine Erkenntnis aus dem CIDR-Kapitel: Adressplanung und Routing lassen sich nicht voneinander trennen. IPv6 schafft zwar einen enormen Adressraum, hebt aber weder Präfixe noch Routinghierarchien auf. Im Gegenteil: Der große Adressraum bietet die Möglichkeit, beide von Beginn an großzügiger und strukturierter zu planen.
Unique Local ist nicht einfach ‚IPv6 privat‘
Mit fc00::/7 existiert außerdem der Bereich für Unique Local Addresses – ULA. Für lokal erzeugte ULA-Präfixe wird praktisch der Teilbereich fd00::/8 verwendet. Die Analogie zu den privaten IPv4-Adressen aus RFC 1918 liegt nahe, ist aber nur begrenzt hilfreich. ULA sind ebenfalls nicht für die globale Weiterleitung im Internet vorgesehen. Ihr Konzept zielt jedoch darauf, lokal erzeugte Präfixe mit sehr hoher Wahrscheinlichkeit global eindeutig zu machen. Dazu enthält ein lokal erzeugter ULA-Präfix eine pseudozufällig erzeugte Global ID.
Das wird beispielsweise interessant, wenn zuvor unabhängige Netze später miteinander verbunden werden. Zwei Unternehmen können problemlos beide die IPv4-Adressen 10.0.0.0/8 verwenden und beim Zusammenschluss erhebliche Überschneidungen feststellen. Bei korrekt erzeugten ULA-Präfixen soll die Wahrscheinlichkeit eines solchen Konflikts erheblich reduziert werden. ULA sind deshalb nicht einfach RFC-1918-Adressen mit 128 Bit.
Wie findet IPv6 einen Nachbarn?
Hier können wir unmittelbar an das IPv4-Kapitel anknüpfen. Dort musste ein Host zunächst entscheiden, ob sich die Zieladresse im eigenen Netz befindet. War das Ziel lokal erreichbar, benötigte er anschließend dessen Layer-2-Adresse. Bei IPv4 und Ethernet kam dafür ARP ins Spiel.
Das grundlegende Problem existiert bei IPv6 weiterhin: Wie gelangt ein IP-Paket auf dem lokalen Link tatsächlich zum richtigen Interface? ARP gehört allerdings nicht mehr zu IPv6. Stattdessen verwendet IPv6 Neighbor Discovery (ND).
Neighbor Discovery übernimmt mehr als ARP
Neighbor Discovery basiert auf ICMPv6 und übernimmt mehrere Aufgaben, die für den Betrieb eines IPv6-Netzes grundlegend sind. Dazu gehören unter anderem die Ermittlung von Link-Layer-Adressen benachbarter Systeme, die Suche nach Routern, das Erlernen von Präfixinformationen und die Überprüfung, ob Nachbarn weiterhin erreichbar sind.
Vier Nachrichtentypen begegnen dabei besonders häufig: Neighbor Solicitation (NS) und Neighbor Advertisement (NA) dienen unter anderem der Kommunikation zwischen benachbarten Systemen. Router Solicitation (RS) und Router Advertisement (RA) ermöglichen dagegen den Informationsaustausch zwischen Hosts und Routern. Neighbor Discovery ist deshalb nicht einfach ARP für IPv6. Die Auflösung einer IPv6-Adresse in eine passende Layer-2-Adresse ist nur eine seiner Aufgaben.
Neighbor Solicitation statt ARP-Broadcast
Auch der Wegfall des Broadcasts wird hier konkret sichtbar. Ein IPv4-Host kann einen ARP Request als Ethernet-Broadcast senden und damit zunächst alle Systeme des lokalen Broadcast-Domains erreichen. IPv6 verwendet stattdessen bei Neighbor Discovery gezielter Multicast.
Eine wichtige Rolle spielen die sogenannten Solicited-Node Multicast Addresses. Für eine IPv6-Unicast- oder Anycast-Adresse wird eine entsprechende Multicast-Adresse gebildet, sodass eine Neighbor Solicitation nicht pauschal an alle Nodes des Links adressiert werden muss. Damit bleibt das grundlegende Zusammenspiel unserer beiden Schichten erhalten: Layer 3 bestimmt, welches Ziel erreicht werden soll. Auf dem lokalen Link muss weiterhin geklärt werden, wie das Paket auf Layer 2 zum richtigen nächsten Interface gelangt. IPv6 löst diese Aufgabe lediglich mit anderen Mechanismen als IPv4.
Router Advertisements – wenn der Router sein Netz bekannt macht
Neighbor Discovery geht noch einen entscheidenden Schritt weiter. IPv6-Router können über Router Advertisements Informationen über das lokale Netz bekannt geben. Hosts können mit einer Router Solicitation aktiv nach solchen Informationen fragen. Über Router Advertisements erfahren Hosts unter anderem von vorhandenen Routern und erhalten Informationen über Präfixe auf dem jeweiligen Link. Präfixinformationen können außerdem kennzeichnen, ob sie für die autonome Adresskonfiguration verwendet werden dürfen.
Damit unterscheidet sich die IPv6-Konfiguration deutlich von der häufig aus IPv4 gewohnten Vorstellung: IP-Adresse + Netzmaske + Default Gateway + DNS = DHCP. Bei IPv6 übernimmt das Router Advertisement selbst grundlegende Aufgaben beim Erlernen der Netzwerkumgebung. Insbesondere der Default Router wird über Neighbor Discovery beziehungsweise Router Advertisements gelernt – nicht über DHCPv6.
SLAAC – IPv6 konfiguriert sich selbst
Eine IPv6-Adresse muss nicht zwingend durch Administrator:innen konfiguriert oder von einem DHCP-Server zugewiesen werden. Mit der Stateless Address Autoconfiguration – SLAAC kann ein Host selbstständig eine passende IPv6-Adresse bilden. Die dafür benötigten Netzwerkinformationen erhält er über die bereits beschriebenen Router Advertisements. Gibt ein Router darin einen geeigneten Präfix für die autonome Adresskonfiguration bekannt, kann der Host diesen übernehmen und daraus eine eigene IPv6-Adresse erzeugen. Für die eigentliche Adressvergabe ist damit kein zentraler DHCP-Server erforderlich.
Vereinfacht lässt sich der Ablauf so darstellen: Router Advertisement → Präfix lernen → Adresse bilden → Adresse prüfen. Zu dieser Prüfung gehört die Duplicate Address Detection (DAD). Bevor eine neu gebildete Adresse regulär verwendet wird, prüft der Host, ob dieselbe IPv6-Adresse auf dem lokalen Link bereits von einem anderen System verwendet wird. Autokonfiguration ist damit keine nachträgliche Komfortfunktion, sondern ein grundlegender Bestandteil des IPv6-Modells.
Und DHCPv6?
SLAAC bedeutet nicht, dass DHCP mit IPv6 verschwunden wäre. DHCPv6 ermöglicht weiterhin eine zentral gesteuerte Bereitstellung von Adressen und weiteren Konfigurationsinformationen. Abhängig vom jeweiligen Netzdesign können SLAAC und DHCPv6 unterschiedliche beziehungsweise ergänzende Rollen übernehmen.
Ein entscheidender Unterschied zu DHCPv4 bleibt jedoch: DHCPv6 liefert dem Host nicht seinen Default Router. Diese Information stammt weiterhin aus den Router Advertisements. Damit bleiben RA und Neighbor Discovery selbst in Netzen relevant, die DHCPv6 einsetzen.
Die verschiedenen Möglichkeiten der IPv6-Adresskonfiguration und ihre praktischen Konsequenzen behandeln wir ausführlicher im Beitrag Adresswelten im Wandel – der strukturierte Einstieg in TCP/IPv6.
Was wird aus NAT?
Nach unserem ausführlichen Blick auf IPv4-NAT drängt sich eine Frage geradezu auf: Wo befindet sich NAT in diesem Modell? Die entscheidende Antwort lautet zunächst: IPv6 benötigt NAT nicht als Adresssparmechanismus. Der 128 Bit große Adressraum erlaubt es, Endsystemen global routbare Adressen bereitzustellen, ohne zahlreiche interne Hosts allein aus Gründen der Adressknappheit hinter einer einzigen öffentlichen Adresse zusammenfassen zu müssen.
Damit entfällt der wesentliche Treiber, der NAT, PAT und schließlich CGNAT unter IPv4 zu ihrer enormen Bedeutung verholfen hat. IPv6 schafft damit wieder Voraussetzungen für eine transparentere Ende-zu-Ende-Adressierung: Die Adresse eines Kommunikationspartners muss nicht zwangsläufig an einer NAT-Grenze verändert werden, nur weil öffentliche Adressen knapp sind.
Kein NAT bedeutet nicht keine Firewall
Damit begegnet uns unmittelbar ein Gedanke aus dem vorherigen Kapitel. Eine global routbare IPv6-Adresse bedeutet nicht, dass ein System automatisch uneingeschränkt aus dem Internet erreichbar sein muss. NAT und Firewalling waren bereits bei IPv4 unterschiedliche Funktionen. IPv6 macht diese Trennung lediglich offensichtlicher. Eine Stateful Firewall kann eingehenden und ausgehenden Verkehr anhand einer Sicherheitsrichtlinie kontrollieren, ohne dafür Adressen übersetzen zu müssen.
Globale Adressierbarkeit und erlaubte Erreichbarkeit sind zwei unterschiedliche Dinge. IPv6 benötigt deshalb kein NAT, um interne Systeme durch eine Firewall zu schützen. Sicherheit entsteht durch geeignete Sicherheitsmechanismen und Richtlinien – nicht durch die bloße Abwesenheit global eindeutiger Adressen.
Übersetzung gibt es trotzdem
Ganz verschwunden ist das Thema Adressübersetzung mit IPv6 allerdings nicht. Mit NPTv6 – IPv6-to-IPv6 Network Prefix Translation beschreibt RFC 6296 beispielsweise ein experimentelles Verfahren, bei dem IPv6-Präfixe gegeneinander übersetzt werden. Anders als beim von IPv4 bekannten PAT geht es dabei nicht darum, zahlreiche interne Kommunikationsbeziehungen hinter einer einzelnen öffentlichen Adresse zusammenzufassen. Transportports werden dafür nicht als Adresssparmechanismus umgesetzt.
Solche Ansätze können beispielsweise bei bestimmten Multihoming- oder Providerabhängigkeits-Szenarien interessant werden. Für unseren Zusammenhang ist jedoch vor allem die Abgrenzung wichtig: IPv6 kann Übersetzungsmechanismen kennen – es benötigt sie aber nicht, um einen zu kleinen Adressraum künstlich zu strecken. Damit unterscheidet sich ihre Rolle grundlegend von NAT und PAT in der IPv4-Welt.
Auch der IPv6-Header wurde neu gestaltet
IPv6 verändert nicht nur die Länge der Adressen. Auch der IP-Header wurde gegenüber IPv4 überarbeitet. Der grundlegende IPv6-Header besitzt eine feste Länge von 40 Byte. Zusätzliche Funktionen können über sogenannte Extension Header zwischen dem IPv6-Header und dem Protokoll der nächsthöheren Schicht eingefügt werden.
Ein weiterer wichtiger Unterschied betrifft die Fragmentierung. Bei IPv4 kann – sofern dies nicht unterbunden wird – auch ein Router ein zu großes Paket auf dem Übertragungsweg fragmentieren. IPv6-Router führen dagegen keine Fragmentierung durch. Ist ein Paket für den weiteren Pfad zu groß, muss dies dem sendenden System signalisiert werden. Eine gegebenenfalls notwendige Fragmentierung erfolgt durch den sendenden Node. Damit gewinnt auch Path MTU Discovery an Bedeutung. Auf ICMPv6 und die damit verbundenen Mechanismen kommen wir später noch zurück.
IPv4 und IPv6 leben nebeneinander
IPv6 war als langfristiger Nachfolger von IPv4 konzipiert. Das bedeutete jedoch nie, dass sich das bestehende Internet zu einem bestimmten Zeitpunkt vollständig umschalten ließ. Dafür war und ist die installierte IPv4-Basis schlicht zu groß.
Deshalb existieren beide Protokollwelten seit vielen Jahren parallel. In einer Dual-Stack-Umgebung unterstützen Hosts und Netze IPv4 und IPv6 gleichzeitig. Je nach Ziel, Namensauflösung und vorhandener Konnektivität kann Kommunikation über das jeweilige Protokoll erfolgen. Daneben existieren weitere Übergangs- und Übersetzungsmechanismen für Szenarien, in denen IPv4 und IPv6 nicht durchgängig parallel zur Verfügung stehen.
Dass IPv6 technisch längst funktioniert, bedeutet deshalb nicht automatisch, dass gewachsene IPv4-Infrastrukturen kurzfristig verschwinden. Warum Unternehmen trotz jahrzehntelanger IPv6-Entwicklung weiterhin an IPv4 festhalten und welche Rolle NAT dabei spielt, betrachten wir ausführlicher in IPv6 ist längst da – warum Unternehmen trotzdem an IPv4 festhalten.
Die Prinzipien bleiben – die Mechanismen verändern sich
Damit können wir IPv4 und IPv6 aus der Perspektive dieses Beitrags wieder zusammenführen. Bei beiden Protokollen benötigt ein Host eine logische Adresse und einen Präfix. Bei beiden muss er erkennen, ob ein Ziel direkt erreichbar ist oder über einen Router erreicht werden muss. Und bei beiden benötigt die Kommunikation auf einem lokalen Ethernet-Link schließlich eine passende Layer-2-Zustellung.
Die Mechanismen unterscheiden sich jedoch: Bei IPv4 begegneten uns ARP, Broadcast, knapper öffentlicher Adressraum und NAT. IPv6 arbeitet stattdessen unter anderem mit Neighbor Discovery, Multicast, Router Advertisements, Autokonfiguration und einem 128 Bit großen Adressraum. Das grundlegende Ziel von Layer 3 bleibt dasselbe: Pakete müssen über die Grenzen einzelner lokaler Netze hinweg adressierbar und weiterleitbar bleiben. IPv6 erfindet dieses Prinzip nicht neu. Es überträgt es auf eine Architektur, die nicht mehr unter denselben Voraussetzungen entwickelt wurde wie IPv4 Anfang der 1980er-Jahre.
Welche Rolle IPv6 darüber hinaus in stärker automatisierten, softwaredefinierten und zunehmend intelligent gesteuerten Netzwerkarchitekturen spielen kann, betrachten wir im Beitrag Wenn die Computerkommunikation intelligent wird – Zukunftsarchitekturen, IPv6 und KI im modernen Netzwerkdesign.
IPv6 ist Evolution und Einschnitt zugleich
IPv6 ist deshalb weder lediglich IPv4 mit längeren Adressen noch ein vollständiger Bruch mit allem, was davor existierte. Präfixe, Routing und die Unterscheidung zwischen lokaler und entfernter Kommunikation bleiben grundlegende Prinzipien. Gleichzeitig verändern sich zentrale Mechanismen: ARP verschwindet, Broadcast wird durch Multicast ersetzt, Neighbor Discovery übernimmt zusätzliche Aufgaben, Router Advertisements werden zu einem wichtigen Bestandteil der Hostkonfiguration und NAT verliert seine Rolle als notwendiger Adresssparmechanismus.
Vor allem aber beseitigt IPv6 jene Grenze, um die sich ein erheblicher Teil unserer bisherigen Geschichte gedreht hat: Statt immer ausgefeiltere Verfahren zu entwickeln, um 32 Bit effizienter aufzuteilen, wiederzuverwenden und zu übersetzen, stellt IPv6 einen Adressraum bereit, bei dem Knappheit nicht mehr das bestimmende Designproblem sein muss. Damit wäre die Entwicklung eigentlich konsequent erzählt: IPv4 wurde zu klein, IPv6 wurde sein Nachfolger. Nur eine Zahl scheint dabei zu fehlen. Was ist eigentlich mit IPv5 passiert? Genau diese Frage führt uns in den nächsten Exkurs – und zu einem Protokoll, das tatsächlich existierte, aber nie als Nachfolger von IPv4 gedacht war.

Exkurs: IPv5 – die übersprungene Versionsnummer
IPv5 gab es – aber anders als erwartet
Wer die Entwicklung von IPv4 zu IPv6 betrachtet, stößt beinahe zwangsläufig auf eine kleine Ungereimtheit: Was ist eigentlich mit IPv5 passiert? Die naheliegende Vermutung wäre, dass zwischen beiden Protokollen eine fünfte IP-Generation entwickelt wurde, die sich nicht durchsetzen konnte. Tatsächlich existierte die Versionsnummer 5 – allerdings nicht als vorgesehener Nachfolger von IPv4. Sie wurde für ein anderes experimentelles Protokoll verwendet: das Internet Stream Protocol, kurz ST, und dessen Weiterentwicklung ST2.
Streaming, bevor das Web existierte
Die Geschichte von ST reicht bis in die späten 1970er-Jahre zurück. Die ursprüngliche Spezifikation wurde 1979 als IEN 119 veröffentlicht. Später entstand daraus ST2, das 1990 in RFC 1190 beschrieben und 1995 mit ST2+ beziehungsweise RFC 1819 noch einmal überarbeitet wurde. Das zu lösende Problem wirkt aus heutiger Sicht ausgesprochen modern: Wie lassen sich zeitkritische Datenströme zuverlässig durch ein paketvermitteltes Netz transportieren?
Das klassische IP bot keine Garantie für eine bestimmte Datenrate oder Verzögerung. Für Dateiübertragungen oder andere klassische Datenkommunikation war dieses Best-Effort-Prinzip akzeptabel. Bei Echtzeitanwendungen wie Sprache und Video können Verzögerungen und stark schwankende Übertragungsbedingungen dagegen unmittelbar wahrnehmbar werden. ST beziehungsweise ST2 verfolgte deshalb einen anderen Ansatz.
Ein verbindungsorientierter Gegenentwurf zu IP
Während IP einzelne Datagramme grundsätzlich unabhängig voneinander vermittelt, arbeitete ST2 verbindungsorientiert und zustandsbehaftet. Vor der eigentlichen Datenübertragung wurde ein Stream aufgebaut. Dabei konnten Pfade ausgewählt und Ressourcen entlang dieses Pfades reserviert werden. ST2 sollte dadurch kontrollierbare Verzögerungen und garantierte Datenraten für Echtzeitanwendungen ermöglichen. Auch Punkt-zu-Mehrpunkt-Kommunikation war Teil des Konzepts.
Vereinfacht standen sich damit zwei unterschiedliche Vorstellungen gegenüber:
- IP: Pakete werden weitgehend unabhängig voneinander nach dem Best-Effort-Prinzip weitergeleitet
- ST2: Für einen Datenstrom wird zunächst Zustand im Netz aufgebaut; Pfad und Ressourcen können für diesen Stream reserviert werden
ST2 war damit kein besseres IPv4, sondern ein spezialisiertes Internetworking-Protokoll für Anwendungen mit Anforderungen an Dienstgüte und Echtzeitübertragung. RFC 1819 formuliert diese Einordnung entsprechend deutlich: ST2 arbeitete auf derselben Ebene wie das verbindungslose IP und sollte es ergänzen, nicht ersetzen.
Warum daraus trotzdem ‚IPv5‘ wurde
Die Verbindung zu unserer Versionsnummer steckt im Paketheader. Sowohl IPv4 als auch IPv6 beginnen mit einem vier Bit großen Versionsfeld. Bei IPv4 enthält dieses Feld den Wert 0100 = 4. Für ST wurde dagegen der Wert 0101 = 5 verwendet. RFC 1190 beschreibt ausdrücklich, dass anhand dieser ersten vier Bit zwischen IP-Paketen mit Version 4 und ST-Paketen mit Version 5 unterschieden werden konnte. Auch ST2+ behielt diese Zuordnung bei. Die IANA führt den Wert 5 bis heute entsprechend als Reserved (Historic). Und genau hier liegt der Ursprung dessen, was rückblickend häufig als IPv5 bezeichnet wird.
ST2 war tatsächlich mehr als eine Idee auf Papier
Dabei wäre es falsch, ST beziehungsweise ST2 als nie realisiertes Gedankenexperiment abzutun. Die ursprüngliche Stream-Transport-Technologie wurde bereits in kleinem Umfang im ARPANET implementiert. In den 1980er-Jahren gab es experimentelle Anwendungen für Sprache, Video und verteilte Simulationen. Später beschäftigte sich die Entwicklung von ST2 und ST2+ weiterhin mit Ressourcenreservierung und garantierter Dienstgüte.
Noch 1996 diskutierte RFC 1946 beispielsweise die Nutzung von ST2+ im Zusammenhang mit ATM und bezeichnete ST2 sowie ST2+ ausdrücklich als Protokolle mit der Internet Protocol Version 5. Die Nummer 5 war also keineswegs nur theoretisch reserviert. Sie war mit einer realen experimentellen Protokollfamilie verbunden.
Warum ST2 trotzdem nicht zum Internetprotokoll der Zukunft wurde
ST2 löste ein reales Problem, verfolgte dabei aber einen deutlich anderen Architekturansatz als das klassische Internet Protocol. Ressourcen mussten reserviert, Streams aufgebaut und entsprechender Zustand in beteiligten Systemen gehalten werden. Das ermöglichte Eigenschaften, die IP selbst nicht bot, stellte aber zugleich andere Anforderungen an die beteiligte Infrastruktur.
Parallel entwickelte sich die IP-basierte Netzwerkwelt weiter. Andere Ansätze zur Ressourcenreservierung und Dienstgüte entstanden, während Echtzeitanwendungen zunehmend auf der bestehenden IP-Infrastruktur realisiert wurden. Bereits RFC 1819 weist darauf hin, dass alternative Verfahren für das Problem der Ressourcenreservierung innerhalb der IETF entwickelt wurden. ST2 und ST2+ blieben ausdrücklich experimentelle Protokolle und waren nicht auf dem Weg zum Internet Standard.
Das macht ST2 rückblickend nicht bedeutungslos. Im Gegenteil: Die Arbeiten zeigen, dass Fragen nach Echtzeitkommunikation, Ressourcenreservierung, Multicast und Quality of Service die Entwicklung paketvermittelter Netze schon beschäftigten, lange bevor Videokonferenzen und Streaming alltäglicher Netzwerkverkehr wurden.
Und warum folgt auf IPv4 dann IPv6?
Als in den 1990er-Jahren tatsächlich ein langfristiger Nachfolger für IPv4 benötigt wurde, war die Versionsnummer 5 bereits durch ST belegt. Der neue Entwurf erhielt deshalb die nächste geeignete Versionsnummer: 6. RFC 1883 spezifizierte 1995 ausdrücklich Internet Protocol Version 6 als Nachfolger von IPv4. Die Spezifikation bezeichnete IPv6 zugleich als IP Next Generation (IPng).
Damit wird auch deutlich, warum die verbreitete Vorstellung eines gescheiterten IPv5 als Zwischenstufe irreführend ist: Zwischen IPv4 und IPv6 wurde keine Generation übersprungen. Die Versionsnummer 5 war bereits für ein anderes experimentelles Internetworking-Protokoll verwendet worden. IPv6 war der eigentliche Nachfolger von IPv4 – ST2 verfolgte ein anderes Ziel.
Ein Protokoll zwischen den Generationen
Die Geschichte von IPv5 ist deshalb mehr als eine Kuriosität der Versionsnummerierung. Sie zeigt, dass die Entwicklung des Internets nie vollkommen linear verlief. Neben dem verbindungslosen Best-Effort-Modell von IP wurden früh alternative Ansätze erprobt. ST und ST2 versuchten, für zeitkritische Datenströme Pfade aufzubauen, Ressourcen zu reservieren und bestimmte Übertragungseigenschaften berechenbarer zu machen.
Durchgesetzt hat sich ST2 als allgemeine Internetarchitektur nicht. Die dahinterstehende Fragestellung ist dagegen bis heute aktuell: Wie transportiert ein paketvermitteltes Netz zeitkritische Daten zuverlässig, wenn Anwendungen Anforderungen an Bandbreite, Verzögerung und Dienstgüte stellen? Die Zahl 5 verschwand damit aus der sichtbaren Entwicklung des Internet Protocol. Die Probleme, mit denen sich ST2 beschäftigte, taten es nicht.
TCP und UDP – wenn aus IP-Paketen Anwendungsverkehr wird
Bis hierhin haben wir uns vor allem mit einer Frage beschäftigt: Wie gelangt ein IP-Paket von einem Host zu einem anderen? IP-Adressen identifizieren Interfaces und Netze, Präfixe unterscheiden lokale von entfernten Zielen und Router vermitteln Pakete über Netzwerkgrenzen hinweg. Am Ziel angekommen, ist die Aufgabe jedoch noch nicht beendet. Ein moderner Rechner kommuniziert schließlich nicht nur mit einem einzigen Dienst. Ein Browser lädt eine Webseite, ein E-Mail-Client synchronisiert Nachrichten, ein DNS-Client fragt nach einem Namen und im Hintergrund greifen weitere Anwendungen gleichzeitig auf Netzwerkressourcen zu.
Die IP-Adresse beantwortet dabei zunächst nur die Frage: Welches System beziehungsweise Interface soll das Paket erreichen? Nun kommt eine weitere hinzu: Für welche Anwendung beziehungsweise Kommunikationsbeziehung auf diesem System sind die Daten bestimmt? Hier beginnt die Aufgabe der Transportschicht – Layer 4.
Die Transportschicht verbindet Anwendungen
Die Transportschicht stellt die Kommunikation zwischen Prozessen beziehungsweise Anwendungen auf unterschiedlichen Endsystemen her. Während IP für die Vermittlung zwischen den beteiligten Hosts sorgt, schafft Layer 4 die Voraussetzungen dafür, dass mehrere Kommunikationsbeziehungen gleichzeitig über dieselbe IP-Infrastruktur abgewickelt werden können. Im TCP/IP-Umfeld begegnen uns dafür vor allem zwei Protokolle: Transmission Control Protocol (TCP) und User Datagram Protocol (UDP). Beide transportieren Daten zwischen Anwendungen. Sie verfolgen dabei jedoch grundlegend unterschiedliche Konzepte.
TCP stellt einer Anwendung einen zuverlässigen, geordneten Bytestrom zur Verfügung. Dafür baut es Verbindungen auf, nummeriert übertragene Daten, bestätigt deren Empfang und reagiert auf Verluste. UDP ist wesentlich schlanker. Es versendet einzelne Datagramme, ohne zuvor eine Verbindung aufzubauen und ohne selbst deren zuverlässige oder geordnete Zustellung sicherzustellen.
Damit treffen wir bereits auf eine wichtige Erkenntnis: Layer 4 bedeutet nicht automatisch Zuverlässigkeit. Das verwendete Transportprotokoll bestimmt, welche Dienste die Transportschicht einer Anwendung bereitstellt.
Ports – wenn eine IP-Adresse nicht mehr ausreicht
Stellen wir uns einen Server mit der IPv4-Adresse 192.0.2.20 vor. Auf diesem System können gleichzeitig ein Webserver, ein DNS-Dienst und zahlreiche weitere Anwendungen aktiv sein. Die IP-Adresse allein reicht deshalb nicht aus, um eingehende Daten eindeutig einer Anwendung zuzuordnen. TCP und UDP verwenden dafür Portnummern.
Ein Port ist eine 16 Bit große Nummer. Damit stehen Werte von 0 bis 65535 zur Verfügung. Bekannte Dienste verwenden häufig standardisierte beziehungsweise registrierte Ports. Beispiele sind TCP-Port 443 für HTTPS oder UDP-Port 53 für typische DNS-Anfragen. Ein Port gehört dabei nicht pauschal einer Anwendung, sondern muss immer zusammen mit dem verwendeten Transportprotokoll betrachtet werden. TCP-Port 53 und UDP-Port 53 sind unterschiedliche Transportendpunkte. Genau deshalb haben wir bei PAT bereits IP-Adressen und Transportinformationen gemeinsam betrachten müssen.
Sockets – Kommunikationsendpunkte werden konkret
In der praktischen Netzwerkprogrammierung begegnet uns häufig der Begriff Socket. Vereinfacht lässt sich ein Kommunikationsendpunkt durch die Kombination aus IP-Adresse, Transportprotokoll und Port beschreiben. Für eine konkrete TCP-Verbindung müssen darüber hinaus beide Seiten der Kommunikation unterschieden werden.
Ein Browser könnte beispielsweise von 192.0.2.10:51000 zu einem Webserver unter 198.51.100.20:443 kommunizieren. Die Verbindung lässt sich dann durch die beteiligten Endpunkte beschreiben: 192.0.2.10:51000 ↔ 198.51.100.20:443. Zusammen mit dem Transportprotokoll lässt sich diese Kommunikationsbeziehung eindeutig von anderen Verbindungen unterscheiden. Der Client verwendet dabei typischerweise einen dynamisch vergebenen Quellport. Dadurch können sogar zahlreiche parallele Verbindungen zum selben Serverdienst auseinandergehalten werden.
Genau diesen Mechanismus haben wir im NAT-Kapitel bereits aus einer anderen Perspektive gesehen. PAT konnte mehrere interne Kommunikationsbeziehungen über dieselbe öffentliche IPv4-Adresse führen, weil neben der IP-Adresse auch Transportinformationen zur Unterscheidung herangezogen wurden. Nun sehen wir, woher diese Portnummern eigentlich stammen und welche Aufgabe sie ursprünglich erfüllen.
TCP – Kommunikation mit Verbindung und Zustand
TCP wurde für Anwendungen entwickelt, die einen zuverlässigen Datentransport benötigen. Die aktuelle grundlegende Spezifikation findet sich in RFC 9293, das die historische TCP-Spezifikation aus RFC 793 ersetzt. TCP ist verbindungsorientiert. Bevor die eigentlichen Anwendungsdaten übertragen werden, etablieren beide Endsysteme einen gemeinsamen Verbindungszustand.
Das bedeutet nicht, dass dafür ein fester physischer Pfad durch das Netz reserviert würde. Die einzelnen IP-Pakete werden weiterhin von Layer 3 vermittelt und können grundsätzlich unterschiedliche Wege nehmen. Die Verbindung existiert vielmehr als Zustand in den beteiligten TCP-Endpunkten. Damit unterscheidet sich TCP übrigens deutlich von dem gerade im IPv5-Exkurs betrachteten ST2: Eine TCP-Verbindung reserviert nicht automatisch einen festen Netzwerkpfad oder garantierte Ressourcen entlang der Route.
Der Three-Way Handshake
Eine TCP-Verbindung beginnt typischerweise mit dem Three-Way Handshake. Nehmen wir erneut unseren Client und Webserver: 192.0.2.10:51000 → 198.51.100.20:443.
Der Verbindungsaufbau lässt sich vereinfacht in drei Schritten darstellen:
- Client → Server: SYN
- Server → Client: SYN, ACK
- Client → Server: ACK
Mit dem ersten SYN signalisiert der Client seinen Verbindungswunsch und übermittelt unter anderem eine initiale Sequenznummer. Der Server bestätigt diesen Wunsch mit SYN und ACK, bestätigt damit die Sequenzinformation des Clients und bringt zugleich seine eigene initiale Sequenznummer ein. Der Client bestätigt diese wiederum mit einem ACK.

Erst damit besitzen beide Seiten die notwendigen Ausgangsinformationen für die weitere TCP-Kommunikation. Der Three-Way Handshake ist also mehr als ein freundliches dreifaches Hallo. Er synchronisiert den Zustand beider Kommunikationspartner und insbesondere ihre Sequenzräume.
Sequenznummern bringen Ordnung in den Datenstrom
IP garantiert nicht, dass Pakete beim Empfänger in derselben Reihenfolge eintreffen, in der sie versendet wurden. Pakete können unterschiedliche Wege nehmen, verzögert werden oder verloren gehen. TCP stellt der Anwendung trotzdem einen geordneten Bytestrom bereit. Dazu versieht TCP die übertragenen Daten mit Sequenzinformationen. Wichtig ist dabei eine häufige Vereinfachung: TCP nummeriert nicht einfach Paket 1, Paket 2, Paket 3. Die Sequenznummern beziehen sich auf Positionen innerhalb des übertragenen Bytestroms.
Dadurch kann die empfangende Seite erkennen, welche Daten bereits vorliegen, welche noch fehlen und in welcher Reihenfolge sie der Anwendung bereitgestellt werden müssen. TCP macht aus der potenziell ungeordneten Paketvermittlung von IP einen geordneten Datenstrom für die Anwendung.
Bestätigungen – angekommen oder nicht?
Zur zuverlässigen Übertragung gehören außerdem Acknowledgements (ACKs). Die empfangende TCP-Seite bestätigt damit, bis zu welcher Position des Bytestroms Daten erfolgreich empfangen wurden beziehungsweise welche Sequenznummer sie als Nächstes erwartet. Gehen Daten verloren, kann TCP dies erkennen und eine erneute Übertragung veranlassen. Dabei spielen neben Bestätigungen auch Timer und weitere Mechanismen zur Verlustbehandlung eine Rolle.
Für die Anwendung entsteht dadurch eine komfortable Abstraktion: Sie muss sich normalerweise nicht selbst darum kümmern, einzelne verlorene IP-Pakete zu erkennen und deren Nutzdaten erneut anzufordern. Diese Zuverlässigkeit ist allerdings nicht kostenlos. TCP benötigt Zustand, zusätzliche Steuerinformationen und gegebenenfalls erneute Übertragungen.
Flusskontrolle – wenn der Empfänger nicht hinterherkommt
Zuverlässige Übertragung bedeutet außerdem, dass ein schneller Sender einen langsameren Empfänger nicht beliebig mit Daten überfluten sollte. TCP besitzt deshalb eine Flusskontrolle. Der Empfänger kann dem Sender über das sogenannte Receive Window mitteilen, wie viele weitere Daten er derzeit aufnehmen kann. Der Sender kann seine Übertragung daran ausrichten. Damit reagiert TCP auf die Leistungsfähigkeit des Kommunikationspartners.
Davon zu unterscheiden ist die Überlastkontrolle (Congestion Control). Sie beschäftigt sich nicht primär damit, wie schnell der Empfänger Daten verarbeiten kann, sondern mit der Belastung des Netzwerkpfades zwischen den Kommunikationspartnern.
Diese Unterscheidung ist wichtig: Flusskontrolle schützt den Empfänger – Überlastkontrolle reagiert auf die Bedingungen im Netz. Für unser grundlegendes Verständnis von Layer 4 genügt diese Abgrenzung zunächst. Die konkreten Algorithmen der TCP Congestion Control würden an dieser Stelle deutlich tiefer führen.
TCP schafft Zuverlässigkeit oberhalb von IP
Damit wird die Arbeitsteilung zwischen Layer 3 und Layer 4 besonders anschaulich. IP versucht, ein Paket zum angegebenen Ziel zu vermitteln. Es garantiert jedoch weder dessen Zustellung noch die richtige Reihenfolge mehrerer Pakete. TCP ergänzt darüber einen zuverlässigen Transportdienst.
Sequenzierung ordnet die Daten. Bestätigungen dokumentieren den Empfang. Wiederholungen reagieren auf Verluste. Flusskontrolle berücksichtigt die Aufnahmekapazität des Empfängers und Überlastkontrolle die Bedingungen des Netzpfades. IP vermittelt – TCP organisiert eine zuverlässige Kommunikationsbeziehung darüber. Aber nicht jede Anwendung benötigt diese Eigenschaften.
UDP – verbindungslose Kommunikation
Das User Datagram Protocol (UDP) verfolgt einen wesentlich einfacheren Ansatz. UDP ist verbindungslos. Vor dem Versenden von Nutzdaten findet kein mit TCP vergleichbarer Three-Way Handshake statt. Eine Anwendung kann ein UDP-Datagramm erzeugen und unmittelbar an einen Zielendpunkt senden.
Der UDP-Header ist entsprechend kompakt. Er enthält im Wesentlichen Quellport, Zielport, Länge und Prüfsumme. UDP selbst stellt dabei unter anderem keine TCP vergleichbaren Mechanismen für Verbindungsaufbau, Sequenzierung, erneute Übertragung verlorener Daten oder Flusskontrolle bereit.
Das bedeutet:
- Ein Datagramm kann ankommen
- Es kann verloren gehen
- Mehrere Datagramme können in anderer Reihenfolge eintreffen
UDP selbst versucht nicht, daraus wieder einen zuverlässigen geordneten Datenstrom zu erzeugen. Das macht UDP allerdings keineswegs zu einem schlechteren TCP.
Weniger Funktionen können ein Vorteil sein
Wenn eine Anwendung keine zuverlässige Bytestromübertragung durch das Transportprotokoll benötigt, wären die entsprechenden TCP-Mechanismen möglicherweise unnötiger Aufwand. Bei einer klassischen DNS-Abfrage beispielsweise sendet ein Client eine Anfrage und erwartet eine Antwort. Für viele solcher Kommunikationsvorgänge eignet sich UDP hervorragend. DNS ist dabei allerdings kein reines UDP-Protokoll und kann ebenfalls TCP verwenden – ein schönes Beispiel dafür, dass die Wahl des Transportprotokolls vom konkreten Anwendungsfall abhängt.
Auch bei zeitkritischen Anwendungen kann es sinnvoll sein, verlorene Daten nicht erneut zu übertragen. Ein verspätet erneut übertragenes Sprach- oder Videofragment kann wertlos sein, wenn die Wiedergabe längst fortgeschritten ist. UDP gibt Anwendungen deshalb mehr Freiheit: Es stellt einen schlanken Datagrammtransport bereit und überlässt zusätzliche Anforderungen weitgehend höheren Protokoll- beziehungsweise Anwendungsebenen.
TCP oder UDP?
Die Frage ‚Welches Protokoll ist besser?‘ führt deshalb in die falsche Richtung. TCP und UDP lösen unterschiedliche Anforderungen. TCP eignet sich besonders, wenn Anwendungen einen zuverlässigen, geordneten Bytestrom benötigen und die dafür erforderlichen Mechanismen nicht selbst implementieren sollen. UDP bietet sich an, wenn einzelne Datagramme, geringer Protokollaufwand, unmittelbares Senden ohne vorherigen TCP-Verbindungsaufbau oder anwendungsspezifische Transportmechanismen gefragt sind.
Entscheidend ist deshalb nicht, ob Zuverlässigkeit grundsätzlich wichtig ist. Entscheidend ist, auf welcher Ebene und mit welchen Mechanismen sie hergestellt werden soll. Und genau dieser Gedanke führt zu einem modernen Transportansatz, der die einfache Gegenüberstellung von TCP und UDP zunehmend erweitert.
QUIC – Transport über UDP neu gedacht
Auf den ersten Blick erscheint die klassische Welt übersichtlich: Zuverlässige Verbindung? TCP. Schlanker verbindungsloser Transport? UDP. Moderne Anwendungen stellen jedoch Anforderungen, für die diese Zweiteilung nicht immer optimal ist. Ein interessantes Beispiel ist QUIC.
QUIC ist ein modernes, verbindungsorientiertes und abgesichertes Transportprotokoll, dessen grundlegende Spezifikation in RFC 9000 beschrieben wird. Eine Besonderheit fällt sofort auf: QUIC wird über UDP transportiert.
Das bedeutet allerdings keineswegs, dass QUIC deshalb die Eigenschaften von UDP übernimmt und auf Zuverlässigkeit verzichten müsste. Vielmehr nutzt QUIC UDP als Grundlage für die Übertragung seiner Datagramme und implementiert darüber eigene Transportmechanismen.
Warum ausgerechnet UDP?
Neue Transportprotokolle haben im heutigen Internet ein praktisches Problem: Zwischen zwei Endsystemen befinden sich häufig Router, Firewalls, NAT-Systeme, Load Balancer und andere Middleboxes. Viele dieser Systeme sind seit Jahrzehnten auf TCP und UDP eingestellt.
UDP bietet QUIC deshalb einen entscheidenden praktischen Vorteil: Das Protokoll kann über eine bereits etablierte und breit unterstützte Transportschnittstelle durch bestehende IP-Infrastrukturen transportiert werden, ohne dafür ein vollständig neues IP-Transportprotokoll in allen beteiligten Zwischenkomponenten etablieren zu müssen. Damit wird UDP gewissermaßen zur Trägerschicht für einen umfangreicheren Transportmechanismus.
QUIC übernimmt selbst Transportaufgaben
Oberhalb von UDP stellt QUIC Eigenschaften bereit, die wir zuvor teilweise bei TCP kennengelernt haben. Dazu gehören unter anderem zuverlässige Datenübertragung, Verlustbehandlung, Flusskontrolle und Überlastkontrolle. Gleichzeitig unterstützt QUIC mehrere voneinander unabhängige Streams innerhalb einer Verbindung.
Hinzu kommt ein weiterer wesentlicher Unterschied: Kryptografische Absicherung ist integraler Bestandteil des QUIC-Verbindungsaufbaus. QUIC verwendet dafür TLS 1.3. Damit werden Transportverbindung und kryptografischer Verbindungsaufbau enger miteinander verzahnt, als wir es aus der klassischen Kombination von TCP und darüberliegendem TLS kennen.
Auf die sicherheitstechnische Bedeutung müssen wir an dieser Stelle noch nicht tiefer eingehen – sie gehört inhaltlich stärker zu den höheren Schichten unserer Beitragsreihe.
QUIC ersetzt nicht einfach TCP
QUIC wird gelegentlich verkürzt als TCP-Nachfolger bezeichnet. Für unser Schichtenverständnis ist eine differenziertere Betrachtung hilfreicher. TCP bleibt ein eigenständiges Transportprotokoll direkt oberhalb von IP. QUIC dagegen verwendet UDP als darunterliegenden Transportmechanismus und realisiert darüber selbst umfangreiche Funktionen eines modernen Transportprotokolls.
Gerade deshalb ist QUIC für unseren bisherigen Weg durch die Netzwerkarchitektur so interessant. Es zeigt, dass die Grenzen zwischen den klassischen Lehrbuchkategorien in modernen Protokollarchitekturen weniger eindeutig erscheinen können: IP bringt Daten zum Zielsystem. UDP stellt Ports und Datagrammtransport bereit. QUIC baut darauf eine eigene zuverlässige, verbindungsorientierte und abgesicherte Transportlogik auf.
HTTP/3 verwendet QUIC als Transportbasis und ist damit eines der prominentesten Beispiele für diesen Ansatz. Die Anwendungsschicht selbst werden wir jedoch erst an anderer Stelle genauer betrachten.
Von der Vermittlung zum Transport
Damit haben wir einen wichtigen Übergang vollzogen. Layer 3 beantwortet die Frage, wie ein Paket das richtige Zielsystem erreicht. Routing, IPv4 und IPv6 bilden dafür die Grundlage.
Layer 4 erweitert diese Kommunikation um die Perspektive der Anwendungen. Ports unterscheiden Kommunikationsendpunkte, TCP kann einen zuverlässigen geordneten Bytestrom bereitstellen und UDP ermöglicht einen schlanken verbindungslosen Datagrammtransport. QUIC zeigt schließlich, dass moderne Protokolle auf diesen Grundlagen aufbauen und Transportfunktionen neu kombinieren können.
Damit ist aus der reinen Zustellung zwischen IP-Endpunkten eine Kommunikation zwischen Anwendungen geworden. IP findet den Host. Die Transportschicht sorgt dafür, dass die Daten im richtigen Kommunikationskontext ankommen. Bevor wir diese Reise in Richtung der höheren Schichten fortsetzen, lohnt sich allerdings noch ein Blick auf einige Mechanismen, die uns im realen Netzwerkbetrieb ständig begegnen. Denn zwischen theoretischer Paketvermittlung und funktionierender Kommunikation liegen Themen wie ICMP, MTU, Fragmentierung, DNS und weitere alltägliche Begleiter der IP-Kommunikation.
Mechanismen, die IP-Kommunikation im Alltag prägen
Mit IP, Routing, TCP und UDP stehen die wesentlichen Bausteine für die Kommunikation über Netzwerkgrenzen hinweg. Im praktischen Betrieb reicht es jedoch nicht, Pakete lediglich zu adressieren, weiterzuleiten und einer Anwendung zuzuordnen. Ein Host muss beispielsweise wissen, wie groß ein Paket auf dem Weg zum Ziel sein darf. Router und Endsysteme müssen Fehler und besondere Situationen signalisieren können. Anwendungen kommunizieren nicht ausschließlich mit einzelnen Empfängern, sondern teilweise mit ganzen Gruppen. Und in größeren Netzen müssen Router Änderungen der Topologie erkennen können, ohne dass Administrator:innen jede Route manuell konfigurieren.
Einige dieser Mechanismen haben wir auf unserem bisherigen Weg bereits gestreift. Nun lohnt sich ein zusammenhängender Blick auf jene Funktionen, die im Netzwerkalltag häufig unsichtbar bleiben – bis etwas nicht funktioniert.
MTU – wie groß darf ein Paket sein?
Netzwerke können nicht beliebig große Pakete übertragen. Die zugrunde liegende Übertragungstechnologie gibt Grenzen dafür vor, wie viele Daten innerhalb einer Übertragungseinheit transportiert werden können. Eine wichtige Größe ist dabei die Maximum Transmission Unit – MTU.
Für klassisches Ethernet beträgt die IP-MTU typischerweise 1.500 Byte. Das bedeutet: Ein Ethernet-Netz kann normalerweise ein IP-Paket mit einer Größe von bis zu 1.500 Byte transportieren, ohne dass dieses aufgrund der MTU aufgeteilt werden muss.
Doch eine Kommunikation besteht selten nur aus einem einzelnen lokalen Ethernet-Segment. Zwischen Quelle und Ziel können unterschiedliche Netzwerktechnologien, Tunnel oder zusätzliche Kapselungen liegen. Entscheidend ist deshalb nicht allein die MTU am sendenden Interface. Relevant ist die kleinste MTU, die auf dem gesamten Pfad zum Ziel verwendet werden kann. Hier kommt die Path MTU – PMTU ins Spiel.
Path MTU Discovery – die passende Paketgröße finden
Die Path MTU Discovery (PMTUD) soll ermitteln, wie groß ein IP-Paket maximal sein darf, ohne auf seinem Weg zum Ziel an einer zu kleinen MTU zu scheitern. Vereinfacht geht es um die Frage: Wie groß darf mein Paket sein, damit es den gesamten Pfad zum Ziel passieren kann? Dabei arbeiten IP und ICMP zusammen.
Unter IPv4 kann der Sender mit dem Don't Fragment (DF)-Bit festlegen, dass ein Paket unterwegs nicht fragmentiert werden darf. Trifft ein Router auf einen Link mit einer kleineren MTU, kann er das Paket dann nicht einfach aufteilen. Er verwirft es und kann dem Sender über ICMP mitteilen, dass eine Weiterleitung ohne Fragmentierung nicht möglich ist. Der Sender kann darauf reagieren und kleinere Pakete verwenden.
Damit wird deutlich, dass ICMP keineswegs nur für ping interessant ist. Es übernimmt wichtige Steuerungs- und Fehlermeldungsfunktionen für IP selbst.
Fragmentierung – wenn ein IPv4-Paket nicht passt
IPv4 kennt noch einen weiteren Umgang mit zu großen Paketen: Fragmentierung. Ist ein IPv4-Paket größer als die MTU des nächsten Links und verbietet das DF-Bit eine Fragmentierung nicht, kann ein Router das ursprüngliche Paket in mehrere kleinere IPv4-Fragmente zerlegen.
Diese Fragmente werden anschließend unabhängig voneinander weitergeleitet. Die Wiederzusammensetzung – die Reassembly – erfolgt erst am Zielsystem. Dafür besitzt der IPv4-Header entsprechende Informationen. Unter anderem helfen Identification, Fragment Offset und das More Fragments (MF)-Flag dem Empfänger dabei, die Fragmente wieder dem ursprünglichen Datagramm zuzuordnen und korrekt zusammenzusetzen.
Fragmentierung löst damit zunächst das MTU-Problem, bringt aber Nachteile mit sich. Zusätzliche Header verursachen Overhead, einzelne Fragmente können auf dem Transportweg verloren gehen und der Empfänger muss Ressourcen für die Reassembly bereitstellen.Geht nur ein benötigtes Fragment verloren, kann das ursprüngliche IP-Datagramm nicht vollständig rekonstruiert werden. Fragmentierung funktioniert – besser ist es jedoch häufig, bereits an der Quelle eine zum Netzwerkpfad passende Paketgröße zu verwenden.
IPv6 fragmentiert anders
Bei IPv6 wurde dieser Mechanismus grundlegend verändert. IPv6-Router fragmentieren weitergeleitete Pakete nicht. Kann ein Router ein IPv6-Paket aufgrund der MTU des nächsten Links nicht weiterleiten, verwirft er es und sendet eine ICMPv6 Packet Too Big-Nachricht an den ursprünglichen Sender. Diese enthält die relevante MTU. Der Sender kann seine Paketgröße daraufhin anpassen.
Falls eine Fragmentierung tatsächlich erforderlich ist, erfolgt sie bei IPv6 durch den sendenden Node, nicht durch einen Router auf dem Übertragungsweg. Dafür verwendet IPv6 einen entsprechenden Fragment Extension Header. Damit gewinnt Path MTU Discovery bei IPv6 noch einmal an Bedeutung. Der Unterschied lässt sich auf einen einfachen Grundgedanken reduzieren: IPv4 kann Fragmentierung auf dem Weg zulassen. IPv6 verlagert die Verantwortung für eine notwendige Fragmentierung auf den Sender.
Wenn ICMP blockiert wird
In der Praxis entsteht rund um PMTUD ein interessantes Fehlerbild. Firewalls werden gelegentlich so konfiguriert, dass ICMP pauschal blockiert wird. Die Motivation dahinter ist häufig die Vorstellung, ICMP sei lediglich ein Diagnoseprotokoll, das potenziellen Angreifenden unnötige Informationen über das Netz verrät.
Eine solche Konfiguration kann jedoch grundlegende Netzwerkmechanismen beeinträchtigen. Erhält ein Sender notwendige ICMP-Informationen über eine zu große Paketgröße nicht, kann die Kommunikation scheinbar unerklärlich ins Stocken geraten. Kleine Datenmengen funktionieren möglicherweise noch, während größere Übertragungen scheitern.
Solche Situationen werden häufig unter dem Begriff PMTUD Black Hole zusammengefasst. Gerade bei IPv6 ist eine pauschale Blockierung von ICMPv6 besonders problematisch, weil ICMPv6 noch stärker Bestandteil grundlegender IPv6-Funktionen ist. ICMP ist kein optionales Zubehör für die Fehlersuche. Es gehört zur Funktionsweise von IP-Netzen.
ICMP – wenn IP Rückmeldung geben muss
Das Internet Control Message Protocol – ICMP ergänzt IP um Kontroll- und Fehlermeldungen. IP selbst ist ein Best-Effort-Protokoll. Ein Router kann ein Paket beispielsweise nicht weiterleiten, weil keine passende Route vorhanden ist, die Lebensdauer des Pakets abgelaufen ist oder die zulässige Paketgröße überschritten wird. ICMP ermöglicht es, bestimmte solcher Situationen gegenüber anderen Systemen zu signalisieren.
Dabei existieren mit ICMP für IPv4 und ICMPv6 für IPv6 unterschiedliche Protokollvarianten. ICMPv6 übernimmt darüber hinaus Aufgaben, die bei IPv4 teilweise durch andere Protokolle realisiert werden. Unser zuvor behandeltes Neighbor Discovery basiert beispielsweise auf ICMPv6.
Ping – die bekannteste ICMP-Anwendung
Das wahrscheinlich bekannteste Diagnosewerkzeug ist ping. Dabei sendet ein System einen ICMP Echo Request an ein Ziel. Antwortet dieses mit einem Echo Reply, lässt sich zunächst feststellen, dass grundsätzlich eine entsprechende Kommunikation zwischen beiden Systemen möglich ist.
Das Ergebnis darf allerdings nicht überinterpretiert werden. Ein erfolgreicher Ping bedeutet nicht automatisch, dass ein bestimmter Anwendungsdienst funktioniert. Und ein fehlender Echo Reply beweist umgekehrt nicht zwangsläufig, dass das Zielsystem ausgefallen ist. ICMP Echo kann beispielsweise gezielt gefiltert werden. Der Befehl ping beantwortet deshalb eine vergleichsweise konkrete Frage: Erhalte ich auf meinen ICMP Echo Request eine Antwort vom Ziel? Für die Fehlersuche ist diese Information ausgesprochen wertvoll – sie ersetzt aber nicht die Prüfung der darüberliegenden Protokolle.
Traceroute – wenn TTL zum Diagnosewerkzeug wird
Ein weiteres bekanntes Werkzeug nutzt einen Mechanismus, den wir beim Routing bereits kennengelernt haben. Der IPv4-Header enthält das Feld Time to Live (TTL). Jeder Router reduziert den Wert beim Weiterleiten. Erreicht TTL den Wert null, wird das Paket verworfen. Damit wird verhindert, dass Pakete bei einer Routing-Schleife unbegrenzt durch das Netz zirkulieren. Der Router kann darauf mit einer ICMP Time Exceeded-Nachricht reagieren.
Der Befehl traceroute beziehungsweise unter Windows tracert nutzt genau dieses Verhalten gezielt aus. Pakete werden zunächst mit sehr kleinen TTL-Werten versendet und der Wert anschließend schrittweise erhöht.
Vereinfacht: TTL 1 → erster Router, TTL 2 → zweiter Router, TTL 3 → dritter Router und so weiter. Die zurückkommenden ICMP-Nachrichten ermöglichen es, einzelne Stationen auf dem Weg zum Ziel sichtbar zu machen.
Bei IPv6 erfüllt der Hop Limit die entsprechende Aufgabe. Aus einem Schutzmechanismus gegen endlose Paketumlaufzeiten wird damit zugleich ein wertvolles Werkzeug für die Netzwerkdiagnose.
Loopback – Kommunikation mit sich selbst
Nicht jede IP-Kommunikation muss tatsächlich ein physisches Netzwerk verlassen. IPv4 reserviert dafür den Bereich 127.0.0.0/8 als Loopback-Adressraum. Besonders bekannt ist: 127.0.0.1. IPv6 verwendet ::1/128. Pakete an eine Loopback-Adresse bleiben innerhalb des lokalen Systems. Sie werden nicht an ein physisches Netzwerkinterface zur Übertragung auf einen externen Link weitergegeben.
Das macht Loopback-Adressen für lokale Dienste, Softwareentwicklung und Diagnosen nützlich. Ein Webserver kann beispielsweise ausschließlich auf der Loopback-Adresse lauschen. Der Dienst ist dann lokal erreichbar, ohne dadurch automatisch über eine physische Netzwerkschnittstelle anderen Systemen zur Verfügung zu stehen.
Auch bei der Fehlersuche hilft diese Unterscheidung: Funktioniert ein Dienst über Loopback, aber nicht über eine Adresse eines physischen Interfaces, lässt sich die Suche bereits auf andere Bereiche der Kommunikationskette eingrenzen. Loopback ermöglicht IP-Kommunikation, ohne dass dafür ein externes Netz benötigt wird.
Unicast, Broadcast, Multicast und Anycast
Bislang haben wir häufig so getan, als kommuniziere immer genau ein Sender mit genau einem Empfänger. Das ist der klassische Fall von Unicast: ein Sender → ein adressierter Empfänger. IP-Netze kennen jedoch unterschiedliche Kommunikationsmodelle. Neben Unicast begegnen uns Broadcast, Multicast und Anycast. Sie unterscheiden sich vor allem darin, welche Gruppe von Empfängern durch eine Adresse angesprochen werden soll.
Broadcast – einer an alle
Broadcast richtet eine Übertragung an alle Systeme innerhalb einer entsprechenden Broadcast-Domain. Bei IPv4 ist dies beispielsweise über eine gerichtete Broadcast-Adresse eines Subnetzes möglich. Für 192.168.10.0/24 lautet die Broadcast-Adresse 192.168.10.255.
Broadcast war und ist Bestandteil verschiedener IPv4-Mechanismen. Gleichzeitig besitzt das Verfahren einen offensichtlichen Nachteil: Auch Systeme, für die eine Nachricht letztlich nicht relevant ist, müssen sich zunächst mit der Übertragung auseinandersetzen. IPv6 kennt deshalb keine Broadcast-Adresse. Aufgaben, für die unter IPv4 Broadcast verwendet wird, werden bei IPv6 durch andere Mechanismen und insbesondere Multicast gelöst.
Multicast – einer an eine Gruppe
Multicast richtet sich nicht an alle Systeme, sondern an eine definierte Gruppe von Empfängern: ein Sender → interessierte Empfängergruppe. IPv4 reserviert dafür den Adressbereich 224.0.0.0/4. IPv6 verwendet Multicast-Adressen aus ff00::/8.
Multicast begegnet uns an sehr unterschiedlichen Stellen. Routingprotokolle können damit gezielt andere Router ansprechen, IPv6 Neighbor Discovery nutzt Multicast und auch Anwendungen können Gruppenkommunikation verwenden. Für die Verwaltung entsprechender Gruppen kommen bei IPv4 IGMP – Internet Group Management Protocol und bei IPv6 MLD – Multicast Listener Discovery zum Einsatz.
Multicast ist damit nicht einfach ein effizienterer Broadcast. Das entscheidende Prinzip besteht darin, Verkehr gezielt an Mitglieder einer bestimmten Gruppe zu richten.
Anycast – dieselbe Adresse an mehreren Orten
Anycast dreht die Perspektive noch einmal um. Mehrere Systeme beziehungsweise Interfaces verwenden dabei dieselbe Adresse. Die Routinginfrastruktur entscheidet anschließend, zu welcher Instanz ein Paket weitergeleitet wird. Vereinfacht: ein Sender → eine von mehreren möglichen Instanzen.
Häufig wird Anycast deshalb mit dem nächstgelegenen Server erklärt. Gemeint ist damit jedoch nicht zwingend die geografisch kürzeste Entfernung. Entscheidend ist, welche Instanz aus Sicht des Routings über den bevorzugten Pfad erreichbar ist.
Anycast eignet sich damit besonders für verteilte Dienste. Eine identische Dienstadresse kann an mehreren Standorten angekündigt werden, während das Routing den Verkehr zu einer geeigneten Instanz führt. Ein bekanntes Einsatzgebiet sind beispielsweise weltweit verteilte DNS-Infrastrukturen.
Damit unterscheiden sich die vier Modelle konzeptionell deutlich:
- Unicast: einer zu einem
- Broadcast: einer zu allen innerhalb des entsprechenden Bereichs
- Multicast: einer zu einer definierten Gruppe
- Anycast: einer zu einer von mehreren möglichen Instanzen
Dynamisches Routing – wenn sich Router austauschen
Eine Routingtabelle kann vollständig statisch konfiguriert werden. In kleinen und überschaubaren Netzen kann das durchaus sinnvoll sein. Mit wachsender Größe entsteht jedoch ein Skalierungsproblem. Wenn neue Netze hinzukommen, Pfade ausfallen oder sich Topologien verändern, müssten Administrator:innen statische Routen auf zahlreichen Routern manuell anpassen.
Dynamische Routingprotokolle automatisieren den Austausch von Routinginformationen. Router können damit Informationen über erreichbare Präfixe austauschen und anhand protokollspezifischer Verfahren geeignete Pfade bestimmen. Wichtig ist dabei eine bereits zuvor eingeführte Unterscheidung: Das Routingprotokoll entscheidet nicht für jedes einzelne Paket neu über dessen Weg. Es trägt vielmehr zur Control Plane bei und beeinflusst, welche Routen für die spätere Weiterleitung zur Verfügung stehen. Die eigentliche paketweise Weiterleitung erfolgt anschließend in der Data Plane.
Unterschiedliche Protokolle für unterschiedliche Aufgaben
Routingprotokolle verfolgen unterschiedliche Ansätze und sind für unterschiedliche Einsatzbereiche konzipiert.
- RIP gehört zu den klassischen Distance-Vector-Protokollen. Seine Metrik basiert im Wesentlichen auf der Anzahl der Hops; mit maximal 15 Hops ist seine Skalierbarkeit stark begrenzt.
- OSPF ist ein Link-State-Protokoll. Router bauen anhand ausgetauschter Topologieinformationen ein Modell des Netzes auf und berechnen daraus geeignete Pfade. OSPF ist insbesondere in Unternehmens- und Providernetzen weiterhin von Bedeutung.
- EIGRP verwendet einen eigenen Ansatz mit dem Diffusing Update Algorithm (DUAL) und einer zusammengesetzten Metrik. Historisch ist EIGRP stark mit Cisco verbunden; die häufig anzutreffende pauschale Beschreibung als ausschließlich proprietäres Cisco-Protokoll greift heute jedoch zu kurz.
- BGP verfolgt wiederum ein anderes Ziel. Als Border Gateway Protocol bildet es eine wesentliche Grundlage für den Austausch von Erreichbarkeitsinformationen zwischen Autonomen Systemen und damit für das Routing im globalen Internet. BGP sucht dabei nicht einfach den mathematisch kürzesten Routingentscheidungen können anhand verschiedener Attribute und insbesondere administrativer Richtlinien beeinflusst werden.
Damit wird deutlich: Es gibt nicht das eine Routingprotokoll für alle Netze. Die Anforderungen innerhalb eines Unternehmensnetzes unterscheiden sich grundlegend von denen des globalen Internets. Die Funktionsweise von RIP, OSPF, EIGRP und weiteren Routingverfahren behandele ich ausführlicher im Beitrag Wenn Router Entscheidungen treffen – Routingprotokolle im Cisco-Netzwerk verstehen. Die besondere Rolle von BGP und seine historische Entwicklung im Internet vertieft Externes Routing im Internet und WAN – Architektur, Historie und Bedeutung von BGP.
Viele kleine Mechanismen ergeben funktionierende Kommunikation
MTU, Fragmentierung, ICMP, Loopback, Multicast oder dynamische Routingprotokolle wirken zunächst wie einzelne technische Spezialthemen. Tatsächlich greifen sie unmittelbar in die Kommunikation ein, die wir in den vorherigen Kapiteln schrittweise aufgebaut haben.
Ein Host muss wissen, wohin ein Paket gehört. Router müssen einen geeigneten nächsten Hop kennen. Die Paketgröße muss zum Übertragungsweg passen. Fehler und besondere Situationen müssen signalisiert werden können. Gruppenkommunikation benötigt andere Adressierungsmodelle als eine klassische Unicast-Verbindung. Und größere Netze müssen Änderungen ihrer Topologie verarbeiten können.
Funktionierende IP-Kommunikation entsteht deshalb nicht durch einen einzelnen Mechanismus. Sie ist das Ergebnis vieler Protokolle und Verfahren, die an unterschiedlichen Stellen ineinandergreifen. Genau diese Zusammenhänge werden in der Praxis besonders interessant. Denn wenn Kommunikation nicht wie erwartet funktioniert, reicht die Frage ‘Ist die IP-Adresse richtig?‘ nur selten aus. Dann müssen Administrator:innen nachvollziehen können, an welcher Stelle dieser Kette ein Paket nicht mehr so behandelt wird, wie es eigentlich sollte.
Layer 3 und 4 in der Praxis – wenn aus Grundlagen Betrieb wird
IP-Adressen, Präfixe, Routingtabellen, TCP-Ports oder MTU-Werte wirken zunächst wie einzelne technische Konzepte. Im laufenden Betrieb treten sie jedoch selten isoliert auf. Eine einfache Webanfrage kann bereits Namensauflösung, mehrere Routingentscheidungen, NAT, TCP oder QUIC, Firewalls und unterschiedliche MTUs durchlaufen. Bei einer Standortvernetzung kommen zusätzlich Tunnel, private Adressräume und dynamische Routinginformationen hinzu. Selbst ein typisches Heimnetz verwendet heute zahlreiche Mechanismen, die wir in den vorherigen Kapiteln kennengelernt haben.
Gerade darin liegt der praktische Wert des Schichtenmodells: Es liefert keine vollständige Beschreibung jedes realen Systems, hilft aber dabei, komplexe Kommunikation in funktionale Teilprobleme zu zerlegen. Statt also nur zu fragen, ob ‚das Netzwerk funktioniert‘, können Administrator:innen genauer untersuchen:
- Ist das Ziel korrekt adressiert?
- Existiert eine Route?
- Ist der nächste Hop erreichbar?
- Funktioniert die Namensauflösung?
- Kann die Transportverbindung aufgebaut werden?
- Lässt die Sicherheitsrichtlinie diese Kommunikation überhaupt zu?
Schauen wir uns in diesem Kontext einige typische Szenarien an.
Standortvernetzung – wenn private Netze über das Internet kommunizieren
Ein Unternehmen betreibt beispielsweise einen Hauptstandort in Dortmund und eine Außenstelle in München. Intern könnten beide Standorte unterschiedliche private IPv4-Präfixe verwenden:
- Dortmund: 10.10.0.0/16
- München: 10.20.0.0/16
Zwischen beiden Standorten soll Kommunikation möglich sein, obwohl das öffentliche Internet die privaten RFC-1918-Adressen nicht routet. Eine typische Lösung besteht darin, zwischen den Standorten einen VPN-Tunnel aufzubauen. Aus Sicht des internen Hosts bleibt das Ziel zunächst ein ganz normales entferntes IP-Netz. Ein System in Dortmund möchte beispielsweise 10.20.5.25 erreichen. Aufgrund seines eigenen Präfixes erkennt es, dass sich das Ziel nicht im lokalen Netz befindet, und sendet das Paket an seinen Router.
Die Routinginfrastruktur entscheidet anschließend, dass Verkehr für 10.20.0.0/16 über die VPN-Verbindung transportiert werden soll. Damit begegnet uns erneut die bekannte Kette: Zieladresse bestimmen → Route auswählen → Next Hop bestimmen → Paket weiterleiten. Der VPN-Tunnel verändert nicht das grundlegende Routingprinzip. Er schafft vielmehr einen zusätzlichen logischen Übertragungsweg zwischen zwei Netzen.
Der Tunnel selbst benötigt ebenfalls IP-Konnektivität
Interessant ist dabei die doppelte Perspektive. Das innere Paket könnte lauten: 10.10.1.50 → 10.20.5.25. Damit dieses Paket durch das Internet transportiert werden kann, wird es abhängig von der verwendeten VPN-Technologie in weitere Protokollinformationen gekapselt. Außen kommunizieren dann beispielsweise die öffentlichen VPN-Endpunkte der beiden Standorte miteinander.
Damit existieren gewissermaßen zwei Routingfragen:
- Im Unternehmensnetz: Wie erreichen wir das entfernte private Präfix?
- Im Internet: Wie erreichen sich die beiden VPN-Gateways?
Gerade Tunnel zeigen deshalb sehr schön, dass ein IP-Paket selbst wieder Nutzlast eines anderen Übertragungsmechanismus werden kann.
Routing innerhalb des VPN-Szenarios
Die benötigten Routen können statisch konfiguriert oder über Routingprotokolle ausgetauscht werden. Für zwei kleine Standorte können statische Routen vollkommen ausreichend sein. In größeren WAN-Architekturen können dagegen OSPF, BGP oder andere Verfahren eingesetzt werden.
Entscheidend ist nicht, dass ein bestimmtes Routingprotokoll zwingend zu einem VPN gehört. Entscheidend ist: Die Routingtabelle muss wissen, über welchen Pfad das entfernte Präfix erreichbar ist.
Auch NAT kann in solchen Umgebungen eine Rolle spielen – beispielsweise wenn sich interne Adressräume überschneiden oder ein VPN-Protokoll eine vorhandene IPv4-NAT-Grenze passieren muss. Damit verbindet ein vermeintlich einfaches Standort-VPN bereits Adressierung, Routing, Kapselung, NAT und Sicherheitsmechanismen miteinander.
Die kryptografischen und sicherheitstechnischen Details von VPN-Technologien gehören allerdings stärker zu den höheren Schichten und damit zum nächsten Beitrag unserer Reihe.
Das Heimnetz – erstaunlich viel Netzwerktechnik hinter einem Router
Ein typischer Internetrouter im privaten Umfeld wirkt zunächst unspektakulär. Einige Geräte verbinden sich per Ethernet oder WLAN, erhalten eine Adresse und erreichen anschließend das Internet. Unter der Oberfläche laufen jedoch zahlreiche Mechanismen zusammen.
Ein IPv4-Client könnte beispielsweise die Adresse 192.168.178.50/24 verwenden und den Router unter 192.168.178.1 als Default Gateway kennen. Soll ein Ziel außerhalb von 192.168.178.0/24 erreicht werden, sendet der Host das Paket an diesen Router.
Der Internetrouter übernimmt anschließend mehrere Aufgaben gleichzeitig: Er routet zwischen internem Netz und Provideranschluss, führt bei IPv4 häufig PAT durch und arbeitet typischerweise zusätzlich als Stateful Firewall.
Dazu kommen weitere Funktionen wie DHCP, DNS-Weiterleitung und zunehmend IPv6 Router Advertisements. Was für Benutzer:innen wie der Router aussieht, ist damit tatsächlich eine Kombination zahlreicher Netzwerkfunktionen.
Eine Webanfrage aus dem Heimnetz
Der Ablauf wird noch anschaulicher, wenn ein Notebook eine Webseite aufruft. Zunächst muss der eingegebene Name in eine IP-Adresse aufgelöst werden. Dazu stellt das System eine DNS-Anfrage. DNS kann abhängig von Situation und Protokoll über UDP oder TCP arbeiten. Moderne Varianten wie DNS over HTTPS oder DNS over TLS bringen noch weitere Transport- und Anwendungsschichten ins Spiel.
Nach erfolgreicher Namensauflösung steht beispielsweise eine Zieladresse fest. Nun prüft der Client anhand seines Präfixes: Ist dieses Ziel lokal oder remote? Für einen öffentlichen Webserver lautet die Antwort typischerweise: remote. Das Paket geht deshalb zunächst an das Default Gateway.
Verwendet das Heimnetz IPv4 mit PAT, könnte aus 192.168.178.50:52000 am Router beispielsweise 203.0.113.45:61000 werden. Anschließend beginnt der Weg durch das Netz des Providers und weitere Routingdomänen bis zum Ziel.
In einer einzigen vermeintlich einfachen Webanfrage begegnen uns damit bereits DNS, Präfixe, Routing, ARP beziehungsweise Neighbor Discovery, NAT und Transportports.
MTU – wenn der Zugangstyp ebenfalls mitredet
Auch die verwendete Anschlusstechnologie kann Auswirkungen auf die IP-Kommunikation haben. Bei klassischem Ethernet begegnet uns häufig eine MTU von 1500 Byte. Wird beispielsweise PPPoE eingesetzt, kann durch die zusätzliche Kapselung eine kleinere nutzbare IP-MTU entstehen. Ein häufig anzutreffender Wert ist 1492 Byte.
Zusätzliche Tunnel können den verfügbaren Raum weiter reduzieren. Solange Path MTU Discovery und die beteiligten Protokolle korrekt funktionieren, bleibt dies für Benutzer:innen meist unsichtbar. Wird ICMP dagegen ungünstig gefiltert oder stimmt die MTU-Konfiguration eines Tunnels nicht, können ausgesprochen merkwürdige Fehler entstehen: Kleine Anfragen funktionieren, größere Übertragungen hängen. Einige Webseiten laden, andere nicht. Eine VPN-Verbindung wird aufgebaut, überträgt aber bestimmte Daten nicht zuverlässig. Damit wird aus einem scheinbar abstrakten MTU-Wert plötzlich ein sehr konkretes Betriebsproblem.
Vom Browser zur Cloud-Anwendung
Nehmen wir nun einen Client, der eine Anwendung bei einem Cloud-Anbieter öffnet. Früher hätte man den Kommunikationsweg häufig recht einfach beschrieben: DNS → TCP → TLS → http. Heute ist bereits diese Darstellung nicht mehr allgemeingültig. Bei HTTP/1.1 oder HTTP/2 über HTTPS wird typischerweise zunächst eine TCP-Verbindung aufgebaut. Danach folgt die kryptografische Absicherung mit TLS und darüber die HTTP-Kommunikation.
Vereinfacht: IP → TCP → TLS → HTTP/1.1 oder HTTP/2
Bei HTTP/3 sieht die Architektur anders aus: IP → UDP → QUIC → HTTP/3
Damit begegnet uns unmittelbar der moderne Transportansatz aus dem vorherigen Kapitel. Ein Browser kann also dieselbe fachliche Aufgabe – den Zugriff auf einen Webdienst – über unterschiedliche Transportarchitekturen realisieren.
Was auf dem Weg in die Cloud geschieht
Auch der eigentliche Zielserver muss nicht zwingend jenes System sein, das die öffentliche IP-Adresse trägt. Vor der Anwendung können beispielsweise Load Balancer, Reverse Proxys, Firewalls oder andere Vermittlungssysteme stehen. Die öffentliche Kommunikation könnte zunächst bei einem Frontend ankommen: Client → öffentliche Dienstadresse:443. Intern wird sie anschließend möglicherweise an eines von vielen Backend-Systemen weitergegeben.
Aus Layer-3-Perspektive können dabei weitere Subnetze und Routingentscheidungen entstehen. Auf Layer 4 können TCP- oder UDP-Verbindungen terminiert und neue aufgebaut werden. Auf höheren Ebenen kann schließlich anhand von HTTP-Informationen entschieden werden, welcher Dienst eine Anfrage erhält.
Damit wird ein wichtiger Unterschied sichtbar: Eine IP-Adresse identifiziert nicht zwangsläufig genau einen physischen Server. Sie kann einen Dienstzugang repräsentieren, hinter dem sich eine wesentlich komplexere Infrastruktur befindet. Anycast, Load Balancing, NAT und virtuelle Netzwerkarchitekturen können die Zuordnung zwischen einer sichtbaren Adresse und den tatsächlich verarbeitenden Systemen weiter abstrahieren.
Container und Kubernetes – bekannte Prinzipien in neuer Größenordnung
Besonders anschaulich wird diese Entwicklung in Containerumgebungen. Kubernetes wirkt auf den ersten Blick wie eine völlig neue Netzwerkwelt. Tatsächlich begegnen uns dort jedoch viele Konzepte wieder, die wir bereits kennengelernt haben: IP-Adressen, Präfixe, Routing, Ports, DNS, NAT und Load Balancing. Sie werden lediglich wesentlich stärker automatisiert.
Ein Kubernetes-Pod erhält typischerweise eine eigene IP-Konnektivität. Wie diese technisch bereitgestellt wird, hängt vom verwendeten Netzwerkmodell und dem jeweiligen Container Network Interface – CNI ab. Lösungen wie Calico, Cilium oder Flannel können dabei unterschiedliche Ansätze verfolgen. Je nach Implementierung kommen native Routingverfahren, Overlay-Netze, Tunnel oder eBPF-basierte Mechanismen zum Einsatz.
Es wäre deshalb zu pauschal, Kubernetes generell als virtuelles Layer-3-Overlay zu beschreiben. Das gemeinsame Ziel besteht vielmehr darin, IP-Kommunikation zwischen den Workloads des Clusters bereitzustellen.
Pods sind dynamisch – Dienste brauchen Stabilität
Ein grundlegendes Problem containerisierter Architekturen liegt darin, dass einzelne Pods kurzlebig sein können. Ein Pod verschwindet, ein anderer wird erzeugt und erhält möglicherweise eine andere IP-Adresse. Anwendungen sollen ihre Kommunikationspartner trotzdem zuverlässig finden können.
Kubernetes führt deshalb mit Services eine zusätzliche Abstraktion ein. Statt einen bestimmten Pod dauerhaft über dessen individuelle Adresse anzusprechen, kann ein Service einen stabileren Zugang zu einer Gruppe geeigneter Backend-Pods bereitstellen.
Hier begegnen uns wiederum Mechanismen verschiedener Ebenen:
- DNS kann Namen auf Dienste abbilden
- Layer-3-Adressen ermöglichen die Erreichbarkeit
- Layer-4-Informationen unterscheiden TCP- und UDP-Dienste
- Load-Balancing-Mechanismen verteilen Kommunikation auf geeignete Backends
Was wie moderne Cloud-native Magie wirkt, basiert damit weiterhin auf den Grundlagen, die seit Jahrzehnten IP-Netze prägen.
Netzwerkvirtualisierung ersetzt die Grundlagen nicht
Das ist vielleicht die wichtigste Erkenntnis dieses Beispiels. Cloud-, Container- und Virtualisierungsplattformen abstrahieren Netzwerke zunehmend. Administrator:innen konfigurieren nicht zwingend jeden Router und jedes Interface von Hand. Softwarecontroller, APIs und Automatisierung übernehmen große Teile dieser Arbeit.
Aber die grundlegenden Fragen verschwinden nicht:
- Welchen Präfix besitzt ein Netz?
- Wie wird ein Ziel erreicht?
- Welcher Next Hop beziehungsweise welche virtuelle Weiterleitungsinstanz ist zuständig?
- Welche Transportverbindung gehört zu welchem Dienst?
- Welche Kommunikation wird erlaubt?
Die Implementierung verändert sich. Das Prinzip bleibt.
Wenn Fehlersuche den Kommunikationsweg rückwärts verfolgt
Gerade bei Störungen zeigt sich deshalb, warum Grundlagenwissen weiterhin wichtig ist. Angenommen, eine Anwendung meldet lediglich: ‘Server nicht erreichbar.‘ Diese Information sagt zunächst wenig darüber aus, wo das Problem tatsächlich liegt. Die Fehlersuche kann deshalb den Kommunikationsweg schrittweise untersuchen: Adresse und Präfix → lokale oder entfernte Entscheidung → Next Hop → Routing → Namensauflösung → Transportport → TCP beziehungsweise UDP → Anwendung.
Vielleicht existiert keine Route. Vielleicht funktioniert Neighbor Discovery oder ARP nicht. Vielleicht verhindert eine falsche MTU größere Übertragungen. Vielleicht erreicht das Paket zwar das Zielsystem, aber auf dem erwarteten TCP-Port lauscht kein Dienst. Vielleicht funktioniert TCP, während die Anwendung selbst einen Fehler produziert. Oder eine Firewall verwirft die Kommunikation an einer ganz anderen Stelle. Je genauer die einzelnen Aufgaben der Schichten verstanden werden, desto gezielter lässt sich die Fehlerursache eingrenzen.
Alte Grundlagen in modernen Netzen
Ob Heimrouter, Unternehmens-WAN, Cloud-Plattform oder Kubernetes-Cluster: Die sichtbare Infrastruktur hat sich in den vergangenen Jahrzehnten enorm verändert. Die grundlegenden Fragen der Kommunikation sind erstaunlich beständig geblieben. Ein System benötigt eine Adresse. Es muss lokale von entfernten Zielen unterscheiden. Für entfernte Netze wird ein geeigneter Pfad benötigt. Auf dem lokalen Link muss der nächste Kommunikationspartner erreichbar sein. Layer 4 muss Daten unterschiedlichen Kommunikationsbeziehungen zuordnen. Und die Anwendung muss schließlich verstehen, was diese Daten bedeuten.
Moderne Netzwerke ersetzen diese Grundlagen nicht. Sie automatisieren, virtualisieren und skalieren sie. Wer Layer 3 und Layer 4 versteht, lernt deshalb nicht lediglich historische Netzwerkgrundlagen. Dieses Wissen schafft ein Modell, mit dem sich auch moderne Netzwerkarchitekturen analysieren lassen – selbst wenn Router inzwischen virtuell, Netze softwaredefiniert und Anwendungen über zahlreiche Cloud-Dienste verteilt sind.
Damit sind wir an einem guten Punkt für das abschließende Fazit des gesamten Beitrags angelangt: Wir können dort den Weg vom Ethernet-Frame aus Teil 1 über IP und Transport in diesem Beitrag bis zur Anwendungsebene des dritten Teils noch einmal zusammenführen.
Wenn aus Verbindung Kommunikation wird – und Vertrauen ins Spiel kommt
Kommunikation im Netzwerk bedeutet weit mehr, als Daten lediglich von einem System zu einem anderen zu übertragen. Hinter jeder funktionierenden Verbindung steht eine Kette von Entscheidungen: Ein Ziel muss adressiert, ein lokales von einem entfernten Netz unterschieden, ein geeigneter Pfad gefunden und der Datenstrom schließlich der richtigen Anwendung zugeordnet werden.
Genau hier greifen die Schichten 3 und 4 ineinander. Die Vermittlungsschicht schafft mit IP-Adressierung, Präfixen und Routing die Grundlage dafür, dass Pakete Netzwerkgrenzen überwinden können. Die Transportschicht ergänzt diese Kommunikation um Ports, Verbindungszustände und je nach Protokoll um Mechanismen für Zuverlässigkeit, Reihenfolge, Flusskontrolle oder einen bewusst schlanken Datagrammtransport.
Dabei ist zugleich deutlich geworden, dass sich Netzwerkarchitektur nicht allein aus aktuellen Protokollen erklären lässt. Viele Mechanismen tragen ihre Geschichte bis heute mit sich. Adressklassen prägten die frühe Struktur von IPv4. Subnetting und später CIDR machten die Netzgrenze flexibler. Private Adressräume, NAT und PAT halfen dabei, einen begrenzten IPv4-Adressraum immer weiter zu nutzen. IPv6 verfolgt schließlich einen grundlegend großzügigeren Ansatz bei der Adressierung, ohne die elementaren Prinzipien von Präfixen, Routing und lokaler beziehungsweise entfernter Kommunikation aufzugeben.
Selbst vermeintliche Randthemen wie ST und die belegte Versionsnummer 5 zeigen dabei, dass die Entwicklung der Internetprotokolle nie geradlinig verlief. Unterschiedliche technische Ansätze konkurrierten miteinander, wurden weiterentwickelt oder verschwanden wieder, während ihre Fragestellungen häufig erhalten blieben.
Von der Adresse bis zur Anwendung
Der vielleicht wichtigste rote Faden dieses Beitrags liegt deshalb weniger in einem einzelnen Protokoll als in der zunehmenden Präzisierung des Kommunikationsziels. Auf Layer 2 haben wir im ersten Teil dieser Reihe betrachtet, wie Daten innerhalb eines lokalen Netzes übertragen werden. Layer 3 erweitert diesen Horizont über die Grenzen einzelner Netze hinweg. IP-Adressen und Routing sorgen dafür, dass Pakete ihr Zielsystem erreichen können.
Layer 4 geht noch einen Schritt weiter. Nun genügt es nicht mehr, den richtigen Host zu finden. Die Daten müssen dem richtigen Kommunikationsendpunkt zugeordnet werden. TCP und UDP verwenden dafür Ports und stellen Anwendungen unterschiedliche Transportmodelle bereit. TCP schafft einen zuverlässigen geordneten Bytestrom, UDP einen schlanken Datagrammtransport. Mit QUIC zeigt sich zugleich, wie moderne Protokolle diese etablierten Grundlagen neu kombinieren können.
Vereinfacht entsteht damit eine zunehmende Konkretisierung: Frame → IP-Ziel → Route → Transportendpunkt → Anwendung. Jede Ebene löst einen anderen Teil desselben Problems.
Grundlagen, die im Betrieb sichtbar werden
Gerade in der Praxis zeigt sich, warum dieses Schichtenverständnis weiterhin relevant ist. Eine Anwendung kann unerreichbar erscheinen, obwohl Routing und IP-Konnektivität vollkommen funktionieren. Eine falsche MTU kann bestimmte Übertragungen verhindern, während kleinere Pakete problemlos ihr Ziel erreichen. Eine Firewall kann einen TCP-Port blockieren, obwohl das Zielsystem erreichbar ist. Ein falsch geplanter Präfix kann Routing und Aggregation erschweren. Und eine vermeintlich einfache Webanfrage kann heute über IPv6, Anycast, mehrere Routingdomänen, UDP, QUIC und zahlreiche virtuelle Netzwerkkomponenten führen.
Moderne Netze machen die Grundlagen nicht überflüssig. Sie überlagern sie mit immer mehr Abstraktion. Cloud-Plattformen, Software Defined Networking und Container-Orchestrierung automatisieren viele Entscheidungen, die früher manuell konfiguriert wurden. Unterhalb dieser Automatisierung bleiben jedoch dieselben Fragen bestehen: Welches Ziel soll erreicht werden? Über welchen Pfad? Mit welchem Protokoll? Zu welchem Dienst? Wer diese Zusammenhänge versteht, kann deshalb auch komplexere Architekturen auf ihre grundlegenden Kommunikationsmechanismen zurückführen.
Das Schichtenmodell bleibt ein Denkmodell
Dabei sollte auch eine Grenze unserer bisherigen Betrachtung deutlich bleiben. Reale Protokollarchitekturen halten sich nicht immer sauber an die Grenzen eines Lehrbuchmodells. QUIC ist dafür ein gutes Beispiel. NAT verwendet Informationen aus Layer 3 und bei PAT zusätzlich aus Layer 4. Firewalls können Entscheidungen anhand verschiedener Schichten treffen. Moderne Proxys und Load Balancer greifen tief in Kommunikationsabläufe ein.
Das OSI-Modell verliert dadurch nicht seinen Wert. Seine Stärke liegt gerade darin, komplexe Kommunikation gedanklich zerlegen zu können. Es hilft bei Architekturentscheidungen ebenso wie bei der Fehlersuche, weil sich Probleme zunächst einer Funktion zuordnen lassen. Die entscheidende Frage lautet dann nicht mehr nur: ‘Warum funktioniert die Verbindung nicht?‘, sondern wesentlich konkreter: ‘An welcher Stelle der Kommunikationskette funktioniert sie nicht mehr?‘
Der Weg geht weiter – von Transport zu Vertrauen
Mit Layer 3 und Layer 4 haben wir den Weg von der logischen Adressierung bis zur Kommunikation zwischen Anwendungen nachvollzogen. Damit endet unsere Reise durch das Netzwerk allerdings noch nicht. Oberhalb der Transportschicht stellt sich eine neue Gruppe von Fragen. Nun geht es nicht mehr primär darum, ob Daten ein Ziel erreichen können, sondern zunehmend darum, wie Anwendungen miteinander kommunizieren und unter welchen Bedingungen wir dieser Kommunikation vertrauen können.
Wie wird aus einer aufgebauten Transportverbindung eine abgesicherte Kommunikation? Welche Rolle spielen TLS und Zertifikate? Wie werden Benutzer:innen und Systeme authentifiziert? Wie greifen DNS, Proxys und moderne Firewall-Architekturen ineinander? Und was bedeutet Vertrauen in Netzwerkarchitekturen, die längst nicht mehr durch eine klar definierte Grenze zwischen intern und extern beschrieben werden können?
Genau dort setzt der dritte Teil dieser Reihe an: Wenn Vertrauen Kontrolle braucht – Sicherheit und Management im Netzwerkalltag. Dort verschiebt sich der Blick von Vermittlung und Transport hin zu Anwendung, Identität, Verschlüsselung, Sicherheitsrichtlinien und modernen Trust-Modellen. Denn am Ende reicht es nicht aus, dass ein Paket seinen Weg findet. Entscheidend ist auch, ob die Kommunikation erlaubt ist, ob ihre Gegenstelle vertrauenswürdig ist und ob die übertragenen Informationen geschützt werden.
Quellenangaben
(Abgerufen am 31. August 2026)
Grundlagen von IP und TCP/IP
- A1 Digital: OSI and TCP/IP model: Differences explained
- Ada Computer Science: The TCP/IP stack
- Alexand Jick Neba (DEV Community): TCP/IP vs OSI: Understanding the Backbone of Networking
- Carpenter, J. Crowcroft, Y. Rekhter (IETF): RFC 2101 – IPv4 Address Behaviour Today
- GeeksforGeeks: History of TCP/IP
- IETF: About RFCs
- IETF: Introduction to the IETF
- Postel (IETF): RFC 791 – Internet Protocol
- Braden (IETF): RFC 1122 – Requirements for Internet Hosts – Communication Layers
- Bradner (IETF): RFC 2026 – The Internet Standards Process -- Revision 3
- Socolofsky, C. Kale (IETF): RFC 1180 – TCP/IP tutorial
- TCP/IP Training: The history of TCP/IP
Geschichte von ARPANET und Internet
- DARPA: ARPANET
- DARPA: TCP/IP
- Detlef Borchers, Oliver Diedrich (Heise): Vor 30 Jahren: Arpanet stellte auf TCP/IP um
- Emmanuel Nepolian (Medium): History of TCP/IP and DoD Model
- History of Computer Communications: TCP to TCP/IP 1976–1979
- Internet Society: A Short History of the Internet
- Paessler: Why ARPAnet Wasn't the Beginning: A Brief History of the Internet - Part 1
- Retail Relates: January 1, 1983 – The Modern Internet Is Born (“Flag Day”)
- Sanjay Basu (Medium): Review of A History of the ARPANET
- Stanford Computer Science: A Brief History of the Internet
Robert Kahn, Vinton Cerf und Jon Postel
- ICANNWiki: Jon Postel
- Internet Society: A Ten Year Tribute to Jon Postel: An Internet Visionary
- Janet Abbate (ACM): Robert (“Bob”) Elliot Kahn
- National Inventors Hall of Fame: Vinton G. Cerf
- Rabea Schloz, Manon Bischoff, Demian Nahuel Goos (detektor.fm): Geschichten aus der Mathematik – Vinton Cerf und die Vernetzung der Welt
- Cerf (IETF): RFC 2468 – I REMEMBER IANA
- White House Archives: Vinton Cerf and Dr. Robert Kahn: Medal of Freedom Recipients
Internet-Governance und Adressverwaltung
- ARIN: Autonomous System Numbers
- Bundesministerium für Wirtschaft: Internetprotokoll Version 6 (IPv6)
- IANA: About IANA
- IANA: IPv4 Address Space
- Joel Snyder, Konstantinos Komaitis, Andrei Robachevsky (Internet Society): The History of IANA: An Extended Timeline with Citations and Commentary
- RIPE NCC: The Internet Registry System
- RIPE NCC: Understanding IP Addressing and CIDR Charts
IPv4-Adressierung, Subnetting und CIDR
- Adem Dikkaya (Medium): IPv4 Addressing and Subnetting Fundamentals
- Computer Networking Demystified: A brief overview of IP Subnetting
- Computer Networking Demystified: A brief overview of Supernetting
- Computer Networking Demystified: An overview of the IPV4 address structure
- Computer Networking Demystified: An Overview of the IPV4 Header
- Computer Networking Demystified: What is VLSM?
- David Guyton (datahacker): Breaking Down IPv4 Address Headers
- Evreka Dev (Medium): IPv4 Addressing and Subnetting: Key Concepts and Subnet Calculations
- Huston (IETF): RFC 1744 – Observations on the Management of the Internet Address Space
- GeeksforGeeks: Introduction of Classful IP Addressing
- GeeksforGeeks: Introduction To Subnetting
- GeeksforGeeks: IPv4 Datagram Header
- GeeksforGeeks: Supernetting in Network Layer
- GeeksforGeeks: What is Internet Protocol Version 4 (Pv4)
- IP4 Market: IPv4 Subnetting Best Practices: Enterprise Scalability Guide
- IPTrading: Best Practices for Managing Your IPv4 Addresses Efficiently
- Mogul, J. Postel (IETF): RFC 950 – Internet Standard Subnetting Procedure
- Cotton, L. Vegoda (IETF): RFC 5735 – Special Use IPv4 Addresses
- Meridian Outpost: IPv4 Classes Explained: A, B, C, D, E, Private Ranges, Subnet Masks & CIDR - Quick Reference
- Monowar Mukul (Medium): Mastering CIDR: A Guide to IP Addressing and Subnetting
- Retana, R. White, V. Fuller, D. McPherson (IETF): RFC 3021 – Using 31-Bit Prefixes on IPv4 Point-to-Point Links
- Cheshire, B. Aboba, E. Guttman (IETF): RFC 3927 – Dynamic Configuration of IPv4 Link-Local Addresses
- Pummill, B. Manning (IETF): RFC 1878 – Variable Length Subnet Table For IPv4
- Fuller, T. Li (IETF): RFC 4632 – Classless Inter-domain Routing (CIDR): The Internet Address Assignment and Aggregation Plan
- Fuller, T. Li, J. Yu, K. Varadhan (IETF): RFC 1338 – Supernetting: an Address Assignment and Aggregation Strategy
- Fuller, T. Li, J. Yu, K. Varadhan (IETF): RFC 1519 – Classless Inter-Domain Routing (CIDR): an Address Assignment and Aggregation Strategy
- Vivesh Kumar Tyagi (DEV): A Beginner’s Guide to Subnetting, CIDR, Network, and Hosts
IPv4-Adressknappheit, private Adressen und NAT
- DediRock: A Brief History of IP Addresses: From IPv4 to IPv6
- Enno Rey (Insinuator): A Brief History of the IPv4 Address Space
- Excentis: The ugly side of NAT
- GeeksforGeeks: IPv4 Exhaustion in Computer Network
- Weil, V. Kuarsingh, C. Donley, C. Liljenstolpe, M. Azinger (IETF): RFC 6598 – IANA-Reserved IPv4 Prefix for Shared Address Space
- Egevang, P. Francis (IETF): RFC 1631 – The IP Network Address Translator (NAT)
- Larus Foundation: IPv1, IPv2, IPv3 to IPv4: IP Addresses' History and Evolution
- Srisuresh, K. Egevang (IETF): RFC 3022 – Traditional IP Network Address Translator (Traditional NAT)
- Paul Wilson (APNIC): IPv4 exhaustion and address transfers, and their impact on IPv6 deployment
- Prefixx: The History & Evolution of IPv4 Address space
- Remote Utilities: A Complete Overview of Network Address Translation
- Vincentas Grinius (IPXO): What Is IPv4 Address Exhaustion and How Can We Alleviate It?
- Rekhter, B. Moskowitz, D. Karrenberg, G. J. de Groot, E. Lear (IETF): RFC 1918 – Address Allocation for Private Internets
IPv6 und Übergang von IPv4
- Conta, S. Deering, M. Gupta (IETF): RFC 4443 – Internet Control Message Protocol (ICMPv6) for the Internet Protocol Version 6 (IPv6) Specification
- Thaler, R. Draves, A. Matsumoto, T. Chown (IETF): RFC 6724 – Default Address Selection for Internet Protocol Version 6 (IPv6)
- John J. Amoss, Daniel Minoli (Google Books): Handbook of IPv4 to IPv6 Transition: Methodologies for Institutional and Corporate Networks (PDF-Datei)
- Patsnap Eureka: RFC 791 vs RFC 8200: Understanding IPv4 and IPv6 specifications
- Gilligan, E. Nordmark (IETF): RFC 1933 – Transition Mechanisms for IPv6 Hosts and Routers
- Hinden, S. Deering (IETF): RFC 4291 – IP Version 6 Addressing Architecture
- Deering, R. Hinden (IETF): RFC 8200 – Internet Protocol, Version 6 (IPv6) Specification
- Thomson, T. Narten, T. Jinmei (IETF): RFC 4862 – IPv6 Stateless Address Autoconfiguration
- Chown, S. Venaas, C. Strauf (IETF): RFC 4477 – Dynamic Host Configuration Protocol (DHCP): IPv4 and IPv6 Dual-Stack Issues
- Mrugalski, M. Siodelski, B. Volz, A. Yourtchenko, M. Richardson, S. Jiang, T. Lemon, T. Winters (IETF): RFC 8415 – Dynamic Host Configuration Protocol for IPv6 (DHCPv6)
- Narten, E. Nordmark, W. Simpson, H. Soliman (IETF): RFC 4861 – Neighbor Discovery for IP version 6 (IPv6)
ST, ST2 und die Versionsnummer 5
- Topolcic (IETF): RFC 1190 – Experimental Internet Stream Protocol: Version 2 (ST-II)
- Berger, L. Delgrossi (IETF): Internet Stream Protocol V2 (st2)
- Delgrossi, L. Berger (IETF): Internet Stream Protocol Version 2 (ST2) Protocol Specification - Version ST2+
- Armstrong, A. Freier, K. Marzullo (IETF): RFC 1301 – Multicast Transport Protocol
TCP, UDP, QUIC und HTTP/3
- Beloslava Petrova (ClouDNS): QUIC Protocol Explained: What It Is and How It Works?
- GeeksforGeeks: QUIC Protocol
- Geoff Huston (APNIC): Comparing TCP and QUIC
- Iyengar, M. Thomson (IETF): RFC 9000 – QUIC: A UDP-Based Multiplexed and Secure Transport
- Postel (IETF): RFC 768 – User Datagram Protocol
- Postel (IETF): RFC 793 – Transmission Control Protocol
- Kunal Sinha (Medium): System Design Building Blocks: TCP vs UDP vs QUIC
- Bishop (IETF): RFC 9114 – HTTP/3
- Eddy (IETF): RFC 9293 – Transmission Control Protocol (TCP)
- Zimmermann, W. Eddy, L. Eggert (IETF): RFC 7805 – Moving Outdated TCP Extensions and TCP-Related Documents to Historic or Informational Status
MTU, Fragmentierung und ICMP
- Cisco: Behebung von IPv4-Fragmentierung, MTU-, MSS- und PMTUD-Problemen mit GRE und IPSec
- IANA: Internet Control Message Protocol (ICMP) Parameters
- Ivan Pepelnjak (ipSpace.net): Network Implications of PMTUD
- McCann, S. Deering, J. Mogul, R. Hinden (IETF): RFC 8201 – Path MTU Discovery for IP version 6
- Mogul, C. Kent, C. Partridge, K. McCloghrie (IETF): RFC 1063 – IP MTU discovery options
- Postel (IETF): RFC 792 – Internet Control Message Protocol
- Mathis, J. Heffner (IETF): RFC 4821 – Packetization Layer Path MTU Discovery
- Almquist, F. Kastenholz (IETF): RFC 1716 – Towards Requirements for IP Routers
Multicast und Anycast
- Cain, S. Deering, I. Kouvelas, B. Fenner, A. Thyagarajan (IETF): RFC 3376 – Internet Group Management Protocol, Version 3
- Bill Woodcock (Packet Clearing House/SANOG): Best Practices in IPv4 Anycast Routing (PDF-Datei)
- Deering (IETF): RFC 1112 – Host extensions for IP multicasting
- Fenner (IETF): RFC 2236 – Internet Group Management Protocol, Version 2
Routing, Routingprotokolle und Longest Prefix Match
- Afzal Badshah (Medium): Understanding Routing in Computer Networks: From Basics to Advanced Protocols
- Andrey Khomyakov (Medium): A Brief Tutorial on IP Routing
- Fenner (IETF): RFC 4794 – RFC 1264 Is Obsolete
- Bruno Leandro Ferreira (Cisco): Routing Protocols an Overview
- Hedrick (IETF): RFC 1058 – Routing Information Protocol
- David Stahl (Global Knowledge): Routing Protocols Overview
- Diyaagrams: TCP/IP Routing
- Malkin (IETF): RFC 2453 – RIP Version 2
- GeeksforGeeks: Classes of Routing Protocols
- GeeksforGeeks: Difference between RIP and OSPF
- GeeksforGeeks: Longest Prefix Matching in Routers
- GeeksforGeeks: What is IP Routing?
- Moy (IETF): RFC 2328 – OSPF Version 2
- Mohit Mishra (Substack): Routing Decision Process: Understanding How Packets Navigate From Host to Gateway
- Nawaz Dhandala (OneUptime): How to Understand Longest Prefix Match in Routing
- Hinden (IETF): RFC 1264 – Internet Engineering Task Force Internet Routing Protocol Standardization Criteria
- Rekhter, T. Li (IETF): RFC 1771 – A Border Gateway Protocol 4 (BGP-4)
- Rekhter, T. Li, S. Hares (IETF): RFC 4271 – A Border Gateway Protocol 4 (BGP-4)
Ergänzende technische Einordnungen
- Deutsche GigaNetz: Internet-Erfinder: Die Geschichte einer weltverändernden Technologie
- Juan Pablo Buriticá (Medium): A thorough team guide to RFCs
- Julian Schröter (FID Verlag): TCP/IP: Ein deutsches Versäumnis und die Geschichte des Internets (PDF-Datei)
- Karlo Bobiles (Cisco): Understanding IPv4 Header with Guest Blogger Gajanan Parwar
- Pranjal Ruhela (Medium): Computer Communication: Locally and Remotely
- Shohei Okada (note): ルーティングの仕組み
Weiterlesen hier im Blog
- Adresswelten im Wandel – der strukturierte Einstieg in TCP/IPv6
- ARPANET, TCP/IP und das World Wide Web – Wie das Internet die Welt vernetzte
- Externes Routing im Internet und WAN – Architektur, Historie und Bedeutung von BGP
- Warum jedes Bit seinen Weg braucht – Der Weg zur intelligenten Kommunikation
- Wenn die Computerkommunikation intelligent wird – Zukunftsarchitekturen, IPv6 und KI im modernen Netzwerkdesign
- Wenn Router Entscheidungen treffen – Routingprotokolle im Cisco-Netzwerk verstehen