‚Wir machen VMware.‘ – Warum Virtualisierung plötzlich wieder Thema ist
Seit geraumer Zeit beobachte ich in meinen Microsoft-Seminaren eine Entwicklung, mit der ich vor wenigen Jahren kaum gerechnet hätte: Das Interesse an Microsoft Hyper-V nimmt wieder spürbar zu. Nicht nur beiläufig, wenn es um einzelne Funktionen von Windows Server geht, sondern zunehmend als eigenständiges Thema. Inzwischen führe ich wieder verstärkt Seminare durch, die sich ausdrücklich mit Hyper-V und der Virtualisierung unter Windows Server beschäftigen.
Das ist bemerkenswert. Denn über viele Jahre verliefen Gespräche über Virtualisierung in meinen Schulungen häufig nach einem ähnlichen Muster. Sobald wir im Rahmen eines Windows-Server-Seminars auf Hyper-V, virtuelle Maschinen oder Hochverfügbarkeit zu sprechen kamen, winkten zahlreiche Administrator:innen ab. Die Begründung fiel meist knapp aus: ‚Wir machen VMware.‘ Damit war das Thema Hyper-V für viele Teilnehmende weitgehend erledigt.
Diese Reaktion war durchaus nachvollziehbar. VMware hatte sich in zahlreichen Unternehmensrechenzentren als etablierte Virtualisierungsplattform durchgesetzt. Viele IT-Abteilungen verfügten über langjährige Erfahrungen mit ESXi, vCenter und den dazugehörigen Managementwerkzeugen. Bestehende Betriebsprozesse, Backup-Lösungen und Hochverfügbarkeitskonzepte waren auf diese Infrastruktur abgestimmt. Warum also eine Alternative betrachten, wenn die vorhandene Plattform zuverlässig funktionierte? Heute wird diese Frage wieder häufiger gestellt – allerdings unter veränderten Vorzeichen.
Als eine Übernahme die Spielregeln veränderte
Am 22. November 2023 schloss Broadcom die Übernahme von VMware ab. Damit begann eine umfassende Neuausrichtung des Produktportfolios und der Lizenzierungsstrategie. Broadcom stellte das VMware-Geschäft stärker auf abonnementbasierte Lizenzmodelle um, reduzierte die Zahl der angebotenen Produktvarianten und bündelte wesentliche Funktionen in größeren Produktpaketen. Insbesondere VMware Cloud Foundation und VMware vSphere Foundation rückten in den Mittelpunkt der neuen Produktstrategie.
Aus Sicht des Herstellers sollte diese Neuausrichtung das Portfolio vereinfachen und die Bereitstellung integrierter Private-Cloud-Lösungen fördern. Für viele Bestandskunden bedeutete sie jedoch, bisherige Lizenzierungs- und Beschaffungsmodelle neu bewerten zu müssen. Dabei geht es nicht ausschließlich um steigende oder veränderte Lizenzkosten. Ebenso wichtig sind langfristige Vertragsbedingungen, die Planbarkeit von Infrastrukturinvestitionen und die Frage, wie stark sich ein Unternehmen von einem einzelnen Technologieanbieter abhängig machen möchte.
Die Auswirkungen reichen damit über die reine Beschaffung von Virtualisierungssoftware hinaus. Eine Virtualisierungsplattform bildet schließlich das Fundament zahlreicher geschäftskritischer Systeme. Veränderungen bei ihrer Lizenzierung oder strategischen Ausrichtung können deshalb unmittelbare Konsequenzen für den gesamten IT-Betrieb haben. Wer die wirtschaftlichen Rahmenbedingungen seiner Virtualisierungsumgebung nicht mehr als langfristig verlässlich einschätzt, beginnt zwangsläufig, über Alternativen nachzudenken.
Wenn selbst die Ausbildung betroffen ist
Besonders deutlich wurden die Auswirkungen der veränderten VMware-Lizenzpolitik im Bildungsbereich und im öffentlichen Dienst. Schulen, Berufskollegs, Hochschulen und andere Bildungseinrichtungen profitierten über Jahre von speziellen Lizenzprogrammen, die den Einsatz von VMware-Technologien zu vergünstigten Konditionen oder teilweise sogar kostenfrei ermöglichten. Damit ließen sich auch mit begrenzten Budgets leistungsfähige Virtualisierungs- und Schulungsumgebungen betreiben.
Mit der Übernahme durch Broadcom änderten sich diese Rahmenbedingungen grundlegend. Am 15. August 2024 kündigte Broadcom die Einstellung der VMware IT Academy und der damit verbundenen Academic Software Licensing Programs an. Einrichtungen, die bislang von besonderen Bildungskonditionen profitiert hatten, mussten ihre Lizenzierung neu bewerten. Je nach bisherigem Lizenzmodell konnten dadurch erhebliche zusätzliche Kosten entstehen, die insbesondere öffentliche Bildungsträger vor finanzielle Herausforderungen stellten.
Die Folgen reichten jedoch über die Lizenzkosten hinaus. Bildungseinrichtungen mussten prüfen, ob sie bestehende VMware-Infrastrukturen weiterbetreiben oder auf Alternativen wie Hyper-V und Proxmox umsteigen sollten. Auch Schulungsumgebungen waren betroffen: Die Network Development Group dokumentierte beispielsweise das Ende der VMware-IT-Academy-Labore zum August 2025.
Damit stellt sich eine grundsätzliche Frage: Welche langfristigen Auswirkungen hat die Lizenzpolitik eines Herstellers auf die Ausbildung zukünftiger Administrator:innen? Schließlich beeinflussen verfügbare Schulungsplattformen nicht nur die vermittelten Kompetenzen, sondern möglicherweise auch spätere Technologieentscheidungen. Ob daraus nachhaltige Marktverschiebungen entstehen, bleibt abzuwarten. Deutlich wird jedoch, dass Lizenzpolitik nicht allein über Kosten entscheidet, sondern auch darüber, welche Technologien zukünftige IT-Fachkräfte kennenlernen und einsetzen.
Hyper-V und Proxmox rücken wieder in den Fokus
Vor diesem Hintergrund überrascht es kaum, dass Unternehmen bestehende Alternativen erneut betrachten. Microsoft Hyper-V ist dabei keineswegs eine neue Technologie. Bereits mit Windows Server 2008 führte Microsoft seinen eigenen Hypervisor als Bestandteil des Serverbetriebssystems ein. Seitdem wurde die Plattform kontinuierlich weiterentwickelt und um Funktionen für Live Migration, Hochverfügbarkeit, Replikation und automatisierte Verwaltung ergänzt. Mit Windows Server 2025 steht weiterhin eine leistungsfähige Virtualisierungsplattform zur Verfügung, die sich insbesondere in bestehende Microsoft-Infrastrukturen integrieren lässt.
Gleichzeitig gewinnt Proxmox Virtual Environment Aufmerksamkeit. Die auf Linux, KVM und weiteren Open-Source-Technologien basierende Plattform verbindet virtuelle Maschinen, Container, Clusterverwaltung und Storage-Funktionen in einer integrierten Managementumgebung.
Allerdings wäre es zu einfach, die gegenwärtige Entwicklung ausschließlich als Wechsel von VMware zu Hyper-V oder Proxmox zu beschreiben. Auch Nutanix AHV, XCP-ng, SUSE Virtualization und weitere Plattformen bieten unterschiedliche Ansätze für den Betrieb virtualisierter Infrastrukturen. Hinzu kommen Cloud-Dienste und containerbasierte Betriebsmodelle, die klassische Virtualisierung nicht zwangsläufig ersetzen, aber ihre Einsatzmöglichkeiten verändern.
Die eigentliche Frage lautet daher nicht, welche Plattform VMware künftig ablösen wird. Vielmehr geht es darum, welche Virtualisierungsarchitektur unter den heutigen technischen, wirtschaftlichen und organisatorischen Bedingungen am besten zu den Anforderungen eines Unternehmens passt.
Virtualisierung war nie verschwunden
Interessanterweise erleben wir diese Diskussion zu einem Zeitpunkt, an dem Virtualisierung längst zu einer Selbstverständlichkeit geworden ist. Virtuelle Maschinen bilden seit Jahrzehnten die Grundlage moderner Rechenzentren. Cloud-Anbieter stellen virtuelle Ressourcen innerhalb weniger Sekunden bereit. Containerplattformen ermöglichen die automatisierte Ausführung und Skalierung von Anwendungen. Selbst viele Sicherheitsfunktionen moderner Betriebssysteme nutzen Virtualisierungstechnologien, um besonders schützenswerte Komponenten voneinander zu isolieren.
Virtualisierung ist also keineswegs eine Technologie, die zwischenzeitlich an Bedeutung verloren hätte. Was sich verändert hat, ist ihre Wahrnehmung. Während früher die Konsolidierung physischer Server im Vordergrund stand, beschäftigen sich IT-Abteilungen heute mit hybriden Infrastrukturen, Cloud-Native-Anwendungen, automatisierten Betriebsmodellen und digitaler Souveränität. Der zugrunde liegende Hypervisor verschwand dabei zunehmend aus dem Blickfeld.
Die aktuellen Entwicklungen rund um VMware führen uns jedoch vor Augen, dass diese technische Grundlage weiterhin von erheblicher Bedeutung ist. Um zu verstehen, weshalb Hyper-V plötzlich wieder intensiver diskutiert wird und warum Plattformen wie Proxmox an Aufmerksamkeit gewinnen, lohnt sich deshalb ein Blick zurück.
Denn die Geschichte der Virtualisierung beginnt nicht mit VMware, Microsoft oder der Cloud. Ihre Ursprünge reichen bis in eine Zeit zurück, in der Computer noch ganze Räume füllten und Rechenleistung eine ausgesprochen kostbare Ressource war.
Als Computer noch ganze Räume füllten: Die Ursprünge der Virtualisierung
Wer heute eine virtuelle Maschine erstellt, benötigt dafür häufig nur wenige Mausklicks oder einen PowerShell-Befehl. Prozessoren, Arbeitsspeicher, virtuelle Festplatten und Netzwerkschnittstellen lassen sich innerhalb kürzester Zeit bereitstellen. Was inzwischen selbstverständlich erscheint, beruht jedoch auf einer Idee, die wesentlich älter ist als VMware, Hyper-V oder moderne Cloud-Plattformen.
Die Geschichte der Virtualisierung beginnt in den 1960er-Jahren, als Großrechner enorme Investitionen darstellten und ihre Rechenleistung möglichst effizient genutzt werden musste. Schon damals beschäftigten sich Entwickler:innen mit einer grundlegenden Frage: Wie lässt sich ein einzelner physischer Computer so aufteilen, dass mehrere Benutzer:innen unabhängig voneinander arbeiten können? Die Antworten darauf legten den Grundstein für eine Technologie, die heute nahezu jede moderne IT-Infrastruktur prägt.
Von Großrechnern und kostbarer Rechenzeit
In den frühen Jahrzehnten der elektronischen Datenverarbeitung waren Computer große, kostspielige Anlagen, die häufig ganze Räume beanspruchten. Ihre Anschaffung, Kühlung und Wartung erforderten erhebliche finanzielle und organisatorische Ressourcen. Gleichzeitig konnten einzelne Programme die verfügbare Rechenleistung oft nicht vollständig ausnutzen. Anfangs dominierte die Stapelverarbeitung, das sogenannte Batch Processing. Programme und Daten wurden gesammelt und anschließend nacheinander abgearbeitet. Während ein Programm beispielsweise auf Ein- oder Ausgaben wartete, blieben Teile der Rechenkapazität ungenutzt.
Mit dem Time-Sharing entstand ein anderer Ansatz. Mehrere Benutzer:innen konnten über Terminals nahezu gleichzeitig mit demselben Großrechner arbeiten. Das Betriebssystem teilte ihnen dafür kurze Prozessorzeitabschnitte zu und wechselte schnell zwischen den einzelnen Aufgaben. Dadurch entstand der Eindruck, jede Person könne den Computer unmittelbar für sich nutzen. Allerdings war Time-Sharing noch nicht mit vollständiger Maschinenvirtualisierung gleichzusetzen. Die Benutzer:innen teilten sich weiterhin eine gemeinsame Betriebssystemumgebung. Die spätere Virtualisierung ging einen entscheidenden Schritt weiter: Sie ermöglichte es, auf einer physischen Maschine mehrere voneinander getrennte Computersysteme bereitzustellen.
IBM und die Entstehung virtueller Maschinen
Eine entscheidende Rolle bei der Entwicklung der Virtualisierung spielte IBM. Bereits in den 1960er-Jahren entstanden mit CP-40 und später CP-67 Systeme, die es ermöglichten, mehrere virtuelle Maschinen auf einem gemeinsamen Großrechner auszuführen. Damit verfolgte IBM einen Ansatz, der über die bisherige gemeinsame Nutzung von Rechenzeit hinausging: Ein physischer Computer konnte mehrere logisch voneinander getrennte Betriebssystemumgebungen bereitstellen.
Mit VM/370, das IBM 1972 für die System/370-Familie vorstellte, wurde dieses Konzept weiterentwickelt und als reguläres Produkt verfügbar. Die Technologie eröffnete neue Möglichkeiten, vorhandene Rechenkapazitäten wirtschaftlicher zu nutzen und unterschiedliche Systemumgebungen unabhängig voneinander zu betreiben. Besonders für die Softwareentwicklung, den Testbetrieb und interaktive Anwendungen bot dies erhebliche Vorteile.
Damit waren bereits wesentliche Grundprinzipien moderner Virtualisierungsplattformen etabliert: die Abstraktion physischer Ressourcen, die Trennung virtueller Maschinen und ihre zentrale Verwaltung. Die historische Entwicklung dokumentiert IBM in seiner Geschichte von z/VM.
Wie diese frühen virtuellen Maschinen tatsächlich funktionierten, welche Rolle das sogenannte Control Program spielte und wie Benutzer:innen innerhalb ihrer virtuellen Umgebungen arbeiteten, betrachten wir im anschließenden Exkurs genauer.
Eine Idee, die ihrer Zeit voraus war
Die Virtualisierung löste ein grundlegendes wirtschaftliches Problem: Teure Rechenleistung ließ sich mehreren voneinander unabhängigen Systemen zur Verfügung stellen. Gleichzeitig vereinfachte die Trennung zwischen physischer Hardware und virtueller Umgebung die Entwicklung, Erprobung und Verwaltung unterschiedlicher Betriebssysteme. Mit der Verbreitung von Minicomputern, Unix-Systemen und später Personal Computern veränderte sich jedoch die IT-Landschaft. Rechenleistung wurde erschwinglicher, während Unternehmen zunehmend auf dezentrale Systeme setzten. Statt einen zentralen Großrechner gemeinsam zu nutzen, betrieben sie zahlreiche eigenständige Server.
Damit rückte die klassische Maschinenvirtualisierung in vielen Bereichen zunächst aus dem Mittelpunkt der Entwicklung. Das zugrunde liegende Konzept blieb allerdings erhalten. Als sich in den 1990er-Jahren immer mehr x86-Server in den Rechenzentren ansammelten, entstand erneut ein bekanntes Problem: Zahlreiche physische Systeme verursachten hohe Kosten, obwohl ihre Ressourcen häufig nur teilweise ausgelastet waren. Die Virtualisierung bot dafür bereits eine jahrzehntealte Lösung. Allerdings musste sie zunächst an die Besonderheiten der x86-Architektur angepasst werden.
Was bedeutet Virtualisierung eigentlich?
Virtualisierung bezeichnet die Abstraktion physischer oder logischer IT-Ressourcen. Dadurch lassen sich Rechenleistung, Arbeitsspeicher, Datenträger oder Netzwerkverbindungen unabhängig von ihrer unmittelbaren technischen Grundlage bereitstellen und verwalten. Mehrere Systeme können sich dieselbe physische Infrastruktur teilen, ohne dass ihre Betriebssystemumgebungen unmittelbar voneinander abhängig sein müssen.
Bei der klassischen Servervirtualisierung übernimmt ein sogenannter Hypervisor die zentrale Rolle. Er stellt virtuellen Maschinen eine abstrahierte Hardwareumgebung zur Verfügung und koordiniert deren Zugriff auf die physischen Ressourcen. Jede virtuelle Maschine kann dadurch ein eigenes Gastbetriebssystem ausführen.
Grundsätzlich unterscheidet man zwei Hypervisor-Architekturen:
- Typ-1-Hypervisoren bilden eine Virtualisierungsschicht unmittelbar auf der physischen Hardware. Beispiele sind VMware ESXi und Microsoft Hyper-V.
- Typ-2-Hypervisoren arbeiten innerhalb eines bestehenden Hostbetriebssystems. Ein bekanntes Beispiel ist Oracle VirtualBox.
Diese Unterscheidung beschreibt vor allem den architektonischen Aufbau. Sie erlaubt jedoch keine pauschalen Rückschlüsse auf Leistung, Sicherheit oder Funktionsumfang einer Virtualisierungslösung.
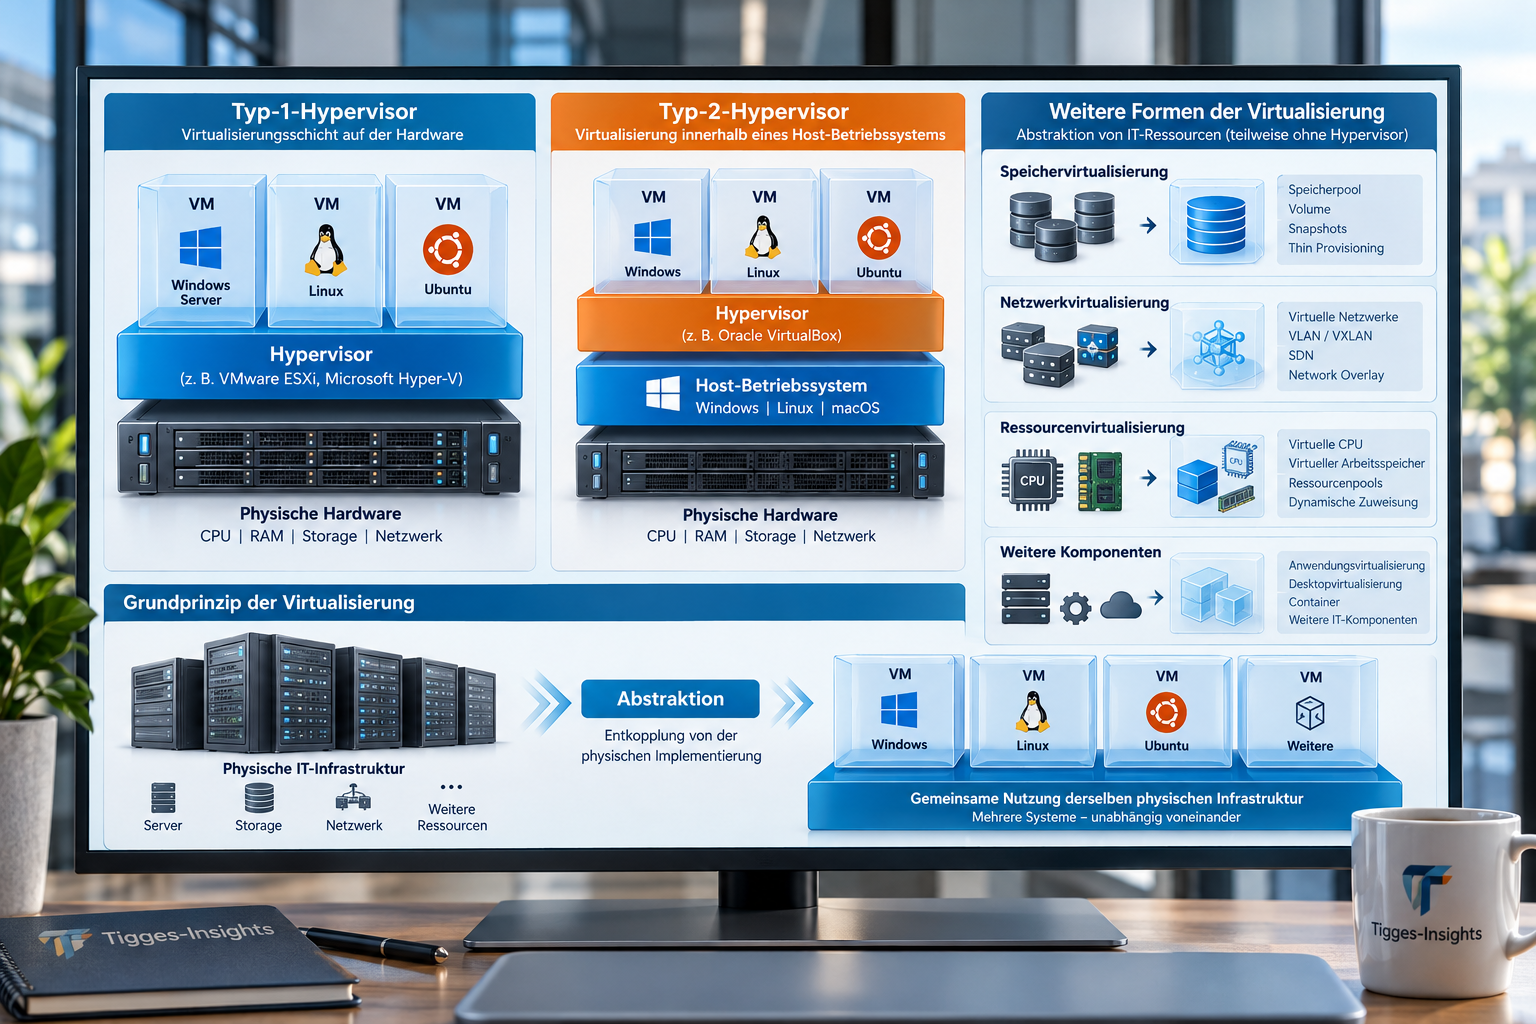
Virtualisierung beschränkt sich zudem nicht auf vollständige virtuelle Maschinen. Auch Speicherressourcen, Netzwerke und andere IT-Komponenten lassen sich abstrahieren. Dabei kommen je nach Anwendungsbereich unterschiedliche Technologien zum Einsatz, die nicht zwangsläufig einen Hypervisor benötigen. Das grundlegende Prinzip bleibt jedoch dasselbe: Die Bereitstellung und Nutzung von IT-Ressourcen wird von ihrer physischen Implementierung entkoppelt. Diese Trennung schafft die Grundlage für flexible, skalierbare und effizient verwaltbare IT-Infrastrukturen.
Von der Großrechneridee zur modernen Servervirtualisierung
Rückblickend zeigt sich, dass Virtualisierung keineswegs eine Erfindung des Cloud-Zeitalters ist. Ihre grundlegenden Konzepte entstanden bereits in einer Zeit, in der Computer außergewöhnlich kostspielig waren und eine möglichst effiziente Nutzung der verfügbaren Rechenleistung wirtschaftlich entscheidend war. Mit CP-40, CP-67 und VM/370 entwickelte IBM Technologien, deren Architekturprinzipien moderne Virtualisierungsplattformen bis heute prägen. Bemerkenswert ist dabei, wie früh zentrale Anforderungen erkannt wurden, die auch heutige Rechenzentren beschäftigen: die gemeinsame Nutzung physischer Ressourcen, die Trennung unterschiedlicher Betriebsumgebungen und die Möglichkeit, Computersysteme unabhängig von der zugrunde liegenden Hardware bereitzustellen.
Allerdings lässt sich die damalige Virtualisierung nicht ohne Weiteres mit den heute vertrauten virtuellen Maschinen auf einem Windows- oder Linux-System vergleichen. Die technischen Voraussetzungen, die Bedienung und insbesondere die Rolle des Großrechners unterschieden sich erheblich von modernen IT-Infrastrukturen. Wie sah Virtualisierung also aus, bevor es Personal Computer, grafische Betriebssysteme und die heute bekannten Hypervisoren gab? Der folgende Exkurs führt zurück in die Rechenzentren der 1960er- und 1970er-Jahre. Anhand der IBM-Großrechner betrachten wir, wie virtuelle Maschinen tatsächlich bereitgestellt wurden, welche Aufgaben das Control Program übernahm und wie Benutzer:innen innerhalb dieser Umgebungen arbeiteten.
Exkurs: Wie funktionierte Virtualisierung auf einem Großrechner?
Virtuelle Maschinen, lange bevor es PCs gab
Wer heute eine virtuelle Maschine startet, denkt häufig an eine grafische Oberfläche, über die sich ein Gastbetriebssystem installieren, konfigurieren und bedienen lässt. Ob Windows, Linux oder eine andere Plattform: Virtuelle Maschinen gehören inzwischen zum Alltag vieler Administrator:innen und lassen sich auf gewöhnlichen Computern ebenso betreiben wie in großen Rechenzentren.
In den 1960er- und 1970er-Jahren sah die Computerwelt allerdings grundlegend anders aus. Personal Computer im heutigen Sinne existierten noch nicht, grafische Benutzeroberflächen spielten praktisch keine Rolle und die verfügbare Rechenleistung konzentrierte sich auf große, kostspielige Anlagen. Dennoch konnten IBM-Großrechner bereits mehrere voneinander unabhängige Betriebssystemumgebungen gleichzeitig ausführen.
Die damalige Virtualisierung verfolgte somit ein Ziel, das bis heute aktuell geblieben ist: Die vorhandene Hardware möglichst effizient nutzen und gleichzeitig voneinander getrennte Computersysteme bereitstellen. Allerdings unterschieden sich die technische Umsetzung und die praktische Arbeit mit diesen Systemen erheblich von modernen Virtualisierungsplattformen. Wie das funktionierte, welche Aufgaben das sogenannte Control Program übernahm und wie Benutzer:innen mit ihren virtuellen Maschinen arbeiteten, zeigt ein Blick in die Großrechnerwelt jener Zeit.
Ein physischer Rechner, mehrere virtuelle Systeme
Im Mittelpunkt stand ein zentral betriebener Großrechner, an den zahlreiche Terminals angeschlossen waren. Diese dienten vor allem der Ein- und Ausgabe, während die eigentliche Datenverarbeitung auf dem Großrechner erfolgte. Das Control Program, kurz CP, bildete die Verwaltungsschicht zwischen der physischen Hardware und den virtuellen Maschinen. Es teilte Prozessorzeit zu, verwaltete Arbeitsspeicher und kontrollierte den Zugriff auf Ein- und Ausgabegeräte.
Jede virtuelle Maschine erhielt dabei eine eigene logische Sicht auf die verfügbaren Ressourcen. Sie konnte beispielsweise einen virtuellen Prozessor, einen definierten Speicherbereich und virtuelle Datenträger verwenden, obwohl sich dahinter gemeinsam genutzte physische Komponenten verbargen. Das Control Program musste sicherstellen, dass die unterschiedlichen Betriebssysteminstanzen ihre Ressourcen kontrolliert nutzten. Insbesondere privilegierte Maschinenoperationen durften nicht unkontrolliert auf die physische Hardware zugreifen.
Damit übernahm CP bereits wesentliche Aufgaben, die wir heute mit einem Hypervisor verbinden. Doch wie erlebten die damaligen Benutzer:innen diese Trennung zwischen physischer und virtueller Maschine?
Was sahen die Benutzer:innen am Terminal?
Anders als bei einer heutigen Desktopvirtualisierung erschien die virtuelle Maschine nicht als Fenster innerhalb eines anderen Betriebssystems. Stattdessen arbeiteten Benutzer:innen an Terminals, über die sie mit ihrer jeweiligen Systemumgebung kommunizierten. Dort konnten sie Befehle eingeben, Programme ausführen und Dateien bearbeiten. Eine wichtige Rolle spielte dabei das Conversational Monitor System, kurz CMS, das innerhalb einer virtuellen Maschine eine interaktive Arbeitsumgebung bereitstellte.
Die Trennung war technisch bedeutsam: Während CP die virtuellen Maschinen und ihre Ressourcen verwaltete, ermöglichte CMS die eigentliche Arbeit innerhalb einer solchen Maschine. Aus Sicht der Benutzer:innen konnte sich diese Umgebung wie ein eigenständiger Computer verhalten. Dass parallel weitere virtuelle Maschinen auf derselben physischen Anlage ausgeführt wurden, musste im Arbeitsalltag nicht unmittelbar erkennbar sein.
CMS war allerdings nur eine mögliche Betriebsumgebung. Die Virtualisierung erlaubte grundsätzlich auch die Ausführung anderer geeigneter Betriebssysteme. Gerade diese Unabhängigkeit eröffnete interessante Einsatzmöglichkeiten, insbesondere dort, wo unterschiedliche Aufgaben auf einer gemeinsamen Rechenanlage erledigt werden mussten.
Drei virtuelle Maschinen im Universitätsrechenzentrum
Ein vereinfachtes Beispiel verdeutlicht den praktischen Nutzen. Angenommen, eine Universität betreibt einen IBM-Großrechner, der gleichzeitig Verwaltungsaufgaben, wissenschaftliche Berechnungen und die Ausbildung unterstützen soll.
Das Control Program könnte dafür drei voneinander getrennte virtuelle Maschinen bereitstellen:
- Verwaltung: Eine stabile Betriebsumgebung für regelmäßig benötigte Anwendungen
- Forschung: Ein unabhängiges System für wissenschaftliche Programme und Berechnungen
- Ausbildung: Eine Testumgebung, in der Studierende Betriebssystemfunktionen untersuchen und erproben
Alle drei Systeme würden dieselbe physische Rechenanlage nutzen. Dennoch ließen sich ihre Betriebssystemumgebungen unabhängig voneinander starten, konfigurieren und verwalten. Ein Neustart der Testmaschine müsste beispielsweise nicht die Verwaltungsumgebung unterbrechen. Auch Änderungen an der Software einer virtuellen Maschine müssten nicht zwangsläufig Auswirkungen auf die anderen Systeme haben.
Das Beispiel beschreibt keine konkret dokumentierte historische Installation, sondern veranschaulicht die damaligen technischen Möglichkeiten. Es zeigt jedoch, weshalb Virtualisierung weit mehr bedeutete als die bloße gemeinsame Nutzung von Rechenzeit.
Warum diese Architektur so bedeutend war
Der entscheidende Fortschritt bestand nicht darin, mehrere Programme gleichzeitig auszuführen. Das war bereits mit dem sogenannten Time-Sharing möglich. Dabei teilte ein Betriebssystem die verfügbare Prozessorzeit in kurze Zeitabschnitte auf und wies diese abwechselnd verschiedenen Programmen beziehungsweise Benutzer:innen zu. Durch den schnellen Wechsel entstand der Eindruck, mehrere Aufgaben würden gleichzeitig bearbeitet, obwohl sie sich die Rechenleistung eines gemeinsamen Systems teilten.
Die Virtualisierung ging einen entscheidenden Schritt weiter: Sie ermöglichte es, mehrere voneinander getrennte Maschinenumgebungen auf einer gemeinsamen physischen Anlage bereitzustellen. Unterschiedliche Betriebssysteme und Konfigurationen konnten dadurch parallel existieren, ohne jeweils einen eigenen Großrechner zu benötigen. Besonders für Entwicklung, Tests und Ausbildung eröffnete dies neue Möglichkeiten. Betriebssysteme ließen sich untersuchen oder verändern, ohne dafür die gesamte physische Anlage exklusiv beanspruchen zu müssen. Gleichzeitig verbesserte die gemeinsame Ressourcennutzung die Wirtschaftlichkeit der kostspieligen Rechensysteme.
Die zentrale Architekturidee hat bis heute Bestand: Eine Virtualisierungsschicht vermittelt zwischen physischer Hardware und mehreren logisch eigenständigen Computersystemen. Eine virtuelle Maschine war somit schon damals kein zusätzlicher physischer Computer, sondern eine durch Software bereitgestellte Maschinenumgebung. Lediglich die Hardware, die Bedienung und die technischen Möglichkeiten unterschieden sich grundlegend von heutigen Systemen.
Wie präsent die Vorstellung zentral gesteuerter Computersysteme auch Anfang der 1980er-Jahre noch war, zeigt ein ungewöhnlicher Blick auf die Populärkultur. Denn selbst Hollywood griff die damalige Computerwelt auf und verwandelte ihre technischen Konzepte in eine Science-Fiction-Geschichte.
Und wieder mal Tron: Hollywood und die Großrechnerwelt
Bereits in meinem Beitrag Wie KI lernt – vom Datenpunkt zur Entscheidung habe ich die Tron-Filmreihe herangezogen, um technische Entwicklungen im Spiegel ihrer Zeit zu betrachten. Auch für die Geschichte der Virtualisierung bietet insbesondere der erste Film aus dem Jahr 1982 eine interessante Perspektive. In Tron begegnen uns Programme als eigenständige Figuren innerhalb einer digitalen Welt. Über ihnen steht das sogenannte Master Control Program, kurz MCP, das andere Programme überwacht, kontrolliert und zunehmend eigene Machtansprüche entwickelt. Die digitale Welt erscheint als hierarchisch organisiertes System, in dem Programme, Benutzer:innen und zentrale Kontrollinstanzen unterschiedliche Rollen übernehmen.
Für heutige Zuschauer:innen wirkt diese Darstellung möglicherweise abstrakt. Computer werden inzwischen vor allem über grafische Oberflächen, Apps und Cloud-Dienste wahrgenommen. Anfang der 1980er-Jahre waren zentral verwaltete Computersysteme, Terminals und die Trennung zwischen Benutzer, Programmen und Systemsteuerung dagegen wesentlich präsenter. Interessant ist insbesondere die Bezeichnung Master Control Program. Sie erinnert an die Control Programs früher IBM-Virtualisierungssysteme, die tatsächlich virtuelle Maschinen und deren Ressourcen verwalteten. Eine technische Gleichsetzung wäre allerdings falsch: Das MCP in Tron ist eine fiktionale, mit künstlicher Intelligenz ausgestattete Kontrollinstanz und kein realer Hypervisor.
Gerade dieser Unterschied macht den Film bemerkenswert. Hollywood verwandelte Konzepte zentraler Computersteuerung in eine Geschichte über Macht und Kontrolle innerhalb digitaler Systeme. Was heute wie eine fantastische Vorstellung vom Innenleben eines Computers erscheint, war 1982 zumindest in seiner Begriffswelt eng mit der damaligen Computertechnik verbunden.
Von der zentralen Rechenanlage zur dezentralen Serverwelt
Während Tron noch eine Computerwelt zeichnete, die stark von zentralen Kontrollinstanzen geprägt war, veränderte sich die tatsächliche IT-Landschaft zunehmend. Personal Computer, Unix-Systeme und später leistungsfähige x86-Server machten Rechenleistung für immer mehr Unternehmen und Einrichtungen unmittelbar verfügbar. An die Stelle weniger großer Rechenanlagen traten vielerorts zahlreiche eigenständige Systeme. Anwendungen erhielten eigene Server, Betriebssysteme liefen auf dedizierter Hardware und die IT-Infrastruktur wurde zunehmend dezentral organisiert.
Damit geriet ein grundlegender Vorteil der frühen Großrechnervirtualisierung in vielen Bereichen zunächst aus dem Blick: die Möglichkeit, mehrere unabhängige Computersysteme auf einer gemeinsamen Hardwareplattform zu betreiben.
Doch mit der wachsenden Zahl physischer Server kehrten bekannte Probleme zurück. Anschaffung, Energieversorgung, Platzbedarf und Administration verursachten steigende Kosten, während die vorhandene Rechenleistung häufig nur teilweise genutzt wurde. Die Idee der Virtualisierung war also keineswegs überholt. Sie musste lediglich für eine andere Hardwarearchitektur und eine veränderte IT-Welt neu erschlossen werden. Genau an diesem Punkt beginnt die Geschichte von VMware – und damit das nächste Kapitel der Virtualisierung.
VMware verändert die x86-Welt
Nach den frühen Erfolgen der Großrechnervirtualisierung veränderte sich die IT-Landschaft grundlegend. Mit der Verbreitung von Personal Computern, Unix-Systemen und zunehmend leistungsfähigen x86-Servern verlagerte sich die Rechenleistung von zentralen Großrechnern auf zahlreiche eigenständige Systeme. Was zunächst als Fortschritt erschien, brachte neue Herausforderungen mit sich. Immer mehr Anwendungen erhielten eigene Server, während die vorhandene Hardware häufig nur einen Bruchteil ihrer Leistungsfähigkeit ausschöpfte. Gleichzeitig stiegen die Anforderungen an Administration, Wartung und Verfügbarkeit.
Die Virtualisierung bot eine Lösung für dieses Problem. Allerdings war die x86-Architektur ursprünglich nicht darauf ausgelegt, mehrere voneinander unabhängige Betriebssysteme unter der Kontrolle eines Hypervisors auszuführen. Genau hier setzte VMware an und machte aus einer jahrzehntealten Idee eine Technologie, die den Betrieb moderner Rechenzentren nachhaltig verändern sollte.
Die Serverlandschaft wächst – und mit ihr die Probleme
In den 1990er-Jahren wurden x86-Server zunehmend leistungsfähiger und erschwinglicher. Unternehmen konnten Anwendungen auf kostengünstiger Standardhardware betreiben. Gleichzeitig wuchs die Zahl physischer Server: Datenbanken, Dateidienste und andere Unternehmenslösungen liefen häufig auf getrennten Maschinen – teilweise aus technischer Notwendigkeit, teilweise schlicht, weil man es ‚schon immer so gemacht hatte‘.
Diese Praxis hatte ihren Preis. Jeder zusätzliche Server benötigte Platz, Strom, Kühlung und Wartung. Betriebssystempflege, Sicherheitsupdates, Datensicherungen und Hardwareüberwachung erhöhten den administrativen Aufwand. Gleichzeitig blieb ein erheblicher Teil der verfügbaren Rechenleistung häufig ungenutzt. Hinzu kam eine Praxis, die mir Anfang der 2000er-Jahre in verschiedenen Unternehmen begegnete: Zur Vereinfachung der Beschaffung wurden unabhängig vom Einsatzzweck nahezu identische Server bestellt. Ob Domänencontroller, Datenbank- oder Mailserver – die Hardwareausstattung unterschied sich kaum.
Das führte zu einer bemerkenswerten Situation: Während Domänencontroller oder DHCP- und DNS-Server teilweise überdimensioniert waren, hätten Datenbank- und Mailserver zusätzlichen Arbeitsspeicher oder leistungsfähigere Speichersysteme gut gebrauchen können. Die Standardisierung vereinfachte zwar Beschaffung und Wartung, erschwerte jedoch eine bedarfsgerechte Ressourcenausstattung. Rechenleistung war vorhanden – nur nicht unbedingt dort, wo sie gebraucht wurde.
Damit kehrte eine Frage zurück, die bereits die Großrechnerentwicklung beschäftigt hatte: Wie lässt sich vorhandene Rechenleistung effizienter nutzen, ohne die Unabhängigkeit unterschiedlicher Systemumgebungen aufzugeben? Die Antwort lag erneut in der Virtualisierung. Doch zunächst musste eine grundlegende technische Hürde überwunden werden.
Warum x86-Virtualisierung zunächst schwierig war
Die frühen IBM-Großrechner verfügten über Architektureigenschaften, die eine kontrollierte Ausführung virtueller Maschinen unterstützten. Bei den verbreiteten x86-Prozessoren war die Situation komplizierter. Betriebssysteme benötigen für bestimmte Aufgaben privilegierte Prozessoroperationen. Dazu gehören beispielsweise die Verwaltung von Speicherstrukturen und die Kontrolle hardwarebezogener Funktionen. Ein Hypervisor muss solche Operationen überwachen können, damit mehrere Gastbetriebssysteme sicher auf derselben Hardware ausgeführt werden.
Bei klassischen Virtualisierungskonzepten sollen kritische Operationen abgefangen und durch die Virtualisierungsschicht kontrolliert verarbeitet werden. Frühe x86-Prozessoren erfüllten diese Voraussetzungen jedoch nicht vollständig. Bestimmte sensible Befehle verhielten sich außerhalb der höchsten Privilegierungsstufe anders, ohne dabei zuverlässig eine Ausnahme auszulösen. Dadurch ließ sich ein unverändertes x86-Betriebssystem nicht ohne Weiteres mit den klassischen Verfahren vollständig virtualisieren.
Das bedeutete allerdings nicht, dass Virtualisierung auf x86 grundsätzlich unmöglich war. Vielmehr waren zusätzliche technische Verfahren erforderlich, um die Architekturgrenzen zu überwinden. Wie VMware dieses Problem löste und weshalb spätere Prozessorerweiterungen die Entwicklung erneut veränderten, betrachten wir im anschließenden technischen Exkurs genauer.
VMware bringt virtuelle Maschinen auf den PC
VMware wurde 1998 gegründet. Das Unternehmen verfolgte das Ziel, Virtualisierung auf verbreiteter x86-Hardware praktisch nutzbar zu machen. Mit VMware Workstation erschien 1999 eine Lösung, die es ermöglichte, mehrere Betriebssysteme auf einem gewöhnlichen PC auszuführen. Virtuelle Maschinen konnten innerhalb eines vorhandenen Hostbetriebssystems gestartet werden und erhielten jeweils eine eigene, abstrahierte Hardwareumgebung. Damit eröffnete VMware neue Möglichkeiten für Softwareentwicklung, Tests und den Betrieb unterschiedlicher Betriebssysteme. Administrator:innen konnten beispielsweise eine zusätzliche Windows- oder Linux-Installation verwenden, ohne dafür einen weiteren physischen Computer bereitzustellen.
Entscheidend war jedoch nicht allein die komfortable Bedienung. VMware entwickelte technische Verfahren, mit denen sich auch Betriebssysteme virtualisieren ließen, deren Prozessorarchitektur ursprünglich keine vollständige klassische Virtualisierung unterstützte. Die praktische Bedeutung ging damit weit über eine zusätzliche Desktopanwendung hinaus. VMware demonstrierte, dass die Prinzipien der Großrechnervirtualisierung auch auf weitverbreiteter Standardhardware nutzbar waren. Der nächste Schritt führte folgerichtig vom Arbeitsplatz in das Rechenzentrum.
Von VMware Workstation zu ESX Server
Mit VMware ESX Server, der 2001 auf den Markt kam, verlagerte VMware den Schwerpunkt auf die Virtualisierung produktiver Serverinfrastrukturen. Während VMware Workstation innerhalb eines bestehenden Desktopbetriebssystems arbeitete, setzte ESX auf eine speziell für den Serverbetrieb entwickelte Virtualisierungsarchitektur. Die Plattform konnte mehrere virtuelle Maschinen auf einem physischen Server ausführen und deren Ressourcen zentral verwalten. Damit ließ sich die bis dahin verbreitete Zuordnung einer Anwendung zu einem eigenen physischen Server zunehmend auflösen. Stattdessen konnten mehrere Betriebssysteminstanzen auf derselben Hardware betrieben werden.
Die Vorteile waren erheblich: Unternehmen konnten ihre Serverbestände konsolidieren, vorhandene Ressourcen besser auslasten und neue Systemumgebungen bereitstellen, ohne jedes Mal zusätzliche Hardware beschaffen zu müssen. Allerdings bedeutete Virtualisierung nicht automatisch eine höhere Verfügbarkeit. Fiel ein physischer Host aus, waren zunächst auch die darauf betriebenen virtuellen Maschinen betroffen. Erst durch zusätzliche Management-, Cluster- und Verfügbarkeitsfunktionen entwickelte sich aus der einzelnen Virtualisierungsplattform eine umfassendere Infrastruktur für den professionellen Rechenzentrumsbetrieb.
vCenter, vMotion und der Wandel des Rechenzentrums
Die eigentliche Tragweite der Servervirtualisierung zeigte sich, als VMware die Verwaltung einzelner virtueller Maschinen zu einer umfassenden Infrastrukturplattform weiterentwickelte. Mit VirtualCenter, später vCenter Server, konnten Administrator:innen mehrere Hosts und ihre virtuellen Maschinen zentral verwalten. Dadurch wurde die Virtualisierungsumgebung zunehmend unabhängig von der Betrachtung einzelner physischer Server. Besondere Bedeutung erhielt die 2003 eingeführte Technologie vMotion. Sie ermöglichte es, laufende virtuelle Maschinen unter geeigneten Voraussetzungen zwischen physischen Hosts zu verschieben, ohne das Gastbetriebssystem regulär herunterfahren zu müssen.
Damit veränderte sich die Rolle der Hardware. Wartungsarbeiten konnten besser geplant und Arbeitslasten flexibler verteilt werden. Virtuelle Maschinen waren nicht mehr dauerhaft an einen bestimmten physischen Server gebunden. Später ergänzten Funktionen wie VMware High Availability und der Distributed Resource Scheduler die Möglichkeiten zur automatisierten Wiederherstellung beziehungsweise Verteilung von Arbeitslasten.
Aus einer Technik zur besseren Ressourcenauslastung entwickelte sich damit ein neues Betriebsmodell: Nicht mehr der einzelne physische Server stand im Mittelpunkt, sondern ein gemeinsam verwalteter Ressourcenpool. Diese Entwicklung schuf wichtige Voraussetzungen für moderne Private-Cloud-Architekturen und softwaredefinierte Rechenzentren.
Warum VMware zum Maßstab wurde
VMware profitierte nicht allein davon, früh eine funktionierende x86-Virtualisierung anzubieten. Das Unternehmen entwickelte rund um den Hypervisor ein umfangreiches Ökosystem aus Managementwerkzeugen, Automatisierungsfunktionen und Integrationen mit anderen Infrastrukturkomponenten. Damit entstand eine Plattform, die weit über das Ausführen virtueller Maschinen hinausging. Zentrale Verwaltung, Live-Migration, Hochverfügbarkeit und die flexible Verteilung von Ressourcen boten Antworten auf konkrete Herausforderungen im Rechenzentrumsbetrieb.
Genau dieser Unterschied begegnete mir über viele Jahre in meinen Windows-Server-Seminaren. Microsoft verfügte mit Hyper-V durchaus über einen leistungsfähigen Hypervisor. In den Diskussionen mit Teilnehmer:innen zeigte sich jedoch häufig, dass VMware bereits als umfassende Infrastrukturplattform etabliert war. Entscheidend war weniger die Frage, welcher Hypervisor virtuelle Maschinen ausführen konnte, sondern welche Lösung den Betrieb ganzer Rechenzentren am besten unterstützte.
Entsprechend veränderten sich auch die Anforderungen an Administrator:innen. Virtuelle Netzwerke, gemeinsame Datenspeicher, Cluster, Migrationen und Hochverfügbarkeit wurden zu festen Bestandteilen der Infrastrukturplanung. VMware entwickelte sich so für viele Unternehmen zum Maßstab professioneller Servervirtualisierung. Betriebsprozesse, technische Standards und Qualifizierungen waren häufig eng mit der Plattform verbunden. VMware verkaufte längst nicht mehr nur Virtualisierung – sondern Antworten auf die Probleme des Rechenzentrums. Doch mit diesem Erfolg entstand zugleich ein Markt, den andere Hersteller nicht dauerhaft unbeachtet lassen konnten.
Ein neuer Markt verändert die Spielregeln
Mit der zunehmenden Verbreitung virtueller Server veränderten sich auch die Erwartungen an Betriebssysteme und Rechenzentrumsplattformen. Virtualisierung wurde nicht mehr ausschließlich als zusätzliche Software betrachtet, sondern zunehmend als grundlegende Infrastrukturkomponente. Unternehmen erwarteten eine zuverlässige Integration mit ihren Betriebssystemen, Verwaltungswerkzeugen und bestehenden IT-Prozessen.
Parallel entwickelten sich die Prozessorarchitekturen weiter. Intel und AMD ergänzten ihre Produkte um Hardwarefunktionen, die den Betrieb von Hypervisoren gezielt unterstützten. Dadurch veränderten sich die technischen Voraussetzungen für die x86-Virtualisierung erneut.
Auch der Wettbewerb nahm zu. Neben VMware entstanden weitere Virtualisierungslösungen, während Microsoft die Technologie zunehmend als Bestandteil seiner eigenen Serverstrategie betrachtete. Damit begann eine neue Phase: Aus einer spezialisierten Lösung wurde eine Funktion, die Unternehmen zunehmend direkt von ihren Infrastrukturplattformen erwarteten. Für Microsoft stellte sich deshalb nicht mehr die Frage, ob Virtualisierung relevant werden würde, sondern welche Rolle Windows Server in einer zunehmend virtualisierten IT-Welt spielen sollte.
Exkurs: Warum x86-Virtualisierung zunächst so schwierig war – und wie VMware das Problem löste
Eine alte Idee trifft auf eine andere Prozessorarchitektur
Auf den ersten Blick erscheint die Entwicklung widersprüchlich: Bereits in den 1960er-Jahren konnte IBM mehrere virtuelle Maschinen auf einem Großrechner ausführen. Als VMware Ende der 1990er-Jahre dasselbe Grundprinzip auf x86-Computern umsetzen wollte, waren dafür jedoch erhebliche technische Innovationen notwendig. Der Grund lag nicht darin, dass x86-Prozessoren grundsätzlich zu langsam gewesen wären. Vielmehr unterschied sich ihre Architektur in einem entscheidenden Punkt von den Voraussetzungen, auf denen die klassische Großrechnervirtualisierung beruhte.
Ein Betriebssystem geht normalerweise davon aus, die Kontrolle über einen Computer zu besitzen. Es verwaltet den Arbeitsspeicher, steuert Hardwarezugriffe und führt privilegierte Prozessoroperationen aus. Sollen mehrere Betriebssysteme gleichzeitig auf derselben Hardware arbeiten, muss eine übergeordnete Instanz diese Zugriffe kontrollieren. Genau diese Aufgabe übernimmt der Hypervisor. Bei frühen x86-Prozessoren ließ sich die notwendige Kontrolle allerdings nicht für alle relevanten Operationen mit den klassischen Virtualisierungsverfahren zuverlässig herstellen. Das eigentliche Problem war deshalb nicht die gemeinsame Nutzung der Hardware, sondern die sichere und transparente Kontrolle mehrerer Betriebssysteme, die jeweils davon ausgingen, allein über diese Hardware zu verfügen.
Die Privilegierungsringe der x86-Architektur
Um das Problem zu verstehen, lohnt sich ein Blick auf das Schutzmodell der x86-Prozessoren. Die Architektur kennt vier sogenannte Privilege Rings, die unterschiedliche Berechtigungsstufen für die Ausführung von Programmcode definieren. Ring 0 besitzt die höchsten Privilegien, während Ring 3 für Anwendungen mit eingeschränkten Rechten vorgesehen ist.
In klassischen Betriebssystemen werden vor allem zwei dieser Stufen verwendet:
- Ring 0: Hier arbeitet der Betriebssystemkernel mit weitreichenden Berechtigungen zur Steuerung des Systems
- Ring 3: Hier laufen gewöhnliche Benutzeranwendungen mit eingeschränkten Zugriffsrechten
Ring 1 und Ring 2 sind ebenfalls Bestandteil des ursprünglichen Schutzmodells, werden von verbreiteten Betriebssystemen jedoch normalerweise nicht für eine eigenständige Anwendungsebene genutzt.
Ein Hypervisor muss nun eine zusätzliche Kontrollinstanz bereitstellen. Würde jedes Gastbetriebssystem uneingeschränkt in Ring 0 arbeiten, könnten die Betriebssysteme nicht unabhängig voneinander über dieselben physischen Ressourcen verfügen. Frühe Virtualisierungsverfahren mussten deshalb Wege finden, den Gastbetriebssystemen eine privilegierte Ausführungsumgebung bereitzustellen, ohne ihnen tatsächlich die vollständige Kontrolle über den physischen Rechner zu überlassen. Damit stellte sich eine entscheidende Frage: Wie kann ein Betriebssystem glauben, mit höchsten Privilegien zu arbeiten, während ein Hypervisor seine kritischen Operationen kontrolliert?
Trap and Emulate: Das klassische Virtualisierungsprinzip
Eine grundlegende Antwort liefert das sogenannte Trap-and-Emulate-Verfahren. Dabei führt das Gastbetriebssystem seine gewöhnlichen Anweisungen möglichst direkt auf dem Prozessor aus. Versucht es hingegen, eine privilegierte Operation auszuführen, die in seiner tatsächlichen Ausführungsumgebung nicht erlaubt ist, erzeugt der Prozessor eine Ausnahme – einen sogenannten Trap. Der Hypervisor übernimmt daraufhin die Kontrolle. Er prüft die angeforderte Operation und bildet deren Wirkung innerhalb der virtuellen Maschine nach, ohne dem Gastbetriebssystem einen unkontrollierten Zugriff auf die physische Hardware zu gestatten. Anschließend wird die Ausführung des Gastbetriebssystems fortgesetzt.
Dieses Verfahren ist besonders elegant, weil nicht jede einzelne Prozessoranweisung durch den Hypervisor interpretiert werden muss. Unkritische Operationen können unmittelbar auf der Hardware ausgeführt werden. Allerdings setzt das Konzept voraus, dass sämtliche für die Virtualisierung relevanten sensiblen Operationen zuverlässig abgefangen werden können. Genau diese Voraussetzung erfüllten die frühen x86-Prozessoren nicht vollständig.
Warum frühe x86-Prozessoren nicht klassisch virtualisierbar waren
Bereits 1974 beschrieben Gerald J. Popek und Robert P. Goldberg grundlegende Anforderungen an eine virtualisierbare Rechnerarchitektur. Ein zentraler Gedanke ihrer Arbeit lautet: Sensible Prozessoroperationen müssen unter den entsprechenden Ausführungsbedingungen kontrollierbar sein. Bei der klassischen Virtualisierung durch Trap and Emulate bedeutet dies insbesondere, dass solche Operationen beim Ausführen außerhalb der erforderlichen Privilegierungsstufe eine Ausnahme auslösen müssen.
Bei der damaligen x86-Architektur war das nicht durchgängig gewährleistet. Bestimmte sensible Anweisungen erzeugten außerhalb von Ring 0 keinen Trap, sondern verhielten sich anders oder lieferten Informationen, die Rückschlüsse auf die tatsächliche Ausführungsumgebung ermöglichten. Ein Beispiel ist die Anweisung SGDT, mit der sich Informationen über die Global Descriptor Table abfragen lassen. Solche Anweisungen konnten problematisch sein, weil ihre Ergebnisse von Zuständen der physischen Ausführungsumgebung abhingen, die eine virtuelle Maschine nicht unmittelbar erkennen sollte.
Ein Hypervisor, der ausschließlich auf klassische Ausnahmebehandlung setzte, konnte solche Situationen nicht zuverlässig kontrollieren. Daraus ergab sich eine wichtige Einschränkung: Unveränderte x86-Betriebssysteme ließen sich auf frühen Prozessoren nicht allein mit dem klassischen Trap-and-Emulate-Verfahren vollständig virtualisieren. VMware musste deshalb einen anderen Weg finden.
VMwares Lösung: Binäre Übersetzung
VMware entwickelte ein Verfahren, das als Binary Translation, also binäre Übersetzung, bekannt wurde. Die grundlegende Idee bestand darin, bestimmte Teile des auszuführenden Programmcodes zu untersuchen und problematische Anweisungsfolgen durch kontrollierbare Alternativen zu ersetzen. Dabei musste keineswegs der gesamte Programmcode einer virtuellen Maschine übersetzt werden. Gewöhnliche, unkritische Anweisungen konnten weiterhin direkt auf dem Prozessor ausgeführt werden. Insbesondere für privilegierte Codebereiche des Gastbetriebssystems kam die dynamische binäre Übersetzung zum Einsatz. Der Hypervisor konnte dadurch kritische Operationen erkennen und so umformen, dass sie innerhalb der virtualisierten Umgebung korrekt verarbeitet wurden.
Für das Gastbetriebssystem blieb dieser Vorgang weitgehend transparent. Es musste nicht speziell für den Betrieb innerhalb einer virtuellen Maschine angepasst werden. Das war ein entscheidender Vorteil gegenüber Verfahren, bei denen das Gastbetriebssystem selbst verändert werden musste. Mit VMware Workstation demonstrierte das Unternehmen ab 1999, dass sich auf diese Weise auch auf gewöhnlicher x86-Hardware mehrere Betriebssystemumgebungen betreiben ließen. VMwares eigentliche Innovation bestand damit nicht darin, die virtuelle Maschine neu zu erfinden, sondern die Architekturgrenzen der damaligen x86-Prozessoren durch eine geeignete Virtualisierungstechnik zu überwinden.
Paravirtualisierung: Ein anderer Lösungsweg
VMware war nicht das einzige Unternehmen beziehungsweise Forschungsprojekt, das sich mit den Grenzen der x86-Virtualisierung beschäftigte. Einen anderen Ansatz verfolgte unter anderem der Hypervisor Xen, dessen Entwicklung Anfang der 2000er-Jahre begann. Bei der sogenannten Paravirtualisierung weiß das Gastbetriebssystem, dass es innerhalb einer virtualisierten Umgebung arbeitet. Bestimmte privilegierte Operationen werden deshalb nicht unverändert ausgeführt, sondern durch gezielte Aufrufe an den Hypervisor ersetzt. Diese Aufrufe werden als Hypercalls bezeichnet.
Der Vorteil liegt darin, dass problematische Hardwareoperationen nicht erst während der Ausführung erkannt und übersetzt werden müssen. Das Gastbetriebssystem arbeitet an den entsprechenden Stellen bewusst mit der Virtualisierungsschicht zusammen. Allerdings erfordert dieser Ansatz Anpassungen am Gastbetriebssystem. Bei frei verfügbaren Betriebssystemen wie Linux war dies grundsätzlich leichter umzusetzen als bei proprietären Systemen, deren Kernel nicht ohne Weiteres verändert werden konnte.
Beide Verfahren verfolgten dasselbe Ziel, unterschieden sich jedoch grundlegend:
- Vollständige Virtualisierung mit binärer Übersetzung: Das Gastbetriebssystem kann weitgehend unverändert bleiben
- Paravirtualisierung: Das Gastbetriebssystem wird für die Zusammenarbeit mit dem Hypervisor angepasst
Später entwickelten sich Mischformen, bei denen beispielsweise vollständig virtualisierte Gäste paravirtualisierte Treiber für bestimmte Ein- und Ausgabeoperationen verwenden.
Intel VT-x und AMD-V: Die Hardware lernt Virtualisierung
Mitte der 2000er-Jahre veränderten Intel und AMD die technischen Voraussetzungen grundlegend. Mit Intel VT-x und AMD-V führten beide Hersteller Prozessorerweiterungen ein, die speziell für die Virtualisierung entwickelt wurden. Sie ergänzten die bisherigen Schutzmechanismen um zusätzliche Ausführungs- und Kontrollmöglichkeiten. Der Hypervisor konnte dadurch Gastbetriebssysteme mit privilegierten Prozessorfunktionen ausführen lassen, ohne ihnen die vollständige Kontrolle über den physischen Rechner zu überlassen. Bestimmte Ereignisse und Operationen konnten gezielt einen Wechsel von der Gastausführung zur Hypervisorsteuerung auslösen. Bei Intel werden diese Übergänge unter anderem als VM Exits bezeichnet.
Wichtig ist dabei eine technische Unterscheidung: Die Hardwarevirtualisierung führte nicht einfach einen zusätzlichen klassischen Privilegierungsring ein. Vielmehr entstanden neue Betriebsmodi beziehungsweise Ausführungszustände, die das vorhandene Schutzmodell ergänzten. In späteren Prozessorgenerationen kamen weitere Erweiterungen hinzu, insbesondere zur effizienteren Speicherverwaltung. Intel Extended Page Tables (EPT) und AMD Rapid Virtualization Indexing, das auf Nested Page Tables (NPT) basiert, reduzierten den Aufwand für die Übersetzung virtueller Speicheradressen.
Die Hardwareunterstützung vereinfachte damit wesentliche Aufgaben der Hypervisoren und eröffnete zusätzliche Optimierungsmöglichkeiten. Sie machte die früheren Softwareverfahren jedoch nicht schlagartig bedeutungslos. Welche Technik tatsächlich eingesetzt wurde, hing weiterhin von Prozessor, Hypervisor und jeweiliger Produktgeneration ab.
Wenn das Gastbetriebssystem seine virtuelle Umgebung erkennt
Mit der zunehmenden Verbreitung der Servervirtualisierung veränderte sich in den 2000er-Jahren auch das Zusammenspiel zwischen Hypervisor und Gastbetriebssystem. Während die frühen Virtualisierungslösungen möglichst unveränderte Betriebssysteme ausführen sollten, wurden virtuelle Umgebungen zunehmend gezielt durch Treiber und Betriebssystemfunktionen unterstützt. Ein wichtiger Ansatz bestand darin, bestimmte virtuelle Hardwarekomponenten nicht mehr ausschließlich als klassische physische Geräte nachzubilden. Stattdessen konnten Gastbetriebssysteme spezielle, für die Virtualisierung entwickelte Treiber verwenden.
Bei VMware übernahmen beispielsweise die VMware Tools entsprechende Integrationsaufgaben. Microsoft setzte bei Hyper-V auf die sogenannten Integration Services und synthetische Geräte, die über den Virtual Machine Bus (VMBus) mit der Virtualisierungsinfrastruktur kommunizieren. Solche Treiber ermöglichen insbesondere effizientere Netzwerk- und Speicherzugriffe, da aufwendige Hardwareemulation teilweise entfällt. Hinzu kommen Integrationsfunktionen wie Zeitsynchronisierung oder die koordinierte Verwaltung virtueller Maschinen.
Damit entstand eine wichtige Weiterentwicklung: Ein Gastbetriebssystem musste nicht mehr vollständig so behandelt werden, als würde es auf einem gewöhnlichen physischen Computer laufen. Es konnte seine virtualisierte Umgebung erkennen und bestimmte Funktionen gezielt nutzen. Diese Form der Zusammenarbeit wird häufig als paravirtualisierte Ein- und Ausgabe bezeichnet. Anders als bei der klassischen Paravirtualisierung war dafür jedoch nicht zwingend eine grundlegende Anpassung des gesamten Betriebssystemkernels erforderlich. Oft genügten geeignete Treiber und Integrationskomponenten.
Was diese Entwicklung für VMware und Hyper-V bedeutete
Die Weiterentwicklung der x86-Virtualisierung veränderte nicht nur die technischen Möglichkeiten, sondern auch den Wettbewerb zwischen den Anbietern. VMware hatte seine frühen Erfolge unter Bedingungen erzielt, in denen die x86-Architektur erhebliche Hürden für die Virtualisierung unveränderter Betriebssysteme aufwies. Mit ausgefeilten Softwareverfahren überwand das Unternehmen diese Grenzen und entwickelte darauf aufbauend eine umfassende Rechenzentrumsplattform.
Mit Intel VT-x und AMD-V standen zunehmend auch anderen Herstellern geeignete Hardwarefunktionen zur Verfügung. Gleichzeitig verbesserten virtualisierungsbewusste Gastbetriebssysteme, synthetische Geräte und paravirtualisierte Treiber das Zusammenspiel zwischen virtuellen Maschinen und Hypervisoren. Microsoft konnte mit Hyper-V deshalb auf einer grundlegend anderen technischen Ausgangslage aufbauen als VMware bei seinen ersten x86-Produkten. Hyper-V setzte von Beginn an auf hardwaregestützte Virtualisierung und wurde 2008 mit Windows Server 2008 eingeführt. Die Integration in das Windows-Server-Ökosystem eröffnete zusätzliche Möglichkeiten für die Zusammenarbeit zwischen Host und Gastbetriebssystem.
Allerdings bedeuteten vergleichbare technische Grundlagen keineswegs gleichwertige Infrastrukturplattformen. Zentrale Verwaltung, Hochverfügbarkeit, Live-Migration, Speicherintegration und Automatisierung blieben entscheidende Kriterien für den produktiven Rechenzentrumsbetrieb. Die technischen Voraussetzungen für Virtualisierung wurden zunehmend standardisiert. Der Unterschied zwischen einem leistungsfähigen Hypervisor und einer ausgereiften Rechenzentrumsplattform blieb jedoch bestehen. Genau hier beginnt die nächste Entwicklungsphase: Während VMware bereits über ein etabliertes Ökosystem verfügte, machte sich Microsoft daran, Hyper-V zu einem festen Bestandteil moderner Windows-Server-Infrastrukturen weiterzuentwickeln.
Microsoft Hyper-V: Vom Nachzügler zur etablierten Plattform
Während VMware die x86-Virtualisierung zunehmend zum festen Bestandteil moderner Rechenzentren machte, verfolgte Microsoft zunächst einen anderen Ansatz. Virtualisierung war bereits Bestandteil des eigenen Produktportfolios, spielte jedoch lange nicht dieselbe strategische Rolle wie bei VMware.
Das änderte sich mit Windows Server 2008. Mit Hyper-V integrierte Microsoft eine leistungsfähige Virtualisierungsplattform in sein Serverbetriebssystem und trat damit zunehmend in direkten Wettbewerb zu VMware. Der Weg dorthin war allerdings mehr als die Entwicklung eines weiteren Hypervisors. Microsoft musste eine Plattform schaffen, die sich in bestehende Windows-Infrastrukturen integrieren ließ und zugleich den steigenden Anforderungen professioneller Rechenzentren gerecht wurde.
Dass Hyper-V technisch virtuelle Maschinen ausführen konnte, stand dabei irgendwann kaum noch zur Diskussion. Entscheidend wurde vielmehr, ob Microsoft auch die betrieblichen Herausforderungen lösen konnte, für die VMware bereits etablierte Antworten bot.
Microsofts erste Schritte: Von Virtual PC zu Virtual Server
Microsofts Einstieg in die x86-Virtualisierung begann nicht mit Hyper-V. Bereits 2003 übernahm das Unternehmen Connectix und damit unter anderem die Virtualisierungstechnologie Virtual PC. Während Virtual PC vor allem für den Desktopbereich vorgesehen war, richtete sich der 2004 veröffentlichte Microsoft Virtual Server 2005 an den Betrieb virtueller Serverumgebungen.
Die Architektur unterschied sich allerdings grundlegend von der späteren Hyper-V-Plattform. Virtual Server arbeitete auf einem bestehenden Windows-Server-Betriebssystem und war damit eine gehostete Virtualisierungslösung. Der Zugriff auf wesentliche Hardwarefunktionen erfolgte über die darunterliegende Windows-Umgebung. Für Entwicklungs-, Test- und bestimmte produktive Szenarien war dies durchaus praktikabel. Im direkten Vergleich mit VMwares zunehmend ausgereifter Rechenzentrumsplattform zeigten sich jedoch architektonische und funktionale Grenzen.
Microsoft sammelte damit wichtige Erfahrungen im Virtualisierungsmarkt. Gleichzeitig wurde deutlich, dass eine langfristig konkurrenzfähige Servervirtualisierung eine andere technische Grundlage benötigte. Mit Hyper-V sollte deshalb nicht lediglich Virtual Server weiterentwickelt werden. Microsoft entschied sich für eine grundlegend neue Architektur.
Windows Server 2008: Hyper-V wird Bestandteil der Plattform
Mit Windows Server 2008 stellte Microsoft Hyper-V als neue Virtualisierungstechnologie vor. Die erste Version wurde im Juni 2008 veröffentlicht und war anschließend auch Bestandteil von Windows Server 2008 mit integriertem Hyper-V. Anders als Virtual Server basierte Hyper-V auf einer Typ-1-Hypervisorarchitektur. Der Hypervisor arbeitet unmittelbar auf der Hardware und übernimmt die grundlegende Kontrolle über die Ausführung virtueller Maschinen.
Eine Besonderheit besteht in der sogenannten Parent Partition. In dieser privilegierten Partition läuft Windows und übernimmt wesentliche Verwaltungsaufgaben sowie den Zugriff auf physische Geräte. Die Gastbetriebssysteme werden in separaten Child Partitions ausgeführt. Damit unterscheidet sich Hyper-V architektonisch von einer klassischen gehosteten Virtualisierungslösung, obwohl Administrator:innen weiterhin mit einer Windows-Server-Oberfläche arbeiten können.
Von Beginn an setzte Hyper-V auf hardwaregestützte Virtualisierung. Geeignete Prozessorfunktionen wie Intel VT-x oder AMD-V gehörten deshalb zu den technischen Voraussetzungen. Microsoft integrierte Virtualisierung damit nicht mehr lediglich als zusätzliche Anwendung, sondern als grundlegende Funktion seiner Serverplattform.
Parent Partition, VMBus und synthetische Geräte
Eine Besonderheit der Hyper-V-Architektur ist die sogenannte Parent Partition. Sie verdeutlicht, wie eng Microsoft die Virtualisierung mit seinem Windows-Server-Ökosystem verzahnte. Anders als bei einer klassischen gehosteten Virtualisierung läuft Windows dabei nicht einfach als gewöhnliches Hostbetriebssystem unterhalb des Hypervisors. Der Hypervisor bildet die grundlegende Virtualisierungsschicht, während Windows innerhalb der privilegierten Parent Partition zentrale Aufgaben für die gesamte Plattform übernimmt.
Dazu gehören insbesondere die Verwaltung virtueller Maschinen, der Zugriff auf physische Geräte und die Bereitstellung wesentlicher Ein- und Ausgabefunktionen. Statt sämtliche Gerätetreiber und Verwaltungsdienste unmittelbar im Hypervisor zu implementieren, kann Microsoft auf die bestehende Windows-Treiberarchitektur und zahlreiche Betriebssystemkomponenten zurückgreifen. Für die Kommunikation mit den virtuellen Maschinen verwendet Hyper-V den Virtual Machine Bus (VMBus). Über diesen Kommunikationskanal können Gastbetriebssysteme sogenannte synthetische Geräte nutzen. Beispielsweise kommuniziert ein synthetischer Netzwerktreiber mit den entsprechenden Diensten der Parent Partition, statt ausschließlich eine klassische physische Netzwerkkarte nachzubilden.
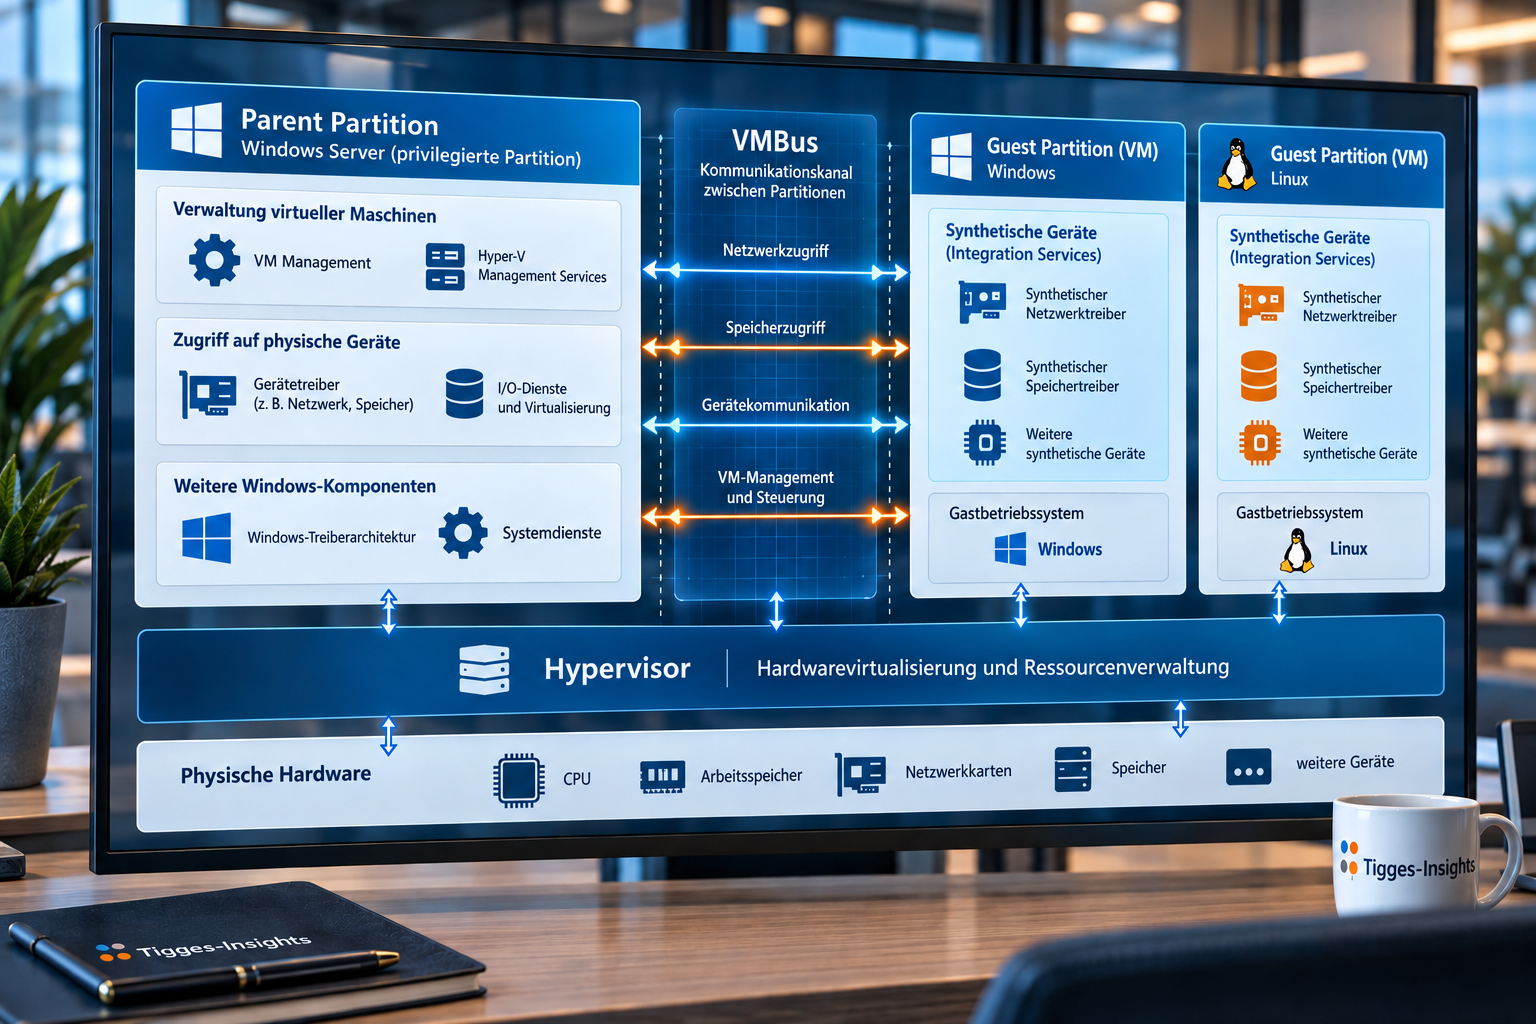
Dadurch lässt sich der Aufwand für Hardwareemulation reduzieren und die Verarbeitung von Netzwerk- und Speicherzugriffen effizienter gestalten. Die erforderlichen Integrationskomponenten wurden zunächst über die Hyper-V Integration Services bereitgestellt. Bei modernen Windows- und zahlreichen Linux-Versionen sind wesentliche Treiber bereits integriert. Die Parent Partition ist damit weit mehr als eine Verwaltungsoberfläche: Sie bildet einen zentralen Bestandteil der Hyper-V-Infrastruktur und verbindet den Hypervisor mit den etablierten Funktionen von Windows Server. Gleichzeitig entstehen daraus besondere Anforderungen an die Stabilität, Sicherheit und Wartung dieser privilegierten Umgebung. Ihre Bedeutung reicht schließlich über den Betrieb einer einzelnen virtuellen Maschine hinaus.
Vom einzelnen Host zur hochverfügbaren Infrastruktur
Ein funktionierender Hypervisor allein genügte nicht, um VMware im Rechenzentrum ernsthaft Konkurrenz zu machen. Entscheidend waren Funktionen, mit denen sich virtuelle Maschinen zuverlässig betreiben, verschieben und bei Hardwareausfällen wiederherstellen ließen. Microsoft entwickelte Hyper-V deshalb gemeinsam mit den Verwaltungs- und Clusterfunktionen von Windows Server weiter. Bereits die erste Hyper-V-Generation konnte in Verbindung mit Windows Server Failover Clustering für hochverfügbare virtuelle Maschinen eingesetzt werden. Ein wichtiger Fortschritt folgte mit Windows Server 2008 R2: Die eingeführte Live Migration ermöglichte es, laufende virtuelle Maschinen zwischen Clusterknoten zu verschieben, ohne sie regulär herunterzufahren.
Mit Windows Server 2012 wurden die Möglichkeiten erheblich erweitert. Unter anderem kamen Shared-Nothing Live Migration, Hyper-V Replica und verbesserte Funktionen zur Ressourcenverwaltung hinzu. Dadurch wurde Hyper-V zunehmend auch für komplexere Produktionsumgebungen interessant. Allerdings bedeutete eine wachsende Funktionsliste nicht automatisch, dass bestehende VMware-Infrastrukturen kurzfristig ersetzt wurden. Unternehmen mussten auch Verwaltungsprozesse, Datensicherung, Monitoring, Automatisierung und das vorhandene Fachwissen berücksichtigen. Die eigentliche Herausforderung lag deshalb zunehmend in der Integration der gesamten Infrastruktur.
System Center: Microsofts Antwort auf die zentrale Verwaltung
VMware hatte früh erkannt, dass die Verwaltung mehrerer Virtualisierungshosts und ihrer virtuellen Maschinen eine zentrale Aufgabe professioneller Rechenzentren darstellt. Microsoft begegnete dieser Anforderung insbesondere mit System Center Virtual Machine Manager, kurz SCVMM beziehungsweise VMM. Die Verwaltungsplattform ermöglichte es, Hyper-V-Hosts, Cluster, virtuelle Maschinen und zugehörige Infrastrukturressourcen zentral zu organisieren. Hinzu kamen Funktionen für Vorlagen, Bereitstellung, Netzwerkkonfiguration und Automatisierung. In Verbindung mit weiteren System-Center-Komponenten entstanden Möglichkeiten zur Überwachung und Verwaltung größerer IT-Umgebungen.
Allerdings unterschied sich Microsofts Ansatz vom VMware-Ökosystem. Während VMware zahlreiche Funktionen eng innerhalb seiner eigenen Virtualisierungsplattform bündelte, verteilten sich bei Microsoft verschiedene Aufgaben auf Windows Server, Failover Clustering, System Center und weitere Verwaltungswerkzeuge. Das war nicht grundsätzlich ein Nachteil. Für Unternehmen mit einer stark Microsoft-orientierten Infrastruktur konnten sich daraus sinnvolle Integrationsmöglichkeiten ergeben. Gleichzeitig bedeutete es jedoch, dass eine vergleichbare betriebliche Gesamtlösung nicht allein durch die Installation der Hyper-V-Rolle entstand. Hyper-V war der Hypervisor. Die professionelle Virtualisierungsplattform entstand erst durch das Zusammenspiel mehrerer Infrastrukturkomponenten.
Warum VMware trotzdem häufig die erste Wahl blieb
Trotz der technischen Fortschritte von Hyper-V blieb VMware in vielen Rechenzentren über Jahre die bevorzugte Plattform. Diese Erfahrung begegnete mir regelmäßig in Windows-Server-Seminaren. Sobald die Virtualisierung zur Sprache kam, fiel häufig der Satz: ‚Wir machen VMware.‘ Dahinter stand nicht zwangsläufig eine Ablehnung von Hyper-V. Viele Unternehmen hatten ihre Infrastruktur längst auf VMware ausgerichtet. Administrator:innen kannten die Plattform, betriebliche Abläufe waren etabliert und vorhandene Werkzeuge entsprechend integriert.
Ein wesentliches Auswahlkriterium war die unterschiedliche Produktstrategie. VMware bot ein konsequent auf Virtualisierung ausgerichtetes Portfolio, dessen Komponenten eng aufeinander abgestimmt waren. Microsoft verfolgte dagegen einen breiteren Ansatz: Hyper-V wurde durch Failover Clustering, System Center und weitere Werkzeuge ergänzt, die auch außerhalb der Virtualisierung eingesetzt wurden. Das ermöglichte eine umfassende Integration in bestehende Microsoft-Infrastrukturen, ließ die Gesamtlösung jedoch mitunter weniger geschlossen erscheinen. In meinen Seminaren entstand deshalb gelegentlich der subjektive Eindruck, Microsoft habe manche Anforderungen zwar erkannt, ihre Umsetzung aber nicht immer konsequent zu Ende gedacht.
Hinzu kam ein gewachsenes Selbstverständnis vieler Administrator:innen. In den 1990er- und frühen 2000er-Jahren galt Microsoft häufig vor allem als Betriebssystemanbieter. Für spezialisierte Aufgaben wandte man sich bevorzugt an etablierte Hersteller: Oracle für Datenbanken, Backup Exec für Datensicherungen oder McAfee für Virenschutz. Gesucht wurde gewissermaßen der Platzhirsch der jeweiligen Disziplin. Mit der zunehmenden Verbreitung von Exchange Server, SQL Server und später SharePoint veränderte sich dieses Denken schrittweise. Dennoch blieb die Vorstellung, spezialisierte Anbieter lieferten grundsätzlich die überzeugenderen Lösungen, teilweise bestehen. Gerade im Sicherheitsbereich begegnen mir solche Vorbehalte mitunter bis heute.
Vor diesem Hintergrund wird die damalige Präferenz für VMware verständlicher. Das Unternehmen stand für Virtualisierung als eigenständige Disziplin, während Microsoft Hyper-V als Bestandteil seines umfassenden Infrastrukturportfolios positionierte. VMware überzeugte damit nicht allein durch seine Technologie, sondern auch durch seine klare Positionierung als Spezialist für das virtualisierte Rechenzentrum. Diese Wahrnehmung beeinflusste viele Plattformentscheidungen – selbst dann, wenn Hyper-V die konkreten technischen Anforderungen bereits erfüllen konnte.
Exkurs: Warum Windows 10 und 11 einen Hypervisor benötigen
Ein Server-Hypervisor auf dem Desktop?
Wer sich mit Microsoft Hyper-V beschäftigt, begegnet zunächst einer scheinbar widersprüchlichen Entscheidung: Microsoft bietet die Virtualisierungsplattform nicht nur unter Windows Server an, sondern auch in bestimmten Editionen von Windows 10 und Windows 11. Dabei handelt es sich keineswegs um eine gewöhnliche Desktopvirtualisierung, bei der ein Hypervisor lediglich als Anwendung innerhalb des Betriebssystems ausgeführt wird. Auch unter Windows 10 und Windows 11 verwendet Hyper-V eine Typ-1-Architektur. Der Hypervisor bildet die grundlegende Virtualisierungsschicht, während das eigentliche Windows-System innerhalb der privilegierten Root beziehungsweise Parent Partition arbeitet.
Warum also sollte ein Desktopbetriebssystem eine Architektur verwenden, die wir zuvor als Grundlage professioneller Servervirtualisierung kennengelernt haben?
Die Antwort liegt in den unterschiedlichen Einsatzmöglichkeiten. Virtualisierung dient längst nicht mehr ausschließlich dazu, mehrere produktive Server auf einer gemeinsamen Hardwareplattform zu betreiben. Sie ermöglicht ebenso die Bereitstellung kontrollierter Testumgebungen, die Isolation von Anwendungen und den Schutz besonders sensibler Betriebssystemkomponenten. Gerade bei Windows 10 und Windows 11 zeigt sich, wie aus einer ursprünglich für die Serverkonsolidierung bekannten Technologie ein grundlegender Bestandteil moderner Desktoparchitekturen wurde.
Virtuelle Maschinen als Entwicklungs- und Testumgebung
Ein naheliegender Einsatzzweck von Hyper-V auf dem Desktop ist die Bereitstellung zusätzlicher Betriebssystemumgebungen. Administrator:innen und Entwickler:innen können virtuelle Maschinen erstellen, um beispielsweise Softwareinstallationen, Gruppenrichtlinien, Netzwerkkonfigurationen oder neue Betriebssystemversionen zu testen. Der wesentliche Vorteil besteht in der Trennung vom eigentlichen Arbeitsplatzsystem. Fehlerhafte Konfigurationen oder problematische Softwareinstallationen bleiben grundsätzlich auf die jeweilige virtuelle Umgebung begrenzt, sofern keine zusätzlichen Verbindungen oder gemeinsam genutzten Ressourcen diese Trennung aufheben.
Besonders hilfreich sind dabei sogenannte Checkpoints. Sie ermöglichen es, bestimmte Zustände einer virtuellen Maschine festzuhalten und später zu einem solchen Zustand zurückzukehren. Damit lassen sich Konfigurationsänderungen wiederholt untersuchen, ohne das Gastbetriebssystem jedes Mal vollständig neu installieren zu müssen. Allerdings ersetzen Checkpoints keine reguläre Datensicherung. Sie sind vor allem für kurzfristige Wiederherstellungsszenarien und Tests vorgesehen. Für eine dauerhafte Sicherung müssen geeignete Backupverfahren eingesetzt werden. Eine virtuelle Maschine ist damit nicht nur ein zusätzlicher Computer, sondern auch eine kontrollierbare und reproduzierbare Arbeitsumgebung.
Virtuelle Maschinen sichern, wiederherstellen und übertragen
Die Möglichkeit, virtuelle Maschinen als weitgehend abgeschlossene Systemumgebungen zu behandeln, eröffnet weitere praktische Einsatzmöglichkeiten. Eine virtuelle Maschine besteht aus einer Konfiguration, virtuellen Datenträgern und gegebenenfalls zusätzlichen Zustandsdateien. Dadurch lassen sich vollständige Systemumgebungen wesentlich einfacher kopieren, archivieren oder auf andere geeignete Hosts übertragen als klassische physische Installationen. Hyper-V unterstützt dafür unter anderem den Export und Import virtueller Maschinen. Administrator:innen können beispielsweise eine vorbereitete Testumgebung exportieren und später erneut bereitstellen.
Auch das Zurücksetzen auf einen definierten Ausgangszustand ist für Schulungen und technische Experimente interessant. Unterschiedliche Konfigurationen lassen sich vergleichen, ohne dass jede Änderung dauerhaft übernommen werden muss. Für meine Seminare ist genau dieser Aspekt besonders relevant: Komplexe Windows-Server-Szenarien können in mehreren virtuellen Maschinen nachgebildet werden, obwohl den Teilnehmer nur ein einzelner physischer Computer zur Verfügung steht. Dabei können Domänencontroller, Mitgliedsserver und Clients innerhalb einer gemeinsamen virtuellen Laborumgebung miteinander kommunizieren. Die Virtualisierung ersetzt in diesem Fall kein produktives Rechenzentrum. Sie macht dessen technische Zusammenhänge auf einem gewöhnlichen Arbeitsplatzrechner nachvollziehbar.
Virtualization-Based Security: Wenn Windows sich selbst virtualisiert
Die strategisch vielleicht wichtigste Bedeutung der Hyper-V-Technologie auf dem Desktop liegt jedoch in der Sicherheit. Mit Virtualization-Based Security (VBS) nutzt Windows hardwaregestützte Virtualisierung, um besonders schützenswerte Funktionen vom gewöhnlichen Betriebssystembetrieb zu isolieren. Dafür wird eine zusätzliche, geschützte Ausführungsumgebung geschaffen, die durch den Hypervisor von der normalen Windows-Umgebung getrennt wird. Diese Architektur kann beispielsweise dazu beitragen, bestimmte sicherheitskritische Daten und Prozesse auch dann besser zu schützen, wenn Angreifer weitreichende Berechtigungen innerhalb des normalen Betriebssystems erlangen.
Ein bekanntes Beispiel ist Credential Guard. Die Funktion verwendet virtualisierungsbasierte Isolation, um ausgewählte Anmeldeinformationen vor unberechtigtem Zugriff zu schützen. Auch Hypervisor-Protected Code Integrity (HVCI), in Windows häufig im Zusammenhang mit der Funktion Speicherintegrität genannt, nutzt Virtualisierung, um die Durchsetzung von Integritätsanforderungen für Kernelcode zusätzlich abzusichern. Dabei ist eine wichtige Unterscheidung erforderlich: VBS benötigt Virtualisierungstechnologie, aber nicht zwingend die aktivierte Hyper-V-Verwaltungsfunktion für virtuelle Maschinen. Ein Windows-System kann somit den Microsoft-Hypervisor für Sicherheitsfunktionen verwenden, obwohl Administrator:innen dort keine gewöhnlichen Hyper-V-Gastmaschinen betreiben.
Windows Sandbox: Eine isolierte Umgebung auf Abruf
Eine weitere praktische Anwendung ist die Windows Sandbox. Sie stellt eine temporäre, isolierte Windows-Umgebung bereit, in der sich beispielsweise unbekannte Programme oder Konfigurationen untersuchen lassen. Im Gegensatz zu einer dauerhaft eingerichteten virtuellen Maschine muss dafür nicht zunächst ein vollständiges Gastbetriebssystem manuell installiert und verwaltet werden. Windows stellt die erforderliche Umgebung weitgehend automatisiert bereit. Nach dem Schließen der Sandbox wird ihr temporärer Zustand verworfen. Bei einem erneuten Start steht wieder eine frische Umgebung zur Verfügung.
Technisch nutzt die Windows Sandbox hardwaregestützte Virtualisierung und Hyper-V-basierte Isolationsmechanismen. Sie eignet sich damit besonders für kurzfristige Tests, ersetzt allerdings keine umfassende Malwareanalyse oder speziell abgesicherte Untersuchungsumgebung. Je nach Konfiguration können beispielsweise Netzwerkverbindungen oder andere Integrationsfunktionen zusätzliche Risiken eröffnen. Das Prinzip ist dennoch bemerkenswert: Virtualisierung wird hier nicht eingesetzt, um einen weiteren dauerhaft betriebenen Computer bereitzustellen, sondern um eine kurzlebige, kontrollierte Ausführungsumgebung zu schaffen.
WSL 2 und die Virtualisierung von Linux unter Windows
Auch das Windows Subsystem for Linux zeigt, wie Microsoft Virtualisierung auf dem Desktop für andere Zwecke nutzt. Während WSL 1 Linux-Systemaufrufe über eine Kompatibilitätsschicht umsetzte, verwendet WSL 2 einen echten Linux-Kernel innerhalb einer leichtgewichtigen virtuellen Umgebung. Die zugrunde liegende Virtualisierung wird dabei weitgehend automatisch verwaltet. Benutzer:innen müssen normalerweise weder eine klassische virtuelle Maschine konfigurieren noch einen vollständigen Linux-Desktop installieren.
Dennoch basiert die Architektur auf Virtualisierungstechnologien, die auch Hyper-V zugrunde liegen. WSL 2 verdeutlicht damit einen weiteren Entwicklungsschritt: Virtuelle Maschinen können so eng in das Hostbetriebssystem integriert werden, dass ihre technische Existenz für die alltägliche Nutzung kaum noch sichtbar ist. Gleichzeitig ist WSL 2 keine gewöhnliche Hyper-V-VM, die über den Hyper-V-Manager wie eine frei konfigurierte Servermaschine verwaltet wird. Die Virtualisierung bleibt Bestandteil der Architektur, während ihre Verwaltung zunehmend von der eigentlichen Anwendung abstrahiert wird.
Warum der Desktop trotzdem kein Rechenzentrum ist
Die technische Grundlage von Hyper-V unter Windows 10 und Windows 11 ähnelt derjenigen unter Windows Server. Daraus folgt jedoch nicht, dass beide Plattformen denselben Einsatzzweck verfolgen. Desktopbetriebssysteme sind auf interaktive Arbeitsplätze ausgelegt. Windows Server bietet dagegen zusätzliche Funktionen, Betriebsmodelle und Integrationsmöglichkeiten für den dauerhaften Einsatz in professionellen Infrastrukturen. Dazu gehören beispielsweise die Einbindung in hochverfügbare Cluster, umfangreiche Verwaltungsfunktionen und die Unterstützung entsprechender Serverworkloads.
Hinzu kommen Unterschiede bei Lizenzierung, Produktunterstützung und verfügbaren Funktionen. Auch die Verfügbarkeit der Hyper-V-Verwaltungsfunktion hängt von der jeweiligen Windows-Edition ab. Unter Windows 10 und Windows 11 steht sie insbesondere in den Editionen Pro, Enterprise und Education zur Verfügung. Die zugrunde liegenden Virtualisierungsfunktionen können jedoch auch für andere Windows-Komponenten relevant sein.
Die Frage lautet deshalb nicht, ob ein Desktopcomputer technisch virtuelle Server ausführen kann. Das ist unter geeigneten Voraussetzungen durchaus möglich. Entscheidend ist vielmehr, welche Anforderungen an Verfügbarkeit, Verwaltung, Sicherheit und langfristigen Betrieb gestellt werden.
Virtualisierung wird zur Betriebssystemfunktion
Die Entwicklung von Hyper-V auf Windows-Desktops zeigt, wie weit sich die Bedeutung der Virtualisierung inzwischen verändert hat. Ursprünglich stand die wirtschaftliche Nutzung physischer Rechenleistung im Mittelpunkt. Später kamen die flexible Bereitstellung von Servern, die Migration virtueller Maschinen und die zentrale Verwaltung ganzer Rechenzentren hinzu. Auf modernen Desktopbetriebssystemen erfüllt Virtualisierung weitere Aufgaben: Sie ermöglicht reproduzierbare Testumgebungen, unterstützt die Ausführung anderer Betriebssysteme und schützt ausgewählte sicherheitskritische Komponenten.
Damit ist der Hypervisor nicht mehr ausschließlich eine Technologie, die Administrator:innen bewusst für den Betrieb virtueller Maschinen einsetzen. Er kann vielmehr Bestandteil der Betriebssystemarchitektur sein, ohne dass Benutzer:innen unmittelbar mit ihm arbeiten. Windows 10 und Windows 11 besitzen Hyper-V-Unterstützung also nicht nur, damit sich virtuelle Maschinen auf dem Desktop betreiben lassen. Die zugrunde liegende Virtualisierungstechnologie hilft Windows zunehmend auch dabei, seine eigenen Funktionen sicherer und flexibler bereitzustellen. Dieser Gedanke führt unmittelbar zur nächsten Entwicklung: In der Cloud bleibt Virtualisierung ebenfalls eine grundlegende Technologie – verschwindet jedoch zunehmend aus dem direkten Blickfeld derjenigen, die ihre Ressourcen nutzen.
Die Cloud: Virtualisierung wird unsichtbar
Lange Zeit war Servervirtualisierung eine Aufgabe, die unmittelbar im eigenen Rechenzentrum stattfand. Unternehmen beschafften physische Server, installierten Hypervisoren, konfigurierten Netzwerke und Datenspeicher und verwalteten ihre virtuellen Maschinen mit Werkzeugen wie VMware vCenter oder Microsoft System Center. Mit dem Aufstieg des Cloud-Computings veränderte sich dieses Betriebsmodell grundlegend. Virtuelle Maschinen konnten nun bereitgestellt werden, ohne zuvor eigene Hardware beschaffen oder einen Hypervisor installieren zu müssen. Die Verantwortung für die zugrunde liegende Infrastruktur verlagerte sich zunehmend auf den Cloudanbieter.
Was aus Sicht der Benutzer:innen wie eine neue Technologie erschien, beruhte jedoch weiterhin auf den bekannten Prinzipien der Virtualisierung. Neu waren vor allem die Bereitstellung, die Verwaltung und die wirtschaftlichen Modelle, nach denen Rechenleistung genutzt werden konnte. Wie sich diese Entwicklung in das umfassendere Konzept moderner Cloudplattformen einordnet, erläutere ich in meinem Beitrag Azure-Grundlagen: Architekturprinzipien, Identität, Governance und Best Practices für moderne Cloud-Umgebungen. Dort stehen insbesondere die Architektur und die grundlegenden Verwaltungsprinzipien von Microsoft Azure im Mittelpunkt. Die Cloud machte Virtualisierung nicht überflüssig. Sie machte ihre technische Umsetzung für viele Benutzer:innen schlicht unsichtbar.
Von der virtuellen Maschine zur Infrastruktur als Dienst
Die klassische Servervirtualisierung ermöglichte es, mehrere Betriebssysteme auf einem physischen Server auszuführen. Die Verantwortung für Hardware, Hypervisor, Datenspeicher und Netzwerk blieb jedoch beim jeweiligen Unternehmen. Mit Infrastructure as a Service (IaaS) veränderte sich diese Aufgabenverteilung. Cloudanbieter stellen virtualisierte Rechenleistung, Speicher und Netzwerkressourcen als abrufbare Dienste bereit. Unternehmen können virtuelle Maschinen konfigurieren und starten, ohne die zugrunde liegende physische Infrastruktur selbst betreiben zu müssen.
Mit Amazon EC2, das 2006 zunächst als Betaversion verfügbar wurde, etablierte sich ein frühes kommerzielles Beispiel für dieses Modell. Microsoft entwickelte später mit Azure ebenfalls eine umfassende Cloudplattform für virtuelle Maschinen und weitere Infrastrukturdienste. Der entscheidende Unterschied lag dabei weniger in der virtuellen Maschine selbst als in ihrer Bereitstellung. Statt Hardware zu beschaffen, konnte Rechenleistung bedarfsgerecht angefordert werden. Virtualisierung wurde damit von einer lokal betriebenen Infrastrukturtechnologie zu einer flexibel konsumierbaren Dienstleistung.
Der Hypervisor verschwindet aus dem Blickfeld
In einem klassischen Rechenzentrum beschäftigen sich Administrator:innen unmittelbar mit den Eigenschaften ihrer Virtualisierungsplattform. Sie verwalten Hosts, konfigurieren virtuelle Switches, planen Cluster und überwachen die verfügbaren Ressourcen. Bei einer virtuellen Maschine in Microsoft Azure oder Amazon EC2 sieht die Situation anders aus. Die Benutzer:innen wählen beispielsweise eine geeignete Maschinenklasse, ein Betriebssystemimage, die gewünschte Speicherkapazität und eine Netzwerkkonfiguration. Die Cloudplattform übernimmt anschließend die Bereitstellung auf der zugrunde liegenden Infrastruktur. Welche konkreten physischen Server verwendet werden und wie deren Ressourcen intern organisiert sind, bleibt weitgehend verborgen.
Das bedeutet allerdings nicht, dass der Hypervisor an Bedeutung verliert. Im Gegenteil: Die zuverlässige Trennung unterschiedlicher Kundenumgebungen, die Ressourcenverteilung und die sichere Ausführung virtueller Maschinen sind grundlegende Voraussetzungen für den Betrieb großer Cloudplattformen. Der Hypervisor ist damit weiterhin vorhanden, gehört jedoch nicht mehr zwangsläufig zu den Komponenten, mit denen sich die Kundschaft unmittelbar beschäftigen muss. Die Virtualisierungsschicht verschwindet nicht aus der Architektur, sondern aus der alltäglichen Administration.
Microsoft Azure: Hyper-V-Technologie im Hintergrund
Gerade bei Microsoft lässt sich diese Entwicklung besonders gut nachvollziehen. Während Hyper-V im lokalen Rechenzentrum als Bestandteil von Windows Server bereitgestellt wird, verwendet Microsoft für seine Azure-Infrastruktur ebenfalls Hyper-V-basierte Virtualisierungstechnologien, die für den Betrieb großer Cloudumgebungen weiterentwickelt wurden. Die technische Grundlage ist damit verwandt, das Betriebsmodell unterscheidet sich jedoch erheblich. In einer lokalen Hyper-V-Umgebung verwalten Administrator:innen die Virtualisierungshosts, deren Betriebssysteme und die zugehörigen Infrastrukturkomponenten selbst. In Azure übernimmt Microsoft diese Aufgaben für die zugrunde liegende Plattform. Die Kundschaft verwaltet stattdessen die bereitgestellten Ressourcen über das Azure-Portal, Programmierschnittstellen oder Automatisierungswerkzeuge.
Diese Trennung ist ein wesentliches Merkmal des Cloudmodells. Die Verantwortung für die physische Infrastruktur und die Virtualisierungsplattform liegt beim Anbieter, während die Verantwortung für das Gastbetriebssystem und die darauf betriebenen Anwendungen bei klassischen IaaS-Angeboten weitgehend bei der Kundschaft verbleibt. Damit wurde Hyper-V auch jenseits lokal installierter Windows-Server zu einer wichtigen technologischen Grundlage innerhalb des Microsoft-Ökosystems.
Von der Serververwaltung zur Ressourcenverwaltung
Mit der Cloud veränderte sich nicht nur der Standort virtueller Maschinen, sondern auch die Art ihrer Verwaltung. Im klassischen Rechenzentrum orientierten sich viele Aufgaben an einzelnen Servern, Virtualisierungshosts und Clustern. Cloudplattformen stellen dagegen abstrakte Ressourcen bereit, die über zentrale Verwaltungsdienste organisiert werden. Virtuelle Maschinen, Netzwerke, Datenträger und Sicherheitsregeln lassen sich dadurch zunehmend automatisiert bereitstellen.
Ein wichtiger Bestandteil dieser Entwicklung ist Infrastructure as Code (IaC). Dabei werden Infrastrukturkonfigurationen in deklarativen Vorlagen oder Programmen beschrieben, statt ausschließlich über grafische Verwaltungsoberflächen eingerichtet zu werden. In Microsoft Azure können beispielsweise Azure Resource Manager, Bicep oder Terraform für die automatisierte Bereitstellung entsprechender Ressourcen verwendet werden.
Damit verändert sich die Rolle der Administrator:innen. Neben Betriebssystemen, Netzwerken und Virtualisierung werden Kenntnisse über Automatisierung, Identitätsverwaltung, Berechtigungen und cloudbasierte Verwaltungsmodelle immer wichtiger. Die einzelne virtuelle Maschine bleibt relevant. Ihre Bereitstellung wird jedoch zunehmend Bestandteil automatisierter Infrastrukturprozesse.
Skalierung: Wenn Ressourcen nicht mehr dauerhaft bereitstehen müssen
Eine weitere Veränderung betrifft die wirtschaftliche Nutzung von Rechenleistung. Im eigenen Rechenzentrum muss Hardware normalerweise für einen bestimmten Zeitraum beschafft und vorgehalten werden. Auch wenn einzelne Server nur selten vollständig ausgelastet sind, entstehen weiterhin Kosten für Anschaffung, Betrieb und Wartung. Cloudplattformen ermöglichen dagegen eine flexiblere Bereitstellung von Ressourcen. Virtuelle Maschinen können bei Bedarf gestartet, verändert oder wieder entfernt werden. Je nach Dienst lassen sich zusätzliche Instanzen auch automatisiert bereitstellen.
Das eröffnet neue Möglichkeiten, insbesondere für Anwendungen mit schwankendem Ressourcenbedarf. Allerdings bedeutet Cloudnutzung nicht automatisch geringere Kosten. Dauerhaft betriebene virtuelle Maschinen, überdimensionierte Ressourcen oder ungeeignete Speicherkonfigurationen können erhebliche Ausgaben verursachen.
Damit kehrt eine Fragestellung zurück, die uns bereits bei der historischen Serverkonsolidierung begegnet ist: Wie viel Rechenleistung wird tatsächlich benötigt, und wie lässt sie sich möglichst effizient bereitstellen? Die Cloud verändert die Möglichkeiten zur Beantwortung dieser Frage. Sie nimmt Unternehmen die Verantwortung für eine wirtschaftlich sinnvolle Ressourcenplanung jedoch nicht ab.
Die Grenzen verschwimmen: Hybrid Cloud und Azure Local
Nicht jede Anwendung kann oder soll vollständig in einer öffentlichen Cloud betrieben werden. Technische Anforderungen, Datenschutz, Latenz, bestehende Investitionen oder organisatorische Vorgaben können dafür sprechen, bestimmte Systeme weiterhin lokal auszuführen. Daraus entstanden hybride Infrastrukturmodelle, in denen lokale Rechenzentren und öffentliche Cloudplattformen miteinander verbunden werden. Microsoft verfolgt diesen Ansatz unter anderem mit Azure Arc und Azure Local. Während Azure Arc Verwaltungs- und Governancefunktionen auf unterschiedliche Infrastrukturumgebungen ausdehnt, bringt Azure Local Azure-orientierte Infrastruktur- und Verwaltungsmodelle in kundeneigene Umgebungen.
Dabei bleibt eine wichtige Unterscheidung bestehen: Eine lokal betriebene Hyper-V-Umgebung wird nicht allein durch ihre Verbindung zu Azure zu einer öffentlichen Cloud. Verantwortlichkeiten, Betriebsmodelle und verfügbare Funktionen unterscheiden sich weiterhin. Dennoch zeigt diese Entwicklung, dass die frühere Trennung zwischen lokaler Virtualisierung und Cloudinfrastruktur zunehmend an Bedeutung verliert. Die entscheidende Frage lautet immer seltener, ob eine virtuelle Maschine lokal oder in der Cloud betrieben wird. Wichtiger wird, wie sich unterschiedliche Betriebsumgebungen gemeinsam verwalten, absichern und automatisieren lassen.
Virtualisierung bleibt – aber nicht jede Anwendung braucht eine virtuelle Maschine
Mit der Cloud entstand schließlich eine weitere Entwicklung: Unternehmen mussten nicht mehr zwangsläufig vollständige virtuelle Maschinen bereitstellen, um Anwendungen auszuführen. Neben IaaS gewannen Platform as a Service (PaaS) und Software as a Service (SaaS) an Bedeutung. Bei diesen Modellen übernimmt der Cloudanbieter zusätzliche Aufgaben, beispielsweise die Verwaltung von Laufzeitumgebungen, Datenbankplattformen oder vollständigen Anwendungen.
Damit verschiebt sich die Verantwortung erneut. Während bei IaaS weiterhin Betriebssysteme verwaltet werden müssen, konzentriert sich die Administration bei höher abstrahierten Diensten stärker auf Anwendungen, Daten, Konfigurationen und Zugriffsrechte. Virtualisierung bleibt dabei häufig ein Bestandteil der technischen Grundlage. Sie ist jedoch nicht mehr zwangsläufig die Ebene, auf der Benutzer:innen ihre Anwendungen bereitstellen.
Besonders deutlich wird diese Entwicklung bei Containern. Sie stellen keine vollständigen virtuellen Computer im klassischen Sinne bereit, sondern isolierte Ausführungsumgebungen, die sich einen Betriebssystemkernel teilen. Damit verfolgen sie einen anderen Ansatz als die bisher betrachtete Servervirtualisierung. Während virtuelle Maschinen die Hardware abstrahieren, abstrahieren Container vor allem die Ausführungsumgebung einer Anwendung. Damit beginnt die nächste Phase unserer Betrachtung: Docker, Kubernetes und die Frage, welche Rolle klassische virtuelle Maschinen in einer zunehmend containerisierten IT-Welt noch spielen.
Docker, Kubernetes und die Zukunft virtueller Maschinen
Über Jahrzehnte war die virtuelle Maschine eine der wichtigsten Antworten auf die Frage, wie sich IT-Ressourcen effizienter nutzen lassen. Statt für jede Anwendung einen eigenen physischen Server bereitzustellen, konnten mehrere Betriebssysteme auf einer gemeinsamen Hardwareplattform ausgeführt werden. Mit der Cloud wurde dieses Prinzip weiterentwickelt: Virtuelle Maschinen ließen sich nun als Dienst bereitstellen, ohne die zugrunde liegende Infrastruktur selbst betreiben zu müssen. Doch auch virtuelle Maschinen bringen einen gewissen Aufwand mit sich. Jede Instanz benötigt ein eigenes Gastbetriebssystem, das gestartet, konfiguriert, aktualisiert und abgesichert werden muss. Für umfangreiche Serveranwendungen ist das häufig sinnvoll. Bei kleineren, modular aufgebauten Anwendungen kann dieser Ansatz jedoch unnötig aufwendig sein.
Mit Containern entstand deshalb ein ergänzendes Betriebsmodell. Statt vollständige Computersysteme bereitzustellen, werden Anwendungen gemeinsam mit ihren benötigten Abhängigkeiten in voneinander isolierten Umgebungen ausgeführt. Die zentrale Veränderung besteht darin, dass nicht mehr zwangsläufig ein vollständiges Betriebssystem virtualisiert werden muss, um eine Anwendung unabhängig bereitzustellen.
Container sind keine Erfindung von Docker
Obwohl Container heute häufig unmittelbar mit Docker verbunden werden, reichen die technischen Grundlagen deutlich weiter zurück. Bereits frühe Unix-Systeme verfügten über Mechanismen, mit denen sich Prozesse in ihrer Sicht auf das Dateisystem einschränken ließen. Ein bekanntes Beispiel ist chroot, das seit den frühen 1980er-Jahren in Unix-Systemen verwendet wird. Eine vollständige Containerisolation bot dieser Mechanismus allerdings nicht.
Später entstanden umfassendere Konzepte. FreeBSD Jails ermöglichten ab dem Jahr 2000 eine stärkere Trennung von Prozessumgebungen. Solaris Zones erweiterten ab 2005 die Möglichkeiten zur Betriebssystemvirtualisierung. Unter Linux entwickelten sich mit Namespaces und Control Groups, kurz cgroups, schließlich die wesentlichen Grundlagen moderner Linux-Container. Namespaces ermöglichen es, bestimmten Prozessen eine eigene Sicht auf Systemressourcen zu geben. Dazu gehören beispielsweise Prozesskennungen, Netzwerkumgebungen oder Mountpunkte. Control Groups begrenzen und überwachen dagegen die Nutzung von Ressourcen wie Prozessorzeit und Arbeitsspeicher.
Der entscheidende Unterschied zur klassischen Maschinenvirtualisierung liegt im gemeinsam verwendeten Betriebssystemkernel. Während virtuelle Maschinen jeweils einen eigenen Kernel ausführen können, nutzen gewöhnliche Linux-Container den Kernel ihres Linux-Hosts. Dadurch entfällt ein erheblicher Teil des Aufwands, der beim Betrieb vollständiger Gastbetriebssysteme entsteht.
Docker: Anwendungen werden transportierbar
Mit Docker, das 2013 öffentlich vorgestellt wurde, gelangte die Containertechnologie zu einem wesentlich breiteren Nutzer:innenkreis. Die eigentliche Innovation bestand dabei nicht darin, Prozesse erstmals voneinander zu isolieren. Docker vereinfachte vielmehr die Erstellung, Verpackung, Verteilung und Ausführung containerisierter Anwendungen. Im Mittelpunkt steht das sogenannte Container Image. Es beschreibt die für eine Anwendung benötigten Dateien, Bibliotheken und Laufzeitkomponenten. Aus einem solchen Image können anschließend Container gestartet werden.
Entwickler:innen können beispielsweise eine Anwendung einschließlich ihrer benötigten Laufzeitumgebung in einem Image bereitstellen. Dieses Image lässt sich anschließend auf anderen geeigneten Containerhosts verwenden, ohne die einzelnen Softwarekomponenten dort erneut manuell installieren zu müssen. Damit reduziert sich ein Problem, das viele IT-Abteilungen seit Jahrzehnten kennen: Eine Anwendung funktioniert auf dem Entwicklungsrechner, verhält sich in der Testumgebung jedoch anders und verursacht schließlich im Produktivbetrieb unerwartete Schwierigkeiten. Container beseitigen solche Unterschiede nicht vollständig. Sie schaffen jedoch eine wesentlich einheitlichere Grundlage für die Bereitstellung von Anwendungen. Docker machte Container damit nicht nur technisch nutzbar, sondern vor allem zu einem praktikablen Werkzeug für moderne Softwareentwicklung und Anwendungsbereitstellung.
Virtuelle Maschinen und Container: Zwei unterschiedliche Abstraktionsebenen
Auf den ersten Blick verfolgen virtuelle Maschinen und Container ähnliche Ziele. Beide ermöglichen es, unterschiedliche Arbeitslasten voneinander zu trennen und gemeinsam vorhandene Ressourcen zu nutzen. Die technische Umsetzung unterscheidet sich jedoch grundlegend. Bei der klassischen Servervirtualisierung stellt ein Hypervisor jeder virtuellen Maschine eine abstrahierte Hardwareumgebung zur Verfügung. Innerhalb dieser Umgebung arbeitet ein eigenes Gastbetriebssystem mit eigenem Kernel.
Container isolieren dagegen Prozesse innerhalb einer gemeinsamen Betriebssystemumgebung. Sie benötigen deshalb normalerweise keinen vollständigen zusätzlichen Kernel für jede einzelne Anwendung.
Daraus ergeben sich unterschiedliche Eigenschaften:
- Virtuelle Maschinen bieten eine weitreichende Trennung vollständiger Betriebssystemumgebungen und ermöglichen beispielsweise den parallelen Betrieb unterschiedlicher Betriebssysteme auf geeigneter Hardware.
- Container benötigen häufig weniger Ressourcen und lassen sich in vielen Szenarien schneller starten, teilen sich jedoch wesentliche Eigenschaften und Sicherheitsgrenzen des Hostkernels.
- Virtuelle Maschinen eignen sich besonders für vollständige Serverumgebungen, bestehende Unternehmensanwendungen und Workloads mit Anforderungen an eine stärkere Betriebssystemisolation.
- Container sind insbesondere für modular aufgebaute Anwendungen interessant, deren Komponenten unabhängig entwickelt, bereitgestellt und skaliert werden sollen.
Allerdings darf daraus keine pauschale Bewertung entstehen. Container sind nicht grundsätzlich unsicher, und virtuelle Maschinen sind nicht automatisch die wirtschaftlichere oder leistungsfähigere Lösung. Entscheidend sind die jeweiligen Anforderungen an Isolation, Betriebssystemunterstützung, Ressourcenverbrauch und Verwaltung.
Wenn aus einzelnen Containern ganze Anwendungslandschaften werden
Mit der zunehmenden Verbreitung von Containern entstand eine neue Herausforderung. Ein einzelner Container lässt sich vergleichsweise einfach starten und verwalten. Moderne Anwendungen bestehen jedoch häufig aus zahlreichen Komponenten, die miteinander kommunizieren und unterschiedliche Aufgaben übernehmen. Eine Webanwendung kann beispielsweise aus einem Frontend, mehreren Backenddiensten, einer Nachrichtenverarbeitung und weiteren unterstützenden Komponenten bestehen. Jede dieser Komponenten lässt sich unabhängig in einem oder mehreren Containern betreiben.
Damit entstehen neue Anforderungen: Container müssen auf geeignete Hosts verteilt, bei Fehlern neu gestartet und bei steigender Auslastung vervielfältigt werden. Gleichzeitig benötigen die Anwendungen zuverlässige Netzwerkverbindungen, Konfigurationsdaten und gegebenenfalls dauerhaften Speicher. Die Verwaltung einzelner Container reicht dafür nicht mehr aus. Es wird eine übergeordnete Plattform benötigt, die den gewünschten Zustand einer Anwendungsumgebung kennt und versucht, diesen Zustand fortlaufend herzustellen. Genau an dieser Stelle beginnt die Bedeutung der Containerorchestrierung.
Docker Swarm: Die Orchestrierung aus dem eigenen Ökosystem
Auch Docker erkannte früh, dass die einfache Bereitstellung einzelner Container allein nicht ausreichen würde, um umfangreiche Anwendungslandschaften zuverlässig zu betreiben. Mit Docker Swarm entstand deshalb eine eigene Lösung zur Verwaltung mehrerer Docker-Hosts. Das ursprüngliche Swarm-Projekt wurde 2014 vorgestellt. Mit Docker 1.12 integrierte das Unternehmen 2016 einen weiterentwickelten Orchestrierungsmodus unmittelbar in die Docker Engine, den sogenannten Swarm Mode.
Die Grundidee war vergleichsweise einfach: Mehrere Docker-Hosts sollten sich zu einem gemeinsamen Cluster zusammenschließen lassen, dessen Ressourcen zentral verwaltet werden konnten. Dazu unterscheidet Swarm zwischen Manager Nodes, die den Zustand des Clusters verwalten und Aufgaben verteilen, und Worker Nodes, auf denen die eigentlichen Container ausgeführt werden. Anwendungen werden dabei als Services definiert. Für jeden Service lässt sich unter anderem festlegen, wie viele Instanzen ausgeführt werden sollen. Swarm verteilt diese Instanzen auf geeignete Hosts und versucht, den gewünschten Zustand aufrechtzuerhalten. Fällt beispielsweise ein Container aus, kann Swarm einen Ersatz bereitstellen. Auch die Verteilung von Netzwerkverbindungen, die Kommunikation zwischen Services und die schrittweise Aktualisierung von Anwendungen werden unterstützt.
Ein wesentlicher Vorteil bestand in der engen Integration in das bestehende Docker-Ökosystem. Administrator:innen konnten vertraute Werkzeuge und Konzepte weiterverwenden, ohne zunächst eine umfangreiche zusätzliche Plattform aufbauen zu müssen. Docker Swarm machte die Containerorchestrierung damit vergleichsweise einfach zugänglich und bot insbesondere für überschaubare Cluster eine praktikable Lösung.
Warum sich Kubernetes dennoch durchsetzte
Parallel zu Docker Swarm entwickelte sich mit Kubernetes eine weitere Orchestrierungsplattform, die 2014 von Google als Open-Source-Projekt vorgestellt wurde. Beide Lösungen verfolgten grundsätzlich ähnliche Ziele: Container sollten automatisiert bereitgestellt, über mehrere Hosts verteilt und im laufenden Betrieb verwaltet werden. Die Unterschiede lagen vor allem in der Architektur, im Funktionsumfang und in der Entwicklung des jeweiligen Ökosystems.
Während Docker Swarm bewusst auf eine vergleichsweise einfache Bedienung und enge Integration in Docker setzte, entwickelte Kubernetes ein umfassenderes, deklaratives Plattformmodell mit zahlreichen Möglichkeiten zur Erweiterung und Integration. Hinzu kam die Unterstützung durch eine wachsende Zahl von Unternehmen, Cloudanbietern und Open-Source-Projekten. Mit der Cloud Native Computing Foundation (CNCF), der Kubernetes 2015 als Gründungsprojekt übergeben wurde, entstand zudem eine herstellerübergreifende organisatorische Grundlage für seine Weiterentwicklung. Im Laufe der folgenden Jahre orientierten sich deshalb immer mehr Unternehmen, Softwarehersteller und Teile der Entwicklercommunity an Kubernetes.
Auch Docker selbst reagierte auf diese Entwicklung und integrierte Kubernetes zeitweise als zusätzliche Orchestrierungsoption in Docker Desktop und Docker Enterprise. Damit wurde deutlich, dass sich die beiden Technologien nicht mehr ausschließlich als konkurrierende Lösungen betrachten ließen. Langfristig setzte sich Kubernetes als führende Plattform für die Orchestrierung containerisierter Anwendungen durch. Docker Swarm blieb weiterhin nutzbar, erreichte jedoch nicht dieselbe Verbreitung und Ökosystemunterstützung.
Das bedeutet keineswegs, dass Swarm für jeden Einsatzzweck die schlechtere Wahl wäre. Gerade bei kleineren oder weniger komplexen Umgebungen kann seine überschaubare Architektur weiterhin Vorteile bieten. Die Entwicklung verdeutlicht vielmehr ein Muster, das uns bereits aus der Geschichte der klassischen Virtualisierung bekannt ist: Nicht allein die technische Leistungsfähigkeit entscheidet über den Erfolg einer Plattform. Ebenso wichtig sind ihre Verbreitung, die Unterstützung durch Hersteller und die langfristige Entwicklung des Ökosystems. Mit Kubernetes entstand auf dieser Grundlage schließlich eine Orchestrierungsplattform, die weit über die Verwaltung einzelner Container hinausgeht und zu einem zentralen Bestandteil moderner Cloud- und Rechenzentrumsarchitekturen wurde.
Kubernetes: Vom Container zur orchestrierten Plattform
Dass sich Kubernetes langfristig gegenüber Docker Swarm und anderen Orchestrierungslösungen durchsetzen konnte, lag nicht allein an seinem Funktionsumfang. Entscheidend war vielmehr ein Architekturansatz, der die Verwaltung containerisierter Anwendungen grundlegend veränderte. Während Administrator:innen bei klassischen Infrastrukturen häufig einzelne Server konfigurieren, Dienste starten und deren Betrieb überwachen, verfolgt Kubernetes ein deklaratives Betriebsmodell. Statt jeden notwendigen Arbeitsschritt unmittelbar vorzugeben, wird beschrieben, welchen Zustand eine Anwendung erreichen und dauerhaft beibehalten soll.
Die Plattform übernimmt anschließend die Aufgabe, den tatsächlichen Zustand mit diesem gewünschten Zustand abzugleichen und erforderliche Änderungen vorzunehmen. Kubernetes verwaltet damit nicht einfach einzelne Container. Es stellt eine Plattform bereit, die den gewünschten Betriebszustand containerisierter Anwendungen kontinuierlich herzustellen versucht.
Control Plane und Worker Nodes: Die Architektur eines Kubernetes-Clusters
Technisch besteht ein Kubernetes-Cluster aus einer Control Plane und den sogenannten Worker Nodes. Die Control Plane bildet die zentrale Steuerungsebene. Sie stellt unter anderem die Kubernetes-API bereit, verwaltet Informationen über den Clusterzustand und entscheidet, auf welchen Nodes neue Arbeitslasten ausgeführt werden sollen.
Zu ihren wesentlichen Komponenten gehören:
- kube-apiserver: Stellt die zentrale Schnittstelle für die Verwaltung und Kommunikation innerhalb des Clusters bereit
- etcd: Speichert die Konfigurationsdaten und den gewünschten beziehungsweise erfassten Zustand des Clusters
- kube-scheduler: Entscheidet anhand verfügbarer Ressourcen und definierter Anforderungen, auf welchen geeigneten Nodes neue Pods ausgeführt werden
- kube-controller-manager: Führt verschiedene Controller aus, die den tatsächlichen Zustand des Clusters mit dem gewünschten Zustand abgleichen
Die Worker Nodes übernehmen dagegen die eigentliche Ausführung der Anwendungen. Dazu verwenden sie eine geeignete Containerlaufzeitumgebung, beispielsweise containerd. Auf jedem Worker Node arbeitet außerdem ein kubelet, das mit der Control Plane kommuniziert und die Ausführung der zugewiesenen Pods überwacht. Diese Trennung zwischen Steuerung und Ausführung erinnert in gewisser Weise an die Architektur etablierter Virtualisierungsplattformen. Auch dort werden zentrale Verwaltungsfunktionen von den Systemen getrennt, die letztlich die virtuellen Maschinen ausführen. Allerdings unterscheiden sich die verwalteten Ressourcen und die jeweiligen Betriebsmodelle erheblich.
Pods: Die kleinste verwaltbare Ausführungseinheit
Eine zentrale Besonderheit von Kubernetes ist die Verwendung sogenannter Pods. Während Docker zunächst den einzelnen Container in den Mittelpunkt stellt, arbeitet Kubernetes auf der Ebene von Pods. Ein Pod umfasst einen oder mehrere eng zusammengehörige Container, die gemeinsam bereitgestellt und verwaltet werden. Die Container innerhalb eines Pods teilen sich unter anderem einen Netzwerk-Namespace und können über definierte Volumes gemeinsam auf Daten zugreifen.
Dadurch lassen sich beispielsweise eine eigentliche Anwendung und ein unterstützender Container innerhalb derselben Ausführungseinheit betreiben. In vielen Fällen enthält ein Pod allerdings lediglich einen einzelnen Anwendungscontainer. Wichtig ist die Unterscheidung zwischen Pod und Container: Ein Pod ist keine zusätzliche virtuelle Maschine und auch kein eigenständiges Gastbetriebssystem. Er beschreibt vielmehr eine gemeinsame Ausführungsumgebung für die ihm zugeordneten Container.
Pods sind zudem grundsätzlich als austauschbare Ressourcen konzipiert. Fällt ein Pod aus oder muss er auf einem anderen Node bereitgestellt werden, wird typischerweise ein neuer Pod erzeugt, anstatt die ursprüngliche Instanz dauerhaft zu reparieren. Damit unterscheidet sich das Betriebsmodell deutlich von klassischen Serverumgebungen, in denen einzelne Maschinen häufig über Jahre hinweg als feste Systeme verwaltet werden.
Deployments: Wenn der gewünschte Zustand wichtiger wird als die einzelne Instanz
Besonders anschaulich wird das deklarative Prinzip bei sogenannten Deployments. Ein Deployment beschreibt unter anderem, welche Anwendung ausgeführt werden soll, welches Container-Image verwendet wird und wie viele Replikate dauerhaft verfügbar sein sollen.
Nehmen wir beispielsweise eine Webanwendung, die mit drei Replikaten betrieben werden soll. In einer klassischen Serverumgebung würden Administrator:innen zunächst geeignete Systeme bereitstellen, die Anwendung installieren und anschließend sicherstellen, dass alle drei Instanzen zuverlässig arbeiten. Bei Kubernetes wird stattdessen der gewünschte Zustand definiert: Drei Replikate der Anwendung sollen ausgeführt werden. Die zuständigen Controller sorgen anschließend dafür, dass entsprechende Pods bereitgestellt werden. Fällt einer dieser Pods aus, versucht Kubernetes, durch die Erstellung eines Ersatzes wieder die gewünschte Anzahl zu erreichen.
Auch Aktualisierungen lassen sich über dieses Modell steuern. Bei einem Rolling Update können neue Anwendungsinstanzen schrittweise bereitgestellt werden, während bisherige Instanzen kontrolliert außer Betrieb gehen. Damit lassen sich viele wiederkehrende Verwaltungsaufgaben automatisieren. Allerdings bedeutet diese Automatisierung nicht, dass Kubernetes automatisch die Funktionsfähigkeit einer gesamten Anwendung garantieren kann. Fehlerhafte Konfigurationen, nicht verfügbare Abhängigkeiten oder Probleme mit persistenten Daten müssen weiterhin berücksichtigt werden.
Services, Skalierung und die Abstraktion der Infrastruktur
Da Pods im laufenden Betrieb ersetzt oder auf anderen Nodes bereitgestellt werden können, benötigen Anwendungen eine Möglichkeit, miteinander zu kommunizieren, ohne von den Netzwerkadressen einzelner Pods abhängig zu sein. Dafür verwendet Kubernetes unter anderem sogenannte Services. Ein Service stellt einen stabilen logischen Zugriffspunkt für eine Gruppe geeigneter Pods bereit. Die Zuordnung erfolgt typischerweise über Labels und Selektoren. Dadurch können beispielsweise mehrere Instanzen eines Backenddienstes unter einer gemeinsamen Serviceadresse angesprochen werden, obwohl sich die zugrunde liegenden Pods im Laufe der Zeit verändern.
Hinzu kommen Möglichkeiten zur automatisierten Skalierung. Mit einem Horizontal Pod Autoscaler lässt sich beispielsweise die Anzahl der Pod-Replikate anhand geeigneter Metriken anpassen. Die tatsächliche Skalierung bleibt dabei von den verfügbaren Ressourcen des Clusters abhängig. Zusätzliche Pods benötigen schließlich geeignete Nodes mit ausreichender Rechenleistung und Arbeitsspeicher. Gerade an dieser Stelle wird die Verbindung zur klassischen Virtualisierung deutlich. Kubernetes kann die Anzahl benötigter Anwendungsinstanzen verändern. Die darunterliegende Infrastruktur muss jedoch weiterhin die erforderlichen Ressourcen bereitstellen. Werden die Worker Nodes als virtuelle Maschinen betrieben, entsteht dadurch eine weitere Ebene der Ressourcenverwaltung: Während Kubernetes die Anwendungen organisiert, stellt die Virtualisierungsplattform die benötigten Betriebssystemumgebungen zur Verfügung.
Eine Plattform mit eigenen Anforderungen
Die Möglichkeiten von Kubernetes sind umfangreich. Gleichzeitig bringt die Plattform eine Komplexität mit sich, die bei der Bewertung nicht unterschätzt werden sollte. Bereits die grundlegende Architektur umfasst mehrere miteinander kommunizierende Komponenten. Hinzu kommen Anforderungen an Netzwerkkonfiguration, Zugriffskontrolle, Zertifikatsverwaltung, Monitoring, Datenspeicherung und die Aktualisierung des Clusters.
Auch die Absicherung der Container selbst bleibt notwendig. Kubernetes ersetzt weder eine durchdachte Sicherheitsarchitektur noch die Pflege der verwendeten Container-Images und Betriebssysteme. Für kleinere Anwendungen oder überschaubare Infrastrukturen kann deshalb eine einfachere Orchestrierungslösung wie Docker Swarm weiterhin ausreichend sein.
Kubernetes entfaltet seine Stärken insbesondere dort, wo zahlreiche Anwendungen und Teams eine gemeinsame, automatisierbare Plattform benötigen und die organisatorischen Voraussetzungen für deren Betrieb vorhanden sind. Dass sich Kubernetes als dominierendes Orchestrierungsmodell etablierte, bedeutet deshalb nicht, dass jede containerisierte Anwendung zwingend Kubernetes benötigt. Seine eigentliche Bedeutung liegt darin, dass Kubernetes die Verwaltung von Anwendungen weitgehend von einzelnen Serverinstanzen entkoppelt und damit eine zusätzliche Abstraktionsebene zwischen Anwendung und Infrastruktur schafft. Diese Abstraktion verändert jedoch nichts an einer grundlegenden Voraussetzung: Auch ein Kubernetes-Cluster benötigt Rechenleistung, Arbeitsspeicher, Netzwerkverbindungen und Datenspeicher. Und genau hier begegnen wir erneut den klassischen Virtualisierungsplattformen, mit denen unsere Betrachtung begonnen hat.
Kubernetes ersetzt keinen Hypervisor
Mit der zunehmenden Verbreitung von Kubernetes entstand gelegentlich der Eindruck, klassische Virtualisierungsplattformen könnten langfristig an Bedeutung verlieren. Schließlich übernimmt Kubernetes zahlreiche Aufgaben, die auf den ersten Blick an die Verwaltung virtueller Maschinen erinnern: Anwendungen werden auf verfügbare Systeme verteilt, ihre Ausführung wird überwacht und ausgefallene Instanzen können automatisch ersetzt werden. Doch dieser Vergleich greift zu kurz. Kubernetes und klassische Hypervisoren arbeiten auf unterschiedlichen technischen Ebenen und lösen damit unterschiedliche Probleme.
Während VMware ESXi, Microsoft Hyper-V oder KVM die Ausführung vollständiger Betriebssystemumgebungen auf gemeinsamer Hardware ermöglichen, organisiert Kubernetes die Bereitstellung und den Betrieb containerisierter Anwendungen. Die eine Technologie abstrahiert primär die Hardware, die andere die Ausführung von Anwendungen. Gerade deshalb werden beide Ansätze in modernen Infrastrukturen häufig miteinander kombiniert.
Kubernetes auf virtuellen Maschinen: Zwei Abstraktionsebenen arbeiten zusammen
Betrachten wir ein Unternehmen, das bereits eine umfangreiche VMware- oder Hyper-V-Infrastruktur betreibt. Die vorhandenen Hosts stellen Rechenleistung, Arbeitsspeicher, Netzwerkverbindungen und Datenspeicher für zahlreiche virtuelle Server bereit. Soll nun eine Kubernetes-Plattform eingeführt werden, müssen dafür nicht zwangsläufig zusätzliche physische Server beschafft werden. Stattdessen lassen sich geeignete virtuelle Maschinen bereitstellen, auf denen beispielsweise Linux als Gastbetriebssystem ausgeführt wird. Diese Maschinen übernehmen anschließend die Rolle der Kubernetes-Nodes. Innerhalb der virtuellen Maschinen stellt eine Containerlaufzeitumgebung wie containerd die erforderlichen Funktionen zur Ausführung der Container bereit. Kubernetes organisiert darüber die Pods und die zugehörigen Anwendungsressourcen.
So entsteht eine mehrschichtige Architektur:
- Physische Infrastruktur: Stellt Prozessoren, Arbeitsspeicher, Netzwerkverbindungen und Datenspeicher bereit
- Hypervisor: Abstrahiert die physische Hardware und ermöglicht den Betrieb mehrerer voneinander isolierter virtueller Maschinen
- Gastbetriebssystem: Stellt die Kernel- und Betriebssystemfunktionen für die Containerlaufzeitumgebung bereit
- Containerlaufzeitumgebung: Übernimmt die technische Ausführung und Verwaltung der Container auf dem jeweiligen Node
- Kubernetes: Koordiniert die Bereitstellung, Verteilung und Überwachung der containerisierten Anwendungen über die Nodes hinweg
Jede Ebene übernimmt damit eine klar abgegrenzte Aufgabe. Ein Kubernetes-Deployment kann beispielsweise festlegen, dass eine Anwendung mit fünf Replikaten betrieben werden soll. Kubernetes verteilt die zugehörigen Pods auf geeignete Nodes, soweit ausreichende Ressourcen vorhanden sind. Die Virtualisierungsplattform wiederum stellt die virtuellen Maschinen bereit, auf denen diese Nodes ausgeführt werden. Sie verwaltet deren virtuelle Hardware, Ressourcenreservierungen und gegebenenfalls die Verfügbarkeit der zugrunde liegenden Hosts. Kubernetes entscheidet somit, wo Anwendungen ausgeführt werden sollen. Der Hypervisor stellt die dafür benötigten virtuellen Betriebssystemumgebungen bereit.
Warum Unternehmen beide Technologien kombinieren
Die Kombination aus Kubernetes und klassischen virtuellen Maschinen bietet insbesondere für bestehende Rechenzentren praktische Vorteile. Viele Unternehmen verfügen bereits über etablierte Virtualisierungsplattformen mit zentraler Verwaltung, definierten Sicherheitskonzepten und automatisierten Bereitstellungsprozessen. Werden Kubernetes-Nodes als virtuelle Maschinen betrieben, können diese vorhandenen Strukturen weitergenutzt werden. So lassen sich beispielsweise neue Nodes aus vorbereiteten Betriebssystem-Images bereitstellen, Ressourcen flexibel zuweisen und virtuelle Maschinen auf geeignete physische Hosts verteilen.
Auch die Trennung unterschiedlicher Umgebungen kann von dieser Architektur profitieren. Entwicklungs-, Test- und Produktionscluster lassen sich auf getrennten virtuellen Maschinen betreiben, ohne für jede Umgebung zwangsläufig eigene physische Server bereitstellen zu müssen. Darüber hinaus können Virtualisierungsplattformen Funktionen wie Hochverfügbarkeit, Hostwartung und die Migration laufender virtueller Maschinen bereitstellen. Allerdings müssen diese Funktionen mit den Mechanismen von Kubernetes abgestimmt werden. Ein Hypervisor kann beispielsweise eine virtuelle Maschine nach dem Ausfall eines physischen Hosts auf einem anderen Host neu starten. Kubernetes erkennt währenddessen möglicherweise, dass der betroffene Node nicht mehr erreichbar ist, und versucht, die darauf ausgeführten Anwendungen auf anderen verfügbaren Nodes wiederherzustellen. Beide Plattformen reagieren damit auf denselben Infrastrukturausfall, allerdings auf unterschiedlichen Ebenen.
Eine durchdachte Architektur muss deshalb berücksichtigen, wie sich die jeweiligen Wiederherstellungsmechanismen gegenseitig beeinflussen. Dazu gehören unter anderem Zeitüberschreitungen, Ressourcenreserven und die Verteilung der Kubernetes-Nodes auf unterschiedliche physische Hosts. Zwei Ebenen der Hochverfügbarkeit bedeuten nicht automatisch doppelte Ausfallsicherheit. Entscheidend ist, dass ihre Mechanismen sinnvoll zusammenarbeiten.
Kubernetes auf Bare Metal: Wenn die virtuelle Maschine entfällt
So verbreitet der Betrieb von Kubernetes auf virtuellen Maschinen auch ist, technisch erforderlich ist diese Architektur nicht. Kubernetes-Nodes können ebenso auf physischen Servern betrieben werden. In diesem Fall spricht man häufig von einem Bare-Metal-Kubernetes-Cluster. Die Containerlaufzeitumgebung arbeitet dann unmittelbar auf dem Betriebssystem des physischen Servers. Eine zusätzliche Maschinenvirtualisierung zwischen Hardware und Betriebssystem entfällt.
Das kann insbesondere dort interessant sein, wo spezielle Hardwareanforderungen bestehen oder der zusätzliche Verwaltungsaufwand einer Virtualisierungsebene vermieden werden soll. Beispiele sind bestimmte hochleistungsfähige Rechenumgebungen, spezialisierte Netzwerkfunktionen oder GPU-beschleunigte Anwendungen, bei denen ein direkter beziehungsweise möglichst kontrollierter Zugriff auf Hardwarefunktionen gewünscht ist.
Allerdings bringt auch dieser Ansatz eigene Anforderungen mit sich. Die Bereitstellung, Wartung und Wiederherstellung physischer Nodes muss organisiert werden. Funktionen, die eine vorhandene Virtualisierungsplattform bereitstellt, stehen nicht automatisch in derselben Form zur Verfügung. Auch die Ressourcenzuweisung ist weniger flexibel, wenn einzelne physische Systeme nicht ohne Weiteres in mehrere unabhängig verwaltete Betriebssystemumgebungen aufgeteilt werden können. Ob Kubernetes auf Bare Metal oder auf virtuellen Maschinen betrieben werden sollte, hängt deshalb von den technischen und organisatorischen Anforderungen ab. Eine grundsätzliche Überlegenheit lässt sich aus keiner der beiden Architekturen ableiten.
Zwei Plattformen, eine gemeinsame Infrastrukturstrategie
Damit zeigt sich ein wichtiger Unterschied zur Vorstellung, Container würden klassische Virtualisierung vollständig ablösen. Kubernetes verändert vor allem die Art und Weise, wie Anwendungen bereitgestellt und betrieben werden. Es macht die einzelne Serverinstanz für viele Anwendungsprozesse weniger wichtig, beseitigt jedoch nicht den Bedarf an einer zuverlässig verwalteten Infrastruktur. Virtuelle Maschinen bleiben deshalb eine sinnvolle Grundlage für zahlreiche Kubernetes-Umgebungen. Gleichzeitig können Unternehmen bestimmte Arbeitslasten direkt auf physischen Systemen betreiben, wenn dies ihren Anforderungen besser entspricht.
Die Entscheidung für Kubernetes beantwortet somit noch nicht die Frage, welche Virtualisierungsplattform ein Unternehmen benötigt. Ebenso wenig entscheidet die Wahl zwischen VMware, Hyper-V oder einer KVM-basierten Lösung darüber, ob Kubernetes eingesetzt werden kann. Containerorchestrierung und Maschinenvirtualisierung stehen nicht zwangsläufig im Wettbewerb. Sie ergänzen sich häufig zu einer Infrastruktur, in der Hardware, Betriebssysteme und Anwendungen auf unterschiedlichen Ebenen unabhängig verwaltet werden können. Gerade dieses Zusammenspiel verdeutlicht, weshalb klassische Hypervisoren auch in einer zunehmend containerisierten IT-Landschaft weiterhin eine wichtige Rolle spielen.
Windows, Linux und die Besonderheiten der Containerarchitektur
Nachdem wir betrachtet haben, wie Kubernetes und klassische Hypervisoren auf unterschiedlichen Ebenen zusammenarbeiten, lohnt sich ein genauerer Blick auf die Betriebssysteme innerhalb dieser Architektur. Denn unabhängig davon, ob ein Kubernetes-Cluster auf physischen Servern oder virtuellen Maschinen betrieben wird, benötigen seine Container eine geeignete Betriebssystemumgebung. Und genau hier zeigt sich ein grundlegender Unterschied zwischen Maschinenvirtualisierung und Containerisierung.
Während ein Hypervisor vollständige virtuelle Maschinen mit jeweils eigenem Betriebssystemkernel bereitstellen kann, verwenden gewöhnliche Container den Kernel des Betriebssystems, auf dem sie ausgeführt werden. Ein Linux-Container benötigt deshalb eine Linux-Kernelumgebung. Ein Windows-Container verwendet dagegen Windows-spezifische Betriebssystemfunktionen und benötigt eine entsprechend kompatible Windows-Kernelumgebung. Diese Abhängigkeit hat weitreichende Konsequenzen für die Bereitstellung und Verwaltung containerisierter Anwendungen.
Linux-Container und Windows-Container: Ähnliche Konzepte, unterschiedliche Grundlagen
Linux-Container verwenden unter anderem Namespaces und Control Groups, um Prozesse voneinander zu isolieren und deren Ressourcennutzung zu kontrollieren. Windows verfolgt mit seinen Containern ein vergleichbares Ziel, verwendet dafür jedoch eigene Betriebssystemmechanismen. Windows Server unterstützt die containerisierte Ausführung geeigneter Windows-Anwendungen. Dazu gehören insbesondere Anwendungen und Dienste, die sich innerhalb der unterstützten Windows-Containerarchitektur betreiben lassen.
Allerdings bedeutet die Unterstützung von Windows-Containern nicht, dass beliebige klassische Windows-Anwendungen unverändert in einen Container verschoben werden können. Viele Anwendungen setzen beispielsweise eine vollständige Desktopumgebung, bestimmte Betriebssystemdienste oder spezielle Installationsmechanismen voraus. Solche Abhängigkeiten können einer Containerisierung entgegenstehen. Hinzu kommt eine weitere Besonderheit: Da Windows-Container bei der gewöhnlichen Prozessisolation den Kernel des Hosts verwenden, müssen die jeweiligen Kompatibilitätsanforderungen zwischen Container-Image und Hostbetriebssystem berücksichtigt werden. Diese Anforderungen können sich zwischen unterschiedlichen Windows- und Windows-Server-Versionen unterscheiden.
Damit zeigt sich ein wesentlicher Unterschied zur klassischen virtuellen Maschine: Ein Hypervisor ermöglicht es, unterschiedliche unterstützte Gastbetriebssysteme mit eigenen Kerneln auszuführen. Ein gewöhnlicher Container bleibt dagegen enger an die Eigenschaften seines Hostbetriebssystems gebunden.
Hyper-V-Isolation: Wenn Windows-Container eine eigene Kernelumgebung erhalten
Microsoft bietet für Windows-Container zwei grundlegende Isolationsmodelle an: die Prozessisolation und die Hyper-V-Isolation. Bei der Prozessisolation verwenden die Container den Kernel des Windows-Hosts. Die Trennung erfolgt über die dafür vorgesehenen Betriebssystemmechanismen. Die Hyper-V-Isolation verfolgt dagegen einen anderen Ansatz: Hier wird der Container innerhalb einer speziell bereitgestellten, leichtgewichtigen virtuellen Maschine ausgeführt. Diese verfügt über eine eigene Kernelumgebung und schafft damit eine zusätzliche Isolationsgrenze gegenüber dem Hostbetriebssystem. Die Anwendung wird weiterhin als Container bereitgestellt und verwaltet. Die darunterliegende Ausführungsumgebung nutzt jedoch die Maschinenvirtualisierung, um eine stärkere Trennung zu ermöglichen.
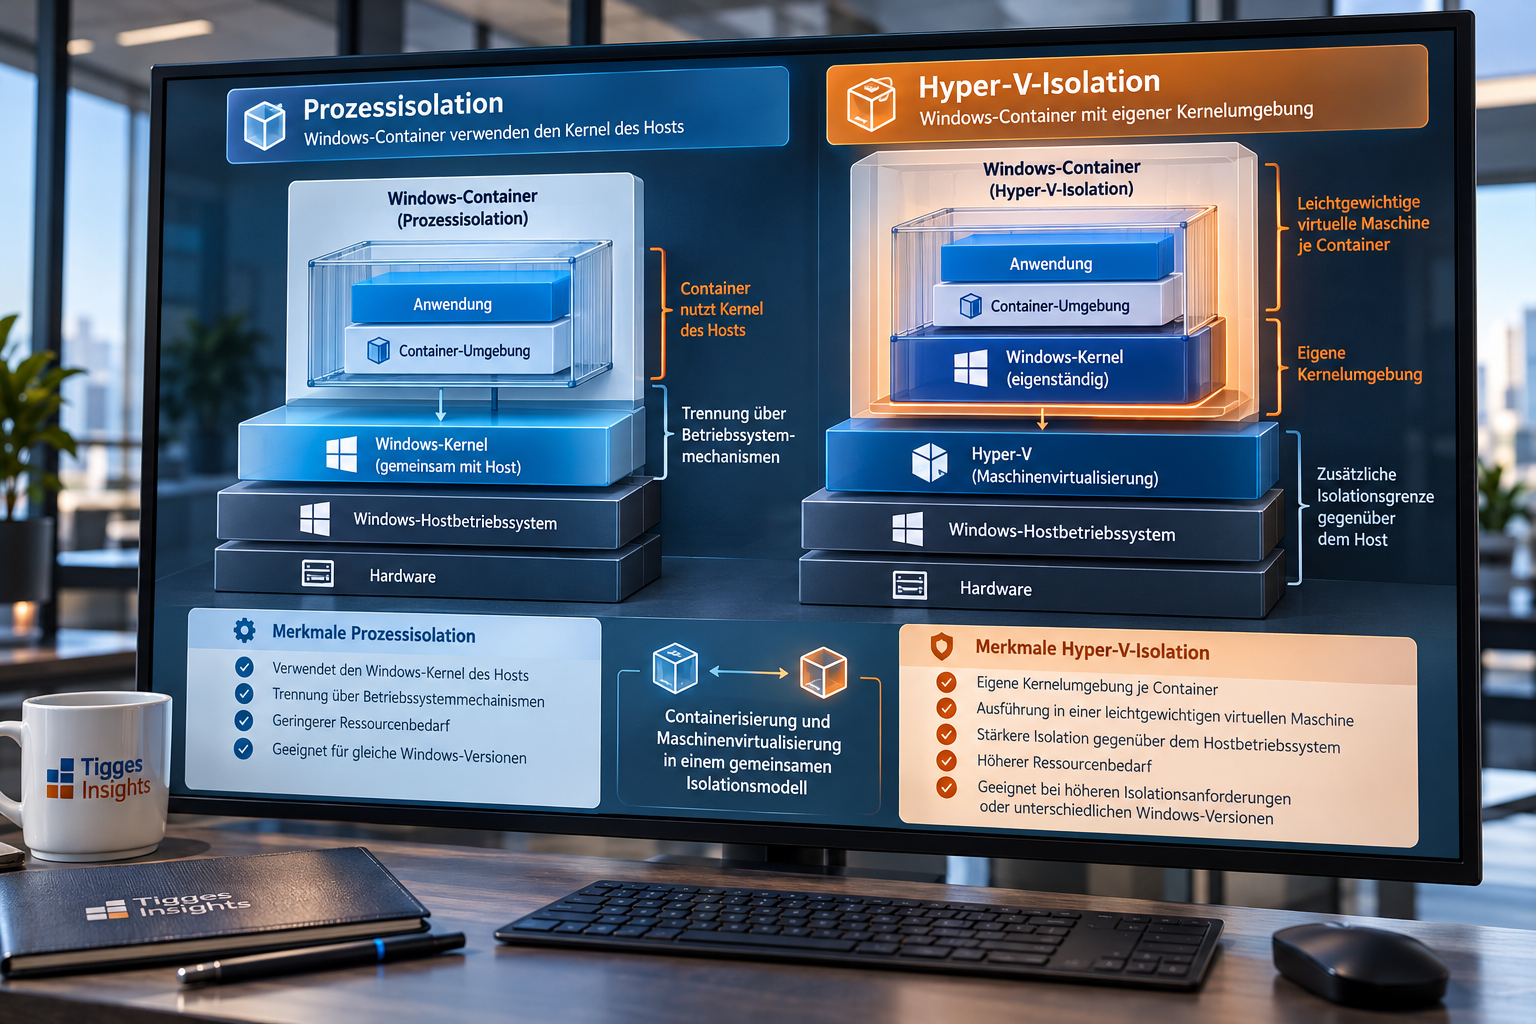
Damit verbindet Microsoft zwei Konzepte, die wir zuvor als unterschiedliche Abstraktionsebenen kennengelernt haben. Die Containertechnologie übernimmt die standardisierte Bereitstellung der Anwendung, während Hyper-V eine zusätzliche Virtualisierungsebene für deren Ausführung bereitstellt. Das kann insbesondere dann interessant sein, wenn höhere Anforderungen an die Isolation bestehen oder bestimmte Unterschiede zwischen Host- und Containerbetriebssystem berücksichtigt werden müssen. Allerdings ist Hyper-V-Isolation nicht mit der gewöhnlichen Prozessisolation gleichzusetzen. Die zusätzliche Kernelumgebung benötigt Ressourcen und bringt einen anderen technischen Aufwand mit sich. Microsoft zeigt damit, dass Containerisierung und Maschinenvirtualisierung nicht nur übereinander betrieben, sondern auch innerhalb eines gemeinsamen Isolationsmodells miteinander kombiniert werden können.
Docker Desktop und WSL 2: Linux-Container unter Windows
Ein weiteres Beispiel begegnet uns auf gewöhnlichen Windows-Arbeitsplätzen. Wer Docker Desktop unter Windows verwendet, kann Linux-Container ausführen, obwohl Windows selbst keinen Linux-Kernel besitzt. Wie ist das möglich? Die Antwort kennen wir bereits aus unserem früheren Exkurs über Hyper-V und die Virtualisierungstechnologien moderner Windows-Betriebssysteme. Mit Windows Subsystem for Linux 2, kurz WSL 2, stellt Microsoft eine Linux-Umgebung bereit, die auf einem tatsächlichen Linux-Kernel innerhalb einer leichtgewichtigen virtuellen Maschine basiert. Docker Desktop kann diese Umgebung als technische Grundlage für die Ausführung von Linux-Containern verwenden.
Aus Sicht der Benutzer:innen erfolgt die Verwaltung weiterhin über vertraute Docker-Werkzeuge. Container-Images werden abgerufen, Anwendungen gestartet und laufende Container überwacht. Dass im Hintergrund eine virtualisierte Linux-Kernelumgebung arbeitet, muss dabei nicht ständig sichtbar sein.
Die Architektur lässt sich vereinfacht folgendermaßen beschreiben:
- Windows: Stellt die Desktopumgebung und die Benutzeroberfläche bereit
- WSL 2: Ermöglicht die Ausführung einer virtualisierten Linux-Kernelumgebung
- Docker Engine und Containerlaufzeit: Stellen innerhalb der Linux-Umgebung die Funktionen zur Ausführung der Container bereit
- Linux-Container: Nutzen den Linux-Kernel und führen die jeweiligen Anwendungen aus
Docker Desktop kann unter Windows auch andere unterstützte Backend- und Isolationsmodelle verwenden. Die WSL-2-Integration ist jedoch ein besonders anschauliches Beispiel für das Zusammenspiel der Technologien. Wir begegnen damit erneut einem Prinzip, das sich durch die gesamte Entwicklung der Virtualisierung zieht: Eine zusätzliche Abstraktionsebene kann im Hintergrund arbeiten, ohne dass Benutzer:innen sie bei jeder Interaktion bewusst wahrnehmen müssen.
Und welche Rolle spielt Kubernetes in gemischten Umgebungen?
Auch bei Kubernetes ist die Unterscheidung zwischen Windows und Linux relevant. Kubernetes kann grundsätzlich Cluster mit Linux- und Windows-Worker-Nodes verwalten. Die eigentlichen Container müssen jedoch auf Nodes ausgeführt werden, deren Betriebssystem die jeweilige Containerarchitektur unterstützt. Ein gewöhnlicher Linux-Container kann daher nicht einfach auf einem Windows-Worker-Node mit Windows-Kernel ausgeführt werden. Umgekehrt benötigt ein Windows-Container eine geeignete Windows-Ausführungsumgebung.
Kubernetes berücksichtigt solche Unterschiede bei der Verteilung der Workloads. Über geeignete Zuordnungsmechanismen können Anwendungen gezielt auf Nodes mit den erforderlichen Betriebssystemeigenschaften eingeplant werden. Dabei sind allerdings nicht sämtliche Kubernetes-Funktionen unter Windows und Linux in identischer Weise verfügbar. Auch die Anforderungen an Netzwerk, Containerlaufzeit und unterstützte Betriebssystemversionen können sich unterscheiden. Für Administrator:innen bedeutet dies, dass die Entscheidung für Kubernetes allein noch keine vollständige Betriebssystemunabhängigkeit schafft. Die Orchestrierungsplattform abstrahiert zahlreiche Aufgaben der Anwendungsverwaltung. Sie hebt jedoch nicht sämtliche technischen Abhängigkeiten zwischen Anwendung, Containerlaufzeit und Betriebssystem auf.
Wenn unterschiedliche Virtualisierungskonzepte zusammenwachsen
Die Beispiele aus dem Microsoft-Umfeld verdeutlichen, wie unterschiedlich Containertechnologien eingesetzt werden können. Windows-Container mit Prozessisolation nutzen den gemeinsamen Kernel des Hosts. Hyper-V-isolierte Container erhalten dagegen eine zusätzliche virtuelle Kernelumgebung. Docker Desktop wiederum kann mithilfe von WSL 2 Linux-Container auf einem Windows-Arbeitsplatz bereitstellen. Kubernetes organisiert schließlich containerisierte Anwendungen über mehrere Nodes hinweg, unabhängig davon, ob diese auf physischen Servern oder virtuellen Maschinen betrieben werden. Die Grenzen zwischen den Technologien verschwinden dadurch nicht. Ihre Zusammenarbeit wird jedoch zunehmend selbstverständlich.
Gerade für Microsoft Hyper-V ist diese Entwicklung bemerkenswert. Eine Technologie, die ursprünglich vor allem als Plattform für virtuelle Server wahrgenommen wurde, bildet inzwischen auch die Grundlage unterschiedlicher Sicherheits-, Entwicklungs- und Containerfunktionen. Die moderne Containerarchitektur macht Hypervisoren nicht überflüssig. Sie erweitert vielmehr die Einsatzmöglichkeiten der Maschinenvirtualisierung und verbindet sie mit neuen Formen der Anwendungsbereitstellung. Damit stellt sich allerdings eine weitere Frage: Wenn Container so viele Möglichkeiten eröffnen, weshalb betreiben Unternehmen dann überhaupt noch klassische virtuelle Server? Die Antwort liegt nicht allein in technischen Einschränkungen, sondern ebenso in den Anforderungen bestehender Anwendungen, gewachsener IT-Infrastrukturen und langfristiger Betriebsmodelle.
Warum klassische virtuelle Maschinen weiterhin gebraucht werden
Wer heute ein Unternehmensrechenzentrum betrachtet, findet dort selten eine Infrastruktur, die ausschließlich nach einem einzigen technologischen Konzept aufgebaut ist. Neben modernen Cloud-Diensten und containerisierten Anwendungen arbeiten häufig zahlreiche virtuelle Server, auf denen geschäftskritische Dienste und Anwendungen seit Jahren zuverlässig betrieben werden. Das ist keineswegs nur das Ergebnis historisch gewachsener Strukturen. Vielmehr spiegeln solche Umgebungen die unterschiedlichen Anforderungen wider, die Unternehmen an ihre IT stellen. Denn für Administrator:innen zählt im täglichen Betrieb nicht allein, wie effizient sich eine Anwendung bereitstellen lässt. Ebenso entscheidend sind ihre Verfügbarkeit, Sicherheit, Wartbarkeit und die Möglichkeit, bei Störungen einen definierten Betriebszustand wiederherzustellen.
Eine neue Bereitstellungstechnologie muss sich deshalb nicht nur anhand ihrer technischen Möglichkeiten bewähren, sondern auch im Zusammenspiel mit vorhandenen Anwendungen, Betriebsprozessen und organisatorischen Rahmenbedingungen. Gerade hier zeigt sich, weshalb klassische virtuelle Maschinen weiterhin eine wichtige Rolle spielen. Nicht jede Anwendung lässt sich sinnvoll containerisieren. Und selbst dort, wo eine Containerisierung technisch möglich wäre, ist sie nicht zwangsläufig die bessere Lösung.
Gewachsene Unternehmensanwendungen lassen sich nicht beliebig verändern
Viele Anwendungen, die heute in Unternehmensrechenzentren betrieben werden, entstanden zu einer Zeit, als physische oder virtuelle Server die selbstverständliche Grundlage der Softwarebereitstellung bildeten. Sie wurden für vollständige Betriebssysteminstallationen entwickelt und setzen häufig bestimmte Systemdienste, Installationsroutinen oder eine enge Integration in vorhandene Infrastrukturkomponenten voraus. Dazu gehören beispielsweise Anwendungen, die auf lokale Windows-Dienste, spezifische Registrierungseinträge, gemeinsam verwendete Dateiverzeichnisse oder besondere Betriebssystemkonfigurationen angewiesen sind. Auch komplexe Fachanwendungen, ältere Datenbanksysteme oder individuell entwickelte Unternehmenslösungen können solche Abhängigkeiten besitzen.
Eine Umstellung auf Container würde in diesen Fällen nicht lediglich bedeuten, die Anwendung in ein anderes Bereitstellungsformat zu verpacken. Häufig müssten zunächst ihre Architektur, ihre Abhängigkeiten und die bisherigen Betriebsprozesse untersucht werden. Unter Umständen wären Anpassungen an der Anwendung selbst erforderlich. Dabei stellt sich eine grundlegende wirtschaftliche Frage: Welchen zusätzlichen Nutzen bietet die Containerisierung gegenüber dem bereits etablierten Betrieb auf einer virtuellen Maschine? Wenn eine Anwendung zuverlässig funktioniert, vom Hersteller unterstützt wird und sich mit vorhandenen Werkzeugen effizient verwalten lässt, kann ihre weitere Ausführung auf einer virtuellen Maschine die sinnvollere Entscheidung sein. Nicht jede technisch mögliche Modernisierung ist automatisch eine wirtschaftlich oder betrieblich notwendige Modernisierung.
Vollständige Betriebssystemumgebungen bleiben eine eigenständige Anforderung
Hinzu kommt, dass Container und virtuelle Maschinen unterschiedliche Isolations- und Betriebsmodelle bereitstellen. Wie wir zuvor gesehen haben, verwenden gewöhnliche Container den Kernel ihres Hostbetriebssystems. Dadurch lassen sich Anwendungen effizient ausführen, gleichzeitig entstehen jedoch Abhängigkeiten von der zugrunde liegenden Kernelumgebung. Virtuelle Maschinen ermöglichen dagegen den Betrieb vollständiger Gastbetriebssysteme mit eigenen Kerneln. Das ist insbesondere dann relevant, wenn unterschiedliche Betriebssystemversionen parallel betrieben werden müssen oder Anwendungen spezielle Anforderungen an die Konfiguration ihrer Betriebssystemumgebung stellen.
Auch die Sicherheitsarchitektur kann für den Einsatz virtueller Maschinen sprechen. Ein Hypervisor schafft eine zusätzliche Isolationsgrenze zwischen den einzelnen Gastbetriebssystemen. Diese Trennung kann gerade bei unterschiedlichen Schutzbedarfen oder voneinander unabhängigen administrativen Verantwortlichkeiten von Bedeutung sein. Allerdings bedeutet das nicht, dass virtuelle Maschinen grundsätzlich sicherer wären als Container. Beide Technologien besitzen eigene Sicherheitsmechanismen und mögliche Angriffsflächen. Entscheidend ist vielmehr, welche Form der Isolation für den jeweiligen Workload benötigt wird und wie konsequent die gesamte Umgebung abgesichert wird.
Betrieb, Datensicherung und Wiederherstellung sind mehr als technische Nebensachen
Ein weiterer Aspekt wird bei der Diskussion über moderne Anwendungsarchitekturen gelegentlich unterschätzt: Der zuverlässige Betrieb einer IT-Infrastruktur umfasst weit mehr als die eigentliche Ausführung einer Anwendung. Unternehmen benötigen nachvollziehbare Verfahren für Datensicherung, Wiederherstellung, Wartung, Überwachung und die Behandlung von Störungen. Für virtuelle Maschinen existieren seit vielen Jahren etablierte Werkzeuge und Betriebsprozesse. Hypervisorbasierte Sicherungsverfahren können beispielsweise vollständige virtuelle Maschinen erfassen und deren Wiederherstellung unterstützen. Je nach Anwendung sind dafür zusätzliche Maßnahmen erforderlich, um auch die Konsistenz der enthaltenen Daten sicherzustellen.
Containerisierte Anwendungen stellen teilweise andere Anforderungen. Während sich zustandslose Anwendungscontainer häufig vergleichsweise einfach ersetzen lassen, müssen persistente Daten, externe Dienste und Konfigurationsinformationen gesondert berücksichtigt werden. Ein neu gestarteter Container stellt schließlich nicht automatisch verlorene Daten wieder her. Kubernetes kann ausgefallene Pods ersetzen und den gewünschten Betriebszustand wiederherzustellen versuchen. Eine vollständige Datensicherungs- und Wiederherstellungsstrategie ersetzt diese Funktion jedoch nicht.
Damit wird deutlich, dass die Entscheidung zwischen virtuellen Maschinen und Containern auch eine Entscheidung über Betriebsprozesse und Verantwortlichkeiten ist. Die Fähigkeit, eine Anwendung automatisiert neu zu starten, ist nicht gleichbedeutend mit der Fähigkeit, ihren vollständigen Zustand nach einem schwerwiegenden Fehler wiederherzustellen.
Herstellerunterstützung und langfristige Wartbarkeit
Gerade bei geschäftskritischen Anwendungen spielt außerdem die Unterstützung durch den jeweiligen Softwarehersteller eine wesentliche Rolle. Nicht jede Anwendung ist für den Betrieb in Containern freigegeben. Manche Hersteller unterstützen ausschließlich bestimmte Betriebssystemversionen oder definierte Virtualisierungsplattformen. Eine eigenständige Containerisierung kann deshalb dazu führen, dass ein Unternehmen zwar eine technisch funktionierende Lösung betreibt, diese jedoch außerhalb der vorgesehenen Supportbedingungen liegt. Auch bei modernen Anwendungen müssen unterstützte Container-Images, Laufzeitumgebungen und Plattformversionen berücksichtigt werden.
Container beseitigen somit nicht die Notwendigkeit eines geregelten Lifecycle-Managements. Sie verändern lediglich, auf welcher Ebene bestimmte Wartungsaufgaben stattfinden. Virtuelle Maschinen bieten hier weiterhin einen etablierten Rahmen, insbesondere wenn Anwendungen über längere Zeiträume mit möglichst wenigen grundlegenden Architekturänderungen betrieben werden sollen.
Virtuelle Maschinen sind nicht nur für ältere Anwendungen relevant
Es wäre allerdings zu kurz gegriffen, virtuelle Maschinen ausschließlich als Betriebsplattform für sogenannte Legacy-Anwendungen zu betrachten. Auch moderne Infrastrukturen benötigen häufig vollständige Betriebssystemumgebungen. Dazu gehören beispielsweise bestimmte Infrastruktur- und Verwaltungsdienste, spezialisierte Sicherheitslösungen, Entwicklungs- und Testumgebungen oder Anwendungen mit besonderen Anforderungen an Betriebssystem und Hardware.
Darüber hinaus haben wir bereits gesehen, dass virtuelle Maschinen selbst eine wichtige Grundlage moderner Containerplattformen bilden können. Kubernetes-Nodes lassen sich auf virtuellen Maschinen bereitstellen, automatisiert austauschen und in vorhandene Verwaltungs- und Sicherheitskonzepte integrieren. Ein Unternehmen kann deshalb gleichzeitig klassische virtuelle Server für bestehende Fachanwendungen betreiben und moderne containerisierte Anwendungen auf einer Kubernetes-Plattform bereitstellen. Beide Betriebsmodelle nutzen dabei möglicherweise dieselbe physische Infrastruktur.
Gerade darin liegt eine wesentliche Stärke der Maschinenvirtualisierung: Sie ermöglicht es, unterschiedliche Workloads auf einer gemeinsamen Hardwareplattform auszuführen, ohne dass sämtliche Anwendungen nach demselben Architekturprinzip aufgebaut sein müssen.
Die passende Plattform entscheidet sich am Workload
Aus dieser Betrachtung ergibt sich eine wichtige Konsequenz. Die Entscheidung zwischen virtuellen Maschinen und Containern sollte nicht anhand eines vermeintlichen technologischen Fortschritts getroffen werden, bei dem die neuere Lösung automatisch als überlegen gilt. Vielmehr müssen die Eigenschaften der jeweiligen Anwendung berücksichtigt werden.
Eine modular aufgebaute Anwendung, deren Komponenten unabhängig entwickelt und häufig aktualisiert werden, kann erheblich von einer containerisierten Architektur profitieren. Eine seit Jahren zuverlässig betriebene Fachanwendung mit komplexen Betriebssystemabhängigkeiten ist dagegen möglicherweise auf einer virtuellen Maschine besser aufgehoben.
Und für zahlreiche Unternehmen wird die sinnvollste Lösung ohnehin in einer Kombination unterschiedlicher Betriebsmodelle bestehen. Virtuelle Maschinen und Container beantworten nicht dieselbe Frage. Virtuelle Maschinen schaffen flexible Betriebssystemumgebungen, während Container die Bereitstellung und Ausführung geeigneter Anwendungen vereinfachen. Die zunehmende Verbreitung von Docker und Kubernetes verändert deshalb die Anforderungen an klassische Virtualisierungsplattformen, beseitigt aber nicht deren grundsätzliche Bedeutung. Solange Unternehmen unterschiedliche Betriebssysteme, Anwendungen und Infrastrukturkomponenten gemeinsam betreiben müssen, bleibt Maschinenvirtualisierung ein wesentlicher Bestandteil moderner IT-Architekturen. Die Zukunft gehört damit nicht ausschließlich der virtuellen Maschine oder dem Container, sondern einer Infrastruktur, in der beide Technologien entsprechend ihren jeweiligen Stärken eingesetzt werden.
Eine zusätzliche Ebene statt eines vollständigen Umbruchs
Von den ersten virtualisierten Großrechnern über VMware und Hyper-V bis hin zu Docker und Kubernetes haben wir inzwischen mehrere Jahrzehnte technischer Entwicklung betrachtet. Dabei zeigt sich ein bemerkenswert konstantes Muster: Neue Technologien haben bestehende Betriebsmodelle nicht zwangsläufig verdrängt. Vielmehr erweiterten sie deren Möglichkeiten und schufen zusätzliche Ebenen der Abstraktion. Die Geschichte der Virtualisierung ist deshalb weniger eine Abfolge vollständiger technologischer Umbrüche als eine kontinuierliche Weiterentwicklung. Jede neue Generation veränderte die Art und Weise, wie Unternehmen ihre IT-Ressourcen bereitstellen, verwalten und nutzen konnten.
Von der Hardware zur Anwendung
Die Großrechnervirtualisierung ermöglichte es, mehrere voneinander getrennte Betriebssystemumgebungen auf einer gemeinsamen, kostspieligen Rechenanlage auszuführen. VMware übertrug dieses Prinzip erfolgreich auf die x86-Architektur und veränderte damit die Organisation moderner Rechenzentren. Microsoft entwickelte mit Hyper-V eine eigene Virtualisierungsplattform und integrierte die zugrunde liegenden Technologien zunehmend in seine Server- und Desktopbetriebssysteme. Mit der Cloud verlagerte sich anschließend die Perspektive. Unternehmen mussten die physische Infrastruktur nicht mehr zwangsläufig selbst bereitstellen und verwalten. Virtuelle Maschinen, Speicher und Netzwerkressourcen wurden zu flexibel nutzbaren Diensten, deren technische Umsetzung für viele Benutzer:innen weitgehend in den Hintergrund trat. Docker und Kubernetes führten diese Entwicklung auf einer anderen Ebene fort. Nun stand nicht mehr ausschließlich die Bereitstellung vollständiger Betriebssystemumgebungen im Mittelpunkt, sondern zunehmend die standardisierte Ausführung, Verteilung und automatisierte Verwaltung einzelner Anwendungskomponenten. Dabei entstanden unterschiedliche technische Ansätze, die ähnliche Anforderungen adressierten, jedoch verschiedene Schwerpunkte setzten.
Auch innerhalb der Containerorchestrierung zeigte sich diese Entwicklung. Docker bot mit Swarm eine vergleichsweise einfach zugängliche Lösung zur Verwaltung mehrerer Containerhosts. Kubernetes etablierte dagegen ein umfassenderes, deklaratives Plattformmodell, das durch ein wachsendes herstellerübergreifendes Ökosystem zunehmend an Bedeutung gewann. Die Entwicklung der Virtualisierung besteht damit nicht in der fortlaufenden Ablösung bestehender Technologien, sondern in der Erweiterung ihrer Einsatzmöglichkeiten.
Unterschiedliche Abstraktionsebenen, gemeinsame Infrastruktur
In modernen Rechenzentren existieren diese Technologien häufig nebeneinander. Klassische virtuelle Maschinen stellen vollständige Betriebssystemumgebungen bereit, während Container die standardisierte Ausführung geeigneter Anwendungen ermöglichen. Kubernetes ergänzt diese Architektur um eine übergeordnete Ebene, auf der containerisierte Anwendungen bereitgestellt, verteilt und überwacht werden. Dabei müssen die unterschiedlichen Technologien keineswegs unabhängig voneinander betrieben werden. Ein Kubernetes-Cluster kann beispielsweise auf virtuellen Maschinen arbeiten, die durch VMware ESXi, Microsoft Hyper-V oder eine KVM-basierte Plattform bereitgestellt werden. Die Container nutzen den Kernel des jeweiligen Gastbetriebssystems, während Kubernetes ihre Ausführung über mehrere Nodes hinweg koordiniert.
Auch Microsofts Unterstützung für Windows-Container verdeutlicht, wie eng diese Konzepte inzwischen miteinander verbunden sind. Mit der Hyper-V-Isolation können Container innerhalb einer zusätzlich virtualisierten Kernelumgebung ausgeführt werden. Docker Desktop wiederum ermöglicht mithilfe von WSL 2 die Ausführung von Linux-Containern auf Windows-Systemen. Was zunächst wie ein Nebeneinander konkurrierender Technologien erscheint, ist somit häufig eine bewusst aufgebaute, mehrschichtige Infrastruktur. Hypervisoren abstrahieren die physische Hardware. Container isolieren Anwendungen innerhalb geeigneter Betriebssystemumgebungen. Kubernetes automatisiert deren Bereitstellung und Verwaltung. Jede Ebene übernimmt bestimmte Aufgaben und baut gleichzeitig auf den technischen Möglichkeiten der darunterliegenden Infrastruktur auf.
Mehr Abstraktion bedeutet nicht weniger Verantwortung
Die zunehmende Entkopplung von Anwendungen und physischer Hardware eröffnet Unternehmen zahlreiche Möglichkeiten. Ressourcen lassen sich flexibler zuweisen, Anwendungen automatisiert bereitstellen und unterschiedliche Betriebsmodelle miteinander kombinieren. Allerdings verschwindet die technische Komplexität dadurch nicht vollständig. Ein Teil davon verlagert sich lediglich auf andere Ebenen. Auch containerisierte Anwendungen benötigen Rechenleistung, Arbeitsspeicher, Netzwerkverbindungen und gegebenenfalls dauerhaften Datenspeicher. Kubernetes benötigt geeignete Nodes, deren Betriebssysteme gepflegt, aktualisiert und abgesichert werden müssen. Werden diese Nodes auf virtuellen Maschinen betrieben, bleibt auch die darunterliegende Virtualisierungsplattform Bestandteil der gesamten Betriebs- und Sicherheitsarchitektur.
Hinzu kommt, dass mehrere Abstraktionsebenen nicht automatisch eine höhere Verfügbarkeit garantieren. Die Wiederherstellungsmechanismen von Kubernetes müssen beispielsweise mit den Hochverfügbarkeitsfunktionen der Virtualisierungsplattform sinnvoll zusammenarbeiten. Ähnliches gilt für Datensicherung, Monitoring und die Verwaltung von Zugriffsrechten. Jede Ebene besitzt eigene Funktionen und Verantwortlichkeiten, die innerhalb eines gemeinsamen Betriebskonzepts berücksichtigt werden müssen. Je unabhängiger Anwendungen von einzelnen Servern werden, desto wichtiger wird es, die technischen Abhängigkeiten zwischen den verschiedenen Infrastrukturebenen zu verstehen.
Technische Flexibilität ist nicht gleich wirtschaftliche Unabhängigkeit
Eine weitere Unterscheidung ist für unsere Betrachtung besonders wichtig: Die technische Entkopplung von Anwendungen bedeutet nicht automatisch, dass Unternehmen unabhängig von einzelnen Herstellern oder Plattformen werden. Container-Images lassen sich unter geeigneten Voraussetzungen in unterschiedlichen Umgebungen ausführen. Virtuelle Maschinen können innerhalb kompatibler Virtualisierungsplattformen verschoben oder auf anderen Hosts wiederhergestellt werden. Doch damit sind längst nicht sämtliche Abhängigkeiten beseitigt. Verwaltungswerkzeuge, Automatisierungslösungen, Datensicherungsverfahren und betriebliche Prozesse sind häufig eng mit bestimmten Produkten verbunden. Hinzu kommen Lizenzmodelle, Supportverträge, vorhandenes Fachwissen und langfristige Investitionen. Ein Unternehmen, das seine Infrastruktur über viele Jahre auf VMware aufgebaut hat, kann deshalb nicht allein durch den Einsatz von Docker oder Kubernetes sämtliche Abhängigkeiten von dieser Plattform auflösen.
Ebenso wenig bedeutet die Verfügbarkeit von Hyper-V, Proxmox VE oder anderen KVM-basierten Lösungen, dass sich eine bestehende Virtualisierungsumgebung ohne Anpassungen und organisatorischen Aufwand ersetzen lässt. Die technischen Möglichkeiten schaffen zwar zusätzliche Handlungsspielräume. Ob diese tatsächlich genutzt werden können, hängt jedoch auch von wirtschaftlichen, organisatorischen und vertraglichen Rahmenbedingungen ab. Technologische Offenheit ist deshalb nicht automatisch mit strategischer Unabhängigkeit gleichzusetzen. Gerade diese Unterscheidung gewinnt an Bedeutung, wenn sich die Geschäftsmodelle etablierter Infrastrukturhersteller verändern.
Wenn eine etablierte Plattform erneut zur strategischen Frage wird
Damit kehren wir zu einer Beobachtung zurück, die bereits am Anfang unseres Beitrags stand. Über viele Jahre war die Entscheidung für eine Virtualisierungsplattform in zahlreichen Unternehmen weitgehend abgeschlossen. VMware hatte sich in vielen Rechenzentren als etablierter Standard durchgesetzt. Hyper-V und andere Lösungen wurden zwar eingesetzt, standen jedoch nicht überall gleichermaßen im Mittelpunkt strategischer Infrastrukturentscheidungen. Währenddessen entwickelten sich die Anwendungen und ihre Betriebsmodelle weiter: Container, Kubernetes und Cloudplattformen eröffneten neue Möglichkeiten, ohne die vorhandenen Virtualisierungsumgebungen grundsätzlich überflüssig zu machen.
Doch nicht nur die Technologien veränderten sich. Auch die wirtschaftlichen Rahmenbedingungen gerieten in Bewegung. Mit der Übernahme von VMware durch Broadcom rückten Lizenzmodelle, Produktpakete, Supportbedingungen und langfristige Herstellerabhängigkeiten erneut in den Mittelpunkt der Diskussion. Plötzlich stellte sich für viele Unternehmen nicht mehr ausschließlich die Frage, welche Virtualisierungsplattform ihre technischen Anforderungen am besten erfüllt. Ebenso wichtig wurde, unter welchen wirtschaftlichen Bedingungen die vorhandene Infrastruktur künftig betrieben werden kann.
Damit entwickelte sich eine über Jahre etablierte technische Entscheidung erneut zu einer strategischen Herausforderung. Die Zukunft der Virtualisierung entscheidet sich nicht allein daran, welche Plattform die meisten Funktionen bietet. Ebenso wichtig ist, wer die zugrunde liegende Technologie kontrolliert, wie sie lizenziert wird und welche Handlungsspielräume Unternehmen langfristig behalten. Genau an diesem Punkt setzen wir im nächsten Kapitel an. Denn der Broadcom-Effekt zeigt, wie schnell aus einer scheinbar abgeschlossenen Infrastrukturentscheidung eine grundlegende Neubewertung der eigenen Virtualisierungsstrategie werden kann.
Exkurs: Microsoft App-V, VBS und NVIDIA – wenn Virtualisierung mehr bedeutet als virtuelle Maschinen
Nicht jeder Container ist ein Container
Wer sich schon länger mit Microsoft-Technologien beschäftigt, wird bei Begriffen wie Anwendungsvirtualisierung oder Container möglicherweise an Lösungen denken, die bereits vor der Verbreitung von Docker existierten. Microsoft Application Virtualization, kurz App-V, ist ein solches Beispiel. Aber auch Sicherheitsfunktionen wie Credential Guard und die früher unter Device Guard zusammengefassten Technologien nutzen Isolationsmechanismen, die auf den ersten Blick an Container erinnern. Und wer auf einem Windows-System mit NVIDIA-Grafikkarte die laufenden Dienste betrachtet, begegnet möglicherweise sogar einem Prozess mit der Bezeichnung NVIDIA Container.
Handelt es sich dabei tatsächlich um Containertechnologien? Die Antwort hängt davon ab, was wir unter einem Container verstehen. Denn nicht jede isolierte Ausführungsumgebung verwendet dieselben technischen Mechanismen. Und nicht jede Softwarekomponente, die als Container bezeichnet wird, ist mit einem Docker-Container vergleichbar.
Microsoft App-V: Anwendungsvirtualisierung vor Docker
Die Geschichte von Microsoft App-V beginnt lange vor der heutigen Containerentwicklung. Mit der Übernahme des Unternehmens Softricity im Jahr 2006 gelangte dessen SoftGrid-Technologie zu Microsoft. Daraus entwickelte sich Microsoft Application Virtualization, eine Lösung zur zentralen Bereitstellung und Virtualisierung von Windows-Anwendungen. App-V verfolgte ein Problem, das viele Administrator:innen aus der klassischen Softwareverteilung kennen: Anwendungen benötigten bestimmte Dateien, Registrierungseinträge oder Bibliotheken und konnten sich bei der Installation gegenseitig beeinflussen.
Unterschiedliche Versionen gemeinsam verwendeter Komponenten führten mitunter zu Konflikten. Zudem verursachte die Installation und Aktualisierung zahlreicher Anwendungen auf vielen Arbeitsplatzsystemen erheblichen Verwaltungsaufwand. App-V setzte genau hier an.
Anwendungen paketieren statt klassisch installieren
Bei App-V wurden Anwendungen zunächst mit einem speziellen Verfahren, dem sogenannten Sequencing, in ein virtuelles Anwendungspaket überführt. Der App-V-Client konnte dieses Paket anschließend auf einem Windows-System bereitstellen und die Anwendung innerhalb einer virtualisierten Anwendungsumgebung ausführen. Dabei wurden bestimmte Zugriffe auf Dateien und Registrierungseinträge umgeleitet beziehungsweise virtualisiert. Anwendungen konnten dadurch teilweise unabhängig von den regulären Installationsstrukturen des Betriebssystems arbeiten.
Für Administrator:innen ergaben sich daraus mehrere Vorteile:
- Anwendungen ließen sich zentral paketieren und bereitstellen
- Bestimmte Konflikte zwischen unterschiedlichen Anwendungsversionen konnten reduziert werden
- Die Softwareverteilung erforderte nicht immer eine klassische Installation auf jedem Arbeitsplatz
- Aktualisierungen und die Bereitstellung definierter Anwendungsversionen ließen sich besser organisieren
Allerdings blieb die Anwendung weiterhin eng mit dem Windows-Betriebssystem verbunden. App-V stellte weder einen eigenen Betriebssystemkernel bereit noch schuf es eine vollständige, sicherheitsorientierte Isolation gegenüber dem Host.
Warum App-V kein Docker-Container war
Auf den ersten Blick bestehen durchaus Gemeinsamkeiten zwischen App-V und modernen Containerkonzepten. Beide Ansätze ermöglichen es, Anwendungen gemeinsam mit bestimmten Abhängigkeiten bereitzustellen und ihre Ausführung von Teilen der regulären Betriebssystemumgebung zu entkoppeln. Die technische Umsetzung und die Zielsetzung unterscheiden sich jedoch erheblich. Docker und vergleichbare Containertechnologien verwenden Betriebssystemmechanismen zur Isolation von Prozessen, Netzwerkumgebungen und Ressourcen. App-V konzentrierte sich dagegen vor allem auf die Virtualisierung ausgewählter Anwendungsressourcen und die Vereinfachung der Softwarebereitstellung.
Insbesondere stellte App-V keine eigenständige Sicherheitsgrenze bereit, wie sie beispielsweise durch eine zusätzlich virtualisierte Betriebssystemumgebung geschaffen werden kann. App-V war damit eine Technologie zur Anwendungsvirtualisierung, aber keine Containerplattform im heutigen Sinne. Gerade diese Unterscheidung ist wichtig, weil sie zeigt, dass die Entkopplung von Anwendungen und Betriebssystemressourcen auf unterschiedlichen technischen Wegen erreicht werden kann.
Virtualization-Based Security: Wenn Isolation der Sicherheit dient
Eine andere Form der Virtualisierung begegnet uns bei den Sicherheitsfunktionen moderner Windows-Betriebssysteme. Bereits im Exkurs über Hyper-V unter Windows 10 und Windows 11 haben wir gesehen, dass Microsoft den Hypervisor längst nicht mehr ausschließlich für den Betrieb klassischer virtueller Maschinen verwendet. Mit Virtualization-Based Security, kurz VBS, nutzt Windows hardwaregestützte Virtualisierung, um besonders schützenswerte Betriebssystemkomponenten von der gewöhnlichen Windows-Ausführungsumgebung zu trennen. Dabei wird eine zusätzliche Sicherheitsgrenze geschaffen, die auch gegenüber bestimmten Angriffen aus dem regulären Betriebssystem heraus Schutz bieten soll.
Virtual Secure Mode und Virtual Trust Levels
Technisch verwendet VBS unter anderem den Virtual Secure Mode (VSM). Innerhalb dieser Architektur unterscheidet Windows verschiedene Vertrauensebenen, die als Virtual Trust Levels (VTL) bezeichnet werden. Die gewöhnliche Windows-Ausführungsumgebung arbeitet grundsätzlich in VTL0. Besonders geschützte Komponenten können dagegen in VTL1 ausgeführt werden. Der Hypervisor unterstützt die Trennung dieser Umgebungen und kontrolliert bestimmte Zugriffe auf geschützte Speicherbereiche.
Damit entsteht eine Isolationsarchitektur, die sich von gewöhnlichen Betriebssystemcontainern deutlich unterscheidet. Ein Docker-Container teilt sich grundsätzlich den Kernel seiner Betriebssystemumgebung. VBS nutzt dagegen hypervisorbasierte Sicherheitsmechanismen, um bestimmte Komponenten selbst gegenüber dem regulären Windows-Kernel zusätzlich abzuschirmen. Auch Begriffe wie Isolated User Mode (IUM) dürfen deshalb nicht mit einem gewöhnlichen Anwendungscontainer verwechselt werden. VBS dient nicht der vereinfachten Bereitstellung von Anwendungen, sondern dem Schutz besonders sensibler Betriebssystemfunktionen.
Credential Guard: Anmeldeinformationen außerhalb der gewöhnlichen Windows-Umgebung
Ein besonders anschauliches Beispiel für diese Sicherheitsarchitektur ist Microsoft Defender Credential Guard. Windows muss während einer angemeldeten Sitzung bestimmte Anmeldeinformationen und sicherheitsrelevante Geheimnisse verarbeiten. Gelangen Angreifer an solche Informationen, können sie diese unter Umständen für weiterführende Angriffe innerhalb einer Unternehmensinfrastruktur verwenden. Credential Guard nutzt deshalb VBS, um ausgewählte Geheimnisse aus der gewöhnlichen Ausführungsumgebung des Local Security Authority Subsystem Service (LSASS) herauszulösen. Dazu arbeitet neben dem regulären LSASS-Prozess ein isolierter Bestandteil, der innerhalb der durch VBS geschützten Umgebung ausgeführt wird. Der gewöhnliche LSASS-Prozess kann mit diesem geschützten Bestandteil kommunizieren, erhält jedoch keinen uneingeschränkten Zugriff auf die dort isolierten Geheimnisse. Damit wird die Angriffsfläche für bestimmte Verfahren zum Auslesen von Anmeldeinformationen reduziert.
Allerdings ist Credential Guard kein vollständiger Schutz gegen Identitätsdiebstahl. Nicht sämtliche Anmeldeinformationen werden auf diese Weise isoliert, und auch die missbräuchliche Verwendung bereits bestehender Sitzungen wird dadurch nicht grundsätzlich verhindert. Für unsere Betrachtung ist vor allem das technische Prinzip entscheidend: Credential Guard verwendet eine hypervisorbasierte Sicherheitsumgebung, aber keinen gewöhnlichen Anwendungscontainer.
Device Guard: Von der Anwendungskontrolle zur geschützten Codeintegrität
Im Umfeld von Windows 10 führte Microsoft außerdem den Begriff Device Guard ein. Darunter wurden verschiedene Sicherheitsmechanismen zusammengefasst, die insbesondere verhindern sollten, dass nicht vertrauenswürdiger oder manipulierter Code ausgeführt wird. Im Laufe der Produktentwicklung wurden die einzelnen Funktionen deutlicher voneinander abgegrenzt und teilweise umbenannt.
Zwei Konzepte sind dabei besonders relevant:
App Control for Business: Welche Software darf ausgeführt werden?
Die früher unter anderem als Windows Defender Application Control (WDAC) bezeichnete Anwendungskontrolle wird inzwischen als App Control for Business geführt. Mit ihr können Administrator:innen Richtlinien definieren, die festlegen, welcher Code auf einem Windows-System ausgeführt werden darf. Solche Richtlinien können beispielsweise auf Signaturen, Herausgeberinformationen oder anderen unterstützten Vertrauensmerkmalen beruhen. Ziel ist es, die Ausführung nicht autorisierter Software einzuschränken und dadurch die Angriffsfläche des Systems zu reduzieren.
Die Anwendungskontrolle selbst ist allerdings keine Containertechnologie. Sie legt Regeln für die Codeausführung fest und benötigt nicht für jede ihrer Funktionen eine eigene virtualisierte Ausführungsumgebung.
HVCI: Codeintegrität durch den Hypervisor absichern
Eine andere Aufgabe übernimmt Hypervisor-Protected Code Integrity, kurz HVCI. Diese Technologie nutzt VBS, um bestimmte Mechanismen zur Überprüfung und Durchsetzung der Kernelcodeintegrität zusätzlich zu schützen. Unter Windows begegnet uns HVCI unter anderem im Zusammenhang mit der Sicherheitsfunktion Speicherintegrität. Der Hypervisor hilft dabei, die Integritätsprüfung und bestimmte Speicherzugriffsregeln gegenüber Manipulationen aus der gewöhnlichen Kernelumgebung abzusichern. Damit wird es für Schadsoftware schwieriger, unzulässigen Kernelcode auszuführen oder bestimmte Schutzmechanismen zu umgehen.
Auch HVCI stellt jedoch keine allgemeine Containerlaufzeit bereit. Der Unterschied zwischen App Control for Business und HVCI ist deshalb wesentlich: Während die Anwendungskontrolle definiert, welcher Code ausgeführt werden darf, schützt HVCI bestimmte Mechanismen der Kernelcodeintegrität mithilfe der Virtualisierung.
NVIDIA Container: Wenn derselbe Begriff Unterschiedliches bedeutet
Ein weiteres interessantes Beispiel begegnet uns bei NVIDIA. Wer auf einem Windows-System mit GeForce-Grafikkarte die laufenden Prozesse oder Dienste betrachtet, findet möglicherweise Bezeichnungen wie NVIDIA Container oder NVIDIA Display Container LS. Der Name legt zunächst nahe, dass Teile des Grafiktreibers innerhalb einer containerisierten Betriebssystemumgebung ausgeführt werden. Tatsächlich ist die Bedeutung hier eine andere.
NVIDIA Display Container unter Windows
Der NVIDIA Display Container ist Bestandteil der NVIDIA-Grafiksoftware und dient dazu, bestimmte Hintergrundfunktionen und Softwarekomponenten auszuführen. Die Bezeichnung Container beschreibt hier eine herstellerspezifische Dienst- und Prozessarchitektur. Daraus lässt sich nicht ableiten, dass der eigentliche Windows-Grafiktreiber innerhalb eines Docker-Containers oder einer vergleichbaren Betriebssystemvirtualisierung arbeitet.
Das Beispiel verdeutlicht eine wichtige begriffliche Besonderheit: Nicht jede Softwarekomponente, die als Container bezeichnet wird, verwendet tatsächlich die Isolationsmechanismen moderner Betriebssystemcontainer. Interessanterweise setzt NVIDIA in anderen Produktbereichen jedoch auf echte Containertechnologien.
Wenn GPU-Treiber als Container-Images bereitgestellt werden
Im Linux- und Rechenzentrumsumfeld existieren Lösungen, mit denen NVIDIA-GPU-Treiber beziehungsweise zugehörige Komponenten über speziell vorbereitete Container-Images bereitgestellt und verwaltet werden können. Solche Verfahren sind insbesondere für automatisierte GPU-Infrastrukturen interessant, in denen zahlreiche Systeme mit geeigneten Treiber- und Laufzeitkomponenten ausgestattet werden müssen. Die Containerisierung kann dabei die Bereitstellung, Aktualisierung und Verwaltung dieser Softwarebestandteile vereinfachen.
Allerdings ersetzt ein solches Container-Image nicht sämtliche technischen Abhängigkeiten vom Hostbetriebssystem. Gerade GPU-Treibermodule müssen weiterhin mit dem verwendeten Linux-Kernel kompatibel sein. Ihre Integration erfordert entsprechende Berechtigungen und geeignete Mechanismen für den Zugriff auf die Hardware. Der Container dient hier also vor allem als Bereitstellungs- und Verwaltungsmechanismus für bestimmte Treiberkomponenten. Das ist ein anderer Anwendungsfall als die gewöhnliche Ausführung einer Webanwendung innerhalb eines Containers.
NVIDIA Container Toolkit: GPU-Beschleunigung für containerisierte Anwendungen
Noch deutlicher wird die Flexibilität moderner Containerarchitekturen beim NVIDIA Container Toolkit. Diese Technologie ermöglicht es geeigneten Containerlaufzeitumgebungen, NVIDIA-GPUs für containerisierte Anwendungen verfügbar zu machen. Damit können beispielsweise KI-Anwendungen, wissenschaftliche Berechnungen oder andere GPU-beschleunigte Workloads innerhalb von Containern ausgeführt werden. Die Anwendungen werden gemeinsam mit ihren benötigten Bibliotheken und Laufzeitkomponenten in Container-Images bereitgestellt. Der Zugriff auf die physische GPU erfolgt über die dafür vorgesehenen Treiber- und Integrationsmechanismen des Hosts. Dabei wird die Grafikkarte nicht zwangsläufig als gewöhnliche virtuelle Hardware nachgebildet. Vielmehr erhält die containerisierte Anwendung Zugriff auf geeignete GPU-Ressourcen der darunterliegenden Infrastruktur.
Gerade bei KI-Anwendungen ist dieses Betriebsmodell interessant. Unterschiedliche Anwendungen können definierte Softwareumgebungen verwenden, während die GPU-Ressourcen über die vorhandene Infrastruktur bereitgestellt und verwaltet werden. Auch Kubernetes kann solche GPU-beschleunigten Workloads orchestrieren, sofern die Nodes entsprechend ausgestattet und konfiguriert sind. Containerisierung beschränkt sich damit längst nicht mehr auf klassische Webanwendungen. Sie kann auch ein wichtiger Bestandteil spezialisierter Rechenumgebungen sein, in denen Hardwarebeschleunigung und automatisierte Softwarebereitstellung zusammenkommen.
Unterschiedliche Technologien, unterschiedliche Aufgaben
Betrachten wir die vorgestellten Technologien gemeinsam, zeigt sich, wie unterschiedlich Virtualisierung und Isolation eingesetzt werden können. Microsoft App-V sollte die Bereitstellung von Windows-Anwendungen vereinfachen und bestimmte Installationskonflikte reduzieren. Docker und moderne Betriebssystemcontainer ermöglichen dagegen die standardisierte Ausführung von Anwendungen innerhalb isolierter Prozessumgebungen. Credential Guard und HVCI nutzen den Hypervisor wiederum, um besonders schützenswerte Betriebssystemfunktionen abzusichern. NVIDIA zeigt schließlich, dass der Begriff Container sowohl für herstellerspezifische Softwarekomponenten als auch für tatsächliche containerbasierte Bereitstellungsmodelle und GPU-beschleunigte Anwendungen verwendet wird.
Die unterschiedlichen Konzepte lassen sich deshalb nicht allein anhand ihrer Bezeichnungen vergleichen. Entscheidend sind vielmehr drei Fragen:
- Was wird isoliert oder abstrahiert? Eine vollständige Betriebssystemumgebung, ein Anwendungsprozess, bestimmte Anwendungsressourcen oder eine sicherheitskritische Betriebssystemfunktion?
- Welche technische Grundlage wird verwendet? Ein Hypervisor, Betriebssystemmechanismen, die Virtualisierung ausgewählter Ressourcen oder eine Kombination verschiedener Ansätze?
- Welches Ziel soll erreicht werden? Eine effizientere Ressourcennutzung, vereinfachte Softwarebereitstellung, bessere Verwaltbarkeit oder eine zusätzliche Sicherheitsgrenze?
Erst aus diesen Antworten ergibt sich, welche Technologie für einen bestimmten Anwendungsfall geeignet ist.
Was uns dieser Exkurs über die Zukunft der Virtualisierung zeigt
Die Beispiele aus dem Microsoft- und NVIDIA-Umfeld verdeutlichen, dass sich Virtualisierung längst nicht mehr auf vollständige virtuelle Maschinen beschränkt. Ihre grundlegenden Prinzipien werden heute auf unterschiedlichen Ebenen eingesetzt: zur Bereitstellung von Anwendungen, zur Isolation sicherheitskritischer Betriebssystemkomponenten und zur Verwaltung spezialisierter Softwareumgebungen.
Dabei entstehen nicht zwangsläufig voneinander unabhängige Technologien. Häufig werden mehrere Ansätze miteinander kombiniert. Ein Windows-System kann beispielsweise VBS zum Schutz bestimmter Betriebssystemfunktionen verwenden und gleichzeitig mit WSL 2 eine virtualisierte Linux-Umgebung für Container bereitstellen. Auf einem anderen System können containerisierte KI-Anwendungen mithilfe geeigneter NVIDIA-Technologien auf GPU-Ressourcen zugreifen. All diese Szenarien verwenden unterschiedliche Mechanismen und verfolgen unterschiedliche Ziele. Gerade deshalb ist eine präzise begriffliche Unterscheidung wichtig. Nicht jede virtuelle Umgebung ist eine virtuelle Maschine. Nicht jede isolierte Anwendung ist ein Container. Und nicht jede Technologie, die den Begriff Container verwendet, arbeitet nach denselben technischen Prinzipien.
Die eigentliche Stärke moderner Virtualisierung liegt nicht darin, sämtliche Aufgaben mit einer einzigen Technologie zu lösen. Sie besteht vielmehr darin, unterschiedliche Abstraktions- und Isolationsmechanismen gezielt miteinander zu kombinieren. Damit ergänzt dieser Exkurs unsere bisherige Betrachtung um eine weitere Erkenntnis: Virtualisierung ist längst nicht mehr nur eine Infrastrukturtechnologie. Sie ist zu einem grundlegenden Architekturprinzip moderner Betriebssysteme, Anwendungsplattformen und Sicherheitslösungen geworden.
Der Broadcom-Effekt: Wenn Lizenzpolitik zur Infrastrukturfrage wird
Ein Hypervisor ist in vielen Unternehmen eine jener Technologien, über die im täglichen Betrieb vergleichsweise wenig gesprochen wird. Solange die virtuellen Maschinen zuverlässig arbeiten, Migrationen funktionieren und die Datensicherung ihren Dienst erfüllt, besteht selten Anlass, die grundlegende Plattformentscheidung infrage zu stellen. Genau das war über viele Jahre eine der großen Stärken von VMware. Die Produkte hatten sich in zahlreichen Rechenzentren etabliert, Administrator:innen verfügten über entsprechende Erfahrungen und die vorhandenen Betriebsprozesse waren auf die Plattform abgestimmt.
Doch eine technische Infrastruktur kann unverändert zuverlässig funktionieren und trotzdem plötzlich zum Gegenstand einer strategischen Neubewertung werden. Bei VMware entstand diese Situation nicht durch einen grundlegenden technischen Rückschritt, sondern durch Veränderungen beim Eigentümer, beim Produktportfolio und bei den Lizenzmodellen. Mit der Übernahme durch Broadcom wurde aus der Frage, welche Virtualisierungsplattform technisch am besten geeignet ist, zunehmend auch die Frage, unter welchen wirtschaftlichen Bedingungen sie langfristig betrieben werden kann.
November 2023: VMware bekommt einen neuen Eigentümer
Am 22. November 2023 wurde die Übernahme von VMware durch Broadcom abgeschlossen. Damit wechselte einer der bedeutendsten Anbieter von Virtualisierungstechnologien in den Besitz eines Unternehmens, dessen Geschäft neben Halbleitern auch umfangreiche Infrastruktursoftware umfasst. Für die VMware-Kundschaft bedeutete dieser Eigentümerwechsel zunächst nicht, dass vorhandene virtuelle Maschinen anders arbeiteten oder etablierte Funktionen plötzlich verschwanden.
Die eigentlichen Veränderungen betrafen die strategische Ausrichtung des Unternehmens. Broadcom begann, das VMware-Portfolio stärker zu bündeln, Vertriebsstrukturen neu auszurichten und das bisherige Lizenzangebot grundlegend umzustellen. Aus Sicht des Herstellers sollte dadurch ein übersichtlicheres Produktportfolio entstehen, das sich stärker an integrierten Infrastrukturplattformen orientiert. Für Unternehmen, die VMware bislang gezielt für einzelne Funktionen oder bestimmte Größenordnungen ihrer Infrastruktur einsetzten, ergab sich daraus jedoch eine andere Perspektive. Sie mussten überprüfen, ob die künftig angebotenen Produktpakete weiterhin zu ihren technischen Anforderungen und wirtschaftlichen Möglichkeiten passten. Damit rückte die Lizenzierung erstmals seit Langem wieder stärker in den Mittelpunkt vieler Virtualisierungsentscheidungen.
Vom dauerhaften Nutzungsrecht zum Subscription-Modell
Eine der folgenreichsten Veränderungen wurde bereits im Dezember 2023 angekündigt: VMware stellte den Verkauf zahlreicher unbefristeter Softwarelizenzen ein und richtete sein Angebot auf zeitlich befristete Subscriptions aus. Der Unterschied ist grundlegend: Bei einer unbefristeten Lizenz erwerben Unternehmen grundsätzlich ein dauerhaftes Nutzungsrecht an der lizenzierten Softwareversion, vorbehaltlich der jeweiligen Vertragsbedingungen. Wartung, Aktualisierungen und Herstellersupport werden davon getrennt betrachtet. Bei einer Subscription ist das Nutzungsrecht dagegen an die vereinbarte Vertragslaufzeit gebunden. Die weitere Nutzung setzt eine entsprechende Berechtigung voraus. Für die Finanzplanung bedeutet dies einen Wechsel von einem Modell mit häufig höheren anfänglichen Lizenzkosten und gesonderten Wartungsverträgen zu wiederkehrenden, vertraglich gebundenen Ausgaben.
Dabei sind Subscriptions keineswegs grundsätzlich nachteilig. Sie können die Bereitstellung aktueller Softwareversionen vereinfachen und die Kosten über einen definierten Zeitraum planbar machen. Problematisch wird eine Umstellung jedoch dann, wenn sich gleichzeitig die angebotenen Produktpakete, Berechnungsgrundlagen und Beschaffungsmöglichkeiten verändern.
Was geschieht mit vorhandenen VMware-Lizenzen?
An dieser Stelle ist eine wichtige Unterscheidung erforderlich. Die Umstellung auf Subscriptions bedeutete nicht, dass sämtliche bereits erworbenen unbefristeten VMware-Lizenzen automatisch ihre Gültigkeit verloren. Bestehende Nutzungsrechte konnten grundsätzlich entsprechend den jeweiligen Lizenzbedingungen weiterbestehen. Allerdings stellte Broadcom auch die reguläre Verlängerung bisheriger Support- und Subscription-Verträge für die betroffenen unbefristeten Angebote ein. Bereits bestehende vertragliche Supportverpflichtungen sollten weiterhin erfüllt werden.
Für Administrator:innen entsteht dadurch eine Situation, die aus anderen Bereichen der IT bekannt ist: Eine Software kann technisch weiterhin funktionieren, obwohl sich ihre wirtschaftliche und supportseitige Zukunft verändert hat. Gerade bei geschäftskritischer Infrastruktur ist das keine nebensächliche Frage. Denn die Möglichkeit, einen Hypervisor weiterhin zu starten, ist nicht gleichbedeutend mit der langfristigen Verfügbarkeit von Sicherheitsupdates, Herstellersupport und kompatiblen Erweiterungen.
VMware Cloud Foundation und vSphere Foundation: Plattformen statt Einzelprodukte
Parallel zur Lizenzumstellung veränderte Broadcom die Struktur des Produktportfolios. Im Mittelpunkt standen zunächst zwei umfassendere Angebote: VMware Cloud Foundation und VMware vSphere Foundation. VMware Cloud Foundation richtet sich an den Aufbau und Betrieb integrierter Private-Cloud- und Hybrid-Cloud-Infrastrukturen. Dazu werden verschiedene Technologien für Virtualisierung, Speicher, Netzwerk und Infrastrukturverwaltung innerhalb einer gemeinsamen Plattform zusammengeführt. VMware vSphere Foundation wurde dagegen als Angebot für Unternehmen positioniert, die vor allem ihre klassische vSphere-Infrastruktur betreiben und um integrierte Verwaltungsfunktionen ergänzen möchten.
Der strategische Gedanke dahinter ist nachvollziehbar: Statt zahlreiche einzelne Produkte unabhängig voneinander zu entwickeln und zu vermarkten, konzentriert sich das Angebot stärker auf integrierte Plattformen. Allerdings passt dieser Ansatz nicht zwangsläufig zu jeder vorhandenen Infrastruktur. Ein Unternehmen, das hauptsächlich einige ESXi-Hosts mit zentraler Verwaltung betreibt, benötigt möglicherweise nicht denselben Funktionsumfang wie ein internationaler Konzern mit umfassender Private-Cloud-Strategie. Je stärker Produkte gebündelt werden, desto wichtiger wird deshalb die Frage, ob die angebotenen Funktionen tatsächlich genutzt werden und welchen wirtschaftlichen Gegenwert sie bieten. Eine umfangreichere Plattform ist nicht automatisch die passendere Plattform. Entscheidend bleibt, welche Funktionen ein Unternehmen für seine konkreten Workloads benötigt.
Wenn Prozessorkerne zur wirtschaftlichen Größe werden
Neben dem Produktportfolio veränderte sich auch die Bedeutung der physischen Hardware für die Lizenzkalkulation. Bei VMware Cloud Foundation und VMware vSphere Foundation basiert die Lizenzierung auf der Anzahl physischer Prozessorkerne der zu lizenzierenden Hosts. Dabei gilt eine Mindestanforderung von 16 Kernen je physischem Prozessor. Ein Prozessor mit acht tatsächlich vorhandenen Kernen wird für diese Berechnung daher mit 16 Kernen angesetzt. Ein Prozessor mit 24 Kernen muss dagegen mit seinen 24 Kernen berücksichtigt werden. Die Anzahl der virtuellen Maschinen ist für diese grundlegende Core-Berechnung nicht der unmittelbare Maßstab.
Ein Rechenbeispiel aus dem Rechenzentrum
Betrachten wir eine kleinere Virtualisierungsumgebung mit drei physischen Hosts. Jeder Host verfügt über zwei Prozessoren mit jeweils acht physischen Kernen. Technisch ergibt sich daraus eine Gesamtkapazität von 48 physischen Prozessorkernen. Für die Lizenzierung werden aufgrund der Mindestanforderung jedoch 16 Kerne je Prozessor berücksichtigt. Bei insgesamt sechs physischen Prozessoren ergibt sich somit eine zu lizenzierende Kapazität von 96 Kernen. Die lizenzrechtlich relevante Kernanzahl liegt in diesem Beispiel also doppelt so hoch wie die tatsächlich vorhandene Kernanzahl.
Das bedeutet nicht automatisch, dass sich die Gesamtkosten verdoppeln. Dafür müssten die konkreten Produktpreise, Vertragslaufzeiten und bisherigen Lizenzbedingungen verglichen werden. Das Beispiel zeigt jedoch, weshalb die Hardwareausstattung bei einer Lizenzneubewertung eine erhebliche Rolle spielen kann. Auch die Entscheidung für Prozessoren mit besonders vielen Kernen beeinflusst die Lizenzkalkulation unmittelbar. Die Auswahl der Serverhardware ist damit nicht mehr ausschließlich eine Frage von Leistung, Energieverbrauch und Anschaffungskosten, sondern zugleich Bestandteil der Softwarekostenplanung.
Wenn Beschaffung und Infrastrukturplanung zusammenwachsen
In klassischen Virtualisierungsprojekten wurden technische und wirtschaftliche Entscheidungen häufig getrennt vorbereitet. Administrator:innen ermittelten die erforderliche Hardwarekapazität, während Einkauf und Lizenzmanagement die benötigten Produkte und Verträge beschafften. Diese Trennung wird schwieriger, wenn die Lizenzkosten unmittelbar von der Anzahl physischer Prozessorkerne, dem gewählten Produktpaket und der Vertragslaufzeit abhängen. Bereits eine vergleichsweise kleine Änderung der Hardwarearchitektur kann dann Auswirkungen auf die langfristigen Betriebskosten haben.
Hinzu kommen weitere Fragen: Müssen sämtliche Hosts eines Clusters einheitlich lizenziert werden? Welche Funktionen sind in einem bestimmten Paket enthalten? Welche zusätzlichen Berechtigungen werden für Speicher- oder Sicherheitsfunktionen benötigt? Die Antworten hängen vom jeweiligen Produkt, der Vertragsgestaltung und dem aktuellen Lizenzmodell ab.
Deshalb genügt es nicht mehr, die Kosten einer bestehenden VMware-Umgebung ausschließlich anhand ihrer bisherigen Lizenzverträge fortzuschreiben. Unternehmen müssen vielmehr ihre tatsächliche Infrastruktur, die benötigten Funktionen und die künftigen Beschaffungsbedingungen gemeinsam betrachten.
Der Broadcom-Effekt reicht über die Lizenzrechnung hinaus
Die wirtschaftlichen Auswirkungen einer veränderten Lizenzpolitik lassen sich nicht auf einen Preisvergleich reduzieren. Viele Unternehmen haben ihre Virtualisierungsplattform über Jahre hinweg in umfangreiche Betriebsprozesse integriert. Dazu gehören beispielsweise automatisierte Bereitstellungsverfahren, Datensicherungslösungen, Monitoring, Netzwerk- und Speicherintegration sowie interne Dokumentations- und Schulungskonzepte.
Ein Wechsel der Plattform betrifft deshalb nicht nur den Hypervisor. Auch die zugehörigen Werkzeuge und die organisatorischen Abläufe müssen überprüft werden. Eine Alternative kann auf den ersten Blick deutlich günstiger erscheinen, gleichzeitig jedoch zusätzlichen Aufwand für Migration, Qualifizierung und die Anpassung bestehender Betriebsprozesse verursachen. Umgekehrt kann die Beibehaltung einer vertrauten Plattform kurzfristig den geringeren Aufwand bedeuten, langfristig aber mit höheren wiederkehrenden Kosten verbunden sein. Gerade deshalb ist eine strategische Betrachtung erforderlich, die über den nächsten Lizenzverlängerungstermin hinausreicht.
Herstellerabhängigkeit wird wieder sichtbar
Die Entwicklung verdeutlicht ein grundlegendes Risiko langfristiger Infrastrukturentscheidungen. Je stärker Unternehmen ihre technischen Prozesse auf einen bestimmten Hersteller ausrichten, desto größer kann der Aufwand werden, wenn sich dessen wirtschaftliche Rahmenbedingungen verändern. Das bedeutet nicht, dass die Entscheidung für eine integrierte Plattform grundsätzlich falsch wäre. Im Gegenteil: Einheitliche Verwaltungswerkzeuge, aufeinander abgestimmte Komponenten und klare Supportverantwortlichkeiten können erhebliche betriebliche Vorteile bieten.
Diese Vorteile besitzen jedoch einen Preis, der nicht ausschließlich in den ursprünglichen Lizenzkosten besteht. Zur Gesamtbetrachtung gehört auch die Frage, welche Alternativen verfügbar bleiben und wie aufwendig ein späterer Plattformwechsel wäre. Herstellerabhängigkeit entsteht nicht erst durch technische Inkompatibilität. Sie kann ebenso aus gewachsenen Betriebsprozessen, vertraglichen Bindungen und fehlenden Migrationsmöglichkeiten resultieren. Damit verändert sich auch die Bedeutung von Plattformalternativen: Hyper-V, Proxmox VE, Nutanix AHV oder XCP-ng werden nicht allein deshalb interessant, weil sie bestimmte technische Funktionen bereitstellen. Sie eröffnen Unternehmen unterschiedliche Möglichkeiten, ihre Abhängigkeiten und wirtschaftlichen Rahmenbedingungen neu zu gestalten.
Wechseln oder bleiben? Eine Entscheidung ohne einfache Antwort
Die Veränderungen bei VMware führen nicht zwangsläufig dazu, dass jedes Unternehmen seine Virtualisierungsplattform wechseln sollte. Für große, stark integrierte VMware-Infrastrukturen kann die Fortführung der vorhandenen Plattform weiterhin sinnvoll sein. Insbesondere dann, wenn die eingesetzten Funktionen intensiv genutzt werden und ein Wechsel erhebliche technische oder organisatorische Risiken verursachen würde. Bei kleineren Umgebungen mit überschaubaren Anforderungen kann die Bewertung anders ausfallen. Wer hauptsächlich klassische virtuelle Server betreibt und nur einen begrenzten Teil des verfügbaren Funktionsumfangs benötigt, sollte prüfen, ob andere Plattformen diese Aufgaben wirtschaftlicher erfüllen können.
Dabei müssen neben den Lizenzkosten insbesondere Migration, Datensicherung, Hochverfügbarkeit, Support, Personalqualifikation und langfristige Wartbarkeit berücksichtigt werden. Auch eine schrittweise Strategie ist denkbar. Unternehmen können beispielsweise bestehende VMware-Workloads zunächst weiterbetreiben und neue Anwendungen oder bestimmte Infrastruktursegmente auf alternativen Plattformen bereitstellen. Eine solche Vorgehensweise reduziert unter Umständen den unmittelbaren Migrationsdruck und ermöglicht es, Erfahrungen mit anderen Technologien zu sammeln.
Allerdings erhöht der parallele Betrieb mehrerer Plattformen zunächst auch die betriebliche Komplexität. Die entscheidende Frage lautet deshalb nicht, ob VMware grundsätzlich ersetzt werden sollte, sondern welche Plattformstrategie die technischen, wirtschaftlichen und organisatorischen Anforderungen eines Unternehmens langfristig am besten erfüllt.
Wenn der Markt wieder in Bewegung gerät
Damit schließt sich der Kreis zu unserer Ausgangsbeobachtung. Über viele Jahre war VMware in zahlreichen Rechenzentren eine etablierte und kaum hinterfragte Entscheidung. Andere Virtualisierungsplattformen existierten zwar, standen aber nicht überall im Mittelpunkt der Infrastrukturplanung. Die Veränderungen seit der Broadcom-Übernahme haben diese Selbstverständlichkeit infrage gestellt. Unternehmen beschäftigen sich wieder intensiver mit Lizenzmodellen, alternativen Hypervisoren und der Möglichkeit, ihre Infrastruktur langfristig unabhängiger zu gestalten.
Dabei zeigt sich, dass die Virtualisierungstechnologie selbst keineswegs an Bedeutung verloren hat. Vielmehr ist ihre strategische Bedeutung erneut sichtbar geworden. Der Broadcom-Effekt besteht deshalb nicht allein in veränderten VMware-Lizenzen. Er liegt vor allem darin, dass Unternehmen ihre Virtualisierungsstrategie wieder bewusst hinterfragen müssen. Und damit richtet sich unser Blick auf jene Plattformen, die lange Zeit im Schatten des Marktführers standen. Denn während VMware sein Geschäftsmodell verändert, stellt sich eine neue Frage: Welche Alternativen sind inzwischen technisch und organisatorisch so weit entwickelt, dass sie für den produktiven Einsatz im Unternehmensrechenzentrum ernsthaft infrage kommen?
Exkurs: Kaufen oder abonnieren? Warum Software mehr kostet als ihren Kaufpreis
Vom einmaligen Softwarekauf zur dauerhaften Zahlungsverpflichtung
‚Früher haben wir unsere Software einmal gekauft. Heute sollen wir für alles monatlich oder jährlich bezahlen.‘ Diese Aussage begegnet uns inzwischen in zahlreichen Diskussionen über moderne Softwareprodukte. Ob Microsoft 365, Adobe Creative Cloud, Sicherheitslösungen oder Virtualisierungsplattformen: Immer mehr Hersteller setzen auf zeitlich befristete Nutzungsrechte, regelmäßig wiederkehrende Zahlungen und teilweise umfangreiche Produktpakete.
Für viele Unternehmen ist diese Entwicklung zunächst schwer nachvollziehbar. Schließlich wurde Software über Jahrzehnte häufig als Investitionsgut betrachtet. Eine Lizenz wurde erworben, die Anwendung installiert und anschließend möglichst lange verwendet. Solange sie funktionierte und die betrieblichen Anforderungen erfüllte, bestand aus dieser Perspektive wenig Anlass, sie zu ersetzen. Wenn Hersteller heute stattdessen ein Abonnement verlangen, liegt eine Schlussfolgerung nahe: ‚Die wollen doch nur noch mehr Geld mit uns verdienen.‘ Ganz von der Hand zu weisen ist dieser Gedanke nicht. Wiederkehrende Einnahmen bieten Herstellern erhebliche wirtschaftliche Vorteile. Sie verbessern die Planbarkeit der Umsätze und können langfristig höhere Erlöse ermöglichen.
Allerdings greift es zu kurz, die Entwicklung ausschließlich auf Gewinninteressen zu reduzieren. Denn auch die Art und Weise, wie Software entwickelt, bereitgestellt, abgesichert und betrieben wird, hat sich grundlegend verändert.
Einmal kaufen, möglichst lange nutzen
Das klassische Lizenzmodell beruhte auf einer vergleichsweise einfachen Vorstellung. Ein Unternehmen kaufte eine bestimmte Softwareversion und erhielt dafür ein vertraglich geregeltes Nutzungsrecht. Die Anwendung konnte anschließend innerhalb der vereinbarten Bedingungen eingesetzt werden, ohne dass allein für dieses fortbestehende Nutzungsrecht regelmäßig neue Lizenzzahlungen erforderlich waren. Neue Hauptversionen wurden häufig gesondert angeboten. Wer deren Funktionen nicht benötigte, konnte zunächst bei der vorhandenen Version bleiben.
Gerade in etablierten Unternehmen entwickelte sich daraus eine nachvollziehbare wirtschaftliche Strategie. Warum sollte eine funktionierende Anwendung ersetzt werden, wenn die Mitarbeitenden damit vertraut waren und die bestehenden Geschäftsprozesse zuverlässig unterstützten? Hinzu kam, dass größere Softwaremigrationen erhebliche Aufwendungen verursachen konnten. Neue Versionen mussten getestet, Schnittstellen angepasst und Benutzer:innen gegebenenfalls geschult werden.
Das Festhalten an einer bewährten Version war deshalb nicht zwangsläufig Ausdruck technischer Rückständigkeit. In vielen Fällen handelte es sich um eine bewusste Entscheidung, Risiken und Kosten zu begrenzen. Problematisch wurde dieses Vorgehen allerdings dann, wenn aus einer zeitlich begrenzten Strategie ein dauerhaftes Prinzip entstand. Aus ‚Wir benötigen die neue Version derzeit nicht‘ wurde mitunter ‚Wir verändern möglichst nichts, solange die Anwendung noch startet‘. Damit verschob sich die Bewertung von der wirtschaftlichen Zweckmäßigkeit zur bloßen technischen Funktionsfähigkeit.
Wenn funktionierende Software trotzdem veraltet
Eine Anwendung kann über viele Jahre zuverlässig arbeiten und dennoch zunehmend zum Sicherheits- oder Betriebsrisiko werden. Das liegt daran, dass Software nicht isoliert existiert. Sie ist auf Betriebssysteme, Laufzeitbibliotheken, Datenbanken, Netzwerkprotokolle und weitere Komponenten angewiesen. Gleichzeitig verändert sich die Umgebung, in der sie eingesetzt wird.
Neue Sicherheitsanforderungen entstehen, Schnittstellen werden weiterentwickelt und bislang unbekannte Schwachstellen werden entdeckt. Eine Anwendung, die vor zehn Jahren unter den damaligen Bedingungen sicher und zuverlässig betrieben werden konnte, erfüllt deshalb nicht automatisch die heutigen Anforderungen.
Dabei müssen wir zwei unterschiedliche Situationen betrachten.
Alte Software ist nicht automatisch unsichere Software
Nicht jede ältere Softwareversion stellt zwangsläufig ein Problem dar. Wenn ein Hersteller weiterhin Sicherheitsupdates bereitstellt, die Anwendung mit unterstützten Betriebssystemen kompatibel ist und die benötigten Funktionen zuverlässig erfüllt, kann ihre weitere Nutzung durchaus sinnvoll sein. Auch sogenannte Long-Term-Servicing-Modelle verfolgen genau diesen Ansatz. Sie ermöglichen es, bestimmte Softwarestände über längere Zeiträume stabil zu betreiben, ohne ständig neue Funktionen übernehmen zu müssen.
Entscheidend ist deshalb nicht allein das Alter einer Software. Wichtiger sind ihr tatsächlicher Supportstatus, die Verfügbarkeit sicherheitsrelevanter Aktualisierungen und die Frage, ob sie innerhalb der vorhandenen Infrastruktur weiterhin verantwortbar betrieben werden kann.
Wenn der Support endet, die Nutzung aber weitergeht
Anders sieht die Situation aus, wenn eine Softwareversion ihr Supportende erreicht hat. In diesem Fall stellt der Hersteller möglicherweise keine regulären Sicherheitsupdates mehr bereit. Neu entdeckte Schwachstellen können dann dauerhaft bestehen bleiben. Dennoch finden sich in Unternehmensnetzen immer wieder Anwendungen, die aus betrieblichen Gründen über ihren vorgesehenen Lebenszyklus hinaus genutzt werden.
Die Begründungen ähneln sich häufig:
- Die Anwendung funktioniert noch zuverlässig
- Eine Migration wäre aufwendig oder kostspielig
- Die verantwortlichen Mitarbeitenden kennen nur die bisherige Version
- Eine notwendige Fachanwendung unterstützt keine neueren Betriebssysteme
- Es fehlen Zeit, Budget oder personelle Ressourcen für eine Umstellung
Solche Gründe können nachvollziehbar sein. Sie beseitigen jedoch nicht die daraus entstehenden Risiken. Die technische Nutzbarkeit einer Software ist nicht gleichbedeutend mit ihrer langfristigen Betriebssicherheit.
Installieren, konfigurieren, vergessen: Das unterschätzte Wartungsproblem
Aus meiner Sicht liegt eines der größten Probleme im Umgang mit Unternehmenssoftware nicht zwangsläufig in der Wahl des Lizenzmodells. Es liegt vielmehr in der Vorstellung, dass eine Softwareinstallation mit der erfolgreichen Inbetriebnahme weitgehend abgeschlossen sei. Gerade bei Infrastrukturprodukten begegnet uns diese Denkweise immer wieder.
Ein Server wird installiert, eine Anwendung eingerichtet und anschließend in den produktiven Betrieb überführt. Danach konzentriert sich die Aufmerksamkeit vor allem darauf, dass der Dienst verfügbar bleibt. Solange keine offensichtlichen Fehler auftreten, werden Änderungen möglichst vermieden. Sicherheitsupdates gelten als potenzielle Störungsquelle. Neue Versionen werden aufgeschoben, weil möglicherweise bestehende Schnittstellen oder Anwendungen nicht mehr funktionieren. Die Folge kann eine Infrastruktur sein, die zwar stabil erscheint, deren technischer Zustand sich aber immer weiter vom aktuellen Sicherheits- und Supportstand entfernt.
Stabilität ist nicht dasselbe wie Stillstand
Natürlich können Aktualisierungen Probleme verursachen. Ein Update kann unerwartete Wechselwirkungen auslösen, eine neue Softwareversion bestehende Funktionen verändern oder eine bisher verwendete Schnittstelle entfernen. Gerade deshalb benötigen Unternehmen geeignete Testverfahren, Wartungsfenster und Wiederherstellungsmöglichkeiten.
Die Schlussfolgerung sollte jedoch nicht lauten, Aktualisierungen grundsätzlich zu vermeiden. Vielmehr müssen Änderungen kontrolliert und nachvollziehbar durchgeführt werden. Dazu gehören unter anderem regelmäßige Sicherheitsupdates, dokumentierte Testverfahren, definierte Verantwortlichkeiten und die Möglichkeit, fehlerhafte Änderungen zurückzunehmen. Eine stabile IT-Infrastruktur zeichnet sich nicht dadurch aus, dass sie niemals verändert wird. Sie zeichnet sich dadurch aus, dass notwendige Veränderungen beherrschbar bleiben.
Warum Hersteller kontinuierliche Softwareentwicklung finanzieren müssen
Auch die Herstellerperspektive hat sich verändert. Früher wurden viele Softwareprodukte in vergleichsweise großen Versionsschritten entwickelt. Neue Hauptversionen erschienen in mehrjährigen Abständen und wurden anschließend als eigenständige Produkte vermarktet. Heute werden zahlreiche Anwendungen kontinuierlich weiterentwickelt. Sicherheitslücken müssen geschlossen, neue Betriebssystemversionen unterstützt und veränderte technische Standards berücksichtigt werden. Bei Cloud-Diensten kommen zusätzliche Aufgaben hinzu: Die Hersteller betreiben Rechenzentren, stellen Rechen- und Speicherressourcen bereit, überwachen ihre Plattformen und müssen die Verfügbarkeit der angebotenen Dienste sicherstellen. Auch die Einhaltung regulatorischer Anforderungen und die Weiterentwicklung von Sicherheitsmechanismen verursachen laufende Aufwendungen.
Ein wiederkehrendes Erlösmodell kann deshalb durchaus zur kontinuierlichen Bereitstellung und Pflege eines Produkts passen. Allerdings ist dabei eine wichtige Unterscheidung erforderlich. Bei einem Cloud-Dienst bezahlt die Kundschaft häufig nicht nur für die Software, sondern auch für den laufenden Betrieb einer technischen Plattform. Bei einer lokal installierten Software mit Subscription-Lizenz übernimmt das Unternehmen dagegen weiterhin wesentliche Teile des Betriebs selbst. Ein Softwareabonnement ist deshalb nicht automatisch mit einem Software-as-a-Service-Angebot gleichzusetzen. Ob der wiederkehrende Preis angemessen ist, lässt sich nur beurteilen, wenn die tatsächlich enthaltenen Leistungen betrachtet werden.
Warum Abonnements für Hersteller attraktiv sind
Neben den technischen Gründen dürfen wir die wirtschaftlichen Interessen der Hersteller nicht ausblenden. Wiederkehrende Einnahmen sind für Softwareunternehmen besonders attraktiv, weil sie sich besser prognostizieren lassen als unregelmäßige Verkäufe neuer Hauptversionen. Ein Subscription-Modell kann außerdem dazu beitragen, die Kundschaft langfristig an ein Produktportfolio zu binden. Je stärker Anwendungen, Daten, Verwaltungswerkzeuge und Betriebsprozesse miteinander integriert sind, desto aufwendiger wird unter Umständen ein späterer Anbieterwechsel.
Auch die Bündelung verschiedener Produkte kann wirtschaftliche Vorteile für Hersteller schaffen. Wenn Unternehmen ein umfangreiches Paket abonnieren müssen, obwohl sie nur einen Teil der enthaltenen Funktionen benötigen, kann sich ihre Kostenstruktur erheblich verändern. Damit wird deutlich: Die Umstellung auf Abonnements ist nicht ausschließlich eine technische Notwendigkeit. Sie ist ebenso eine geschäftspolitische Entscheidung. Dass ein Abonnement für einen Hersteller wirtschaftlich attraktiv ist, bedeutet allerdings noch nicht, dass es für die Kundschaft grundsätzlich unwirtschaftlich sein muss. Entscheidend ist, welche Leistungen tatsächlich benötigt werden, wie sich die Kosten über mehrere Jahre entwickeln und welche Alternativen zur Verfügung stehen.
Kaufen oder abonnieren: Eine Frage der Gesamtkosten
Ein häufiger Fehler bei Lizenzvergleichen besteht darin, ausschließlich den Kaufpreis einer unbefristeten Lizenz mit der jährlichen Subscription-Gebühr zu vergleichen. Ein solcher Vergleich kann irreführend sein. Denn auch bei einer gekauften Software entstehen während ihrer Nutzungsdauer zusätzliche Kosten. Dazu gehören Wartungsverträge, Aktualisierungen, Migrationsprojekte, Schulungen und gegebenenfalls der Erwerb neuer Hauptversionen.
Umgekehrt verursacht auch ein Abonnement nicht zwangsläufig geringere Betriebskosten. Die laufenden Lizenzzahlungen können über einen längeren Zeitraum erheblich sein. Hinzu kommen weiterhin Aufwendungen für Administration, Datensicherung, Tests und die Anpassung bestehender Prozesse.
Ein vereinfachtes Rechenbeispiel
Nehmen wir an, ein Unternehmen benötigt eine bestimmte Software für einen Zeitraum von sechs Jahren. Für die unbefristete Lizenz werden einmalig 12.000 Euro fällig. Zusätzlich kostet ein Wartungsvertrag jährlich 2.000 Euro. Alternativ wird die Software für 4.500 Euro pro Jahr als Subscription angeboten.
Unter der vereinfachenden Annahme, dass Preise und Leistungsumfang unverändert bleiben, ergibt sich folgende Betrachtung:
|
Kostenposition |
Kauf mit Wartung |
Subscription |
|
Einmaliger Lizenzkauf |
12.000 € |
0 € |
|
Jährliche Kosten |
2.000 € |
4.500 € |
|
Gesamtkosten nach 3 Jahren |
18.000 € |
13.500 € |
|
Gesamtkosten nach 6 Jahren |
24.000 € |
27.000 € |
In diesem Beispiel ist die Subscription zunächst günstiger. Bei längerer Nutzungsdauer entwickelt sich der Kauf mit Wartung dagegen wirtschaftlich vorteilhafter. Allerdings berücksichtigt die Rechnung weder Preisänderungen noch Finanzierungseffekte, Migrationskosten oder Unterschiede im Funktionsumfang. Sie zeigt deshalb keine allgemeingültige Überlegenheit eines Lizenzmodells. Vielmehr verdeutlicht sie, weshalb die Wirtschaftlichkeit immer über einen angemessenen Betrachtungszeitraum bewertet werden muss.
Ein Abonnement garantiert keine aktuelle oder sichere Software
Ein weiterer Aspekt wird in der Diskussion häufig übersehen. Die Umstellung auf ein Abonnement sorgt nicht automatisch dafür, dass Unternehmen ihre Software tatsächlich aktuell halten. Auch eine abonnierte Anwendung kann über längere Zeit ungepatcht bleiben, wenn Administrator:innen verfügbare Aktualisierungen nicht installieren. Bei lokal betriebenen Softwareprodukten verbleibt diese Verantwortung grundsätzlich beim betreibenden Unternehmen, soweit sie nicht vertraglich an einen Dienstleister übertragen wurde. Umgekehrt kann eine unbefristet lizenzierte Software über Jahre hinweg sicher betrieben werden, wenn geeignete Updates bereitstehen und konsequent eingespielt werden. Das Lizenzmodell allein entscheidet deshalb weder über die Sicherheit noch über die Qualität des Betriebs.
Der eigentliche Unterschied liegt im Lebenszyklusmanagement
Wesentlich ist vielmehr, ob Unternehmen den gesamten Lebenszyklus ihrer Software aktiv gestalten. Dazu gehören die Auswahl geeigneter Produkte, die Planung von Aktualisierungen, die regelmäßige Bewertung des Supportstatus und die rechtzeitige Vorbereitung notwendiger Migrationen. Gerade bei größeren Unternehmensanwendungen sollten diese Aufgaben nicht erst beginnen, wenn das Supportende unmittelbar bevorsteht.
Wer sich frühzeitig mit technischen Abhängigkeiten und zukünftigen Anforderungen beschäftigt, kann notwendige Veränderungen schrittweise vorbereiten. Wer dagegen über Jahre hinweg jede Aktualisierung vermeidet, schafft möglicherweise eine Situation, in der schließlich nur noch eine umfangreiche und kostspielige Migration möglich ist. Nicht das Alter einer Software allein verursacht technische Schulden, sondern vor allem der unkontrollierte Umgang mit ihren Abhängigkeiten, Sicherheitsanforderungen und notwendigen Veränderungen.
Wenn aus Kosteneinsparung technische Schulden werden
Das Festhalten an älteren Softwareversionen kann kurzfristig erhebliche Kosten vermeiden. Ein Unternehmen muss keine neuen Lizenzen beschaffen, keine Mitarbeitenden schulen und keine bestehenden Anwendungen anpassen. Langfristig können daraus jedoch technische Schulden entstehen. Mit diesem Begriff beschreiben wir den zusätzlichen Aufwand, der sich aus technischen Entscheidungen ergibt, deren Folgen erst zu einem späteren Zeitpunkt sichtbar werden.
Eine über Jahre nicht modernisierte Anwendung kann beispielsweise von einer veralteten Datenbankversion, nicht mehr unterstützten Betriebssystemkomponenten oder proprietären Schnittstellen abhängig sein. Je länger notwendige Anpassungen aufgeschoben werden, desto schwieriger kann eine spätere Migration werden. Unter Umständen stehen dann nicht mehr sämtliche Zwischenversionen oder Migrationswerkzeuge zur Verfügung. Auch das Wissen über die ursprüngliche Implementierung kann verloren gehen, wenn verantwortliche Mitarbeitende das Unternehmen verlassen.
Die vermeintliche Einsparung durch den Verzicht auf regelmäßige Modernisierung wird dann möglicherweise durch ein deutlich aufwendigeres Migrationsprojekt wieder aufgehoben. Das bedeutet nicht, dass jede neue Softwareversion unmittelbar eingeführt werden muss. Es bedeutet jedoch, dass Unternehmen bewusst entscheiden sollten, wann sie aktualisieren, welche Risiken sie vorübergehend akzeptieren und wie sie ihre langfristige Handlungsfähigkeit erhalten.
Der VMware-Fall: Wenn die Wahlfreiheit eingeschränkt wird
Kehren wir vor diesem Hintergrund zu VMware zurück. Die Umstellung auf Subscription-Lizenzen ist für sich genommen keine ungewöhnliche Entwicklung innerhalb der Softwarebranche. Auch andere Hersteller haben ihre Geschäftsmodelle in den vergangenen Jahren entsprechend verändert. Der entscheidende Punkt liegt jedoch darin, dass Unternehmen mit einer bereits etablierten Infrastruktur nicht immer frei zwischen einem Kauf- und einem Abonnementmodell wählen können. Wenn ein Hersteller den Vertrieb unbefristeter Lizenzen einstellt, verändert sich die wirtschaftliche Ausgangslage für Bestandskund:innen. Eine bislang mögliche Beschaffungsstrategie steht dann für zukünftige Lizenzierungen nicht mehr in derselben Form zur Verfügung.
Gleichzeitig können Produktbündelungen und veränderte Berechnungsgrundlagen dazu führen, dass sich die Gesamtkosten unabhängig vom tatsächlichen Nutzungsumfang verschieben. Das erklärt, weshalb die Diskussion um Broadcom und VMware deutlich emotionaler geführt wird als manche andere Umstellung auf Subscriptions. Es geht nicht ausschließlich um die Frage, ob wiederkehrende Lizenzzahlungen sinnvoll sind. Es geht auch um Planungssicherheit, bestehende Investitionen und die Möglichkeit, eine über Jahre aufgebaute Infrastruktur unter wirtschaftlich tragbaren Bedingungen fortzuführen. Ein Abonnement kann ein sinnvolles Lizenzmodell sein. Problematisch wird es insbesondere dann, wenn Unternehmen keine zu ihren Anforderungen passende Alternative mehr angeboten wird.
Die eigentliche Frage lautet: Wie wollen wir Software betreiben?
Damit kommen wir zu einer Erkenntnis, die über VMware und die Virtualisierung hinausreicht. Die Entscheidung zwischen Kauf und Abonnement sollte nicht allein von der Höhe der nächsten Rechnung abhängen. Unternehmen müssen vielmehr klären, welche Anforderungen sie an die langfristige Bereitstellung, Sicherheit und Weiterentwicklung ihrer Software stellen.
Dazu gehören Fragen wie:
- Wie lange soll eine bestimmte Softwaregeneration produktiv eingesetzt werden?
- Welche Sicherheitsupdates und Supportleistungen stehen während dieser Zeit zur Verfügung?
- Wie werden Aktualisierungen getestet und kontrolliert eingeführt?
- Welche Kosten entstehen durch Migrationen und die Anpassung vorhandener Prozesse?
- Welche vertraglichen und technischen Abhängigkeiten entstehen gegenüber dem Hersteller?
- Wie flexibel kann das Unternehmen auf veränderte Anforderungen oder Lizenzbedingungen reagieren?
Diese Fragen lassen sich nicht pauschal zugunsten eines bestimmten Lizenzmodells beantworten. Für eine langfristig stabile Fachanwendung kann eine unbefristete Lizenz mit verlässlicher Wartung wirtschaftlich sinnvoll sein. Für eine kontinuierlich weiterentwickelte Plattform mit regelmäßig benötigten Funktionen kann dagegen eine Subscription Vorteile bieten. Und bei vollständig betriebenen Cloud-Diensten kann ein wiederkehrendes Entgelt ohnehin eine andere Leistung abdecken als beim klassischen Softwarekauf. Entscheidend ist, dass die Lizenzstrategie zur technischen und organisatorischen Betriebsstrategie passt.
Fazit: Software ist kein einmaliger Anschaffungsvorgang
Die Aussage ‚Die Hersteller wollen nur mehr Geld verdienen‘ beschreibt einen Teil der wirtschaftlichen Interessen hinter modernen Subscription-Modellen. Sie erklärt jedoch nicht die gesamte Entwicklung. Software ist heute stärker vernetzt, sicherheitskritischer und häufig enger mit anderen Plattformen verbunden als in früheren Jahrzehnten. Ihre Bereitstellung endet deshalb nicht mit der Installation. Aktualisierungen, Sicherheitsmaßnahmen, Kompatibilitätsprüfungen und regelmäßige Modernisierung gehören zu einem verantwortungsvollen Betrieb.
Gleichzeitig müssen Hersteller akzeptieren, dass Unternehmen ihre Investitionen langfristig planen und bestehende Systeme nicht beliebig schnell ersetzen können. Ein wirtschaftlich tragfähiges Lizenzmodell sollte deshalb nicht nur kontinuierliche Weiterentwicklung ermöglichen, sondern auch Transparenz, Planungssicherheit und angemessene Wahlmöglichkeiten bieten. Software einmal zu kaufen bedeutet nicht, sie ohne weitere Aufwendungen dauerhaft sicher betreiben zu können. Software zu abonnieren bedeutet umgekehrt nicht, dass Aktualität, Sicherheit und wirtschaftlicher Nutzen automatisch gewährleistet sind. Letztlich entscheidet nicht das Lizenzmodell allein über die Qualität einer IT-Infrastruktur, sondern der verantwortungsvolle Umgang mit der eingesetzten Software über ihren gesamten Lebenszyklus.
Und genau diese Erkenntnis führt uns zurück zur Virtualisierung. Denn wer heute über Alternativen zu VMware nachdenkt, sollte nicht ausschließlich nach dem günstigsten Hypervisor suchen. Ebenso wichtig sind die langfristige Wartbarkeit, die verfügbaren Supportmodelle und die Frage, wie zuverlässig sich eine Plattform über viele Jahre betreiben und weiterentwickeln lässt. Damit sind wir bei den Technologien angekommen, die wir im nächsten Kapitel genauer betrachten werden: den Virtualisierungsplattformen jenseits der etablierten Marktführer.
Virtualisierung jenseits der großen Anbieter
Wer sich über viele Jahre mit Servervirtualisierung beschäftigt hat, kennt die klassische Diskussion: VMware oder Hyper-V? In zahlreichen Unternehmensrechenzentren standen diese beiden Plattformen lange im Mittelpunkt. VMware galt als etablierter Spezialist für Virtualisierung, während Microsoft mit Hyper-V eine eng in das Windows-Server-Ökosystem integrierte Alternative entwickelte. Doch diese Gegenüberstellung bildet den Markt längst nicht vollständig ab.
Parallel dazu entstanden weitere Virtualisierungslösungen, die teilweise auf offenen Technologien basieren, andere Architekturkonzepte verfolgen oder Virtualisierung als Bestandteil einer umfassenderen Infrastrukturplattform verstehen. Viele dieser Lösungen sind keineswegs neu. Sie existieren seit Jahren und werden in produktiven Umgebungen eingesetzt. Allerdings standen sie außerhalb bestimmter Anwendergruppen lange weniger im öffentlichen Fokus. Die Veränderungen rund um VMware haben das Interesse an solchen Alternativen deutlich verstärkt.
Dabei lohnt es sich, genauer hinzusehen. Denn hinter Namen wie Proxmox VE, XCP-ng oder Nutanix AHV verbergen sich unterschiedliche technische Ansätze, die weit über die Frage nach kostenlosen oder kostenpflichtigen Lizenzen hinausgehen. Wer die Virtualisierungsplattform eines Unternehmens neu bewertet, sollte deshalb nicht nur nach einem Ersatz für den bisherigen Hypervisor suchen. Vielmehr gilt es zu verstehen, welche Architektur und welches Betriebsmodell langfristig zu den eigenen Anforderungen passen.
KVM: Wenn Linux selbst zur Virtualisierungsplattform wird
Eine der wichtigsten Grundlagen alternativer Virtualisierungsplattformen ist KVM, die Kernel-based Virtual Machine. KVM wurde 2007 in den Linux-Kernel aufgenommen und ermöglicht es, Linux mithilfe der hardwaregestützten Virtualisierungsfunktionen moderner Prozessoren als Hypervisor einzusetzen. Dazu gehören insbesondere Intel VT-x und AMD-V, die wir bereits bei der Entwicklung der x86-Virtualisierung kennengelernt haben. Anders als bei einer vollständig eigenständigen Hypervisorinstallation wird die Virtualisierungsfunktion bei KVM unmittelbar in den Linux-Kernel integriert.
Ein entsprechend konfiguriertes Linux-System kann dadurch virtuelle Maschinen ausführen und zugleich auf die vorhandenen Mechanismen des Betriebssystems für Speicherverwaltung, Prozessplanung, Gerätetreiber und Sicherheit zurückgreifen.
KVM, QEMU und libvirt: Drei Komponenten, unterschiedliche Aufgaben
Im Zusammenhang mit KVM begegnen uns häufig zwei weitere Technologien: QEMU und libvirt. Obwohl diese Begriffe oftmals gemeinsam genannt werden, erfüllen sie unterschiedliche Aufgaben. KVM stellt die kernelbasierte Virtualisierungsfunktion bereit und ermöglicht die hardwarebeschleunigte Ausführung virtueller Prozessoren. QEMU übernimmt unter anderem die Bereitstellung virtueller Geräte und weiterer Bestandteile der virtuellen Maschinenumgebung. In Verbindung mit KVM können große Teile der Gastausführung hardwarebeschleunigt erfolgen. libvirt bietet wiederum eine einheitliche Verwaltungs- und Programmierschnittstelle, über die virtuelle Maschinen und weitere Virtualisierungsressourcen gesteuert werden können.
Damit entsteht eine Architektur, die sich von einem einzelnen, vollständig integrierten Virtualisierungsprodukt unterscheidet. Die einzelnen Komponenten können durch unterschiedliche Verwaltungswerkzeuge und Infrastrukturplattformen kombiniert werden. Gerade diese Offenheit hat wesentlich dazu beigetragen, dass KVM heute in zahlreichen Linux-basierten Virtualisierungslösungen eingesetzt wird.
Ist KVM ein Typ-1- oder Typ-2-Hypervisor?
Bei KVM wird die klassische Unterscheidung zwischen Typ-1- und Typ-2-Hypervisoren besonders interessant. Auf den ersten Blick könnte man KVM als Typ-2-Hypervisor betrachten, weil es innerhalb eines Linux-Betriebssystems verwendet wird. Diese Einordnung greift jedoch zu kurz. KVM ist Bestandteil des Kernels und nutzt dessen Funktionen unmittelbar zur Verwaltung der virtuellen Maschinen. Es handelt sich deshalb nicht um eine gewöhnliche Desktopanwendung, die lediglich auf einem bestehenden Betriebssystem ausgeführt wird.
Gleichzeitig besitzt KVM keine vollständig vom Linux-Kernel getrennte Hypervisorarchitektur, wie sie beispielsweise bei VMware ESXi oder dem Xen-Hypervisor anzutreffen ist. In der Praxis wird KVM deshalb häufig den Typ-1-Hypervisoren zugeordnet, obwohl seine technische Architektur die Grenzen dieser traditionellen Klassifizierung sichtbar macht. Entscheidender als die begriffliche Einordnung ist die tatsächliche Funktionsweise. KVM zeigt, dass ein allgemeines Betriebssystem und ein leistungsfähiger Hypervisor keine grundsätzlich getrennten Technologien sein müssen.
Proxmox VE: Eine vollständige Plattform auf offener Grundlage
Eine besonders bekannte Virtualisierungsplattform auf Basis von KVM ist Proxmox Virtual Environment, kurz Proxmox VE. Die Plattform kombiniert verschiedene Open-Source-Technologien zu einer integrierten Lösung für den Betrieb und die Verwaltung virtueller Infrastrukturen. Als technische Grundlage dient eine Linux-Umgebung auf Debian-Basis. Darauf aufbauend stellt Proxmox VE eine webbasierte Verwaltungsoberfläche bereit, über die virtuelle Maschinen, Container, Netzwerke und Speicherressourcen administriert werden können.
Dabei verfolgt Proxmox einen Ansatz, der sich von der bloßen Installation einzelner KVM-Komponenten unterscheidet. Administrator:innen müssen die verschiedenen Werkzeuge nicht selbst zu einer vollständigen Verwaltungsplattform zusammenstellen. Viele grundlegende Funktionen werden bereits innerhalb einer gemeinsamen Umgebung angeboten.
Virtuelle Maschinen und Linux-Container
Eine Besonderheit von Proxmox VE ist die Unterstützung zweier unterschiedlicher Virtualisierungsmodelle. Für vollständige virtuelle Maschinen verwendet die Plattform KVM in Verbindung mit QEMU. Daneben unterstützt Proxmox VE Linux Containers, kurz LXC. Während KVM virtuelle Maschinen mit eigenständigen Gastbetriebssystemen ermöglicht, teilen sich LXC-Container den Kernel des Linux-Hosts.
Damit können Administrator:innen je nach Anforderung zwischen einer vollständigen Betriebssystemvirtualisierung und einer ressourcenschonenderen Betriebssystemvirtualisierung wählen. Allerdings dürfen LXC-Container nicht mit Docker-Containern gleichgesetzt werden. LXC eignet sich insbesondere für die Bereitstellung systemorientierter Linux-Umgebungen. Docker und vergleichbare Technologien konzentrieren sich dagegen stärker auf die Paketierung und Ausführung einzelner Anwendungen. Beide Ansätze verwenden teilweise ähnliche Linux-Kernelmechanismen, verfolgen jedoch unterschiedliche Betriebsmodelle.
Cluster, Hochverfügbarkeit und Speicherintegration
Proxmox VE beschränkt sich nicht auf einzelne Virtualisierungshosts. Mehrere Server können zu einem Cluster zusammengefasst und über eine gemeinsame Verwaltungsoberfläche administriert werden. Zu den verfügbaren Funktionen gehören unter anderem die Migration virtueller Maschinen, Hochverfügbarkeitsmechanismen und die Integration unterschiedlicher Speichertechnologien. Besonders interessant ist die Unterstützung von Ceph.
Ceph ist eine verteilte Speicherplattform, mit der mehrere Server ihre Speicherressourcen innerhalb eines gemeinsamen Systems bereitstellen können. In einer geeigneten Proxmox-Architektur lässt sich dadurch eine hyperkonvergente Infrastruktur aufbauen, bei der Rechenleistung und verteilter Speicher auf denselben physischen Hosts betrieben werden. Das kann insbesondere dann interessant sein, wenn Unternehmen keine klassische zentrale SAN-Infrastruktur einsetzen möchten. Allerdings erfordert eine solche Architektur eine sorgfältige Planung von Netzwerk, Speicherkapazität, Redundanz und Ausfallverhalten. Die Verfügbarkeit entsprechender Funktionen bedeutet nicht, dass ein produktiver Cluster ohne zusätzliche Architekturüberlegungen betrieben werden sollte.
Open Source bedeutet nicht automatisch kostenloser Unternehmensbetrieb
Ein wesentlicher Unterschied zu manchen proprietären Virtualisierungsplattformen liegt im Lizenz- und Geschäftsmodell. Proxmox VE ist Open-Source-Software und kann grundsätzlich ohne den Erwerb einer klassischen Hypervisorlizenz eingesetzt werden. Für den professionellen Betrieb bietet der Hersteller kostenpflichtige Subscriptions an, die insbesondere Zugang zu einem Enterprise-Repository und unterschiedliche Supportleistungen umfassen. Damit unterscheiden sich die wirtschaftlichen Rahmenbedingungen von einem Modell, bei dem bereits das grundlegende Nutzungsrecht an der Virtualisierungssoftware an eine kostenpflichtige Subscription gebunden ist.
Allerdings entstehen auch beim Einsatz von Proxmox VE Kosten. Hardware, Datensicherung, Monitoring, Administration, Schulungen und gegebenenfalls externer Support müssen weiterhin berücksichtigt werden. Der wirtschaftliche Vorteil einer offenen Virtualisierungsplattform ergibt sich deshalb nicht allein aus dem Wegfall bestimmter Lizenzkosten, sondern aus dem Zusammenspiel von Funktionsumfang, Betriebsaufwand und langfristiger Wartbarkeit.
XCP-ng: Die Xen-Architektur als eigenständige Alternative
Während Proxmox VE auf KVM setzt, verwendet XCP-ng eine andere technische Grundlage. Die Plattform basiert auf dem Xen-Hypervisor, dessen Entwicklung bereits zu Beginn der 2000er-Jahre begann. Xen spielte eine wichtige Rolle bei der Verbreitung der Paravirtualisierung und gehörte zu den Technologien, die wir bereits im Zusammenhang mit den frühen Herausforderungen der x86-Virtualisierung betrachtet haben. XCP-ng führt diese Entwicklung innerhalb einer vollständigen Virtualisierungsplattform fort.
Historisch ist die Lösung eng mit der XenServer- und Xen-Cloud-Platform-Familie verbunden. Heute wird XCP-ng als eigenständiges Open-Source-Projekt weiterentwickelt und im professionellen Umfeld durch das Unternehmen Vates unterstützt.
Xen als Grundlage der Virtualisierung
Der Xen-Hypervisor arbeitet mit einer Architektur, bei der der Hypervisor selbst eine eigenständige Schicht zwischen Hardware und virtuellen Maschinen bildet. Eine privilegierte Verwaltungsdomäne, traditionell als Domain 0 oder Dom0 bezeichnet, übernimmt wesentliche Aufgaben bei der Verwaltung von Geräten und virtuellen Maschinen. Die eigentlichen Gastbetriebssysteme werden in weiteren Domänen ausgeführt.
Damit unterscheidet sich die Architektur deutlich von KVM, das seine Virtualisierungsfunktionen unmittelbar in den Linux-Kernel integriert. Beide Konzepte ermöglichen den produktiven Betrieb virtueller Maschinen, verwenden jedoch unterschiedliche Mechanismen zur Trennung von Hypervisor, Verwaltungsumgebung und Gastbetriebssystemen. Für Administrator:innen ist diese Unterscheidung vor allem dann relevant, wenn es um Fehlersuche, Sicherheitsarchitektur und die Wartung der Virtualisierungsplattform geht.
XAPI und Xen Orchestra: Verwaltung als eigenständige Ebene
XCP-ng verwendet mit XAPI eine zentrale Programmierschnittstelle zur Verwaltung der Virtualisierungsumgebung. Darüber lassen sich unter anderem Hosts, virtuelle Maschinen, Netzwerke und Speicherressourcen steuern. Für die übergreifende Administration mehrerer Hosts und Pools spielt Xen Orchestra eine wichtige Rolle. Xen Orchestra stellt eine webbasierte Verwaltungsumgebung bereit und ergänzt die Plattform um Funktionen für Automatisierung, Überwachung und Datensicherung.
Damit entsteht eine Architektur, bei der Hypervisor und übergeordnete Verwaltungsplattform klar voneinander unterschieden werden können. Das erinnert in gewisser Weise an die Trennung zwischen ESXi und vCenter Server, ohne dass beide Produktarchitekturen technisch identisch wären. Für Unternehmen, die bereits mit zentral verwalteten Virtualisierungsclustern arbeiten, ist dieses Konzept grundsätzlich vertraut. XCP-ng zeigt damit, dass nicht nur KVM-basierte Plattformen eine Alternative zu etablierten Virtualisierungslösungen darstellen. Auch die Xen-Architektur besitzt weiterhin ein eigenständiges Ökosystem für den professionellen Infrastrukturbetrieb.
Nutanix AHV: Virtualisierung als Bestandteil einer hyperkonvergenten Plattform
Einen anderen Ansatz verfolgt Nutanix mit AHV, dem Acropolis Hypervisor. AHV basiert ebenfalls auf KVM, wird jedoch nicht primär als isoliertes Hypervisorprodukt positioniert. Stattdessen ist die Virtualisierung eng in die hyperkonvergente Infrastrukturplattform von Nutanix eingebunden. Der Begriff Hyperkonvergenz beschreibt dabei die Zusammenführung von Rechenleistung, Speicher und deren Verwaltung innerhalb einer gemeinsamen Infrastrukturarchitektur. Anstatt getrennte Systeme für Servervirtualisierung und zentrale Speicherdienste zu betreiben, können entsprechende Funktionen innerhalb eines abgestimmten Clusters bereitgestellt werden.
AHV, AOS und Prism
Um die Nutanix-Architektur zu verstehen, müssen wir drei Komponenten unterscheiden. AHV stellt die Virtualisierungsfunktion für die Ausführung virtueller Maschinen bereit. AOS, das Acropolis Operating System, übernimmt wesentliche Funktionen der verteilten Infrastruktur- und Speicherplattform. Prism dient der zentralen Verwaltung und Überwachung der Nutanix-Umgebung. Die Komponenten sind darauf ausgelegt, innerhalb einer gemeinsamen Plattform zusammenzuarbeiten. Dadurch kann sich der Verwaltungsaufwand gegenüber einer Architektur mit mehreren voneinander unabhängigen Infrastrukturprodukten reduzieren. Allerdings entsteht zugleich eine stärkere Bindung an das jeweilige Plattformökosystem.
Nicht nur der Hypervisor entscheidet
Nutanix verdeutlicht besonders anschaulich, weshalb ein Vergleich ausschließlich auf Hypervisorebene häufig zu kurz greift. Ein Unternehmen, das AHV einsetzt, entscheidet sich in vielen Fällen nicht lediglich für eine Alternative zu VMware ESXi. Es bewertet vielmehr eine umfassendere Infrastrukturarchitektur, bei der Virtualisierung, Speicherverwaltung und Plattformadministration eng miteinander verbunden sind.
Das kann Vorteile hinsichtlich Integration und einheitlicher Verwaltung bieten. Gleichzeitig müssen Unternehmen berücksichtigen, welche Hardwarekonfigurationen, Lizenzmodelle und Supportleistungen für ihre konkrete Umgebung verfügbar sind. Die Frage lautet deshalb weniger, ob AHV technisch dieselben Aufgaben wie ESXi erfüllen kann. Entscheidend ist, ob die gesamte Nutanix-Architektur zum vorgesehenen Betriebsmodell passt.
OpenStack: Wenn aus Virtualisierung eine eigene Cloudplattform wird
Eine weitere wichtige Entwicklung außerhalb der klassischen Hypervisorprodukte ist OpenStack. Allerdings müssen wir OpenStack zunächst richtig einordnen – OpenStack ist selbst kein Hypervisor. Vielmehr handelt es sich um eine offene Infrastrukturplattform, mit der Rechen-, Speicher- und Netzwerkressourcen als Cloud-Dienste bereitgestellt und verwaltet werden können. Für die Ausführung virtueller Maschinen kann OpenStack auf unterschiedliche Virtualisierungstechnologien zurückgreifen. Besonders verbreitet ist dabei die Kombination aus KVM, QEMU und libvirt. Damit begegnen uns technische Komponenten wieder, die wir bereits bei Proxmox VE kennengelernt haben. Der Unterschied liegt in der übergeordneten Architektur.
Von der Hostverwaltung zur Infrastrukturautomatisierung
Während klassische Virtualisierungsplattformen häufig von der Verwaltung einzelner Hosts und Cluster ausgehen, verfolgt OpenStack einen stärker dienstorientierten Ansatz. Benutzer:innen sollen virtuelle Maschinen, Netzwerke und Speicherressourcen über definierte Schnittstellen selbstständig bereitstellen können. Dazu verwendet OpenStack unterschiedliche Dienste mit klar abgegrenzten Aufgaben.
Beispielsweise übernimmt Nova die Verwaltung von Compute-Ressourcen, während Neutron virtuelle Netzwerkfunktionen bereitstellt. Cinder ermöglicht blockbasierten Speicher, und Keystone stellt zentrale Identitäts- und Authentifizierungsfunktionen bereit. Diese Dienste arbeiten innerhalb einer gemeinsamen Cloudarchitektur zusammen. Damit lassen sich Infrastrukturumgebungen aufbauen, die hinsichtlich ihrer Bedienung und Automatisierung eher an Public-Cloud-Plattformen erinnern als an eine klassische Hostverwaltung.
OpenStack ist keine einfache VMware-Ersatzinstallation
Gerade deshalb sollte OpenStack nicht als unmittelbarer Ersatz für eine kleine VMware- oder Hyper-V-Umgebung betrachtet werden. Die Plattform eröffnet umfangreiche Möglichkeiten zur Automatisierung und zum Aufbau eigener Private-Cloud-Infrastrukturen. Allerdings erfordern Installation, Integration und laufender Betrieb entsprechendes Fachwissen. Hinzu kommen die Verwaltung zahlreicher Plattformdienste, deren Aktualisierung sowie die Abstimmung von Netzwerk-, Speicher- und Sicherheitsarchitektur.
OpenStack eignet sich deshalb insbesondere für Organisationen, die eine umfassende, automatisierbare Infrastrukturplattform benötigen und über die erforderlichen betrieblichen Ressourcen verfügen. OpenStack zeigt, wie sich klassische Virtualisierung zu einem Cloud-Betriebsmodell weiterentwickeln kann, ohne dass dafür zwingend ein proprietärer Hypervisor erforderlich ist.
Nicht jede Alternative verfolgt dasselbe Ziel
Die bisher betrachteten Lösungen verdeutlichen, dass der Markt jenseits von VMware und Hyper-V keineswegs einheitlich ist. Proxmox VE verbindet KVM-basierte Maschinenvirtualisierung und LXC-Container innerhalb einer integrierten Verwaltungsplattform. XCP-ng setzt auf den Xen-Hypervisor und eine eigenständige Verwaltungsarchitektur mit XAPI und Xen Orchestra. Nutanix AHV integriert KVM-basierte Virtualisierung in eine umfassendere hyperkonvergente Infrastruktur. OpenStack wiederum verwendet Virtualisierung als technische Grundlage für eine automatisierbare Cloudplattform.
Damit unterscheiden sich diese Lösungen nicht nur in ihren Funktionen, sondern bereits in der Frage, welches Problem sie vorrangig lösen sollen. Ein Unternehmen, das eine überschaubare Servervirtualisierung betreiben möchte, stellt andere Anforderungen als ein Rechenzentrumsbetreiber, der eine mandantenfähige Private Cloud bereitstellen will. Ebenso unterscheiden sich die Bedürfnisse einer Organisation mit vorhandener zentraler Speicherinfrastruktur von denen eines Unternehmens, das bewusst auf hyperkonvergente Systeme setzt. Die Wahl einer Virtualisierungsplattform ist deshalb immer auch eine Entscheidung über die Architektur und das Betriebsmodell der gesamten Infrastruktur.
Offene Technologien schaffen Möglichkeiten, aber keine automatische Unabhängigkeit
Gerade im Zusammenhang mit den veränderten VMware-Lizenzmodellen wird häufig auf Open Source als mögliche Alternative verwiesen. Tatsächlich bieten offene Technologien wichtige Vorteile. Der Quellcode ist unter den jeweiligen Lizenzbedingungen zugänglich, und Unternehmen können bestimmte Komponenten unabhängig von einem einzelnen proprietären Produkt einsetzen. Auch die Möglichkeit, zwischen unterschiedlichen Dienstleistern und Supportangeboten zu wählen, kann die langfristige Handlungsfreiheit verbessern.
Allerdings wäre es falsch, daraus eine vollständige Unabhängigkeit abzuleiten. Auch Open-Source-Plattformen besitzen spezifische Verwaltungswerkzeuge, Datenformate, Schnittstellen und Betriebsmodelle. Wer seine Infrastruktur über Jahre hinweg eng auf eine bestimmte Plattform ausrichtet, entwickelt entsprechende technische und organisatorische Abhängigkeiten. Zudem unterscheiden sich Community-Unterstützung und vertraglich zugesicherter Herstellersupport erheblich. Für geschäftskritische Umgebungen müssen deshalb auch bei offenen Lösungen klare Verantwortlichkeiten für Sicherheitsupdates, Fehlerbehebung und langfristige Wartung definiert werden. Open Source kann die Abhängigkeit von proprietären Lizenzmodellen reduzieren. Es ersetzt jedoch weder eine durchdachte Infrastrukturarchitektur noch ein professionelles Betriebs- und Supportkonzept.
Wenn aus Alternativen ernsthafte Infrastrukturentscheidungen werden
Die Entwicklungen rund um Broadcom haben das Interesse an alternativen Virtualisierungsplattformen verstärkt. Doch die technischen Grundlagen dieser Lösungen entstanden nicht erst mit der VMware-Übernahme. KVM, Xen und die darauf aufbauenden Verwaltungsplattformen besitzen eine eigenständige Entwicklungsgeschichte. Ihre Bedeutung ergibt sich deshalb nicht ausschließlich aus den wirtschaftlichen Veränderungen eines Wettbewerbers. Vielmehr bieten sie unterschiedliche Antworten auf die Frage, wie virtuelle Infrastrukturen aufgebaut, verwaltet und langfristig betrieben werden können.
Für Unternehmen eröffnet das zusätzliche Möglichkeiten. Sie können ihre vorhandenen Virtualisierungsstrategien überprüfen, alternative Betriebsmodelle erproben und ihre Abhängigkeiten bewusster gestalten. Allerdings sollte eine solche Neubewertung nicht allein durch kurzfristigen Kostendruck bestimmt werden. Entscheidend ist, ob eine Plattform die benötigten Funktionen zuverlässig bereitstellt und sich dauerhaft in die vorhandenen Betriebsprozesse integrieren lässt.
Damit stellt sich eine weitere Frage, die über einzelne Produkte hinausgeht. Wenn heute so viele unterschiedliche Virtualisierungsplattformen verfügbar sind, welche davon werden in der Praxis tatsächlich eingesetzt? Genau dieser Frage widmen wir uns im nächsten Kapitel. Denn zwischen technischer Verfügbarkeit, öffentlicher Wahrnehmung und tatsächlicher Verbreitung in Unternehmensrechenzentren können erhebliche Unterschiede bestehen.
Exkurs: Everything Xen – Von griechischen Gästen zur modernen Virtualisierungsplattform
Everything Xen – ein musikalischer Einstieg in die Virtualisierungsgeschichte
Wer sich an die Rockmusik der 1990er-Jahre erinnert, dem dürfte der Song Everything Zen der britischen Band Bush aus dem Jahr 1994 noch ein Begriff sein. Unser Titel Everything Xen ist eine kleine Anspielung darauf – allerdings beschäftigen wir uns hier weniger mit Musik als mit einer bemerkenswerten Entwicklung der IT-Geschichte. Denn Xen begegnet uns in unterschiedlichen Zusammenhängen: als eigenständiger Hypervisor, als Grundlage kommerzieller Virtualisierungsprodukte, als Bestandteil großer Cloudinfrastrukturen und als technische Basis von Open-Source-Plattformen wie XCP-ng.
Dabei gehört Xen zu den Technologien, die die Entwicklung der x86-Virtualisierung wesentlich mitgeprägt haben. Seine Geschichte reicht von einem universitären Forschungsprojekt über die Entstehung kommerzieller Virtualisierungsplattformen bis hin zum Einsatz in großen Rechenzentren und Cloudumgebungen. Um diese Entwicklung zu verstehen, müssen wir allerdings etwas weiter zurückblicken. Und wie Sheldon Cooper, der Penny die Grundlagen der Physik erklären möchte, beginnen auch wir unsere Geschichte im antiken Griechenland.
Xen, Xenos und die Bedeutung des Fremden
Unser kleiner Ausflug ins antike Griechenland führt uns zunächst auf die Agora, den zentralen öffentlichen Versammlungs- und Marktplatz einer griechischen Stadt. Hier wurde gehandelt, diskutiert und über politische Angelegenheiten gesprochen. Und während wir uns noch umsehen, begegnet uns ein Fremder.
Die Griechen hätten ihn möglicherweise als xénos (ξένος) bezeichnet. Je nach Zusammenhang konnte dieser Begriff einen Fremden, einen Gast oder auch einen Gastfreund beschreiben. Damit sind wir der Herkunft unseres Hypervisornamens bereits erstaunlich nahe. Im antiken Griechenland besaß insbesondere die Xenía (ξενία), die Gastfreundschaft, eine wichtige gesellschaftliche Bedeutung. Sie beschrieb ein Verhältnis gegenseitiger Verpflichtungen zwischen Gastgeber:innen und Gästen. Fremde konnten aufgenommen und versorgt werden, während von ihnen im Gegenzug die Achtung bestimmter Regeln und gesellschaftlicher Erwartungen verlangt wurde.
Diese sprachliche Herkunft passt bemerkenswert gut zur Virtualisierung. Schließlich ermöglicht ein Hypervisor, unterschiedliche Gastbetriebssysteme auf einer gemeinsamen physischen Infrastruktur auszuführen. Der Host stellt die erforderlichen Ressourcen bereit, während die Gäste innerhalb definierter Grenzen eigenständig arbeiten.
Dabei ist die Namensgebung keineswegs eine nachträgliche Interpretation. Das Forschungsprojekt, aus dem Xen hervorging, trug ursprünglich den Namen XenoServer. Dahinter stand die Idee, fremde beziehungsweise zuvor unbekannte Aufgaben auf gemeinsam genutzten Computersystemen auszuführen und dabei geeignete Mechanismen für Isolation und Ressourcenkontrolle bereitzustellen. Der spätere Name Xen übernahm diesen sprachlichen Ursprung. Und damit schließt sich unser kleiner Ausflug auf die Agora: Was im antiken Griechenland das Verhältnis zwischen Gastgeber:innen und Fremdem beschrieb, findet sich in gewisser Weise auch in der Architektur moderner Virtualisierungssysteme wieder. Xen beschreibt damit bereits im Namen ein wesentliches Prinzip der Virtualisierung: Eine gemeinsame Infrastruktur stellt unterschiedlichen Gästen kontrolliert Ressourcen zur Verfügung.
Cambridge: Die Geburtsstätte von Xen
Von der Agora im antiken Griechenland führt uns unsere Reise nun rund zweieinhalb Jahrtausende weiter nach Cambridge in England. Am Computer Laboratory der Universität Cambridge beschäftigte sich um die Jahrtausendwende eine Forschungsgruppe mit neuen Konzepten zur gemeinsamen Nutzung verteilter Rechenressourcen. Im Mittelpunkt stand das bereits erwähnte XenoServer-Projekt, aus dessen Umfeld schließlich der Xen-Hypervisor hervorging.
Zu den prägenden Persönlichkeiten dieser Entwicklung gehörten Ian Pratt, Keir Fraser und weitere Forschende, die sich mit der effizienten Bereitstellung und Isolation virtueller Ausführungsumgebungen beschäftigten. Dabei ging es nicht darum, einen weiteren kommerziellen Virtualisierungsserver zu entwickeln. Vielmehr untersuchte die Forschungsgruppe grundlegende Fragen der Ressourcenverwaltung, Leistungsfähigkeit und Isolation in gemeinsam genutzten Computersystemen.
Aus diesen Überlegungen entstand eine Hypervisorarchitektur, die bewusst auf die Zusammenarbeit zwischen Gastbetriebssystem und Virtualisierungsschicht setzte. Dieser Ansatz unterschied sich von den damals etablierten Verfahren zur vollständigen Virtualisierung und sollte insbesondere eine möglichst effiziente Ausführung virtueller Maschinen ermöglichen. Die technische Grundlage dafür bildete die Paravirtualisierung – ein Konzept, das wir uns gleich noch genauer ansehen werden.
2003: Xen wird öffentlich verfügbar
Im Jahr 2003 war es schließlich so weit: Aus den Forschungsarbeiten in Cambridge ging mit Xen ein öffentlich verfügbarer Open-Source-Hypervisor hervor. Im selben Jahr veröffentlichten die beteiligten Wissenschaftler:innen ihre Arbeit Xen and the Art of Virtualization. Darin stellten sie nicht nur eine neue Virtualisierungsarchitektur vor, sondern präsentierten auch Ergebnisse zur Leistungsfähigkeit und Isolation virtueller Maschinen. Damit wurde aus einem Forschungsansatz eine Technologie, die sich erstmals auch außerhalb der Universität untersuchen, einsetzen und weiterentwickeln ließ.
Besonders bemerkenswert war dabei, dass Xen einen anderen Weg einschlug als die damals bereits etablierten Virtualisierungslösungen. Anstatt dem Gastbetriebssystem eine vollständig unveränderte Hardwareumgebung vorzuspielen, bezogen die Entwickler:innen das Betriebssystem bewusst in die Virtualisierung ein. Der Gedanke dahinter war ebenso einfach wie wirkungsvoll: Warum sollte ein Hypervisor sämtliche Besonderheiten der Hardware vor einem Gastbetriebssystem verbergen, wenn dieses stattdessen gezielt mit der Virtualisierungsschicht zusammenarbeiten könnte? Aus dieser Überlegung entstand eines der charakteristischen Merkmale der frühen Xen-Architektur: die Paravirtualisierung.
Paravirtualisierung: Wenn das Gastbetriebssystem mitarbeitet
Um die Idee hinter Xen zu verstehen, müssen wir uns zunächst von einer gewohnten Vorstellung lösen. Bei der vollständigen Virtualisierung wird ein Gastbetriebssystem grundsätzlich so ausgeführt, als würde es auf einem eigenen Computer arbeiten. Der Hypervisor stellt die dafür notwendige virtuelle Hardwareumgebung bereit und kontrolliert die Zugriffe auf die tatsächlichen Ressourcen. Die frühen Xen-Entwickler:innen entschieden sich für einen anderen Ansatz. Was wäre, wenn das Gastbetriebssystem bereits wüsste, dass es sich innerhalb einer virtuellen Maschine befindet?
Genau darauf beruhte die Paravirtualisierung. Das Gastbetriebssystem wurde gezielt angepasst, sodass es bestimmte privilegierte Operationen nicht mehr unmittelbar auszuführen versuchte. Stattdessen konnte es die benötigten Funktionen direkt beim Hypervisor anfordern. Dafür verwendete Xen sogenannte Hypercalls. Das Prinzip ähnelt den Systemaufrufen, mit denen Anwendungen Dienste des Betriebssystemkernels anfordern. Während ein Systemaufruf die Grenze zwischen Anwendung und Betriebssystem überbrückt, ermöglicht ein Hypercall die gezielte Kommunikation zwischen Gastbetriebssystem und Hypervisor.
Dadurch mussten bestimmte Hardwareoperationen nicht mehr aufwendig abgefangen oder nachgebildet werden. Die Besonderheit von Xen lag somit nicht allein in der Virtualisierung selbst, sondern in der bewussten Zusammenarbeit zwischen Gastbetriebssystem und Hypervisor.
Leistungsfähigkeit durch bewusste Anpassung
Die Idee hinter der Paravirtualisierung war durchaus überzeugend: Wenn ein Gastbetriebssystem bereits weiß, dass es virtualisiert ausgeführt wird, kann es gezielt mit dem Hypervisor zusammenarbeiten, anstatt eine vollständig unveränderte Hardwareumgebung vorauszusetzen. Gerade in den frühen Jahren der x86-Virtualisierung bot dieser Ansatz erhebliche Vorteile. Bestimmte privilegierte Operationen mussten nicht mehr aufwendig abgefangen oder durch andere Befehlsfolgen ersetzt werden. Das ermöglichte eine effiziente Ausführung virtueller Maschinen, obwohl die Prozessoren noch nicht über die heute selbstverständlichen Virtualisierungserweiterungen verfügten.
Allerdings hatte diese Zusammenarbeit ihren Preis. Das Gastbetriebssystem musste entsprechend angepasst werden können. Bei Linux war dies aufgrund des verfügbaren Quellcodes grundsätzlich möglich. Bei proprietären Betriebssystemen wie Microsoft Windows ließ sich eine solche Anpassung dagegen nicht ohne Weiteres durchführen. Damit stellte sich eine entscheidende Frage: Wie konnte Xen auch Betriebssysteme virtualisieren, deren Kernel nicht verändert werden konnte?
Die Antwort lieferten schließlich die Prozessorhersteller. Mit Intel VT-x und AMD-V wurden hardwaregestützte Virtualisierungsfunktionen verfügbar, die auch die Ausführung unveränderter Gastbetriebssysteme ermöglichten. Xen konnte diese Erweiterungen nutzen und sein ursprüngliches Konzept um die hardwaregestützte vollständige Virtualisierung, kurz HVM (Hardware Virtual Machine), ergänzen. Die Paravirtualisierung verschwand dadurch allerdings nicht. Vielmehr entwickelte sich ein Zusammenspiel unterschiedlicher Verfahren. Auch hardwarevirtualisierte Gäste können paravirtualisierte Treiber und Schnittstellen verwenden, um beispielsweise die Kommunikation mit virtuellen Netzwerk- und Speichergeräten effizienter zu gestalten. Später entstand mit PVH zudem ein Xen-Virtualisierungsmodus, der hardwaregestützte Prozessorvirtualisierung mit paravirtualisierten Schnittstellen kombiniert. Aus einem ursprünglich auf angepasste Gastbetriebssysteme angewiesenen Hypervisor entwickelte sich damit eine flexiblere Architektur, die unterschiedliche Virtualisierungsverfahren miteinander verbinden konnte.
Dom0 und DomU: Die besondere Architektur von Xen
Nachdem wir nun wissen, wie Xen virtuelle Maschinen ausführen kann, stellt sich die nächste Frage: Wer verwaltet eigentlich diese Maschinen und stellt ihnen die benötigten Ressourcen zur Verfügung? Bei VMware ESXi übernimmt der Hypervisor gemeinsam mit seinen integrierten Verwaltungs- und Gerätetreiberkomponenten wesentliche Aufgaben des Virtualisierungsbetriebs. Bei KVM sind entsprechende Funktionen eng mit dem Linux-Kernel und den darauf aufbauenden Verwaltungsprozessen verbunden.
Xen verfolgt in seiner klassischen Architektur einen anderen Ansatz. Der eigentliche Hypervisor wird unmittelbar auf der physischen Hardware ausgeführt. Er übernimmt grundlegende Aufgaben wie die Prozessorplanung, Speicherisolation und Kontrolle privilegierter Zugriffe. Zahlreiche Verwaltungs- und Gerätefunktionen werden dagegen in gesonderte Ausführungsumgebungen ausgelagert. Diese bezeichnet Xen als Domänen.
Dabei unterscheidet die klassische Architektur zwischen einer besonders privilegierten Verwaltungsdomäne und den gewöhnlichen Gastdomänen.
Dom0: Die privilegierte Verwaltungsumgebung
Die erste und besonders berechtigte Domäne trägt den Namen Domain 0, kurz Dom0. Sie wird beim Start einer klassischen Xen-Umgebung eingerichtet und verwendet üblicherweise ein Linux-basiertes Betriebssystem mit den erforderlichen Verwaltungswerkzeugen und Treibern. Dom0 übernimmt Aufgaben, die wir bei anderen Virtualisierungsplattformen häufig unmittelbar mit dem Hypervisor verbinden. Dazu gehören beispielsweise das Erstellen und Starten virtueller Maschinen, die Verwaltung virtueller Geräte sowie die Bereitstellung von Ein- und Ausgabediensten für Gastdomänen.
Hier liegt eine wichtige architektonische Besonderheit. Dom0 ist nicht der Hypervisor selbst. Sie ist eine eigenständige Betriebssystemumgebung, die mit besonderen Berechtigungen auf die Funktionen des Xen-Hypervisors zugreifen kann. Diese Trennung ermöglicht es, den eigentlichen Hypervisor vergleichsweise schlank zu halten und zahlreiche Verwaltungsaufgaben außerhalb seiner unmittelbar privilegierten Ausführungsschicht abzuwickeln. Allerdings entsteht dadurch auch eine besondere Verantwortung: Die Sicherheit und Zuverlässigkeit von Dom0 sind für den Betrieb einer klassischen Xen-Infrastruktur von zentraler Bedeutung.
DomU: Die eigentlichen Gastbetriebssysteme
Neben Dom0 existieren die gewöhnlichen Gastdomänen, die traditionell als DomU bezeichnet werden. In ihnen werden die virtuellen Maschinen mit ihren jeweiligen Gastbetriebssystemen und Anwendungen ausgeführt. Eine DomU kann beispielsweise einen Linux-Server oder eine Windows-Server-Installation beherbergen. Welche Virtualisierungsmechanismen dabei zum Einsatz kommen, hängt vom jeweiligen Gasttyp und der Konfiguration ab. Möglich sind unter anderem paravirtualisierte Gäste sowie hardwarevirtualisierte Umgebungen mit zusätzlichen paravirtualisierten Gerätetreibern.
Für die Kommunikation mit virtuellen Netzwerk- und Speichergeräten verwendet die klassische Xen-Architektur häufig ein Frontend- und Backend-Modell. Dabei befindet sich ein Frontend-Treiber innerhalb der Gastdomäne, während ein entsprechender Backend-Dienst in einer dafür zuständigen Domäne arbeitet – häufig in Dom0. Über definierte Kommunikationsmechanismen können beide Seiten Daten austauschen, ohne dass die Gastdomäne unmittelbar auf sämtliche physischen Geräte zugreifen muss. Damit entsteht eine kontrollierte Trennung zwischen den eigentlichen Arbeitslasten und den Komponenten, die ihnen Infrastrukturressourcen bereitstellen.
Warum diese Trennung wichtig ist
Die Aufteilung in Hypervisor, Verwaltungsdomäne und Gastdomänen gehört zu den grundlegenden Architekturmerkmalen von Xen. Sie ermöglicht eine klare funktionale Trennung zwischen der Ausführung virtueller Maschinen und zahlreichen Aufgaben ihrer Verwaltung. Dabei ist die klassische Dom0-Architektur nicht die einzige denkbare Xen-Konfiguration. In spezialisierten Umgebungen können beispielsweise zusätzliche Treiberdomänen oder andere Verwaltungsmodelle eingesetzt werden.
Für das Verständnis von XenServer und XCP-ng bleibt das traditionelle Domänenmodell jedoch besonders hilfreich. Es erklärt, weshalb sich Xen nicht einfach als Linux-basierter Hypervisor beschreiben lässt und warum seine Architektur anders aufgebaut ist als die von KVM. Xen trennt den eigentlichen Hypervisor bewusst von zahlreichen Verwaltungs- und Gerätefunktionen. Dom0 übernimmt dabei eine privilegierte Rolle, während DomU die isolierten Gastbetriebssysteme ausführt.
XenSource: Aus Forschung wird ein Unternehmen
Während die Forschenden in Cambridge ihre Virtualisierungsarchitektur kontinuierlich weiterentwickelten, wuchs auch außerhalb der Universität das Interesse an Xen. Die Möglichkeit, mehrere Betriebssysteme effizient auf einer gemeinsamen Hardwareplattform auszuführen, war längst nicht mehr ausschließlich für die Wissenschaft interessant. Unternehmen suchten nach Möglichkeiten, ihre Server besser auszulasten, Infrastrukturen zu konsolidieren und den Verwaltungsaufwand zu reduzieren.
Damit eröffnete sich für Xen ein neuer Weg. Aus dem Umfeld der Universität Cambridge entstand 2005 das Unternehmen XenSource, an dessen Gründung unter anderem Ian Pratt beteiligt war. Das Ziel bestand darin, die offene Xen-Technologie um professionelle Verwaltungswerkzeuge, geeignete Installations- und Betriebsverfahren sowie kommerzielle Supportangebote zu ergänzen. Aus einem Forschungsprojekt sollte eine Virtualisierungsplattform werden, die sich auch im produktiven Unternehmensbetrieb zuverlässig einsetzen ließ.
Dabei verfolgte XenSource einen Ansatz, der uns aus der Open-Source-Welt durchaus vertraut ist: Die grundlegende Technologie blieb offen, während darauf aufbauend kommerzielle Produkte und Dienstleistungen entwickelt wurden. Für Xen bedeutete dies einen wichtigen Entwicklungsschritt. Der Hypervisor musste nun nicht mehr ausschließlich technisch überzeugen, sondern sich auch an den Anforderungen professioneller IT-Infrastrukturen messen lassen. Und damit betrat ein Unternehmen die Bühne, dessen Name vielen Administrator:innen bis heute vertraut sein dürfte: Citrix.
2007: Citrix übernimmt XenSource
Im August 2007 kündigte Citrix Systems die Übernahme von XenSource an. Wenige Wochen später, im Oktober desselben Jahres, wurde die Transaktion abgeschlossen. Für Citrix war dies ein strategisch bedeutsamer Schritt. Das Unternehmen war bereits für seine Lösungen zur zentralisierten Bereitstellung von Anwendungen und Desktopumgebungen bekannt. Mit XenSource erhielt Citrix nun zusätzlich eine eigene Technologie für die Virtualisierung vollständiger Betriebssysteme. Damit ließ sich das bestehende Portfolio um eine weitere Infrastrukturebene ergänzen. Die Virtualisierungsplattform XenServer, die bereits aus der Produktentwicklung von XenSource hervorgegangen war, wurde unter Citrix weiterentwickelt und vermarktet.
Allerdings ist an dieser Stelle eine Unterscheidung wichtig. Citrix übernahm mit XenSource ein Unternehmen und dessen kommerzielle Produkte, nicht jedoch die ausschließliche Kontrolle über sämtliche Entwicklungen des offenen Xen-Hypervisors. Die zugrunde liegende Open-Source-Technologie blieb weiterhin verfügbar und wurde von einer breiteren Entwicklergemeinschaft mitgestaltet. So entstanden zwei eng miteinander verbundene, aber keineswegs identische Entwicklungslinien: Auf der einen Seite der offene Xen-Hypervisor als technische Grundlage, auf der anderen Seite kommerzielle Virtualisierungsplattformen mit zusätzlichen Verwaltungs-, Integrations- und Supportfunktionen. Xen war damit nicht mehr nur der Name eines Hypervisors. Es entwickelte sich zunehmend zu einem Begriff, der innerhalb unterschiedlicher Produkte und Infrastrukturlösungen auftauchte.
XenServer, XenApp und XenDesktop: Ein Name, unterschiedliche Technologien
Mit der Übernahme von XenSource begann für Citrix nicht nur ein neues Kapitel in der Servervirtualisierung. Auch innerhalb des Produktportfolios gewann der Name Xen zunehmend an Bedeutung. Wer sich in den folgenden Jahren mit Citrix beschäftigte, begegnete ihm beinahe überall: XenServer, XenApp, XenDesktop und XenCenter gehörten zu den bekanntesten Bezeichnungen. Auf den ersten Blick konnte dadurch der Eindruck entstehen, dass all diese Produkte auf derselben technischen Grundlage aufbauten.
Tatsächlich war das jedoch nicht der Fall. XenServer bezeichnete die eigentliche Servervirtualisierungsplattform. Hier kam der Xen-Hypervisor zum Einsatz, um mehrere virtuelle Maschinen auf einer gemeinsamen physischen Infrastruktur auszuführen. XenApp verfolgte dagegen ein anderes Ziel. Die Lösung ermöglichte es, Anwendungen zentral auf Servern bereitzustellen und Benutzer:innen über geeignete Sitzungs- und Übertragungsverfahren zugänglich zu machen. Ihre technologische Entwicklung reichte über frühere Citrix-Produkte wie MetaFrame und Presentation Server zurück. XenDesktop konzentrierte sich auf die Bereitstellung virtueller Desktopumgebungen. Dabei konnten vollständige Windows-Desktops zentral betrieben und den Benutzer:innen über das Netzwerk zur Verfügung gestellt werden.
Für die Ausführung solcher virtuellen Desktops war allerdings nicht zwingend XenServer erforderlich. XenDesktop unterstützte auch andere Virtualisierungsplattformen, darunter entsprechende Lösungen von VMware und Microsoft. Und schließlich gab es noch XenCenter, das Verwaltungswerkzeug für XenServer-Umgebungen. Damit wurde deutlich, dass Citrix unter dem gemeinsamen Namensbestandteil Xen unterschiedliche Technologien und Produktfunktionen zusammenführte. Die einheitliche Bezeichnung war vor allem Ausdruck einer übergreifenden Produkt- und Markenstrategie.
Warum die begriffliche Unterscheidung wichtig ist
Gerade Administrator:innen, die bereits vor vielen Jahren mit Citrix-Produkten gearbeitet haben, dürften sich an diese Namensvielfalt erinnern. In älteren Dokumentationen, Schulungsunterlagen und Infrastrukturkonzepten begegnen uns die damaligen Produktbezeichnungen noch heute. Dabei ist es wichtig, zwischen der technischen Grundlage und der jeweiligen Aufgabe eines Produkts zu unterscheiden.
- XenServer stellte die Virtualisierungsinfrastruktur bereit, auf der unterschiedliche Gastbetriebssysteme ausgeführt werden konnten
- XenApp kümmerte sich um die zentrale Bereitstellung von Anwendungen, während XenDesktop vollständige Desktopumgebungen für Benutzer:innen zugänglich machte
- XenCenter wiederum diente der Administration der XenServer-Plattform
Diese Produkte konnten innerhalb einer gemeinsamen Citrix-Infrastruktur zusammenarbeiten, waren jedoch keineswegs zwangsläufig auf denselben Hypervisor angewiesen. Ein Unternehmen konnte beispielsweise XenDesktop für die Bereitstellung virtueller Windows-Arbeitsplätze einsetzen, während die zugrunde liegenden virtuellen Maschinen auf VMware vSphere oder Microsoft Hyper-V betrieben wurden. Die Produktnamen allein verrieten deshalb nicht, welche Virtualisierungstechnologie tatsächlich innerhalb des Rechenzentrums verwendet wurde.
Später veränderte Citrix seine Produktbezeichnungen erneut. Aus XenApp und XenDesktop wurden im Rahmen einer umfassenderen Neuausrichtung unter anderem Citrix Virtual Apps und Citrix Virtual Desktops. Auch daran erkennen wir, dass Produktnamen und technische Architekturen nicht zwangsläufig dieselbe Entwicklung durchlaufen. Nicht überall, wo Citrix den Namen Xen verwendete, arbeitete im Hintergrund tatsächlich der Xen-Hypervisor. Entscheidend war stets die jeweilige Funktion des Produkts innerhalb der Gesamtinfrastruktur.
Xen in der Cloud: Eine Technologie wird zur Infrastrukturgrundlage
Während Citrix XenServer als kommerzielle Virtualisierungsplattform weiterentwickelte, begann für den offenen Xen-Hypervisor an anderer Stelle eine mindestens ebenso interessante Entwicklung. Die ersten großen Public-Cloud-Plattformen standen vor einer Herausforderung, die uns aus der klassischen Servervirtualisierung bereits vertraut ist – allerdings in einer völlig anderen Größenordnung. Wie lassen sich Rechenressourcen zahlreichen Unternehmen und Benutzer:innen gleichzeitig zur Verfügung stellen, ohne dass sich deren Systeme gegenseitig beeinflussen? Eine entscheidende Voraussetzung dafür war die zuverlässige Isolation unterschiedlicher Kundenumgebungen auf gemeinsam genutzter Hardware. Und genau hier kam Xen ins Spiel. Als Amazon Web Services im Jahr 2006 seinen Dienst Elastic Compute Cloud, kurz EC2, vorstellte, setzte die Plattform auf Xen-basierte Virtualisierung. Der Hypervisor ermöglichte es, virtuelle Serverinstanzen unterschiedlicher Kund:innen auf derselben physischen Infrastruktur auszuführen.
Was in Cambridge als Forschungsprojekt begonnen hatte, wurde damit zur technischen Grundlage eines neuen Geschäftsmodells. Unternehmen mussten physische Server nicht mehr zwangsläufig selbst beschaffen und betreiben. Stattdessen konnten sie virtuelle Rechenressourcen bedarfsgerecht über eine Cloudplattform bereitstellen und nach dem jeweiligen Nutzungsmodell bezahlen. Natürlich bestand diese Entwicklung aus weit mehr als einem Hypervisor. Automatisierung, Netzwerkvirtualisierung, Speicherbereitstellung und die Abrechnung genutzter Ressourcen waren ebenso entscheidend. Doch Xen bildete einen wichtigen Teil des technischen Fundaments. Aus einer Technologie zur effizienten gemeinsamen Nutzung einzelner Computersysteme wurde so ein Baustein für die Bereitstellung von Infrastruktur als Dienstleistung – Infrastructure as a Service.
Von Xen zu Nitro: Wenn sich die Infrastruktur weiterentwickelt
So bedeutend Xen für die frühen EC2-Generationen war, blieb auch Amazon nicht bei seiner ursprünglichen Architektur stehen. Mit zunehmender Größe der AWS-Infrastruktur stiegen die Anforderungen an Leistungsfähigkeit, Sicherheit und die effiziente Verwaltung physischer Ressourcen. Insbesondere die Bereitstellung virtueller Netzwerk- und Speichergeräte verursachte Aufgaben, die innerhalb klassischer Virtualisierungsarchitekturen durch Softwarekomponenten auf den Hosts übernommen werden mussten. Amazon begann deshalb, immer mehr dieser Funktionen auf spezialisierte Hardware auszulagern. Daraus entwickelte sich das AWS Nitro System, dessen Einführung 2017 öffentlich vorgestellt wurde.
Nitro kombiniert dedizierte Hardwarekomponenten für Infrastrukturaufgaben mit einem schlanken Hypervisor. Funktionen wie Netzwerk- und Speicheranbindung sowie bestimmte Management- und Sicherheitsaufgaben werden dabei durch spezialisierte Komponenten unterstützt. Dadurch kann ein größerer Anteil der Hostressourcen für die eigentlichen Kund:inneninstanzen bereitgestellt werden. Gleichzeitig verändert sich die Sicherheitsarchitektur, weil zentrale Infrastrukturaufgaben nicht mehr in derselben Weise von einer umfangreichen privilegierten Hostumgebung abhängig sind. Für neue EC2-Instanzfamilien setzte AWS zunehmend auf diese Architektur. Xen-basierte Instanztypen verschwanden dadurch allerdings nicht schlagartig, sondern wurden über einen längeren Zeitraum parallel zu Nitro-basierten Angeboten betrieben.
Eine neue Architektur statt eines einfachen Hypervisorwechsels
Interessant ist an dieser Entwicklung weniger der Wechsel von einer konkreten Virtualisierungstechnologie zu einer anderen. Vielmehr zeigt AWS Nitro, wie sich die Aufgabenverteilung innerhalb einer Virtualisierungsplattform verändern kann. Bei der klassischen Xen-Architektur übernimmt Dom0 zahlreiche Verwaltungs- und Gerätefunktionen. Nitro verlagert wesentliche Aufgaben dagegen auf spezialisierte Hardwarekomponenten und verwendet für die verbleibende Virtualisierungsschicht einen vergleichsweise schlanken Hypervisor. Beide Konzepte verfolgen das Ziel, virtuelle Ausführungsumgebungen zuverlässig voneinander zu isolieren. Sie unterscheiden sich jedoch deutlich darin, wie die dafür erforderlichen Funktionen technisch umgesetzt werden.
Damit schließt sich ein weiterer Kreis unserer bisherigen Betrachtungen. Xen half dabei, die frühen Public-Cloud-Infrastrukturen aufzubauen. Die daraus entstandenen Anforderungen an Skalierbarkeit, Leistungsfähigkeit und Isolation förderten wiederum neue Virtualisierungsarchitekturen. Eine Technologie kann die Entstehung eines Marktes entscheidend ermöglichen, ohne deshalb dauerhaft die einzige oder technisch bevorzugte Grundlage seiner weiteren Entwicklung bleiben zu müssen.
2013: Xen wird ein Projekt der Linux Foundation
Während Xen längst in Unternehmensrechenzentren und großen Cloudinfrastrukturen eingesetzt wurde, stellte sich zunehmend eine andere Frage: Wer sollte eigentlich über die langfristige Entwicklung dieser Technologie entscheiden? Schließlich hatte sich das ursprüngliche Forschungsprojekt aus Cambridge inzwischen zu einer Virtualisierungsgrundlage entwickelt, an der zahlreiche Unternehmen ein eigenes Interesse besaßen. Neben Citrix gehörten dazu unter anderem Prozessorhersteller, Anbieter von Infrastruktursoftware und Betreiber großer Cloudplattformen. Sie alle nutzten Xen für unterschiedliche Zwecke und waren darauf angewiesen, dass der Hypervisor zuverlässig weiterentwickelt wurde.
Im April 2013 folgte deshalb ein wichtiger organisatorischer Schritt: Das Xen Project wurde unter dem Dach der Linux Foundation als gemeinschaftlich getragenes Open-Source-Projekt neu aufgestellt. Damit erhielt Xen einen herstellerübergreifenden organisatorischen Rahmen, in dem unterschiedliche Unternehmen und Entwickler:innen an einer gemeinsamen technologischen Grundlage arbeiten konnten. Das war keineswegs selbstverständlich. Zwar war der Xen-Hypervisor bereits seit seiner Veröffentlichung als Open-Source-Software verfügbar. Die kommerzielle Entwicklung rund um XenSource und später Citrix hatte jedoch gezeigt, wie eng offene Technologien mit den Interessen einzelner Unternehmen verbunden sein können. Die Linux Foundation bot nun einen Rahmen, um die Zusammenarbeit zwischen verschiedenen Beteiligten langfristig zu organisieren und die Entwicklung des Hypervisors unabhängig von einer einzelnen Produktstrategie fortzuführen. Xen blieb damit nicht nur eine offene Technologie, sondern erhielt auch eine stärker gemeinschaftlich organisierte Grundlage für seine weitere Entwicklung.
Ein Hypervisor für unterschiedliche Einsatzgebiete
Mit der organisatorischen Neuaufstellung veränderte sich nicht plötzlich die grundlegende Aufgabe des Xen-Hypervisors. Allerdings wurde zunehmend deutlich, dass seine Architektur auch außerhalb klassischer Rechenzentren interessante Möglichkeiten eröffnete. Denn die Fähigkeit, unterschiedliche Betriebssysteme und Anwendungen innerhalb voneinander isolierter Ausführungsumgebungen zu betreiben, ist nicht ausschließlich für Servervirtualisierung und Cloudplattformen relevant. Auch in industriellen Anlagen, eingebetteten Systemen und spezialisierten Hardwareplattformen müssen unterschiedliche Softwarekomponenten häufig auf gemeinsamen Prozessorressourcen ausgeführt werden.
Dabei können sehr unterschiedliche Anforderungen zusammentreffen. Eine Komponente benötigt möglicherweise besonders kurze und vorhersagbare Reaktionszeiten. Eine andere übernimmt Kommunikationsaufgaben, verarbeitet Benutzereingaben oder stellt eine umfangreichere Anwendungsumgebung bereit. Gerade in der Fahrzeugtechnik lässt sich dieses Prinzip anschaulich nachvollziehen. Moderne Fahrzeuge verfügen über zahlreiche softwaregesteuerte Funktionen, die teilweise unterschiedliche Anforderungen an Sicherheit, Zuverlässigkeit und zeitliches Verhalten stellen. Virtualisierung kann dabei helfen, bestimmte Ausführungsumgebungen voneinander zu trennen und vorhandene Hardware effizienter zu nutzen.
Von der Servervirtualisierung zur Systemisolation
Allerdings dürfen wir solche Einsatzszenarien nicht einfach mit einer klassischen XenServer- oder XCP-ng-Installation gleichsetzen. In eingebetteten Umgebungen stehen häufig andere Anforderungen im Vordergrund als in einem Unternehmensrechenzentrum. Dazu gehören beispielsweise ein möglichst geringer Ressourcenbedarf, eine kontrollierte Gerätezuordnung, definierte Startabläufe und gegebenenfalls die Unterstützung zeitkritischer Anwendungen. Auch die Architektur kann sich unterscheiden. Nicht jede Xen-basierte Umgebung benötigt dieselben Verwaltungsmechanismen, die wir zuvor anhand von Dom0 und DomU kennengelernt haben. Für bestimmte Anwendungsfälle lassen sich beispielsweise schlankere oder stärker statisch konfigurierte Domänenarchitekturen einsetzen.
Dabei ist allerdings eine wichtige Einschränkung zu beachten: Der Einsatz eines Hypervisors garantiert für sich genommen weder Echtzeitfähigkeit noch funktionale Sicherheit. Solche Eigenschaften müssen durch die gesamte Systemarchitektur, geeignete Hardware und entsprechende Entwicklungs- und Prüfverfahren gewährleistet werden. Dennoch verdeutlichen diese Einsatzgebiete, wie vielseitig die ursprüngliche Xen-Idee geworden ist. Was in Cambridge mit der gemeinsamen Nutzung von Rechenressourcen begann, entwickelte sich zu einer Technologie, die auch für die kontrollierte Trennung unterschiedlicher Softwareumgebungen eingesetzt werden kann. Xen ist damit weit mehr als die technische Grundlage von XenServer oder XCP-ng. Der Hypervisor steht für ein Virtualisierungskonzept, das sowohl in großen Cloudinfrastrukturen als auch in spezialisierten eingebetteten Systemen Anwendung finden kann.
XCP-ng: Die offene XenServer-Tradition lebt weiter
Kehren wir nach unserem Ausflug in die großen Cloudrechenzentren und spezialisierten Systemarchitekturen noch einmal zur klassischen Servervirtualisierung zurück. Dort begegnet uns mit XCP-ng eine Plattform, die wir bereits im vorherigen Kapitel kennengelernt haben und deren Entstehung eng mit der Geschichte von XenServer verbunden ist. Die Abkürzung steht für Xen Cloud Platform – new generation und erinnert damit bewusst an die frühere Xen Cloud Platform, die bereits einen offenen Ansatz zur Bereitstellung Xen-basierter Virtualisierungsinfrastrukturen verfolgte.
Im Jahr 2018 entstand XCP-ng vor dem Hintergrund veränderter Lizenz- und Funktionsbedingungen bei der kostenlosen XenServer-Edition. Bestimmte Funktionen, die zuvor ohne zusätzliche kommerzielle Lizenzierung genutzt werden konnten, waren nun an andere Lizenzbedingungen gebunden. Für Teile der Anwendergemeinschaft stellte sich deshalb die Frage, wie sich eine leistungsfähige Xen-basierte Virtualisierungsplattform weiterhin offen entwickeln und betreiben ließe. Die Antwort war XCP-ng. Das Projekt knüpfte an die technische Entwicklung von XenServer und der früheren Xen Cloud Platform an, verfolgte jedoch das Ziel, eine eigenständige Open-Source-Distribution mit transparenten Entwicklungsprozessen und ohne proprietäre Freischaltung zentraler Plattformfunktionen bereitzustellen. Damit entstand nicht einfach ein weiterer Hypervisor. Vielmehr entwickelte sich eine vollständige Virtualisierungsplattform, die den Xen-Hypervisor mit den notwendigen Verwaltungs-, Netzwerk- und Speicherkomponenten zu einer produktiv nutzbaren Infrastruktur verbindet.
Von der Community zur professionellen Plattform
Ein wesentliches Merkmal von XCP-ng ist das Zusammenspiel zwischen gemeinschaftlicher Entwicklung und kommerzieller Unterstützung. Die Plattform wird als Open-Source-Projekt weiterentwickelt. Gleichzeitig bietet das Unternehmen Vates professionelle Dienstleistungen und Supportmodelle für den produktiven Einsatz an. Dieses Konzept erinnert an die ursprüngliche Entwicklung von XenSource: Eine offene technische Grundlage wird durch professionelle Betriebs- und Supportangebote ergänzt. Allerdings steht bei XCP-ng nicht die Entwicklung eines proprietär lizenzierten Hypervisors im Mittelpunkt. Vielmehr soll die Plattform selbst offen verfügbar bleiben, während Unternehmen bei Bedarf zusätzliche Unterstützung für ihre Infrastruktur erhalten können.
Damit schließt sich ein historischer Kreis. Was einst als akademisches Forschungsprojekt begann und später über XenSource und Citrix in kommerzielle Virtualisierungsprodukte einfloss, fand mit XCP-ng einen weiteren eigenständigen Entwicklungsweg. XCP-ng zeigt damit, dass sich aus einer etablierten Virtualisierungstechnologie auch dann neue Plattformen entwickeln können, wenn sich die wirtschaftlichen und organisatorischen Rahmenbedingungen ihrer bisherigen Produktfamilie verändern.
Xen Orchestra ergänzt die Infrastrukturverwaltung
Ein Hypervisor allein macht allerdings noch keine vollständig verwaltbare Virtualisierungsinfrastruktur aus. Wer mehrere Hosts, zahlreiche virtuelle Maschinen und unterschiedliche Speicherressourcen betreibt, benötigt Werkzeuge, mit denen sich diese Umgebung zentral administrieren, überwachen und automatisieren lässt. Hier kommt Xen Orchestra ins Spiel.
Die webbasierte Verwaltungsplattform wurde ebenfalls im Umfeld von Vates entwickelt und ermöglicht die zentrale Administration von XCP-ng sowie unterstützten XenServer-Umgebungen. Administrator:innen können darüber virtuelle Maschinen verwalten, Hosts und Pools überwachen sowie wiederkehrende Verwaltungsaufgaben automatisieren. Besonders interessant sind die integrierten Funktionen zur Datensicherung. Xen Orchestra unterstützt unterschiedliche Backup- und Wiederherstellungsverfahren für virtuelle Maschinen. Dazu gehören beispielsweise geplante Sicherungen und die Wiederherstellung vollständiger virtueller Systeme.
Damit übernimmt die Plattform Aufgaben, für die in anderen Virtualisierungsumgebungen teilweise zusätzliche Verwaltungs- oder Datensicherungsprodukte eingesetzt werden. Allerdings hängt der tatsächlich verfügbare Funktionsumfang von der jeweiligen Bereitstellungs- und Supportvariante ab.
Drei Ebenen, eine gemeinsame Infrastruktur
An dieser Stelle lohnt es sich, die Architektur noch einmal bewusst auseinanderzuhalten. Der Xen-Hypervisor bildet die grundlegende Virtualisierungsschicht. Er ermöglicht die isolierte Ausführung der Gastbetriebssysteme und übernimmt zentrale Aufgaben der Ressourcenverwaltung. XCP-ng ergänzt diese Grundlage um eine vollständige Hostplattform mit Betriebssystemkomponenten, Treibern, Netzwerk- und Speicherintegration sowie den notwendigen Verwaltungsdiensten. Xen Orchestra stellt darüber eine zentrale Managementebene bereit, über die sich auch größere Virtualisierungsumgebungen administrieren, überwachen und sichern lassen.
Diese Aufteilung erinnert an Architekturprinzipien, die uns bereits von anderen Virtualisierungsplattformen vertraut sind. Der Hypervisor übernimmt die eigentliche Ausführung virtueller Maschinen. Die Hostplattform stellt die erforderlichen Infrastrukturkomponenten bereit, während eine übergeordnete Verwaltungsumgebung den Betrieb mehrerer Systeme koordiniert. Gerade diese Trennung macht deutlich, weshalb wir Xen, XenServer und XCP-ng nicht einfach als unterschiedliche Namen für dieselbe Software betrachten dürfen. Xen ist die technische Grundlage, XCP-ng eine darauf aufbauende Virtualisierungsplattform und Xen Orchestra eine ergänzende Verwaltungs- und Betriebsumgebung. Gemeinsam bilden sie ein eigenständiges Ökosystem für professionelle Servervirtualisierung.
Citrix Hypervisor und die Rückkehr des Namens XenServer
Während sich XCP-ng als eigenständige Open-Source-Plattform etablierte, nahm auch die kommerzielle Produktgeschichte von XenServer ihren weiteren Verlauf. Und wie so häufig in der IT-Branche blieb dabei nicht einmal der Produktname unverändert. Aus XenServer wurde zwischenzeitlich Citrix Hypervisor. Im Jahr 2019 führte Citrix diese Bezeichnung im Rahmen seiner damaligen Produktstrategie ein. Damit sollte die Virtualisierungsplattform stärker unter der gemeinsamen Citrix-Marke positioniert werden.
Die zugrunde liegende Technologie verschwand dadurch allerdings nicht. Auch unter dem Namen Citrix Hypervisor blieb die Plattform eng mit der bisherigen XenServer-Entwicklung und dem offenen Xen-Hypervisor verbunden. Später erfolgte eine erneute organisatorische und strategische Neuausrichtung. XenServer wurde wieder als eigenständige Produktmarke etabliert und wird inzwischen von der XenServer-Organisation innerhalb des Cloud Software Group-Umfelds weiterentwickelt. Damit begegnet uns ein Phänomen, das wir aus vielen Bereichen der Unternehmens-IT kennen: Technologien können über Jahrzehnte bestehen bleiben, während Herstellerstrukturen, Produktnamen und Lizenzmodelle mehrfach verändert werden.
Gleiche Wurzeln bedeuten nicht identische Produkte
Für Administrator:innen kann diese Entwicklung durchaus verwirrend sein. Wer heute ältere Dokumentationen, Schulungsunterlagen oder Installationsanleitungen durchsucht, stößt möglicherweise auf XenServer, Citrix Hypervisor und später wieder XenServer. Dabei handelt es sich nicht zwangsläufig um unterschiedliche Virtualisierungstechnologien, sondern teilweise um verschiedene Produktgenerationen derselben Entwicklungslinie. Allerdings wäre es ebenso falsch, sämtliche Versionen einfach gleichzusetzen. Zwischen einzelnen Produktgenerationen können sich unterstützte Hardwareplattformen, Verwaltungsfunktionen, Sicherheitsmechanismen, Lizenzbedingungen und Supportmodelle erheblich unterscheiden.
Eine Anleitung für Citrix Hypervisor lässt sich deshalb nicht automatisch auf eine aktuelle XenServer-Installation übertragen. Und auch XCP-ng ist trotz seiner gemeinsamen technischen Herkunft keine bloße Umbenennung von XenServer, sondern eine eigenständig entwickelte Plattform. Der Name allein verrät uns also weder den technischen Funktionsumfang noch die Lizenzbedingungen oder den konkreten Entwicklungsstand einer Virtualisierungsumgebung.
Xen, XenServer und XCP-ng: Was gehört eigentlich zusammen?
Nach unserer Reise von der Agora im antiken Griechenland über Cambridge und die frühen Cloudrechenzentren bis zu den heutigen Virtualisierungsplattformen ist es an der Zeit, die verschiedenen Begriffe noch einmal zusammenzuführen. Denn inzwischen haben wir festgestellt, dass Xen keineswegs nur für ein einzelnes Produkt steht.
Am Anfang steht das Xen Project mit seinem offenen Hypervisor. Er bildet die eigentliche Virtualisierungsschicht, auf der unterschiedliche Gastbetriebssysteme voneinander isoliert ausgeführt werden können. Die Entwicklung des Hypervisors wird gemeinschaftlich im Rahmen des Xen Project unter dem Dach der Linux Foundation organisiert.
Aus dem universitären Forschungsumfeld entstand 2005 XenSource. Das Unternehmen überführte die Xen-Technologie in kommerziell nutzbare Virtualisierungsprodukte und wurde 2007 von Citrix übernommen. Eine dieser Produktlinien war XenServer. Die Plattform kombiniert den Xen-Hypervisor mit zusätzlichen Komponenten für den professionellen Betrieb virtueller Maschinen. Dazu gehören insbesondere Verwaltungsdienste sowie Funktionen zur Integration von Netzwerk- und Speicherressourcen. Zwischenzeitlich wurde XenServer unter der Bezeichnung Citrix Hypervisor vermarktet, bevor der ursprüngliche Produktname wieder eingeführt wurde.
Die offene Entwicklungslinie: Von XCP zu XCP-ng
Parallel zur kommerziellen Produktentwicklung entstand mit der Xen Cloud Platform, kurz XCP, eine offene Plattform, die auf den Technologien des Xen-Ökosystems aufbaute. Sie verfolgte das Ziel, nicht nur den Hypervisor selbst, sondern auch weitere Komponenten für den Aufbau und die Verwaltung einer Xen-basierten Virtualisierungsinfrastruktur bereitzustellen. An diese Entwicklungsgeschichte knüpft XCP-ng an.
Die 2018 entstandene Plattform führt wesentliche technische Konzepte der XenServer-Familie in einer eigenständigen Open-Source-Distribution fort. Dabei ist wichtig, dass XCP-ng nicht einfach mit der historischen Xen Cloud Platform gleichgesetzt werden darf. Beide gehören zur Entwicklungsgeschichte des Xen-Ökosystems, sind jedoch unterschiedliche Projekte und Produktgenerationen.
XAPI und Xen Orchestra: Die Verwaltungsebene
Neben dem Hypervisor und den darauf aufbauenden Plattformen begegnen uns zwei weitere Begriffe, die insbesondere für den praktischen Betrieb wichtig sind. XAPI bezeichnet die Verwaltungs- und Programmierschnittstelle beziehungsweise den zugehörigen Verwaltungsdienst, über den XenServer- und XCP-ng-Umgebungen gesteuert werden können. Darüber lassen sich beispielsweise virtuelle Maschinen erstellen, konfigurieren und verwalten sowie Host- und Poolfunktionen ansprechen. XAPI gehört damit nicht zum eigentlichen Xen-Hypervisor, sondern zur darüberliegenden Verwaltungsarchitektur. Xen Orchestra setzt wiederum auf dieser Verwaltungsebene auf.
Die webbasierte Plattform ermöglicht es, unterstützte XenServer- und XCP-ng-Infrastrukturen zentral zu administrieren, zu überwachen und zu automatisieren. Ergänzend stehen Funktionen zur Datensicherung und Wiederherstellung virtueller Maschinen zur Verfügung. Damit ergibt sich eine klare technische Aufgabenteilung. Der Xen-Hypervisor stellt die grundlegenden Virtualisierungsmechanismen bereit. XenServer und XCP-ng bilden darauf aufbauende Hostplattformen. XAPI ermöglicht deren programmatische Verwaltung, während Xen Orchestra zusätzliche zentrale Betriebsfunktionen bereitstellt.
Eine gemeinsame Herkunft, unterschiedliche Entwicklungswege
Betrachten wir diese Zusammenhänge, wird deutlich, weshalb die Bezeichnung Xen allein nur wenig über eine konkrete Infrastruktur aussagt. Sie kann den offenen Hypervisor meinen, auf eine historische Produktgeneration verweisen oder Bestandteil des Namens einer vollständigen Virtualisierungsplattform sein. Hinzu kommt, dass gemeinsame technische Wurzeln nicht zwangsläufig identische Entwicklungsziele bedeuten. Während das Xen Project die grundlegende Virtualisierungstechnologie weiterentwickelt, verfolgen XenServer und XCP-ng jeweils eigene Produktstrategien, Veröffentlichungszyklen und Supportmodelle.
Die verschiedenen Projekte bleiben technologisch miteinander verbunden, entwickeln sich organisatorisch und funktional jedoch nicht vollständig parallel. Xen ist die gemeinsame technologische Grundlage. XenServer und XCP-ng sind unterschiedliche Plattformen, die auf dieser Grundlage aufbauen. Und mit XAPI und Xen Orchestra kommen weitere Komponenten hinzu, die aus der reinen Virtualisierung eine verwaltbare Infrastruktur machen.
Everything Xen: Eine Technologie mit bemerkenswerter Geschichte
Damit endet unsere kleine Zeitreise, die uns vom antiken Griechenland über die Universität Cambridge bis in die Rechenzentren großer Cloudanbieter geführt hat. Was als akademisches Forschungsprojekt begann, entwickelte sich zu einer der einflussreichsten offenen Virtualisierungstechnologien der x86-Welt.
Xen zeigte bereits zu einer Zeit, als hardwaregestützte Virtualisierung noch keine Selbstverständlichkeit war, wie sich unterschiedliche Betriebssysteme effizient auf gemeinsam genutzter Hardware ausführen lassen. Mit der Paravirtualisierung beschritt das Projekt dabei einen eigenen technischen Weg, der die weitere Entwicklung moderner Hypervisorarchitekturen wesentlich mitprägte. Später wurde Xen zur Grundlage kommerzieller Virtualisierungsplattformen, unterstützte den Aufbau früher Public-Cloud-Infrastrukturen und erschloss weitere Einsatzgebiete jenseits klassischer Unternehmensrechenzentren.
Unternehmen wurden gegründet und übernommen, Produkte umbenannt, Lizenzmodelle verändert und neue Plattformen entwickelt. Doch der offene Xen-Hypervisor blieb über all diese Veränderungen hinweg eine eigenständige technologische Grundlage. Mit XenServer und XCP-ng existieren bis heute unterschiedliche Virtualisierungsplattformen, deren Entwicklungsgeschichte eng mit Xen verbunden ist.
Und damit kehren wir noch einmal dorthin zurück, wo unsere Geschichte ihren Anfang nahm: ins antike Griechenland. Der Begriff xénos bezeichnete einen Fremden, einen Gast oder einen Gastfreund. In der Virtualisierung begegnet uns dieses Prinzip in technischer Form wieder. Unterschiedliche Gastbetriebssysteme teilen sich eine gemeinsame physische Infrastruktur, ohne ihre Eigenständigkeit aufgeben zu müssen. Aus einem griechischen Begriff für den Gast wurde so der Name einer Technologie, die seit mehr als zwei Jahrzehnten dazu beiträgt, unterschiedlichsten Betriebssystemen auf gemeinsamer Hardware einen eigenen, kontrollierten Platz zu geben. Vielleicht ist das die schönste Verbindung zwischen dem Namen Xen und seiner technischen Bedeutung. Und vielleicht geht es uns nach diesem ausführlichen Ausflug in die Virtualisierungsgeschichte ein wenig wie Penny, nachdem Sheldon Cooper versucht hat, ihr die Grundlagen der Physik zu erklären. Nach all den historischen Hintergründen, technischen Zusammenhängen und architektonischen Besonderheiten bleibt am Ende womöglich nur eine einzige Erkenntnis hängen: Fig Newtons wurden nicht nach dem berühmten Physiker Isaac Newton benannt, sondern nach Newton, einer Stadt in Massachusetts. Aber immerhin haben wir unterwegs auch etwas über Virtualisierung gelernt. Everything Xen – eine Geschichte über Gäste, Gastgeber und die bemerkenswerte Entwicklung moderner IT-Infrastrukturen.
Wer virtualisiert eigentlich womit?
Nach unserer Reise durch mehrere Jahrzehnte Virtualisierungsgeschichte stellt sich nun eine Frage, die angesichts der aktuellen Entwicklungen wieder besonders interessant geworden ist: Wer setzt heute eigentlich welche Virtualisierungsplattform ein? Lange Zeit schien die Antwort zumindest im klassischen Unternehmensrechenzentrum relativ eindeutig. VMware hatte sich als eine der prägenden Plattformen etabliert, Microsoft entwickelte Hyper-V zu einer ernsthaften Alternative und mit KVM, Xen sowie darauf aufbauenden Lösungen entstanden weitere Virtualisierungsmöglichkeiten.
Doch inzwischen hat sich die Ausgangssituation verändert. Die Übernahme von VMware durch Broadcom und die anschließenden Veränderungen bei Produktangeboten und Lizenzmodellen haben viele Unternehmen dazu veranlasst, ihre bisherigen Infrastrukturentscheidungen erneut zu überprüfen. Plattformen wie Microsoft Hyper-V, Proxmox VE oder Nutanix AHV rücken dadurch wieder stärker in den Mittelpunkt strategischer Überlegungen.
Aber bedeutet das tatsächlich, dass VMware bereits Marktanteile verliert? Profitiert Microsoft von dieser Entwicklung? Und wie verbreitet sind offene Virtualisierungsplattformen wie Proxmox VE inzwischen wirklich? Um diese Fragen zu beantworten, reicht ein Blick auf einzelne Herstellerangaben oder vermeintlich eindeutige Marktanteilsstatistiken nicht aus. Wir müssen vielmehr unterschiedliche Perspektiven miteinander verbinden: wirtschaftliche Marktanalysen, die strategische Bewertung der Anbieter und Daten über den beobachteten Einsatz konkreter Technologien. Und dabei werden wir feststellen, dass die Antwort auf die Frage nach dem Marktführer wesentlich stärker davon abhängt, was wir eigentlich messen, als es auf den ersten Blick erscheint.
Marktanteile: Warum die Zahlen nicht die ganze Geschichte erzählen
Wer nach aktuellen Marktanteilen im Virtualisierungsmarkt sucht, findet zahlreiche Untersuchungen, Herstellerangaben und Prognosen. Allerdings beginnt die Schwierigkeit bereits bei einer scheinbar einfachen Frage: Was verstehen wir überhaupt unter einem Marktanteil?
Geht es um die Anzahl physischer Hosts, auf denen ein bestimmter Hypervisor installiert ist? Um die Zahl der darauf ausgeführten virtuellen Maschinen? Um Unternehmen, die eine Plattform einsetzen? Oder um die Umsätze, die Hersteller mit Virtualisierungssoftware, Abonnements und Supportleistungen erzielen?
Diese Kennzahlen beschreiben unterschiedliche Sachverhalte. Ein Unternehmen kann beispielsweise mehrere Hundert virtuelle Maschinen auf einer vergleichsweise kleinen Anzahl physischer Hosts betreiben. Ein anderes nutzt dieselbe Plattform lediglich für einige wenige Testsysteme. Zählen wir beide Organisationen als jeweils einen Kunden, erscheinen sie in der Statistik gleichwertig. Betrachten wir dagegen die Anzahl virtueller Maschinen oder die bereitgestellte Rechenkapazität, ergibt sich ein völlig anderes Bild.
Noch schwieriger wird die Einordnung, wenn wir Umsatzdaten heranziehen. Ein Hersteller kann durch höhere Lizenzpreise, veränderte Produktpakete oder den Übergang zu Abonnementmodellen steigende Umsätze erzielen, obwohl die Anzahl seiner Installationen stagniert oder sogar zurückgeht. Ein steigender Umsatz bedeutet deshalb nicht automatisch einen wachsenden technischen Marktanteil.
Wenn unterschiedliche Technologien in derselben Statistik auftauchen
Hinzu kommt eine weitere Besonderheit: Nicht jede Marktuntersuchung verwendet dieselbe Definition von Virtualisierung. Während manche Studien ausschließlich Serverhypervisoren betrachten, beziehen andere auch Desktopvirtualisierung, Anwendungsbereitstellung, Netzwerkvirtualisierung oder softwaredefinierte Speicherlösungen ein. Ein besonders anschauliches Beispiel liefert die Technologiedatenbank von 6sense. Dort werden innerhalb der Kategorie Virtualization Platform unter anderem VMware, VMware vSphere und VMware ESXi als eigenständige Einträge geführt. Gleichzeitig taucht mit Citrix Workspace App eine Lösung auf, die selbst keinen Serverhypervisor bereitstellt.
Damit begegnen uns in derselben Auswertung unterschiedliche Produkt- und Technologieebenen. Würden wir solche Angaben ungeprüft miteinander vergleichen oder einzelne Prozentwerte addieren, könnten daraus irreführende Schlussfolgerungen entstehen. Auch die Erfassung eines Unternehmens als Nutzer einer bestimmten Technologie sagt noch nichts darüber aus, wie umfangreich diese tatsächlich eingesetzt wird. Deshalb müssen wir bei jeder Statistik prüfen, welche Produkte berücksichtigt werden, wie die Daten erhoben wurden und auf welche Grundgesamtheit sich die ausgewiesenen Werte beziehen. Marktanteile sind nur dann wirklich aussagekräftig, wenn wir verstehen, welcher Markt betrachtet wird und was die verwendeten Zahlen tatsächlich messen.
VMware: Die etablierte Infrastruktur verschwindet nicht über Nacht
Wer die aktuellen Diskussionen über VMware verfolgt, könnte gelegentlich den Eindruck gewinnen, dass zahlreiche Unternehmen ihre bisherigen Virtualisierungsplattformen möglichst schnell ersetzen möchten. Doch zwischen einer strategischen Neubewertung und der tatsächlichen Ablösung einer etablierten Infrastruktur liegt häufig ein langer Weg.
Wie stark VMware den Virtualisierungsmarkt über viele Jahre geprägt hat, verdeutlichen auch die verfügbaren Marktdaten. Die Marktanalyse von Mordor Intelligence verweist auf einen geschätzten Anteil von rund 70 Prozent an der installierten On-Premises-Hypervisorbasis vor der Übernahme durch Broadcom im Jahr 2023. Diese Größenordnung unterstreicht die historische Bedeutung von VMware. Allerdings handelt es sich um eine Schätzung, deren zugrunde liegende Erhebungsmethode anhand der öffentlich verfügbaren Angaben nicht vollständig nachvollzogen werden kann. Eine andere Perspektive liefert die Technologiedatenbank von 6sense. Dort erreicht VMware innerhalb der Kategorie Virtualization Platform einen ausgewiesenen Anteil von 40,77 Prozent. Weitere 11,58 Prozent entfallen auf VMware vSphere und 6,97 Prozent auf VMware ESXi.
Auf den ersten Blick könnte man versucht sein, diese Werte zu einem gemeinsamen VMware-Marktanteil zusammenzufassen. Doch genau das wäre methodisch problematisch.
Warum 40,77 Prozent nicht die ganze VMware-Geschichte erzählen
6sense erfasst VMware, VMware vSphere und VMware ESXi als eigenständige Technologieeinträge. Dabei stehen diese Bezeichnungen nicht für drei vollständig voneinander unabhängige Virtualisierungsplattformen. ESXi ist der eigentliche Hypervisor, während vSphere die darüberliegende Virtualisierungsplattform einschließlich weiterer Verwaltungs- und Infrastrukturfunktionen bezeichnet. Der allgemeine Begriff VMware kann sich wiederum auf unterschiedliche Produkte des Herstellerportfolios beziehen.
Ein Unternehmen kann deshalb innerhalb der Datenbasis möglicherweise mehreren dieser Kategorien zugeordnet sein. Die Prozentwerte dürfen folglich nicht einfach addiert werden. Ebenso wenig beschreibt der Wert von 40,77 Prozent den weltweiten Anteil von VMware an sämtlichen produktiv eingesetzten Serverhypervisoren. Er zeigt vielmehr, welchen Anteil der entsprechende Technologieeintrag innerhalb der von 6sense erfassten und kategorisierten Unternehmensdaten erreicht.
Dennoch lässt sich daraus eine vorsichtige Erkenntnis ableiten. VMware ist innerhalb dieser Datenbasis weiterhin sehr stark vertreten. Eine genaue Aussage über den tatsächlichen weltweiten Installationsmarktanteil oder dessen Veränderung seit der Broadcom-Übernahme lässt sich daraus jedoch nicht ableiten.
Wenn aus einer Plattform ein ganzes Ökosystem wird
Dass VMware trotz veränderter wirtschaftlicher Rahmenbedingungen weiterhin in zahlreichen Unternehmensrechenzentren eingesetzt wird, hat nachvollziehbare Gründe. Über mehr als zwei Jahrzehnte entstanden umfangreiche Betriebsprozesse, Verwaltungsstrukturen und Automatisierungen rund um die VMware-Technologien. Administrator:innen wurden entsprechend qualifiziert, Monitoring- und Backupkonzepte auf die Plattform abgestimmt und Anwendungen für bestimmte Virtualisierungsumgebungen freigegeben. Hinzu kommen Investitionen in Hardware, Netzwerkarchitekturen und Hochverfügbarkeitslösungen.
Gerade in größeren Organisationen ist VMware deshalb häufig weit mehr als ein Hypervisor. Automatisierte Bereitstellungsprozesse greifen auf Verwaltungs-APIs zu, Backupsoftware verwendet spezifische Integrationsschnittstellen und Monitoringlösungen überwachen die Verfügbarkeit und Leistungsfähigkeit der Infrastruktur. Ein Wechsel betrifft folglich nicht nur die virtuellen Maschinen, sondern möglicherweise auch zahlreiche Werkzeuge und Betriebsabläufe. Selbst wenn eine alternative Plattform geringere Lizenzkosten verspricht, müssen Unternehmen zunächst prüfen, welche Auswirkungen eine Migration auf ihre gesamte Infrastruktur hätte.
Zwischen Wechselabsicht und tatsächlicher Migration
Genau hier liegt eine Besonderheit der aktuellen Marktentwicklung. Ein Unternehmen kann mit den veränderten VMware-Lizenzbedingungen unzufrieden sein und dennoch zunächst bei der bestehenden Plattform bleiben. Möglicherweise laufen vorhandene Verträge noch über einen längeren Zeitraum. Vielleicht sind geschäftskritische Anwendungen an bestimmte Plattformfreigaben gebunden. Oder die bestehende Infrastruktur funktioniert zuverlässig, während eine Migration zusätzliche Risiken mit sich bringen würde. In anderen Fällen werden alternative Plattformen zunächst in Testumgebungen erprobt, bevor einzelne weniger kritische Systeme umziehen.
Gerade größere Organisationen können deshalb über Jahre hinweg unterschiedliche Virtualisierungsplattformen parallel betreiben. Die bestehende VMware-Infrastruktur bleibt produktiv, während neue Workloads möglicherweise bereits auf Hyper-V, Proxmox VE oder einer anderen Plattform bereitgestellt werden. Das bedeutet nicht zwangsläufig, dass eine vollständige Ablösung geplant ist. Auch eine dauerhafte Verteilung unterschiedlicher Anwendungen auf mehrere Virtualisierungsplattformen kann das Ergebnis einer solchen Neubewertung sein.
Für die Interpretation aktueller Marktstatistiken ist diese Unterscheidung entscheidend. Eine zunehmende öffentliche Diskussion über alternative Hypervisoren oder eine steigende Zahl von Migrationsprojekten führt nicht automatisch zu einer unmittelbar messbaren Veränderung der installierten Infrastruktur. VMware kann deshalb weiterhin eine starke Marktposition besitzen, während gleichzeitig immer mehr Unternehmen Alternativen prüfen. Beides ist kein Widerspruch, sondern Ausdruck eines Marktes, dessen strategische Entscheidungen sich schneller verändern als seine gewachsenen Infrastrukturen.
Hyper-V: Eine Alternative, die häufig bereits vorhanden ist
Während VMware über viele Jahre als eigenständige Virtualisierungsplattform in Unternehmensrechenzentren etabliert wurde, nimmt Microsoft Hyper-V innerhalb des Marktes eine etwas andere Stellung ein. Denn Hyper-V muss nicht zwangsläufig als separates Virtualisierungsprodukt beschafft werden. Die Technologie ist als Serverrolle Bestandteil unterstützter Windows-Server-Editionen und kann damit grundsätzlich auf einer bereits vorhandenen Microsoft-Infrastruktur bereitgestellt werden.
Gerade für Unternehmen, die ohnehin Windows Server einsetzen, erscheint Hyper-V deshalb als naheliegende Alternative zu VMware.
Doch wie verbreitet ist die Plattform tatsächlich? Die Technologiedatenbank von 6sense weist für Microsoft Hyper-V innerhalb ihrer Kategorie Virtualization Platform einen Anteil von 5,73 Prozent aus. Dieser Wert liegt deutlich unter den separat erfassten VMware-Einträgen. Allerdings dürfen wir daraus nicht unmittelbar schließen, dass Hyper-V lediglich auf einem entsprechend kleinen Anteil der weltweit eingesetzten Virtualisierungshosts betrieben wird. Wie bereits erläutert, beschreibt die 6sense-Auswertung die Zuordnung von Technologien innerhalb einer bestimmten Unternehmensdatenbank und keine vollständige Erhebung aller produktiven Hypervisorinstallationen.
Hinzu kommt eine Besonderheit des Microsoft-Ökosystems. Nicht jede Windows-Server-Installation ist automatisch ein Hyper-V-Host. Umgekehrt lässt sich aus der Verbreitung von Windows Server auch nicht zuverlässig ableiten, wie viele Unternehmen Hyper-V produktiv einsetzen. Die technische Verfügbarkeit einer Virtualisierungsplattform und ihre tatsächlich messbare Nutzung sind zwei unterschiedliche Größen.
Microsofts Stärke liegt im Zusammenspiel der Technologien
Für die Bewertung von Hyper-V ist deshalb nicht allein der ausgewiesene Marktanteil entscheidend. Microsoft verfügt über ein umfangreiches Infrastrukturökosystem, in das sich Hyper-V integrieren lässt. Windows Failover Clustering ermöglicht den hochverfügbaren Betrieb virtueller Maschinen. Windows Admin Center stellt webbasierte Verwaltungsfunktionen bereit, während System Center Virtual Machine Manager insbesondere für die zentrale Administration größerer Virtualisierungsumgebungen eingesetzt werden kann.
Hinzu kommen PowerShell als etablierte Automatisierungsplattform sowie unterschiedliche Möglichkeiten zur Integration in hybride Verwaltungsmodelle. Mit Azure Arc können beispielsweise unterstützte lokale Server und weitere Infrastrukturressourcen in übergreifende Verwaltungs- und Governancekonzepte eingebunden werden.
Dabei sollten wir allerdings nicht übersehen, dass diese Komponenten unterschiedliche Aufgaben erfüllen und teilweise zusätzliche Lizenzierungs- oder Infrastrukturvoraussetzungen mitbringen. Ein Hyper-V-Host wird schließlich nicht allein dadurch zu einer vollständig verwalteten Unternehmensplattform, dass er unter Windows Server betrieben wird.
Gartner 2026: Microsoft gehört zu den führenden Anbietern
Interessant ist in diesem Zusammenhang auch die aktuelle strategische Bewertung des Virtualisierungsmarktes. Nach einer öffentlich zugänglichen Zusammenfassung des IT-Dienstleisters enthus zählt Microsoft im Gartner Magic Quadrant für Servervirtualisierungsplattformen vom September 2026 zu den vier als Leader eingeordneten Anbietern. Neben Microsoft werden dort Broadcom, Nutanix und Red Hat genannt.
Diese Einordnung ist besonders bemerkenswert, weil Microsofts Virtualisierungsstrategie inzwischen weit über den klassischen Hyper-V-Host hinausreicht. Mit Azure Local bietet Microsoft eine Infrastrukturplattform an, die lokale Rechen- und Speicherressourcen mit cloudbasierten Verwaltungs- und Betriebsmodellen verbindet. Hyper-V bildet dabei weiterhin eine wesentliche technische Grundlage, wird jedoch in ein umfassenderes Plattformkonzept eingebettet.
Allerdings müssen wir auch diese Bewertung richtig verstehen. Der Gartner Magic Quadrant ist keine Statistik über installierte Hypervisoren. Er bewertet die strategische Ausrichtung und Umsetzungsfähigkeit der untersuchten Anbieter. Die Einordnung als Leader bedeutet deshalb nicht, dass Microsoft VMware bei der Zahl produktiver Installationen überholt hätte. Sie zeigt vielmehr, dass Microsoft innerhalb der aktuellen Wettbewerbslandschaft als strategisch bedeutender Anbieter von Servervirtualisierungsplattformen bewertet wird.
Vorhandene Technologie bedeutet noch keine fertige Infrastruktur
Für Unternehmen mit einer stark Microsoft-geprägten IT-Landschaft kann Hyper-V somit eine interessante Option darstellen. Bestehende Kompetenzen im Umgang mit Windows Server, Active Directory, PowerShell und Microsoft-Verwaltungswerkzeugen können den Aufbau und Betrieb einer entsprechenden Virtualisierungsumgebung erleichtern. Allerdings sollten wir daraus keine automatische Wirtschaftlichkeits- oder Migrationsempfehlung ableiten. Auch unter Hyper-V müssen Hochverfügbarkeit, Storage, Netzwerkarchitektur, Datensicherung und Monitoring sorgfältig geplant werden.
Hinzu kommen die Lizenzierungsregeln von Windows Server, insbesondere die Unterschiede zwischen Standard und Datacenter sowie gegebenenfalls zusätzliche Verwaltungsprodukte. Eine bereits vorhandene Windows-Server-Lizenz bedeutet schließlich nicht automatisch, dass sämtliche geplanten Virtualisierungsszenarien ohne weitere Lizenzkosten abgedeckt wären. Ebenso müssen bei einer Migration von VMware die vorhandenen virtuellen Maschinen, Betriebsprozesse und Herstellerfreigaben berücksichtigt werden.
Trotzdem besitzt Hyper-V einen Vorteil, den wir bei der Betrachtung des Virtualisierungsmarktes nicht unterschätzen sollten: Die Technologie ist für viele Unternehmen keine unbekannte Alternative, sondern Bestandteil einer Infrastrukturwelt, mit der ihre Administrator:innen bereits täglich arbeiten. Hyper-V gewinnt seine strategische Bedeutung deshalb nicht allein durch die Verfügbarkeit innerhalb von Windows Server. Entscheidend ist die Möglichkeit, Virtualisierung in ein bestehendes Microsoft-Ökosystem einzubinden und dieses zunehmend mit hybriden Infrastrukturkonzepten zu verbinden.
KVM und Proxmox VE: Die offene Virtualisierung wird sichtbarer
Neben VMware und Microsoft Hyper-V gewinnt eine weitere Gruppe von Virtualisierungstechnologien zunehmend Aufmerksamkeit: Plattformen, die auf offenen Standards und frei verfügbarer Software aufbauen. Dabei spielt insbesondere KVM (Kernel-based Virtual Machine) eine zentrale Rolle. KVM ist seit vielen Jahren Bestandteil des Linux-Kernels und ermöglicht es, Linux-Systeme als Hypervisoren für virtuelle Maschinen einzusetzen. In Verbindung mit Komponenten wie QEMU, libvirt und unterschiedlichen Verwaltungswerkzeugen bildet KVM die technische Grundlage zahlreicher Virtualisierungs- und Cloudplattformen. Anders als bei VMware vSphere oder Microsoft Hyper-V lässt sich seine Verbreitung allerdings nicht ohne Weiteres einem einzelnen Produkt zuordnen.
KVM kann auf eigenständig verwalteten Linux-Hosts eingesetzt werden, innerhalb von OpenStack-Umgebungen arbeiten oder Bestandteil kommerzieller Infrastrukturplattformen sein. Auch Proxmox Virtual Environment, kurz Proxmox VE, verwendet KVM für die Bereitstellung virtueller Maschinen. Damit kann dieselbe grundlegende Virtualisierungstechnologie in sehr unterschiedlichen Betriebsmodellen zum Einsatz kommen, ohne in Marktstatistiken zwangsläufig unter demselben Produktnamen aufzutauchen. Wer die Verbreitung von KVM beurteilen möchte, muss deshalb zwischen der zugrunde liegenden Technologie und den darauf aufbauenden Virtualisierungsplattformen unterscheiden.
Proxmox VE: Eine konkrete Plattform wird messbar
Besonders anschaulich wird diese Entwicklung am Beispiel von Proxmox VE. Die Plattform kombiniert KVM-basierte virtuelle Maschinen mit LXC-Containern, einer zentralen webbasierten Verwaltungsoberfläche sowie Funktionen für Clustering, Hochverfügbarkeit, Netzwerk- und Speicherverwaltung. Auch die Integration von Technologien wie ZFS und Ceph ermöglicht unterschiedliche Speicherarchitekturen, von einzelnen Virtualisierungshosts bis hin zu verteilten Clusterumgebungen. Damit bietet Proxmox VE ein zusammenhängendes Administrations- und Betriebskonzept, ohne dass Unternehmen sämtliche Komponenten einer KVM-basierten Infrastruktur selbst zusammenstellen müssen.
Die Technologiedatenbank von 6sense weist für Proxmox VE innerhalb ihrer Kategorie Virtualization Platform einen Anteil von 2,13 Prozent aus. Dieser Wert liegt unter den dort ausgewiesenen Anteilen für VMware und Microsoft Hyper-V. Allerdings gilt auch hier die bereits erläuterte methodische Einschränkung: Die Zahl beschreibt die beobachtete Zuordnung einer Technologie innerhalb der 6sense-Datenbasis und nicht den weltweiten Anteil an sämtlichen produktiven Virtualisierungshosts oder virtuellen Maschinen.
Zudem erfasst der Proxmox-Eintrag nicht automatisch alle KVM-basierten Umgebungen. Eine OpenStack-Installation mit KVM, ein eigenständig betriebener Linux-Hypervisor oder eine andere KVM-basierte Plattform ist schließlich keine Proxmox-VE-Installation. Die 2,13 Prozent beschreiben deshalb die Sichtbarkeit von Proxmox VE innerhalb der untersuchten Unternehmensdatenbank, nicht den Marktanteil der gesamten Linux-basierten Virtualisierung.
Open Source bedeutet nicht automatisch kostenloser Betrieb
Für Unternehmen, die ihre Virtualisierungsstrategie derzeit überprüfen, besitzt Proxmox VE mehrere interessante Eigenschaften. Der Quellcode ist offen verfügbar, die Plattform lässt sich ohne verpflichtende kommerzielle Softwarelizenz einsetzen und zentrale Verwaltungsfunktionen sind bereits Bestandteil des Produkts. Gleichzeitig bietet Proxmox Server Solutions kostenpflichtige Subskriptionen an, die insbesondere den Zugang zum Enterprise-Repository und unterschiedliche Supportleistungen umfassen. Das unterscheidet das Geschäftsmodell von klassischen proprietären Lizenzierungsansätzen.
Allerdings sollten wir daraus nicht ableiten, dass eine produktive Proxmox-Infrastruktur grundsätzlich kostenlos betrieben werden kann. Auch hier entstehen Kosten für Hardware, Storage, Netzwerkkomponenten, Datensicherung, Administration und gegebenenfalls kommerziellen Support. Hinzu kommen Schulungen sowie der Aufwand für den Aufbau und die Pflege entsprechender Betriebsprozesse.
Gerade bei geschäftskritischen Anwendungen müssen Unternehmen außerdem prüfen, ob Herstellerfreigaben, Supportvereinbarungen und technische Integrationen für die geplante Plattform vorliegen. Der offene Quellcode bietet zusätzliche Gestaltungsmöglichkeiten und reduziert bestimmte Abhängigkeiten von proprietären Softwarelizenzen. Er ersetzt jedoch weder ein professionelles Betriebskonzept noch die Verantwortung für eine zuverlässige Infrastruktur.
Zwischen wachsendem Interesse und tatsächlicher Marktdurchdringung
Die Veränderungen im VMware-Ökosystem haben die Diskussion über alternative Virtualisierungsplattformen deutlich belebt. Proxmox VE wird dabei häufig als mögliche Alternative genannt, insbesondere wenn Unternehmen ihre Lizenzkosten überprüfen, bestehende Herstellerabhängigkeiten reduzieren oder neue Virtualisierungsumgebungen aufbauen möchten.
Doch auch hier müssen wir zwischen Interesse und tatsächlicher Nutzung unterscheiden. Eine zunehmende Zahl von Fachbeiträgen, Installationsanleitungen, Vergleichstests oder Migrationsdiskussionen zeigt zunächst, dass sich Administrator:innen intensiver mit einer Technologie beschäftigen. Sie belegt noch nicht, wie viele Unternehmen bereits produktive VMware-Umgebungen durch Proxmox VE ersetzt haben.
Ebenso wenig lässt sich aus einem einzelnen aktuellen Marktanteilswert eine belastbare Wachstumskurve ableiten. Dafür wären vergleichbare Erhebungen über mehrere Zeitpunkte erforderlich, die auf einer möglichst konstanten Datenbasis und einheitlichen Erfassungsmethode beruhen. Hinzu kommt, dass Proxmox VE nicht ausschließlich als Ersatz für VMware eingesetzt werden muss. Die Plattform kann ebenso für neue Infrastrukturprojekte, kleinere Standorte, Test- und Entwicklungsumgebungen oder als zusätzliche Virtualisierungslösung innerhalb einer bereits bestehenden IT-Landschaft verwendet werden. Auch ein dauerhafter Parallelbetrieb unterschiedlicher Plattformen ist denkbar.
Damit ergibt sich für die Einordnung der aktuellen Marktentwicklung eine wichtige Erkenntnis: KVM ist als grundlegende Virtualisierungstechnologie wesentlich breiter einsetzbar, als es die Marktanteilszahl einer einzelnen darauf aufbauenden Plattform erkennen lässt. Proxmox VE wiederum ist eine sichtbar gewordene Alternative im Wettbewerb der Virtualisierungsprodukte – doch ihre tatsächliche Verbreitung und ihr Wachstum müssen anhand geeigneter Daten beurteilt werden, nicht allein anhand öffentlicher Aufmerksamkeit.
Die Cloud verändert den Maßstab
Bislang haben wir vor allem Virtualisierungsplattformen betrachtet, die Unternehmen in ihren eigenen Rechenzentren betreiben und verwalten. Doch sobald wir die Public Cloud in unsere Marktbetrachtung einbeziehen, verändert sich die Perspektive grundlegend. Denn auch hinter Diensten wie Amazon EC2, Microsoft Azure Virtual Machines oder Google Compute Engine stehen physische Server, auf deren Ressourcen virtuelle Maschinen ausgeführt werden.
Allerdings entscheiden Kund:innen normalerweise nicht selbst, welcher Hypervisor auf diesen Systemen installiert wird. Sie wählen vielmehr eine virtuelle Maschinenkonfiguration, definieren benötigte Rechenleistung, Arbeitsspeicher, Speicherressourcen und Netzwerkanbindungen und beziehen diese über die Verwaltungsplattform des jeweiligen Cloudanbieters. Die zugrunde liegende Virtualisierungsarchitektur bleibt dabei weitgehend Bestandteil der internen Infrastruktur des Anbieters.
Damit verschiebt sich die eigentliche Entscheidung. Während Unternehmen im eigenen Rechenzentrum zwischen VMware, Hyper-V oder Proxmox VE wählen können, entscheiden sie sich in der Public Cloud in erster Linie für einen Cloudanbieter, dessen Dienste und dessen Betriebsmodell. Der Hypervisor verschwindet damit nicht aus der technischen Architektur. Er verschwindet lediglich weitgehend aus dem unmittelbaren Entscheidungs- und Verantwortungsbereich der Kund:innen.
Warum Cloud-Marktanteile keine Hypervisor-Marktanteile sind
Diese Unterscheidung ist für unsere Marktbetrachtung entscheidend. Wenn eine Untersuchung beispielsweise die Umsätze oder Marktanteile von Amazon Web Services, Microsoft Azure und Google Cloud gegenüberstellt, beschreibt sie zunächst den Markt für Cloudservices. Daraus lässt sich nicht unmittelbar ableiten, wie viele virtuelle Maschinen auf KVM, Hyper-V, Xen oder anderen Virtualisierungstechnologien ausgeführt werden.
Hinzu kommt, dass große Cloudanbieter ihre Virtualisierungsarchitekturen über viele Jahre eigenständig weiterentwickelt haben. Amazon Web Services setzte bei EC2 ursprünglich auf Xen-basierte Virtualisierung. Mit der später eingeführten Nitro-Architektur verlagerte AWS zahlreiche Infrastrukturaufgaben auf spezialisierte Hardwarekomponenten und nutzt für entsprechende EC2-Instanzen einen schlanken, KVM-basierten Hypervisor. Microsoft wiederum verwendet für Azure eine eigene, auf Hyper-V-Technologien aufbauende Virtualisierungsarchitektur. Auch Google Cloud setzt bei Compute Engine auf eine eigene, auf KVM basierende Virtualisierungsinfrastruktur.
Damit begegnen uns bekannte Virtualisierungstechnologien erneut, allerdings in Betriebsumgebungen, die sich erheblich von einer klassischen Installation im Unternehmensrechenzentrum unterscheiden. Die zugrunde liegenden Hypervisoren sind Bestandteil hochgradig automatisierter, verteilter Plattformen. Ihre Verwaltung, Weiterentwicklung und Integration in die physische Infrastruktur erfolgen durch die jeweiligen Cloudanbieter. Eine Marktstatistik, die ausschließlich die Verbreitung separat angebotener Virtualisierungsprodukte erfasst, bildet diese Nutzung deshalb nicht zwangsläufig vollständig ab.
Ein wachsender Markt mit unterschiedlichen Teilbereichen
Wie groß die wirtschaftliche Bedeutung von Virtualisierung inzwischen geworden ist, verdeutlicht eine Marktanalyse von Mordor Intelligence. Das Marktforschungsunternehmen schätzt das weltweite Volumen des Virtualisierungssoftwaremarktes für 2025 auf rund 95,59 Milliarden US-Dollar und für 2026 auf etwa 110,21 Milliarden US-Dollar. Bis 2031 prognostiziert die Untersuchung ein Wachstum auf ungefähr 224,59 Milliarden US-Dollar. Allerdings müssen wir auch diese Zahlen richtig einordnen.
Die Untersuchung betrachtet einen breiten Virtualisierungssoftwaremarkt, der neben Server- und Compute-Virtualisierung weitere Bereiche wie Storage-, Netzwerk-, Desktop- und Anwendungsvirtualisierung umfasst. Die genannten Umsätze lassen sich daher weder vollständig der klassischen Servervirtualisierung zurechnen noch unmittelbar auf VMware, Hyper-V oder Proxmox VE verteilen. Ebenso wenig können wir daraus ablesen, wie viele virtuelle Maschinen tatsächlich in privaten Rechenzentren oder innerhalb großer Public-Cloud-Infrastrukturen betrieben werden. Dennoch zeigt die Prognose eine wesentliche Entwicklung: Virtualisierung bleibt eine wirtschaftlich bedeutende Basistechnologie, deren Einsatz weit über den klassischen Hypervisor im Unternehmensrechenzentrum hinausreicht.
Virtualisierung wird zur unsichtbaren Infrastruktur
Gerade in der Cloud wird deutlich, wie grundlegend sich die Rolle der Virtualisierung verändert hat. Im klassischen Rechenzentrum beschäftigen sich Administrator:innen unmittelbar mit Hypervisorhosts, virtuellen Switches, Clustern und Speicheranbindungen. In der Public Cloud treten dagegen Verwaltungs-APIs, automatisierte Bereitstellung, Skalierung, Identitäts- und Berechtigungskonzepte sowie die Integration unterschiedlicher Clouddienste in den Vordergrund. Bei Plattformdiensten und serverlosen Ausführungsmodellen kann die zugrunde liegende Virtualisierung für die Anwender:innen noch weiter in den Hintergrund rücken. Die physische und virtuelle Infrastruktur existiert weiterhin. Ihre Komplexität wird jedoch zunehmend durch die Plattform abstrahiert.
Damit entsteht eine interessante Verschiebung: Die Bedeutung einzelner Hypervisorprodukte für die unmittelbare Kaufentscheidung kann abnehmen, während Virtualisierung als technische Grundlage moderner IT-Infrastrukturen gleichzeitig unverzichtbar bleibt. Für unsere Frage, wer eigentlich womit virtualisiert, bedeutet das eine zusätzliche Einschränkung. Wir können die Verbreitung von VMware, Hyper-V oder Proxmox VE innerhalb beobachtbarer Unternehmensumgebungen vergleichen. Daraus ergibt sich aber noch kein vollständiges Bild der weltweit genutzten Virtualisierungstechnologien. Denn ein erheblicher Teil virtualisierter Rechenressourcen wird heute über Cloudplattformen bereitgestellt, deren interne Hypervisorarchitektur nicht als eigenständiges Produkt am Markt erscheint. Virtualisierung ist heute wesentlich weiter verbreitet, als es die Marktanteile einzelner Virtualisierungsprodukte erkennen lassen. Die Cloud verändert dabei nicht nur den Maßstab, sondern auch die Frage, auf welcher Ebene wir Virtualisierung überhaupt messen sollten.
Zwischen Bestandsplattform und strategischer Neuausrichtung
Was lässt sich aus unserer Betrachtung des Virtualisierungsmarktes nun tatsächlich ableiten? Zunächst zeigt sich, dass VMware weiterhin eine bedeutende Rolle innerhalb der bestehenden Unternehmensinfrastrukturen spielt. Die Daten von 6sense verdeutlichen die starke Präsenz der Technologie innerhalb der erfassten Unternehmenslandschaft, während Microsoft Hyper-V und Proxmox VE ebenfalls als eigenständige Plattformen sichtbar werden. Gleichzeitig zeigt die erneute strategische Bewertung des Servervirtualisierungsmarktes durch Gartner, über die unter anderem enthus berichtet, dass der Wettbewerb längst nicht mehr ausschließlich zwischen VMware und Microsoft stattfindet. Mit Nutanix und Red Hat gehören weitere Anbieter zur Gruppe der dort eingeordneten Leader. Hinzu kommen unterschiedliche offene und kommerzielle Plattformen, die je nach Infrastrukturstrategie interessante Alternativen darstellen können.
Allerdings dürfen wir diese Beobachtungen nicht mit einer bereits abgeschlossenen Neuverteilung des Marktes verwechseln. Die verfügbaren Daten beschreiben unterschiedliche Perspektiven: die beobachtete Nutzung einzelner Technologien, die strategische Positionierung von Anbietern und das wirtschaftliche Volumen eines breiter gefassten Virtualisierungsmarktes. Keine dieser Perspektiven allein beantwortet zuverlässig, wie viele Unternehmen ihre produktiven Virtualisierungsumgebungen seit der Broadcom-Übernahme tatsächlich auf andere Plattformen migriert haben.
Drei Phasen einer möglichen Veränderung
Um die aktuelle Entwicklung besser einzuordnen, sollten wir drei unterschiedliche Situationen auseinanderhalten.
- Bestandsbetrieb: Unternehmen betreiben ihre etablierte Virtualisierungsplattform weiter, weil sie technisch zuverlässig funktioniert, bestehende Prozesse darauf abgestimmt sind und eine Migration derzeit keinen ausreichenden wirtschaftlichen oder betrieblichen Vorteil verspricht.
- Strategische Evaluation: Andere Organisationen prüfen alternative Lösungen, vergleichen Lizenz- und Supportmodelle, bewerten technische Anforderungen und führen gegebenenfalls erste Tests durch, ohne bereits eine verbindliche Migrationsentscheidung getroffen zu haben.
- Konkrete Migration: Wieder andere haben sich bereits für eine neue Plattform entschieden, migrieren einzelne Workloads oder haben bestimmte Teile ihrer Infrastruktur vollständig umgestellt.
Diese Phasen schließen sich innerhalb eines Unternehmens nicht einmal gegenseitig aus. Eine Organisation kann beispielsweise ihre geschäftskritischen VMware-Cluster unverändert weiterbetreiben, während neue Testumgebungen auf Proxmox VE entstehen und bestimmte Windows-basierte Workloads künftig auf Hyper-V bereitgestellt werden. Ebenso kann eine strategische Entscheidung zunächst nur zukünftige Investitionen betreffen, ohne dass bestehende virtuelle Maschinen unmittelbar migriert werden.
Gerade in größeren IT-Landschaften können solche Übergangsphasen mehrere Jahre dauern. Deshalb wäre es vorschnell, aus der aktuellen Diskussion über VMware bereits eine grundlegende Verschiebung der weltweiten Hypervisor-Marktanteile abzuleiten. Gleichzeitig wäre es ebenso falsch, die Entwicklung lediglich als kurzfristige Reaktion auf veränderte Lizenzbedingungen zu betrachten.
Wenn sich die Bewertungskriterien verändern
Denn die Diskussion über Virtualisierungsplattformen hat inzwischen eine Dimension erreicht, die weit über einzelne Lizenzpreise hinausgeht. Unternehmen beschäftigen sich wieder intensiver mit grundsätzlichen Fragen ihrer Infrastrukturstrategie:
- Wie stark möchten wir uns langfristig an einen einzelnen Hersteller und dessen Produktstrategie binden?
- Welche Lizenz-, Betriebs- und Supportmodelle passen zu unseren wirtschaftlichen und technischen Anforderungen?
- Wie lassen sich bestehende virtuelle Maschinen, Automatisierungen und Verwaltungsprozesse auf andere Plattformen übertragen?
- Welche Bedeutung haben offene Schnittstellen, Hochverfügbarkeit, Datensicherung und die Integration hybrider Cloudumgebungen?
- Welche Kompetenzen benötigen unsere Administrator:innen, um unterschiedliche Plattformen zuverlässig und wirtschaftlich betreiben zu können?
Diese Fragen sind keineswegs neu. Allerdings wurden sie in vielen Unternehmen über Jahre hinweg kaum noch grundsätzlich gestellt. Die vorhandene Virtualisierungsplattform war etabliert, die Betriebsprozesse funktionierten und neue Anforderungen wurden innerhalb der bestehenden Architektur umgesetzt. Die Veränderungen im VMware-Ökosystem haben diese Selbstverständlichkeit zumindest teilweise aufgebrochen.
Damit entsteht eine Situation, in der nicht zwangsläufig sofort der Hypervisor ausgetauscht wird, wohl aber die Grundlage zukünftiger Investitionsentscheidungen. Ein Unternehmen kann beispielsweise beschließen, neue Virtualisierungsprojekte künftig grundsätzlich technologieoffen auszuschreiben, selbst wenn die bestehende VMware-Infrastruktur noch viele Jahre produktiv bleibt. Oder es entwickelt erstmals ein Migrationskonzept, das bislang mangels wirtschaftlichen oder technischen Handlungsdrucks nicht erforderlich erschien.
Der eigentliche Wandel beginnt vor der Migration
Genau darin liegt möglicherweise die wichtigste Erkenntnis unserer Marktbetrachtung. Die Veränderungen des Virtualisierungsmarktes lassen sich nicht allein an den heutigen Anteilen einzelner Hersteller ablesen. Eine hohe installierte Basis kann über lange Zeit bestehen bleiben, während sich die Präferenzen für neue Infrastrukturprojekte bereits verschieben. Umgekehrt bedeutet eine zunehmende öffentliche Aufmerksamkeit für alternative Plattformen noch nicht, dass diese im gleichen Umfang produktive Systeme übernehmen.
Auch die Cloud verändert dieses Bild: Dort wird Virtualisierung weiterhin in großem Umfang genutzt, ohne dass Kund:innen zwangsläufig eine unmittelbare Entscheidung über den zugrunde liegenden Hypervisor treffen. Die entscheidende Frage lautet deshalb nicht ausschließlich, welcher Anbieter heute die meisten Installationen besitzt. Mindestens ebenso interessant ist, nach welchen Kriterien Unternehmen ihre nächste Virtualisierungsplattform auswählen werden. Denn genau dort können sich Marktveränderungen zunächst bemerkbar machen: in Ausschreibungen, Architekturentscheidungen, Pilotprojekten, Vertragsverhandlungen und der Planung zukünftiger Rechenzentrumsinvestitionen. Der Virtualisierungsmarkt befindet sich deshalb nicht einfach in einem Austausch etablierter Produkte. Vielmehr werden technische, wirtschaftliche und strategische Entscheidungen neu bewertet, die über viele Jahre als weitgehend abgeschlossen galten. Und damit gelangen wir zu einer Frage, die für die Praxis mindestens ebenso wichtig ist wie jede Marktanteilsstatistik: Welche Virtualisierungsplattform passt unter diesen veränderten Rahmenbedingungen eigentlich zu den eigenen Anforderungen?
VMware, Hyper-V oder Proxmox: Was zählt in der Praxis?
Stellen wir uns eine Situation vor, wie sie derzeit in vielen Unternehmen entstehen dürfte. Eine bestehende Virtualisierungsinfrastruktur muss modernisiert werden. Die eingesetzte Serverhardware erreicht das Ende ihres Lebenszyklus, Wartungs- und Supportverträge stehen zur Verlängerung an und gleichzeitig wachsen die Anforderungen an Sicherheit, Verfügbarkeit und Automatisierung. Vielleicht sollen auch neue Anwendungen bereitgestellt oder bestehende Systeme stärker in eine hybride IT-Infrastruktur integriert werden. Über viele Jahre war die Entscheidung in solchen Situationen häufig vergleichsweise einfach: Man modernisierte die Hardware, aktualisierte die vorhandene Virtualisierungsplattform und führte die etablierten Betriebsprozesse fort. Wer VMware einsetzte, blieb in der Regel bei VMware. Nicht unbedingt, weil es keine Alternativen gab, sondern weil die bestehende Infrastruktur funktionierte und ein Plattformwechsel zusätzliche Risiken, Kosten und organisatorischen Aufwand verursacht hätte.
Doch diese Selbstverständlichkeit gerät zunehmend ins Wanken. Insbesondere die Veränderungen der VMware-Produkt- und Lizenzstrategie unter Broadcom haben dazu geführt, dass Unternehmen ihre bisherigen Entscheidungen erneut hinterfragen. Dabei geht es längst nicht ausschließlich um steigende oder veränderte Lizenzkosten. Auch die langfristige Planbarkeit, die Abhängigkeit von einzelnen Herstellern und die Möglichkeit, bestehende Betriebsmodelle künftig flexibel weiterzuentwickeln, gewinnen an Bedeutung. Plötzlich stehen Fragen im Raum, die vielerorts über Jahre kaum gestellt wurden: Müssen wir tatsächlich wieder VMware einsetzen? Könnten wir unsere virtuellen Maschinen ebenso zuverlässig unter Microsoft Hyper-V betreiben? Und wäre Proxmox Virtual Environment möglicherweise eine technisch geeignete und wirtschaftlich interessante Alternative?
Diese Überlegungen beschränken sich keineswegs auf große Rechenzentren. Gerade kleinere und mittelständische Unternehmen müssen sorgfältig abwägen, wie viel Komplexität sie selbst beherrschen können, welche Kompetenzen bereits vorhanden sind und welchen Stellenwert externe Supportleistungen einnehmen. In größeren Organisationen kommen häufig zusätzliche Anforderungen an Standardisierung, Automatisierung, Compliance und die Integration bestehender Managementsysteme hinzu. Die gute Nachricht: Technisch stehen heute mehrere ausgereifte Plattformen zur Verfügung, mit denen sich leistungsfähige und hochverfügbare Virtualisierungsumgebungen aufbauen lassen.
Die weniger einfache Nachricht: Eine funktionierende virtuelle Maschine ist noch kein Beleg für eine geeignete Unternehmensinfrastruktur. Der Hypervisor allein entscheidet nicht darüber, ob eine Virtualisierungsplattform für den produktiven Betrieb geeignet ist. Entscheidend ist, wie zuverlässig, sicher und wirtschaftlich sich die gesamte Umgebung über ihren Lebenszyklus betreiben lässt. Genau deshalb wollen wir die drei Plattformen nun nicht anhand einzelner Funktionen oder vermeintlich eindeutiger Ranglisten vergleichen. Stattdessen betrachten wir die Anforderungen, die im Administrationsalltag tatsächlich den Unterschied machen – von der zentralen Verwaltung über Hochverfügbarkeit und Storage bis hin zu Datensicherung, Automatisierung, Lizenzierung und Migration.
Drei Plattformen, unterschiedliche Ökosysteme
VMware vSphere, Microsoft Hyper-V und Proxmox Virtual Environment verfolgen zunächst dasselbe grundlegende Ziel: Sie ermöglichen es, mehrere voneinander isolierte virtuelle Maschinen auf gemeinsamer physischer Hardware auszuführen und die verfügbaren Ressourcen effizient zu nutzen. Allerdings unterscheiden sich die Plattformen deutlich darin, wie sie Virtualisierung, zentrale Verwaltung, Hochverfügbarkeit und weitere Infrastrukturkomponenten zu einer produktiv nutzbaren Umgebung zusammenführen.
Diese Unterschiede sind keineswegs nur technischer Natur. Sie beeinflussen auch die erforderlichen Administrationskenntnisse, die Integration vorhandener Systeme und die langfristigen Betriebs- und Lizenzmodelle.
VMware vSphere: Ein etabliertes, integriertes Produktökosystem
Bei VMware vSphere bildet der Typ-1-Hypervisor ESXi die technische Grundlage. Er übernimmt die Virtualisierung der physischen Hardware und stellt die erforderlichen Ressourcen für virtuelle Maschinen bereit. Für die zentrale Verwaltung mehrerer ESXi-Hosts kommt typischerweise vCenter Server zum Einsatz. Darüber lassen sich unter anderem Hosts und virtuelle Maschinen administrieren, Cluster konfigurieren, Berechtigungen verwalten und Funktionen wie vMotion oder vSphere High Availability koordinieren. Ergänzend bietet das VMware-Ökosystem weitere Technologien für softwaredefinierten Speicher, Netzwerkvirtualisierung, Automatisierung und den Betrieb größerer Infrastrukturumgebungen.
Welche Funktionen tatsächlich verfügbar sind, hängt allerdings vom eingesetzten Produktpaket, den jeweiligen Lizenzberechtigungen und den technischen Voraussetzungen ab. Gerade hierin liegt eine wesentliche Stärke von VMware: Viele Unternehmen verfügen über langjährig etablierte Betriebsprozesse, geschulte Administrator:innen und umfangreiche Integrationen in Backup-, Monitoring- und Automatisierungslösungen. Gleichzeitig entsteht dadurch eine enge Bindung an das jeweilige Produkt- und Lizenzökosystem.
Microsoft Hyper-V: Virtualisierung als Bestandteil der Windows-Infrastruktur
Microsoft verfolgt mit Hyper-V einen anderen Ansatz. Hyper-V ist als Typ-1-Hypervisor Bestandteil unterstützter Windows-Server-Editionen und stellt die grundlegenden Virtualisierungsfunktionen bereit. Die für größere Unternehmensumgebungen erforderlichen Verwaltungs- und Infrastrukturaufgaben verteilen sich jedoch auf unterschiedliche Microsoft-Technologien. So ermöglicht Windows Failover Clustering den hochverfügbaren Betrieb virtueller Maschinen über mehrere Hosts hinweg. Windows Admin Center stellt webbasierte Verwaltungsfunktionen bereit, während System Center Virtual Machine Manager (SCVMM) insbesondere für die zentrale Verwaltung umfangreicherer Virtualisierungsumgebungen und ihrer Infrastrukturressourcen eingesetzt werden kann.
Hinzu kommt PowerShell als leistungsfähige Grundlage für Administration und Automatisierung. Damit lässt sich Hyper-V eng in vorhandene Windows-Server-Umgebungen integrieren. Gerade Unternehmen, deren IT-Infrastruktur bereits stark auf Microsoft-Technologien ausgerichtet ist, können vorhandene Kompetenzen und Verwaltungsprozesse weiterverwenden.
Allerdings entsteht daraus nicht automatisch eine vollständig integrierte Virtualisierungsplattform. Welche zusätzlichen Komponenten benötigt werden, hängt von der Größe der Umgebung und den Anforderungen an Verfügbarkeit, Verwaltung und Automatisierung ab. Mit Azure Local bietet Microsoft darüber hinaus eine eigenständige, auf Hyper-V-Technologien aufbauende Infrastrukturplattform für lokale und hybride Betriebsmodelle. Sie sollte jedoch nicht mit einer klassischen Hyper-V-Installation unter Windows Server gleichgesetzt werden, da sich Architektur, Verwaltung und Lizenzierung unterscheiden.
Proxmox VE: Offene Technologien unter einer gemeinsamen Verwaltung
Proxmox Virtual Environment verfolgt wiederum einen stärker integrierten Open-Source-Ansatz. Die auf Debian GNU / Linux basierende Plattform verwendet KVM (Kernel-based Virtual Machine) für die Ausführung virtueller Maschinen und LXC (Linux Containers) für die Bereitstellung von Systemcontainern. Dabei kombiniert Proxmox VE unterschiedliche etablierte Linux-Technologien mit einer zentralen webbasierten Verwaltungsoberfläche.
Bereits innerhalb der Plattform lassen sich einzelne Hosts, Cluster, virtuelle Maschinen und Container verwalten. Hinzu kommen Funktionen für Hochverfügbarkeit, Live-Migration, Netzwerkverwaltung und die Integration unterschiedlicher Speichertechnologien. Für den Storage können beispielsweise lokale Datenträger, ZFS, NFS, iSCSI oder verteilte Ceph-Umgebungen eingesetzt werden. Welche Architektur sinnvoll ist, hängt von den jeweiligen Anforderungen und der verfügbaren Infrastruktur ab.
Proxmox VE stellt damit eine weitgehend zusammenhängende Virtualisierungs- und Verwaltungsumgebung bereit, ohne dass Administrator:innen die zugrunde liegenden Linux-Komponenten einzeln zu einer eigenen Plattform zusammenführen müssen. Der offene Quellcode ermöglicht zudem eine vergleichsweise unabhängige Gestaltung der Infrastruktur. Für den professionellen Betrieb stehen kommerzielle Subskriptionen und Supportleistungen zur Verfügung. Allerdings bedeutet die integrierte Verwaltung nicht, dass jede Anforderung eines großen Rechenzentrums automatisch ohne zusätzliche Produkte oder organisatorischen Aufwand abgedeckt wird.
Drei Ansätze, aber kein universeller Gewinner
Bereits diese grundlegende Gegenüberstellung zeigt, warum ein reiner Funktionsvergleich zu kurz greifen würde. VMware vSphere bietet ein über viele Jahre gewachsenes kommerzielles Virtualisierungsökosystem mit umfangreichen Integrationen. Microsoft Hyper-V fügt sich in eine bestehende Windows-Infrastruktur ein und kann durch weitere Microsoft-Technologien zu einer umfassenden Virtualisierungsumgebung erweitert werden. Proxmox VE verbindet offene Technologien mit einer integrierten Verwaltungsplattform und einem anderen Lizenz- und Supportmodell. Keine dieser Architekturphilosophien ist grundsätzlich überlegen.
Für ein Unternehmen mit etablierten VMware-Prozessen können andere Kriterien entscheidend sein als für eine Organisation, die bereits umfangreiche Windows-Server- und PowerShell-Kompetenzen besitzt. Ein Linux-orientiertes IT-Team wird wiederum andere Anforderungen und Möglichkeiten mitbringen. Die entscheidende Frage lautet deshalb nicht, welche Plattform grundsätzlich die meisten Funktionen besitzt, sondern welches Ökosystem die eigenen technischen Anforderungen mit vertretbarem Betriebsaufwand erfüllt. Und genau hier beginnt der eigentliche Praxisvergleich: bei der Administration und der Frage, wie sich eine Virtualisierungsumgebung im täglichen Betrieb zuverlässig verwalten lässt.
Administration: Wie viel Infrastruktur muss verwaltet werden?
Eine virtuelle Maschine anzulegen, gehört heute auf allen drei Plattformen zu den vergleichsweise einfachen Aufgaben. Einige Konfigurationseinstellungen, die Auswahl eines Installationsmediums und die Zuweisung von Prozessorleistung, Arbeitsspeicher und Speicherplatz genügen häufig, um ein neues System bereitzustellen. Doch die eigentliche Herausforderung beginnt nicht bei der ersten virtuellen Maschine. Sie entsteht, wenn aus einem einzelnen Host eine Clusterumgebung wird, mehrere Administrator:innen unterschiedliche Aufgaben übernehmen und Dutzende oder Hunderte virtuelle Maschinen zuverlässig betrieben werden müssen.
Plötzlich geht es nicht mehr ausschließlich darum, Systeme zu starten oder herunterzufahren. Ressourcen müssen überwacht, Berechtigungen vergeben, Konfigurationen vereinheitlicht und Wartungsarbeiten geplant werden. Hinzu kommen Fragen der Dokumentation, der Nachvollziehbarkeit administrativer Änderungen und der Integration in vorhandene Betriebsprozesse. Je größer eine Virtualisierungsumgebung wird, desto wichtiger ist nicht die Verwaltung einzelner virtueller Maschinen, sondern die konsistente Verwaltung der gesamten Infrastruktur.
VMware vCenter: Zentrale Verwaltung als etablierter Standard
VMware stellt mit vCenter Server eine zentrale Verwaltungsplattform für ESXi-Hosts und vSphere-Umgebungen bereit. Administrator:innen können darüber Hosts und Cluster organisieren, virtuelle Maschinen verwalten, Berechtigungen zuweisen und zahlreiche Infrastrukturaufgaben zentral durchführen. Besonders relevant wird dies bei größeren Installationen, in denen unterschiedliche Teams für Serverbetrieb, Netzwerk, Storage und Datensicherung verantwortlich sind. vCenter unterstützt hierfür rollenbasierte Berechtigungen, eine strukturierte Organisation von Infrastrukturressourcen und die Nachvollziehbarkeit zahlreicher administrativer Vorgänge. Hinzu kommt das über viele Jahre gewachsene VMware-Ökosystem. Zahlreiche Backup-, Monitoring- und Automatisierungsprodukte können mit vSphere und vCenter zusammenarbeiten.
Für Unternehmen, die bereits umfangreiche VMware-Infrastrukturen betreiben, ist diese Integration häufig ein entscheidender Vorteil. Allerdings bedeutet die zentrale Verwaltung auch, dass vCenter selbst zu einer wichtigen Infrastrukturkomponente wird. Verfügbarkeit, Absicherung, Aktualisierung und Wiederherstellbarkeit der Verwaltungsumgebung müssen entsprechend berücksichtigt werden. Ein Ausfall von vCenter führt zwar nicht automatisch zum Stillstand bereits laufender virtueller Maschinen auf den ESXi-Hosts. Zentrale Verwaltungsfunktionen und bestimmte clusterübergreifende Betriebsabläufe können dadurch jedoch eingeschränkt sein.
Microsoft Hyper-V: Verwaltung über mehrere Komponenten
Bei Microsoft Hyper-V gestaltet sich die Verwaltung etwas anders. Einzelne Hosts und virtuelle Maschinen lassen sich beispielsweise über den Hyper-V-Manager, PowerShell oder Windows Admin Center administrieren. Sobald mehrere Hosts zu einer hochverfügbaren Umgebung zusammengefasst werden, kommt zusätzlich Windows Failover Clustering ins Spiel. Der Failover Cluster Manager übernimmt dabei wichtige Aufgaben rund um Clusterressourcen und hochverfügbare virtuelle Maschinen.
Für umfangreichere Virtualisierungsumgebungen bietet Microsoft mit System Center Virtual Machine Manager, kurz SCVMM, eine weitere Verwaltungsebene. SCVMM ermöglicht unter anderem die zentrale Verwaltung von Hyper-V-Hosts, Clustern, virtuellen Maschinen und bestimmten Netzwerk- und Speicherressourcen. Auch standardisierte Bereitstellungsvorgänge und die Organisation größerer Infrastrukturumgebungen lassen sich damit unterstützen. Diese Aufteilung kann zunächst komplexer wirken als eine zentrale Verwaltungsoberfläche, die bereits zahlreiche Funktionen integriert. Allerdings besitzt sie gerade in Microsoft-geprägten IT-Landschaften einen praktischen Vorteil: Administrator:innen können vorhandene Werkzeuge, Berechtigungskonzepte und PowerShell-Kenntnisse weiterverwenden.
Gleichzeitig müssen Unternehmen darauf achten, welche Verwaltungsaufgaben durch welche Komponente abgedeckt werden und wie diese sinnvoll zusammenarbeiten. Denn nicht jede Hyper-V-Umgebung benötigt automatisch SCVMM. Für kleinere Installationen können die integrierten Verwaltungswerkzeuge vollkommen ausreichend sein. Bei größeren Infrastrukturen kann eine zusätzliche zentrale Verwaltung dagegen erhebliche organisatorische Vorteile bieten.
Proxmox VE: Eine gemeinsame Oberfläche für Hosts und Cluster
Proxmox VE verfolgt einen stärker integrierten Verwaltungsansatz. Die webbasierte Administrationsoberfläche ist bereits Bestandteil der Plattform und ermöglicht die Verwaltung einzelner Hosts ebenso wie die Administration mehrerer zu einem Cluster zusammengeschlossener Systeme. Virtuelle Maschinen, LXC-Container, Speicherressourcen, virtuelle Netzwerke und zahlreiche Clusterfunktionen lassen sich innerhalb dieser gemeinsamen Oberfläche konfigurieren. Auch Berechtigungen können rollenbasiert vergeben werden. Proxmox VE unterstützt hierfür unterschiedliche Authentifizierungsverfahren und die Einbindung externer Identitätsquellen, beispielsweise über LDAP oder Microsoft Active Directory.
Für Administrator:innen entsteht damit eine vergleichsweise einheitliche Arbeitsumgebung, ohne dass für die grundlegende Clusterverwaltung zunächst ein separates Produkt wie vCenter oder SCVMM bereitgestellt werden muss. Das kann insbesondere bei kleineren und mittelgroßen Infrastrukturen den Einstieg und den laufenden Betrieb vereinfachen. Allerdings sollten wir daraus nicht schließen, dass die Administration einer Proxmox-Umgebung grundsätzlich weniger Fachkenntnisse erfordert. Gerade bei komplexeren Speicherarchitekturen, verteilten Ceph-Clustern oder anspruchsvollen Netzwerkkonfigurationen sind fundierte Kenntnisse der zugrunde liegenden Linux-Technologien weiterhin wichtig.
Zudem müssen Unternehmen prüfen, welche Anforderungen an zentrale Richtlinien, übergreifendes Monitoring, Auditierung und die Integration vorhandener Managementsysteme bestehen. Eine integrierte Oberfläche erleichtert viele Aufgaben. Sie ersetzt jedoch nicht automatisch sämtliche Prozesse und Werkzeuge eines professionellen Infrastrukturmanagements.
Einheitliche Verwaltung ist mehr als eine gemeinsame Oberfläche
Bei allen drei Plattformen zeigt sich letztlich dieselbe Herausforderung: Eine produktive Virtualisierungsumgebung muss nicht nur administrierbar, sondern auch langfristig beherrschbar sein. Dazu gehören beispielsweise einheitliche Namenskonventionen, klar definierte Administratorrollen, dokumentierte Konfigurationsstandards und nachvollziehbare Änderungsprozesse.
Ebenso wichtig ist die Frage, wie neue Hosts in die Umgebung aufgenommen, Updates ausgerollt und bestehende Systeme regelmäßig auf Abweichungen von den vorgesehenen Konfigurationen überprüft werden. Gerade in größeren Organisationen reicht es deshalb nicht aus, dass mehrere Administrator:innen auf dieselbe Verwaltungsoberfläche zugreifen können. Sie müssen auch nach gemeinsamen Regeln arbeiten. Die Plattform sollte diese Regeln technisch unterstützen und sich möglichst reibungslos in vorhandene Prozesse für Monitoring, Identitätsverwaltung, Dokumentation und Änderungsmanagement integrieren lassen.
Dabei sind die Anforderungen durchaus unterschiedlich. Ein Unternehmen mit drei Virtualisierungshosts benötigt nicht zwangsläufig dieselben Verwaltungsstrukturen wie ein Rechenzentrum mit mehreren Hundert Hosts und unterschiedlichen Betriebsteams. Entscheidend ist vielmehr, dass die eingesetzten Werkzeuge zur tatsächlichen Größe und Komplexität der Umgebung passen. Die beste Administrationslösung ist deshalb nicht zwangsläufig diejenige mit den meisten Funktionen oder der umfangreichsten Verwaltungsoberfläche. Es ist diejenige, mit der sich die eigene Infrastruktur konsistent, sicher und nachvollziehbar betreiben lässt. Wie wichtig diese Beherrschbarkeit ist, zeigt sich spätestens dann, wenn nicht mehr der reguläre Administrationsalltag im Mittelpunkt steht, sondern der Ausfall eines physischen Virtualisierungshosts.
Hochverfügbarkeit: Was passiert, wenn ein Host ausfällt?
Solange alle Virtualisierungshosts zuverlässig arbeiten, unterscheiden sich die grundlegenden Betriebsabläufe der drei Plattformen zunächst wenig. Virtuelle Maschinen werden gestartet, Anwendungen stellen ihre Dienste bereit und Administrator:innen überwachen die verfügbaren Ressourcen. Interessant wird es allerdings in dem Moment, in dem ein physischer Server plötzlich ausfällt. Denn spätestens dann zeigt sich, ob eine Virtualisierungsumgebung lediglich aus mehreren Hosts besteht oder tatsächlich als hochverfügbare Infrastruktur geplant wurde.
In produktiven Umgebungen reicht es schließlich nicht aus, virtuelle Maschinen auf unterschiedlichen Servern betreiben zu können. Entscheidend ist, wie die Infrastruktur auf den Ausfall einzelner Komponenten reagiert und wie schnell betroffene Dienste wieder zur Verfügung stehen. VMware vSphere, Microsoft Hyper-V und Proxmox VE unterstützen entsprechende Hochverfügbarkeitskonzepte. Allerdings unterscheiden sich ihre technischen Mechanismen, die erforderlichen Komponenten und die Möglichkeiten zur automatisierten Wiederherstellung.
VMware vSphere: Automatischer Neustart durch vSphere HA
VMware stellt mit vSphere High Availability (HA) eine etablierte Funktion für den hochverfügbaren Betrieb virtueller Maschinen innerhalb eines Clusters bereit. Die beteiligten ESXi-Hosts überwachen ihre Erreichbarkeit und ihren Zustand mithilfe entsprechender Clustermechanismen. Fällt ein Host aus, kann vSphere HA die betroffenen virtuellen Maschinen auf anderen verfügbaren Hosts automatisch neu starten. Voraussetzung ist allerdings, dass die verbleibenden Clusterknoten über ausreichende Ressourcen verfügen und auf die benötigten virtuellen Festplatten und Konfigurationsdaten zugreifen können. Hier zeigt sich bereits eine wichtige Eigenschaft jeder Hochverfügbarkeitsarchitektur: Ein zusätzlicher Host allein genügt nicht. Auch die erforderlichen Speicher- und Netzwerkressourcen müssen nach einem Ausfall weiterhin verfügbar sein.
Für geplante Wartungsarbeiten bietet VMware mit vMotion außerdem die Möglichkeit, laufende virtuelle Maschinen unter geeigneten Voraussetzungen zwischen Hosts zu verschieben, ohne sie regulär herunterfahren zu müssen. Distributed Resource Scheduler (DRS) kann ergänzend die Ressourcenverteilung innerhalb eines Clusters unterstützen und bei entsprechender Konfiguration Migrationen zur Lastverteilung anstoßen. Diese Funktionen erfüllen jedoch unterschiedliche Aufgaben. vSphere HA reagiert auf bestimmte Ausfallsituationen, während vMotion und DRS vor allem die Verlagerung und Verteilung laufender Workloads unterstützen. Welche Funktionen verfügbar sind, hängt auch hier von der jeweiligen Produkt- und Lizenzkonfiguration ab.
Microsoft Hyper-V: Hochverfügbarkeit durch Failover Clustering
Bei Microsoft Hyper-V übernimmt Windows Server Failover Clustering die zentrale Rolle für den hochverfügbaren Betrieb virtueller Maschinen. Mehrere Hyper-V-Hosts werden dazu zu einem Failovercluster zusammengefasst. Virtuelle Maschinen lassen sich als hochverfügbare Clusterrollen konfigurieren und können bei einem Hostausfall auf verbleibenden Clusterknoten neu gestartet werden. Die Clusterknoten überwachen ihre gegenseitige Erreichbarkeit und den Zustand der verwalteten Ressourcen. Mithilfe von Quorum-Mechanismen entscheidet der Cluster, ob ausreichend Mitglieder beziehungsweise Stimmen für einen sicheren Weiterbetrieb verfügbar sind. Damit soll insbesondere verhindert werden, dass voneinander getrennte Clusterteile dieselben Ressourcen gleichzeitig und widersprüchlich verwalten.
Auch bei Hyper-V müssen die benötigten VM-Daten für die verbleibenden Hosts verfügbar sein. Je nach Architektur kommen beispielsweise gemeinsam genutzte Speicherressourcen, Cluster Shared Volumes oder geeignete softwaredefinierte Speicherlösungen zum Einsatz. Für geplante Wartungsarbeiten steht Hyper-V Live Migration zur Verfügung. Sie ermöglicht es, laufende virtuelle Maschinen unter geeigneten Voraussetzungen zwischen Hosts zu verschieben.
Dabei sollten wir zwei unterschiedliche Szenarien auseinanderhalten: Die Live-Migration dient der geplanten Verlagerung einer laufenden VM. Der automatische Failover nach einem unerwarteten Hostausfall führt in einer klassischen Clusterkonfiguration dagegen normalerweise zu einem Neustart der betroffenen virtuellen Maschine. Die Hochverfügbarkeit entsteht somit nicht allein durch Hyper-V, sondern durch das Zusammenspiel von Hypervisor, Failover Clustering, Speicherarchitektur und Netzwerk.
Proxmox VE: Cluster, Quorum und HA-Manager
Auch Proxmox VE bietet integrierte Funktionen für den hochverfügbaren Betrieb virtueller Maschinen und Container. Mehrere Proxmox-Hosts können zu einem Cluster zusammengeschlossen werden. Die Clusterkommunikation basiert dabei unter anderem auf Corosync, während die Hochverfügbarkeitsverwaltung über die entsprechenden HA-Komponenten der Plattform erfolgt. Eine zentrale Bedeutung besitzt auch hier das Quorum.
Der Cluster muss zuverlässig feststellen können, welche Knoten weiterhin miteinander kommunizieren und welche Entscheidungen über gemeinsam verwaltete Ressourcen zulässig sind. Verliert ein Cluster seine erforderliche Stimmenmehrheit, können bestimmte Verwaltungs- und Hochverfügbarkeitsfunktionen eingeschränkt werden. Das dient dem Schutz vor widersprüchlichen Clusterzuständen. Gerade kleinere Installationen mit lediglich zwei Hosts benötigen deshalb eine sorgfältige Quorum-Planung. Ein zusätzliches QDevice kann in geeigneten Konfigurationen helfen, eine zuverlässige Mehrheitsentscheidung zu ermöglichen.
Für die automatische Wiederherstellung virtueller Maschinen muss außerdem sichergestellt sein, dass ihre benötigten Daten auf einem verbleibenden Host verfügbar sind. Dafür kommen beispielsweise gemeinsam erreichbare Speicherressourcen oder geeignete verteilte Speicherarchitekturen wie Ceph infrage. Auch replizierte Speicherkonfigurationen können unter bestimmten Voraussetzungen verwendet werden, wobei Replikationsintervalle und mögliche Datenverluste berücksichtigt werden müssen.
Proxmox VE unterstützt ebenfalls die Live-Migration laufender virtueller Maschinen. Welche Migrationsmöglichkeiten bestehen und ob dabei auch Speicherinhalte übertragen werden müssen, hängt von der jeweiligen Konfiguration ab. Damit zeigt sich auch bei Proxmox VE: Die integrierten Cluster- und HA-Funktionen erleichtern den Aufbau einer hochverfügbaren Umgebung. Ihre Zuverlässigkeit hängt jedoch wesentlich von der zugrunde liegenden Architektur ab.
Hochverfügbarkeit ist keine unterbrechungsfreie Ausführung
An dieser Stelle sollten wir einen verbreiteten Irrtum vermeiden. Wenn ein physischer Virtualisierungshost plötzlich ausfällt, bedeutet Hochverfügbarkeit in den beschriebenen klassischen Clusterkonfigurationen normalerweise nicht, dass die darauf ausgeführten virtuellen Maschinen ohne Unterbrechung weiterlaufen. Stattdessen wird der Ausfall erkannt und die betroffenen virtuellen Maschinen werden auf anderen verfügbaren Hosts erneut gestartet. Der bisherige Ausführungszustand geht dabei in der Regel verloren. Nicht gespeicherte Daten innerhalb der Anwendungen können betroffen sein, bestehende Netzwerkverbindungen werden unterbrochen und laufende Prozesse müssen nach dem Neustart gegebenenfalls wiederhergestellt werden.
Wie lange diese Unterbrechung dauert, hängt von mehreren Faktoren ab: der Ausfallerkennung, der Clusterentscheidung, der Verfügbarkeit der benötigten Ressourcen, dem Start des Gastbetriebssystems und schließlich dem Wiederanlauf der Anwendungen. Hochverfügbarkeit reduziert die Dauer bestimmter Ausfälle. Sie verhindert jedoch nicht zwangsläufig die Unterbrechung der betroffenen Dienste.
Ein Beispiel aus der Praxis
Stellen wir uns einen Virtualisierungscluster mit drei physischen Hosts vor. Auf dem ersten Host läuft eine virtuelle Maschine mit einer geschäftskritischen Anwendung. Die beiden anderen Hosts verfügen über ausreichend freie Ressourcen, um diese virtuelle Maschine bei Bedarf zu übernehmen.
- Szenario 1: Geplante Wartung: Administrator:innen möchten den ersten Host aktualisieren. Mithilfe einer geeigneten Live-Migration kann die laufende virtuelle Maschine auf einen anderen Host verschoben werden. Die Anwendung bleibt dabei im Idealfall ohne wahrnehmbare Unterbrechung erreichbar, auch wenn technisch kurze Verzögerungen möglich sind.
- Szenario 2: Unerwarteter Hardwareausfall: Der erste Host fällt durch einen Defekt plötzlich aus. Der Cluster erkennt den Fehler und startet die virtuelle Maschine auf einem verbleibenden Host neu. Die Anwendung steht erst wieder zur Verfügung, nachdem das Gastbetriebssystem gestartet und die benötigten Dienste betriebsbereit sind.
- Szenario 3: Ausfall der gemeinsamen Speicherinfrastruktur: Die Hosts selbst sind weiterhin funktionsfähig. Allerdings fällt das Speichersystem aus, auf dem die virtuellen Festplatten liegen. In diesem Fall kann ein automatischer Neustart auf einem anderen Host wirkungslos bleiben, weil auch dieser nicht auf die benötigten Daten zugreifen kann.
Das Beispiel verdeutlicht, warum eine hochverfügbare Virtualisierungsumgebung immer als Gesamtsystem betrachtet werden muss.
Die Verfügbarkeit der Anwendung entscheidet
Für Unternehmen ist letztlich nicht entscheidend, ob ein Hypervisor einen ausgefallenen Host zuverlässig erkennt. Entscheidend ist, ob die darauf betriebenen Anwendungen innerhalb der erforderlichen Zeit wieder zur Verfügung stehen. Deshalb sollten wir zwischen der Hochverfügbarkeit der Virtualisierungsplattform und der Verfügbarkeit der eigentlichen Anwendung unterscheiden. Eine Datenbank kann beispielsweise über eigene Replikations- oder Clustermechanismen verfügen. Auch Webanwendungen lassen sich unter Umständen auf mehrere unabhängige Instanzen verteilen und über einen Load Balancer bereitstellen.
Solche anwendungsbezogenen Konzepte können bestimmte Ausfälle abfangen, ohne dass zunächst eine vollständige virtuelle Maschine neu gestartet werden muss. Sie ersetzen allerdings ebenfalls keine sorgfältige Infrastrukturplanung. Für die Bewertung einer Virtualisierungsplattform sollten Unternehmen deshalb konkrete Wiederherstellungsziele definieren. Dazu gehören insbesondere die maximal tolerierbare Wiederherstellungszeit und der akzeptable Datenverlust, häufig als Recovery Time Objective (RTO) und Recovery Point Objective (RPO) bezeichnet.
Diese Ziele lassen sich nicht allein durch das Aktivieren einer HA-Funktion garantieren. Sie müssen durch geeignete Architekturentscheidungen, realistische Tests und dokumentierte Wiederherstellungsverfahren abgesichert werden. Eine hochverfügbare Virtualisierungsplattform ist deshalb nicht automatisch eine hochverfügbare Anwendung. Erst das Zusammenspiel von Clusterarchitektur, Speicher, Netzwerk und Anwendungskonzept bestimmt, wie widerstandsfähig die gesamte Infrastruktur tatsächlich ist. Und damit gelangen wir zu einer Komponente, deren Bedeutung im Virtualisierungsalltag häufig unterschätzt wird: der Speicherinfrastruktur.
Storage: Die eigentliche Herausforderung liegt häufig unterhalb der VM
Virtuelle Maschinen benötigen Prozessorleistung, Arbeitsspeicher und eine geeignete Netzwerkanbindung. Doch mindestens ebenso wichtig ist die Speicherinfrastruktur, auf der Betriebssysteme, Anwendungen und Daten abgelegt werden. Solange eine virtuelle Maschine auf einem einzelnen Host betrieben wird, erscheint diese Anforderung zunächst überschaubar. Eine virtuelle Festplatte wird angelegt, einem Datenspeicher zugewiesen und anschließend vom Gastbetriebssystem wie ein physisches Laufwerk verwendet. Komplexer wird es, sobald mehrere Hosts zusammenarbeiten, virtuelle Maschinen zwischen ihnen verschoben werden sollen oder eine Infrastruktur auch beim Ausfall einzelner Komponenten verfügbar bleiben muss.
Dann genügt es nicht mehr, dass ein Host auf seine lokalen Datenträger zugreifen kann. Die benötigten Daten müssen auch nach einer Migration oder einem Ausfall dort verfügbar sein, wo die virtuelle Maschine anschließend ausgeführt wird. Die Leistungsfähigkeit einer Virtualisierungsplattform hängt deshalb nicht allein vom Hypervisor ab. Häufig entscheidet die zugrunde liegende Speicherarchitektur darüber, welche Verfügbarkeits- und Betriebsmodelle überhaupt möglich sind.
Lokaler Speicher, Shared Storage und verteilte Systeme
Grundsätzlich lassen sich drei Speicheransätze unterscheiden, die in Virtualisierungsumgebungen unterschiedliche Aufgaben erfüllen. Lokaler Speicher befindet sich unmittelbar im Virtualisierungshost. Dabei kann es sich beispielsweise um SSDs oder NVMe-Laufwerke handeln, die über geeignete Controller und Dateisysteme verwaltet werden. Dieser Ansatz ermöglicht vergleichsweise einfache Architekturen und kann insbesondere bei einzelnen Hosts oder weniger komplexen Installationen wirtschaftlich interessant sein. Allerdings sind die gespeicherten VM-Daten zunächst an den jeweiligen Host gebunden. Fällt dieser aus, stehen seine lokalen Datenträger anderen Hosts nicht automatisch zur Verfügung.
Gemeinsam genutzter Speicher, häufig als Shared Storage bezeichnet, stellt Speicherressourcen mehreren Virtualisierungshosts bereit. Dafür können beispielsweise Storage Area Networks (SAN) mit Fibre Channel oder iSCSI sowie Network Attached Storage (NAS) mit geeigneten Netzwerkprotokollen eingesetzt werden. Der wesentliche Vorteil besteht darin, dass mehrere Hosts auf dieselben benötigten VM-Daten zugreifen können, sofern die jeweilige Plattform und Speicherarchitektur dies unterstützen. Dadurch lassen sich bestimmte Live-Migrations- und Hochverfügbarkeitsszenarien vergleichsweise unkompliziert realisieren. Allerdings muss auch die gemeinsame Speicherinfrastruktur selbst redundant und ausfallsicher ausgelegt werden. Ein zentral bereitgestelltes Speichersystem darf schließlich nicht zum alleinigen Ausfallpunkt der gesamten Virtualisierungsumgebung werden.
Verteilte Speicherarchitekturen verfolgen einen anderen Ansatz. Hier werden Speicherkapazitäten mehrerer Systeme zu einem gemeinsamen logischen Speicherverbund zusammengeführt. Daten können dabei abhängig von der eingesetzten Technologie redundant über unterschiedliche Hosts oder Speicherknoten verteilt werden. Das ermöglicht zusätzliche Architekturvarianten, stellt allerdings höhere Anforderungen an Netzwerkleistung, Datenverteilung und den Umgang mit Fehlerzuständen.
Welche Lösung sinnvoll ist, hängt deshalb nicht allein von der Anzahl der virtuellen Maschinen ab. Auch Leistungsanforderungen, Wiederherstellungsziele, vorhandene Hardware und die administrativen Kompetenzen müssen berücksichtigt werden.
VMware vSphere: Unterschiedliche Speicherarchitekturen unter einer Plattform
VMware vSphere unterstützt verschiedene Speichertechnologien und ermöglicht damit sowohl klassische als auch softwaredefinierte Infrastrukturarchitekturen. In traditionellen Rechenzentrumsumgebungen werden virtuelle Maschinen häufig auf zentral bereitgestellten Datastores betrieben. Je nach Infrastruktur können diese beispielsweise über Fibre Channel, iSCSI oder NFS angebunden sein. Auch lokale Datenträger lassen sich verwenden, wobei die verfügbaren Migrations- und Hochverfügbarkeitsmöglichkeiten von der jeweiligen Konfiguration abhängen. Mit VMware vSAN steht darüber hinaus eine softwaredefinierte Speicherlösung zur Verfügung, die lokale Speicherkapazitäten geeigneter ESXi-Hosts zu einem verteilten Datenspeicher zusammenführen kann. Dabei werden Daten entsprechend den konfigurierten Speicherrichtlinien und den unterstützten Schutzmechanismen über die beteiligten Ressourcen verteilt.
Für Administrator:innen entsteht damit die Möglichkeit, Speicher- und Virtualisierungsverwaltung eng miteinander zu verbinden. Allerdings sind dabei die unterstützten Hardwarekonfigurationen, Netzwerkanforderungen und jeweiligen Lizenzberechtigungen zu berücksichtigen. Gerade bei bestehenden VMware-Umgebungen ist außerdem relevant, welche Storage-Systeme und Integrationen bereits vorhanden sind. Ein Wechsel des Hypervisors kann schließlich auch Auswirkungen auf etablierte Speicherverwaltungs- und Betriebsprozesse haben.
Microsoft Hyper-V: Storage im Zusammenspiel mit Windows Server
Microsoft Hyper-V unterstützt ebenfalls unterschiedliche Speicherarchitekturen. Virtuelle Festplatten können auf lokalen Datenträgern oder geeigneten gemeinsam bereitgestellten Speicherressourcen abgelegt werden. Dazu gehören beispielsweise iSCSI- und Fibre-Channel-basierte SAN-Systeme sowie entsprechend konfigurierte SMB-Dateifreigaben.
Für hochverfügbare Hyper-V-Cluster spielen Cluster Shared Volumes (CSV) eine wichtige Rolle. CSV ermöglicht mehreren Knoten eines Windows Failover Clusters den koordinierten Zugriff auf gemeinsam bereitgestellte Volumes. Dadurch können virtuelle Maschinen innerhalb des Clusters verwaltet und bei geeigneter Konfiguration zwischen Hosts verschoben werden. Wichtig ist allerdings die technische Unterscheidung: CSV stellt selbst keinen verteilten Speicher bereit und ersetzt auch keine redundante Speicherarchitektur. Die Funktion organisiert vielmehr den gemeinsamen Zugriff auf dafür geeignete Speicherressourcen.
Mit Storage Spaces Direct (S2D) bietet Microsoft zusätzlich eine Technologie für softwaredefinierte Speicherarchitekturen. Dabei können lokale Datenträger mehrerer Clusterknoten zu einem gemeinsamen Speicherpool zusammengeführt und Daten über geeignete Resilienzmechanismen geschützt werden. Storage Spaces Direct bildet unter anderem eine technische Grundlage entsprechender hyperkonvergenter Infrastrukturkonzepte.
Hier müssen wir allerdings zwischen klassischen Windows-Server-Konfigurationen und Azure Local unterscheiden. Azure Local nutzt verwandte Microsoft-Technologien für eine eigenständige, Azure-integrierte Infrastrukturplattform. Daraus folgt jedoch nicht, dass beide Betriebsmodelle hinsichtlich Verwaltung, unterstützter Konfigurationen und Lizenzierung identisch sind. Gerade bei Microsoft zeigt sich deshalb, wie wichtig es ist, nicht nur den Hypervisor, sondern die gesamte vorgesehene Infrastrukturarchitektur zu bewerten.
Proxmox VE: Flexible Speicherintegration mit ZFS und Ceph
Proxmox VE unterstützt eine breite Auswahl unterschiedlicher Speichertechnologien. Neben lokalen Datenträgern und klassischen Netzwerkfreigaben lassen sich beispielsweise NFS, iSCSI, LVM-basierte Konfigurationen und ZFS integrieren. Besonders interessant sind dabei zwei Technologien, die unterschiedliche Aufgaben erfüllen.
ZFS kombiniert Dateisystem- und Volume-Management-Funktionen und bietet unter anderem Mechanismen zur Integritätsprüfung, Snapshot-Verwaltung und redundanten Datenspeicherung. In Proxmox-Umgebungen kann ZFS beispielsweise für leistungsfähige lokale Speicherarchitekturen verwendet werden. Darüber hinaus lassen sich geeignete ZFS-basierte Speicherreplikationsverfahren nutzen. Allerdings macht ZFS allein aus mehreren Virtualisierungshosts noch keinen gemeinsam verfügbaren Speichercluster. Werden VM-Daten zwischen Hosts repliziert, müssen unter anderem Replikationsintervalle und mögliche Datenverluste berücksichtigt werden.
Ceph verfolgt dagegen einen verteilten Ansatz. Die Technologie ermöglicht es, Speicherkapazitäten mehrerer Systeme zu einem gemeinsamen Storage-Verbund zusammenzuführen. Proxmox VE integriert hierfür Verwaltungsfunktionen, mit denen sich geeignete Ceph-Umgebungen innerhalb der Virtualisierungsinfrastruktur betreiben lassen. Dabei können virtuelle Maschinen auf verteilten Speicherressourcen abgelegt werden, deren Daten entsprechend der konfigurierten Architektur über mehrere Speicherknoten verteilt sind.
Das eröffnet interessante Möglichkeiten für hochverfügbare Cluster, setzt jedoch eine sorgfältige Planung voraus. Insbesondere Netzwerkbandbreite, Latenz, Speichermedien, Redundanz und die Dimensionierung der beteiligten Hosts beeinflussen die Leistungsfähigkeit und Stabilität der Umgebung. Auch hier gilt: Die Verfügbarkeit einer Technologie innerhalb der Verwaltungsoberfläche bedeutet nicht automatisch, dass sie ohne weitergehende Fachkenntnisse zuverlässig betrieben werden kann.
Hyperkonvergenz verändert die Architektur
Besonders interessant wird der Vergleich, wenn wir klassische Storage-Architekturen den Konzepten einer hyperkonvergenten Infrastruktur (Hyperconverged Infrastructure, HCI) gegenüberstellen. In traditionellen Rechenzentren werden Rechenleistung und Speicher häufig durch unterschiedliche Systeme bereitgestellt. Virtualisierungshosts übernehmen die Ausführung virtueller Maschinen, während zentrale Storage-Systeme die benötigten Daten bereitstellen. Hyperkonvergente Architekturen führen diese Aufgaben enger zusammen. Mehrere Hosts stellen nicht nur Prozessorleistung und Arbeitsspeicher bereit, sondern bringen zugleich lokale Speicherkapazitäten in einen gemeinsamen, softwaredefinierten Speicherverbund ein. VMware vSAN, Storage Spaces Direct und Ceph-basierte Proxmox-Umgebungen verfolgen in diesem Zusammenhang verwandte Grundideen, unterscheiden sich jedoch erheblich hinsichtlich Architektur, unterstützter Konfigurationen und Betriebsmodell.
Die Vorteile können durchaus interessant sein: Rechen- und Speicherressourcen lassen sich innerhalb einer gemeinsamen Infrastruktur bereitstellen, zusätzliche Kapazitäten können durch geeignete Erweiterungen ergänzt werden und separate zentrale Storage-Systeme sind nicht in jedem Szenario erforderlich. Allerdings sollten wir Hyperkonvergenz keineswegs automatisch mit geringerer Komplexität gleichsetzen. Denn mit der Zusammenführung von Compute und Storage entstehen neue technische Abhängigkeiten. Fällt ein Host aus, verliert die Infrastruktur unter Umständen nicht nur Rechenleistung, sondern gleichzeitig einen Teil ihrer Speicherkapazität oder ihrer redundanten Datenkopien. Die verbleibenden Systeme müssen diesen Ausfall auffangen können. Je nach Architektur können außerdem Wiederherstellungs- und Rebalancing-Prozesse zusätzliche Netzwerk-, Prozessor- und Speicherressourcen beanspruchen.
Deshalb müssen insbesondere folgende Aspekte berücksichtigt werden:
- Netzwerkarchitektur: Bandbreite, Latenz, Redundanz und die Trennung unterschiedlicher Datenverkehrsarten
- Fehlertoleranz: Die Anzahl der tolerierbaren Ausfälle und die dafür erforderlichen Datenkopien beziehungsweise Redundanzmechanismen
- Kapazitätsplanung: Ausreichende Reserven für den Regelbetrieb, Ausfallsituationen und die Wiederherstellung redundanter Datenbestände
- Hardwarekompatibilität: Unterstützte Controller, Datenträger, Netzwerkkarten und gegebenenfalls herstellerspezifische Anforderungen
- Betriebsprozesse: Überwachung, Wartung, Erweiterung und Wiederherstellung des verteilten Speichersystems
Gerade bei kleineren Installationen kann deshalb eine klassische Architektur mit einem geeigneten zentralen Speichersystem einfacher zu betreiben sein als ein verteilter Storage-Cluster. Umgekehrt kann eine hyperkonvergente Umgebung bei passenden Anforderungen eine leistungsfähige und flexibel erweiterbare Alternative darstellen.
Speicherleistung ist nicht nur eine Frage der IOPS
Bei der Bewertung unterschiedlicher Storage-Architekturen sollten wir schließlich einen weiteren Aspekt berücksichtigen. Die Leistungsfähigkeit einer Speicherlösung lässt sich nicht allein anhand der maximal erreichbaren Ein- und Ausgabeoperationen pro Sekunde, der sogenannten IOPS, beurteilen. Mindestens ebenso wichtig sind die Latenz einzelner Speicherzugriffe, der erreichbare Datendurchsatz und das Verhalten unter gleichzeitiger Belastung durch mehrere virtuelle Maschinen.
Ein Datenbankserver mit vielen kleinen, zeitkritischen Schreiboperationen stellt beispielsweise andere Anforderungen als ein Dateiserver, der überwiegend große Datenmengen sequenziell überträgt. Hinzu kommen Hintergrundprozesse wie Snapshots, Replikation, Datensicherung oder die Wiederherstellung redundanter Datenbestände. Gerade bei verteilten Speichersystemen können diese Vorgänge zusätzliche Last erzeugen, die bei einer rein theoretischen Leistungsbetrachtung leicht übersehen wird.
Deshalb sollten Speicherarchitekturen möglichst anhand realistischer Workloads und nicht ausschließlich anhand einzelner Benchmarkwerte bewertet werden. Die beste Storage-Lösung ist nicht zwangsläufig diejenige mit der höchsten theoretischen Leistung oder der modernsten Architektur. Entscheidend ist, ob sie die benötigten Daten unter den vorgesehenen Betriebs- und Fehlerbedingungen zuverlässig, mit ausreichender Leistung und innerhalb der wirtschaftlichen Rahmenbedingungen bereitstellt. Damit wird zugleich deutlich, warum Storage und Hochverfügbarkeit untrennbar miteinander verbunden sind.
Eine virtuelle Maschine lässt sich nur dann erfolgreich auf einem anderen Host neu starten, wenn auch ihre benötigten Daten verfügbar und konsistent sind. Doch selbst eine hochverfügbare Speicherarchitektur beantwortet noch nicht die Frage, wie sich versehentlich gelöschte, beschädigte oder verschlüsselte Daten wiederherstellen lassen. Und damit gelangen wir zu einem weiteren entscheidenden Bestandteil jeder Virtualisierungsinfrastruktur: der Datensicherung.
Backup: Ein Snapshot ist noch keine Datensicherung
Eine hochverfügbare Virtualisierungsumgebung kann den Ausfall eines physischen Hosts abfangen. Redundante Speicherarchitekturen können dafür sorgen, dass virtuelle Festplatten auch beim Defekt einzelner Datenträger weiterhin erreichbar bleiben. Doch was geschieht, wenn eine Administratorin versehentlich eine wichtige virtuelle Maschine löscht? Wenn eine Datenbank durch einen Softwarefehler beschädigt wird? Oder wenn ein Ransomware-Angriff nicht nur produktive Systeme, sondern auch erreichbare Speicherressourcen verschlüsselt?
In solchen Situationen helfen Hochverfügbarkeit und Speicherredundanz allein häufig nicht weiter. Denn beide Konzepte verfolgen in erster Linie das Ziel, den Betrieb trotz bestimmter technischer Fehler aufrechtzuerhalten. Eine versehentliche Löschung oder eine unerwünschte Datenänderung kann dagegen auch auf redundante Systeme übertragen werden. Genau deshalb gehört die Datensicherung zu den wichtigsten Entscheidungskriterien beim Vergleich von VMware vSphere, Microsoft Hyper-V und Proxmox VE.
Alle drei Plattformen bieten Möglichkeiten, Zustände virtueller Maschinen zu erfassen und Datensicherungslösungen einzubinden. Daraus folgt allerdings nicht, dass jede dieser Funktionen bereits ein vollständiges Backupkonzept darstellt. Eine zuverlässige Virtualisierungsinfrastruktur benötigt nicht nur Mechanismen zur Vermeidung von Ausfällen, sondern auch einen unabhängigen Weg zurück zu einem definierten, wiederherstellbaren Datenzustand.
Snapshot, Replikation und Backup: Drei unterschiedliche Aufgaben
Im Virtualisierungsalltag begegnen uns mehrere Technologien, die auf den ersten Blick ähnliche Ziele verfolgen. Tatsächlich unterscheiden sie sich jedoch grundlegend. Snapshots beziehungsweise Checkpoints erfassen einen bestimmten Zustand einer virtuellen Maschine oder ihrer virtuellen Datenträger. Sie können beispielsweise vor einem Softwareupdate oder einer Konfigurationsänderung angelegt werden, um bei Problemen auf einen früheren Zustand zurückkehren zu können. Dabei hängt der genaue Funktionsumfang von der eingesetzten Plattform und Snapshot-Technologie ab. Manche Verfahren erfassen ausschließlich den Festplattenzustand, andere können zusätzlich den Arbeitsspeicher oder anwendungskonsistente Zustände berücksichtigen.
Snapshots sind jedoch häufig von der ursprünglichen Speicherinfrastruktur und den zugehörigen Datenstrukturen abhängig. Fällt diese vollständig aus, stehen unter Umständen auch die Snapshots nicht mehr zur Verfügung. Außerdem können langfristig bestehende Snapshots die Speicherverwaltung erschweren, zusätzlichen Speicherplatz beanspruchen und die Leistung beeinträchtigen.
Replikation verfolgt einen anderen Ansatz. Hier werden Daten oder virtuelle Maschinen regelmäßig beziehungsweise fortlaufend auf ein weiteres System übertragen. Das kann die Wiederherstellung nach einem Host- oder Standortausfall erheblich erleichtern. Allerdings werden je nach Verfahren auch unerwünschte Änderungen repliziert. Eine beschädigte Datei oder eine verschlüsselte virtuelle Festplatte kann dadurch ebenfalls auf dem Zielsystem landen. Replikation ist deshalb nicht automatisch ein Ersatz für eine unabhängige Datensicherung.
Ein Backup erstellt dagegen eine wiederherstellbare Sicherung von Daten oder Systemzuständen, die nach einer definierten Aufbewahrungsstrategie vorgehalten wird. Geeignete Backupverfahren ermöglichen es, unterschiedliche Wiederherstellungspunkte bereitzustellen und Daten unabhängig vom aktuellen Zustand der produktiven Systeme wiederherzustellen. Entscheidend ist dabei, dass die Sicherungsdaten ausreichend vom Produktivsystem getrennt, gegen unbefugte Veränderungen geschützt und regelmäßig auf ihre Wiederherstellbarkeit überprüft werden.
VMware vSphere: Ein umfangreiches Backup-Ökosystem
VMware verfügt über ein über viele Jahre gewachsenes Ökosystem für die Datensicherung virtualisierter Infrastrukturen. Zahlreiche kommerzielle Backupplattformen unterstützen die Sicherung virtueller Maschinen auf VMware vSphere und integrieren sich dafür unter anderem in die Verwaltungs- und Schnittstellenarchitektur der Plattform. Für imagebasierte Sicherungsverfahren spielen beispielsweise die vSphere Storage APIs for Data Protection (VADP) eine wichtige Rolle. Sie ermöglichen geeigneten Backupanwendungen den Zugriff auf virtuelle Maschinendaten, ohne dass sämtliche Sicherungsvorgänge innerhalb des Gastbetriebssystems durchgeführt werden müssen. Ergänzende Mechanismen wie Changed Block Tracking (CBT) können dazu beitragen, bei inkrementellen Sicherungen nur die seit dem vorherigen Sicherungspunkt veränderten Datenblöcke zu verarbeiten.
Gerade in größeren VMware-Umgebungen sind solche Integrationen häufig Bestandteil etablierter Betriebsprozesse. Allerdings sollten Unternehmen bei einem Plattformwechsel sorgfältig prüfen, ob ihre vorhandene Backupsoftware auch die neue Virtualisierungsumgebung unterstützt und welche Funktionen dort tatsächlich zur Verfügung stehen. Denn eine Backupsoftware, die mehrere Hypervisoren unterstützt, bietet nicht zwangsläufig auf allen Plattformen denselben Funktionsumfang.
Microsoft Hyper-V: Datensicherung über Windows und spezialisierte Produkte
Auch Microsoft Hyper-V lässt sich in unterschiedliche kommerzielle Datensicherungslösungen integrieren. Dabei können Backupanwendungen auf Funktionen und Schnittstellen des Windows- und Hyper-V-Ökosystems zurückgreifen. Eine wichtige Rolle spielen unter anderem Volume Shadow Copy Service (VSS) und die Hyper-V-spezifischen Sicherungsmechanismen, mit denen geeignete Backupsoftware konsistente Sicherungspunkte virtueller Maschinen erstellen kann. Für Windows-Gastsysteme lassen sich dadurch unter entsprechenden Voraussetzungen auch anwendungskonsistente Sicherungen unterstützen.
Allerdings ist zwischen einem technisch erfolgreich erstellten VM-Backup und einer tatsächlich anwendungskonsistenten Sicherung zu unterscheiden. Gerade Datenbank- und Anwendungssysteme benötigen unter Umständen zusätzliche Integrationen oder spezifische Sicherungsverfahren, damit ihre Daten nach einer Wiederherstellung zuverlässig verwendet werden können. Windows Server bietet zwar eigene Sicherungsfunktionen, doch für umfangreichere Virtualisierungsumgebungen werden häufig spezialisierte Backupplattformen eingesetzt. Diese können beispielsweise zentrale Sicherungsrichtlinien, Aufbewahrungszeiträume, Wiederherstellung einzelner Dateien und die Absicherung mehrerer Hyper-V-Hosts unterstützen. Welche Funktionen verfügbar sind, hängt dabei vom jeweiligen Produkt und der konkreten Konfiguration ab.
Proxmox VE: Datensicherung mit Proxmox Backup Server
Im Proxmox-Ökosystem steht mit Proxmox Backup Server (PBS) eine speziell für die Datensicherung entwickelte Lösung zur Verfügung. Sie integriert sich eng in Proxmox VE und ermöglicht unter anderem die Sicherung virtueller Maschinen und unterstützter Container-Workloads. Zu den wesentlichen Funktionen gehören inkrementelle Sicherungen, Deduplizierung, Komprimierung, Verschlüsselungsmöglichkeiten und definierbare Aufbewahrungsrichtlinien. Darüber hinaus unterstützt Proxmox Backup Server Integritätsprüfungen und verschiedene Wiederherstellungsszenarien.
Besonders interessant ist die Möglichkeit, Sicherungsdaten auf einer eigenständigen Backupinfrastruktur abzulegen und diese von den produktiven Virtualisierungshosts zu trennen. Damit entsteht eine klarere Trennung zwischen dem Betrieb virtueller Maschinen und der Aufbewahrung ihrer Sicherungen. Allerdings sollte auch hier nicht der Eindruck entstehen, dass die Installation eines Backupservers bereits ein vollständiges Datensicherungskonzept ersetzt. Die Absicherung der Backupzugänge, die Trennung administrativer Berechtigungen, die Aufbewahrung zusätzlicher Sicherungskopien und die Wiederherstellung nach einem vollständigen Infrastrukturverlust müssen weiterhin geplant werden. Auch bei Proxmox VE können abhängig vom eingesetzten Produkt weitere kompatible Datensicherungslösungen verwendet werden. Deren jeweiliger Funktionsumfang sollte jedoch ausdrücklich geprüft werden.
Die eigentliche Herausforderung beginnt bei der Wiederherstellung
Im täglichen Betrieb konzentriert sich die Aufmerksamkeit häufig auf die erfolgreiche Durchführung geplanter Sicherungen. Backupjobs werden überwacht, Fehlermeldungen ausgewertet und Aufbewahrungsrichtlinien kontrolliert. Doch eine erfolgreich abgeschlossene Sicherung bedeutet noch nicht automatisch, dass sich eine Anwendung innerhalb der benötigten Zeit wiederherstellen lässt.
Dafür müssen wir uns erneut mit zwei Kennzahlen beschäftigen, die uns bereits im Zusammenhang mit der Hochverfügbarkeit begegnet sind: Das Recovery Point Objective (RPO) beschreibt, wie weit der wiederhergestellte Datenstand im ungünstigsten zulässigen Fall zurückliegen darf. Das Recovery Time Objective (RTO) definiert dagegen, innerhalb welcher Zeit ein System oder Dienst nach einem Ausfall wieder zur Verfügung stehen soll.
Ein Unternehmen, das maximal eine Stunde Datenverlust tolerieren kann, benötigt eine andere Sicherungsfrequenz als eine Organisation, bei der ein Wiederherstellungspunkt vom Vortag ausreicht. Ebenso macht es einen erheblichen Unterschied, ob eine virtuelle Maschine innerhalb weniger Minuten oder erst nach mehreren Stunden wieder betriebsbereit sein muss. Dabei umfasst die Wiederherstellungszeit nicht nur das Zurückkopieren einer virtuellen Festplatte. Auch die Bereitstellung geeigneter Hardware, die Konfiguration virtueller Netzwerke, das Starten des Gastbetriebssystems und die Wiederherstellung abhängiger Anwendungen können Zeit beanspruchen. Gerade nach einem größeren Infrastrukturverlust zeigt sich deshalb, ob die vorhandene Backupstrategie tatsächlich zu den definierten Wiederherstellungszielen passt.
Schutz vor Ransomware: Auch Backups benötigen eine Sicherheitsarchitektur
Eine besondere Herausforderung stellen Angriffe dar, bei denen nicht nur produktive Daten, sondern gezielt auch vorhandene Sicherungen kompromittiert werden sollen. Wenn Angreifer mit denselben administrativen Berechtigungen sowohl virtuelle Maschinen als auch deren Backupbestände verändern oder löschen können, entsteht eine erhebliche zusätzliche Gefährdung. Deshalb sollten Datensicherungskonzepte möglichst unterschiedliche Schutzebenen vorsehen.
Dazu gehören insbesondere:
- Getrennte Berechtigungen: Backupadministration und produktive Virtualisierungsverwaltung sollten nicht unnötig dieselben privilegierten Zugänge verwenden
- Unveränderbare oder offline aufbewahrte Sicherungen: Geeignete Speicher- und Aufbewahrungsverfahren können verhindern, dass Sicherungsdaten innerhalb definierter Zeiträume nachträglich verändert oder gelöscht werden
- Zusätzliche Sicherungskopien: Eine räumlich oder logisch getrennte Kopie reduziert die Abhängigkeit von einem einzelnen Standort oder Speichersystem
- Regelmäßige Wiederherstellungstests: Nicht nur die Integrität der Sicherungsdaten, sondern auch die tatsächliche Wiederherstellbarkeit der Anwendungen muss überprüft werden
Als Orientierung kann beispielsweise die 3-2-1-Regel dienen: drei Datenkopien insgesamt, auf zwei unterschiedlichen Speichermedien beziehungsweise Speicherarten, davon mindestens eine Kopie an einem anderen Standort. Für einen erhöhten Schutz werden häufig weiterentwickelte Konzepte verwendet, die unveränderbare oder offline aufbewahrte Sicherungen und regelmäßige Wiederherstellungsprüfungen ausdrücklich berücksichtigen. Entscheidend ist jedoch nicht die Bezeichnung einer bestimmten Backupstrategie, sondern ihre praktische Wirksamkeit im eigenen Infrastrukturkontext.
Disaster Recovery: Wenn nicht nur eine virtuelle Maschine ausfällt
Schließlich müssen wir zwischen der Wiederherstellung einzelner Systeme und einem umfassenderen Disaster-Recovery-Konzept unterscheiden. Ein versehentlich gelöschter Dateiserver stellt andere Anforderungen als der vollständige Verlust eines Virtualisierungsclusters oder eines Rechenzentrumsstandorts. Im ersten Fall kann die Wiederherstellung einer einzelnen virtuellen Maschine ausreichen. Im zweiten Fall müssen möglicherweise zunächst neue Virtualisierungshosts bereitgestellt, Netzwerke rekonstruiert, Speicherressourcen eingerichtet und Verwaltungs- sowie Identitätsdienste wiederhergestellt werden. Erst anschließend können die eigentlichen Anwendungen in einer geeigneten Reihenfolge gestartet werden.
Gerade hier zeigt sich, warum die Datensicherung nicht isoliert von der Virtualisierungsarchitektur betrachtet werden darf. Ein vollständiges Wiederherstellungskonzept muss auch die Konfiguration der Infrastruktur, erforderliche Zugangsdaten, Abhängigkeiten zwischen Anwendungen und die Verfügbarkeit geeigneter Ersatzressourcen berücksichtigen. Entscheidend ist deshalb nicht, ob VMware, Hyper-V oder Proxmox VE Backups erstellen beziehungsweise unterstützen können. Entscheidend ist, ob sich mit dem jeweiligen Gesamtkonzept die erforderlichen Daten und Anwendungen innerhalb der definierten Wiederherstellungsziele zuverlässig zurückholen lassen. Damit wird die Datensicherung zu einem wesentlichen Bestandteil der langfristigen Betriebsstrategie und nicht lediglich zu einer zusätzlichen Funktion der Virtualisierungsplattform.
Doch auch außerhalb von Fehler- und Wiederherstellungssituationen stellt sich eine wichtige Frage: Wie lassen sich die zahlreichen wiederkehrenden Aufgaben einer Virtualisierungsumgebung möglichst einheitlich, nachvollziehbar und effizient durchführen? Genau hier gewinnt die Automatisierung an Bedeutung.
Automatisierung: Wenn aus Administration Infrastrukturmanagement wird
Eine neue virtuelle Maschine bereitzustellen, ist auf allen drei betrachteten Plattformen eine überschaubare Aufgabe. Administrator:innen wählen die benötigten Ressourcen aus, konfigurieren die Netzwerkanbindung, weisen Speicherplatz zu und starten anschließend die Installation des Gastbetriebssystems. Doch was geschieht, wenn nicht eine einzelne virtuelle Maschine benötigt wird, sondern regelmäßig Dutzende neuer Systeme bereitgestellt werden müssen? Dann genügt es nicht mehr, dass sich die einzelnen Arbeitsschritte über eine grafische Verwaltungsoberfläche durchführen lassen. Vielmehr stellt sich die Frage, wie sich diese Vorgänge standardisieren, wiederholen und möglichst fehlerfrei in bestehende Betriebsprozesse integrieren lassen.
Denn eine virtuelle Maschine ist nach ihrer Erstellung noch längst kein vollständig betriebsbereites System. Sie benötigt möglicherweise eine definierte Netzwerkkonfiguration, eine Einbindung in die vorhandene Identitätsinfrastruktur, Sicherheitsrichtlinien, Monitoring, Datensicherung und eine nachvollziehbare Dokumentation. Werden all diese Aufgaben jedes Mal manuell durchgeführt, entstehen nicht nur zusätzliche Aufwände. Auch die Gefahr uneinheitlicher Konfigurationen und administrativer Fehler wächst. Automatisierung bedeutet deshalb nicht lediglich, Mausklicks durch Skripte zu ersetzen. Sie schafft die Grundlage dafür, Infrastruktur nach definierten Regeln reproduzierbar bereitzustellen und zu betreiben.
VMware vSphere: Automatisierung in einem gewachsenen Ökosystem
VMware bietet seit vielen Jahren umfangreiche Möglichkeiten, Verwaltungsaufgaben über Skripte, Programmierschnittstellen und externe Automatisierungsplattformen durchzuführen. Eine besonders etablierte Technologie ist VMware PowerCLI. Die PowerShell-basierten Werkzeuge ermöglichen es, zahlreiche Verwaltungsaufgaben innerhalb von vSphere automatisiert auszuführen. Dazu gehören beispielsweise die Bereitstellung virtueller Maschinen, die Konfiguration von Hosts, die Verwaltung von Ressourcen und die Auswertung von Infrastrukturinformationen.
Ergänzend stellt VMware APIs bereit, über die sich geeignete externe Anwendungen und Automatisierungslösungen integrieren lassen. Damit können Unternehmen wiederkehrende Aufgaben in eigene Skripte, Bereitstellungsprozesse und übergreifende Infrastrukturworkflows einbinden. Auch Infrastructure-as-Code-Werkzeuge wie Terraform beziehungsweise entsprechende Provider können für unterstützte vSphere-Ressourcen eingesetzt werden.
Gerade in größeren VMware-Umgebungen ist diese Integrationsfähigkeit ein wesentlicher Vorteil. Viele Unternehmen haben über Jahre eigene Automatisierungen entwickelt oder vorhandene Produkte in ihre Betriebsabläufe eingebunden. Allerdings entsteht daraus auch eine Abhängigkeit: Bei einem Plattformwechsel müssen nicht nur virtuelle Maschinen migriert, sondern häufig auch Skripte, Schnittstellen und automatisierte Prozesse angepasst werden.
Microsoft Hyper-V: PowerShell als gemeinsame Grundlage
Microsoft Hyper-V lässt sich umfassend über Windows PowerShell verwalten. Viele Aufgaben, die Administrator:innen über den Hyper-V-Manager oder andere Verwaltungswerkzeuge durchführen, können auch mithilfe entsprechender PowerShell-Cmdlets automatisiert werden. Virtuelle Maschinen lassen sich erstellen, konfigurieren, starten, verschieben und überwachen. Auch die Verwaltung virtueller Switches, virtueller Festplatten und zahlreicher Hosteinstellungen kann skriptbasiert erfolgen.
Besonders interessant ist dabei die Einbindung in das übrige Windows-Server-Ökosystem. Denn PowerShell beschränkt sich nicht auf Hyper-V. Dieselbe Skriptumgebung kann beispielsweise auch für Aufgaben rund um Active Directory, Netzwerkkonfigurationen, Windows-Dienste und weitere Infrastrukturkomponenten eingesetzt werden. Dadurch lassen sich unterschiedliche Bereitstellungsschritte zu gemeinsamen Abläufen zusammenführen. Ein Skript könnte beispielsweise eine virtuelle Maschine anlegen, die benötigten Ressourcen zuweisen und anschließend weitere vorbereitende Konfigurationsschritte anstoßen.
Für umfangreichere Umgebungen können ergänzend System Center Virtual Machine Manager und geeignete externe Automatisierungsplattformen eingesetzt werden. Windows Admin Center bietet ebenfalls Verwaltungs- und Erweiterungsmöglichkeiten, ersetzt aber keine umfassende Infrastructure-as-Code-Plattform. Für Unternehmen mit bereits vorhandenen PowerShell-Kompetenzen kann Hyper-V deshalb einen organisatorischen Vorteil besitzen. Allerdings gilt auch hier: Die Verfügbarkeit einer Skriptschnittstelle garantiert noch keine einheitliche Automatisierungsstrategie. Gerade beim Zusammenspiel mehrerer Verwaltungswerkzeuge müssen Zuständigkeiten und Konfigurationsstandards klar definiert werden.
Proxmox VE: API-basierte Verwaltung und offene Werkzeuge
Proxmox VE stellt ebenfalls umfangreiche Möglichkeiten zur Automatisierung bereit. Eine zentrale Rolle spielt die REST-API, über die sich zahlreiche Verwaltungsfunktionen programmatisch ansprechen lassen. Ergänzend stehen Kommandozeilenwerkzeuge zur Verfügung, mit denen Administrator:innen virtuelle Maschinen, Container, Clusterressourcen und weitere Infrastrukturkomponenten verwalten können. Damit lassen sich Bereitstellungs- und Verwaltungsaufgaben in eigene Skripte oder externe Automatisierungsplattformen integrieren.
Für Infrastructure-as-Code-Szenarien existieren außerdem Terraform- und OpenTofu-Provider sowie weitere Integrationen, beispielsweise für Ansible. Dabei sollte allerdings berücksichtigt werden, dass nicht jede Integration denselben Entwicklungsstand, Funktionsumfang oder Supportstatus besitzt. Insbesondere bei Community-gepflegten Erweiterungen müssen Unternehmen prüfen, ob die eingesetzten Versionen zuverlässig unterstützt werden und wie langfristig die jeweiligen Schnittstellen und Werkzeuge gepflegt werden.
Für Linux-orientierte Teams kann der offene und API-basierte Ansatz von Proxmox VE besonders interessant sein. Gleichzeitig müssen auch hier geeignete Standards für Berechtigungen, Zugangsdaten, Konfigurationsverwaltung und Fehlerbehandlung geschaffen werden. Denn eine offene Schnittstelle allein macht aus einer Virtualisierungsumgebung noch keine automatisiert betriebene Infrastruktur.
Infrastructure as Code: Infrastruktur wird beschreibbar
Die eigentliche Veränderung beginnt dort, wo Infrastruktur nicht mehr ausschließlich durch einzelne administrative Eingriffe entsteht, sondern durch definierte und wiederverwendbare Konfigurationen beschrieben wird. Dieses Prinzip wird als Infrastructure as Code (IaC) bezeichnet. Anstatt beispielsweise jede virtuelle Maschine manuell anzulegen, können Unternehmen festlegen, welche Ressourcen ein bestimmter Systemtyp benötigt. Eine solche Definition könnte unter anderem die Anzahl virtueller Prozessoren, den Arbeitsspeicher, die benötigten Datenträger und die Netzwerkanbindung umfassen. Geeignete Werkzeuge verwenden diese Vorgaben anschließend, um die entsprechenden Ressourcen über die unterstützten Schnittstellen der Virtualisierungsplattform bereitzustellen.
Der wesentliche Vorteil liegt in der Wiederholbarkeit. Wenn mehrere Systeme nach demselben Standard erstellt werden sollen, müssen die entsprechenden Einstellungen nicht jedes Mal erneut manuell vorgenommen werden. Darüber hinaus können Infrastrukturdefinitionen in Versionsverwaltungssystemen wie Git abgelegt und Änderungen nachvollziehbar dokumentiert werden.
Allerdings müssen wir zwischen der Bereitstellung virtueller Infrastruktur und der Konfiguration der darauf betriebenen Systeme unterscheiden. Terraform oder OpenTofu können beispielsweise unterstützte Infrastrukturressourcen deklarativ verwalten. Werkzeuge wie Ansible können ergänzend Aufgaben innerhalb der bereitgestellten Betriebssysteme übernehmen. Je nach Architektur kommen weitere Verfahren für Betriebssystembereitstellung, Konfigurationsmanagement und Anwendungsinstallation hinzu. Erst das koordinierte Zusammenspiel dieser Komponenten ermöglicht einen weitgehend automatisierten Bereitstellungsprozess.
Automatisierung verändert auch die Anforderungen an den Betrieb
Mit zunehmender Automatisierung verändern sich die Aufgaben der Administrator:innen. Statt einzelne Systeme immer wieder manuell zu konfigurieren, müssen sie verlässliche Standards entwickeln, Automatisierungsabläufe pflegen und deren Ergebnisse kontrollieren. Dabei entstehen neue Anforderungen an die Qualität und Sicherheit der eingesetzten Verfahren. Automatisierungen benötigen geeignete Berechtigungen, müssen Fehler zuverlässig erkennen und dürfen vorhandene Systeme nicht unbeabsichtigt verändern. Auch der Umgang mit Zugangsdaten und anderen vertraulichen Informationen muss berücksichtigt werden. Hinzu kommt die Frage, wie sich Änderungen vor ihrem produktiven Einsatz testen und bei Problemen gegebenenfalls zurücknehmen lassen. Gerade in größeren Organisationen können automatisierte Bereitstellungsprozesse deshalb mit Freigabeverfahren, Versionsverwaltung und bestehenden Change-Management-Prozessen verbunden werden.
Eine weitere Herausforderung entsteht durch Configuration Drift. Darunter verstehen wir Abweichungen zwischen einem vorgesehenen Konfigurationszustand und der tatsächlich betriebenen Infrastruktur. Solche Abweichungen können beispielsweise entstehen, wenn Administrator:innen Einstellungen nachträglich manuell verändern, ohne die zugrunde liegenden Infrastrukturdefinitionen anzupassen. Geeignete Automatisierungs- und Konfigurationsmanagementverfahren können helfen, solche Unterschiede zu erkennen und kontrolliert zu korrigieren. Dabei muss allerdings berücksichtigt werden, dass nicht jede Änderung automatisch und ohne Prüfung zurückgesetzt werden sollte. Automatisierung schafft erst dann einen nachhaltigen Mehrwert, wenn sie nicht nur die Bereitstellung beschleunigt, sondern auch die Sicherheit, Konsistenz und Nachvollziehbarkeit des laufenden Betriebs verbessert.
Nicht die Anzahl der Schnittstellen entscheidet
Technisch lassen sich auf VMware vSphere, Microsoft Hyper-V und Proxmox VE zahlreiche Infrastrukturaufgaben automatisieren. Die Unterschiede liegen deshalb häufig weniger in der grundsätzlichen Frage, ob eine bestimmte Aufgabe automatisiert werden kann. Entscheidend ist vielmehr, wie vollständig und zuverlässig die benötigten Funktionen über unterstützte Schnittstellen erreichbar sind, welche Werkzeuge bereits eingesetzt werden und wie gut sich die Plattform in vorhandene Betriebsprozesse integrieren lässt. Ein Unternehmen mit umfangreichen PowerCLI-Automatisierungen wird einen Wechsel von VMware anders bewerten als eine Organisation, deren Infrastrukturverwaltung bereits weitgehend auf PowerShell basiert. Für Teams mit Linux-Erfahrung und etablierten API-basierten Bereitstellungsverfahren kann wiederum Proxmox VE eine interessante Alternative darstellen.
Dabei sollten Unternehmen auch den langfristigen Pflegeaufwand berücksichtigen. Skripte und Automatisierungen müssen dokumentiert, getestet und bei Änderungen der Plattform regelmäßig überprüft werden. Die beste Automatisierungsplattform ist deshalb nicht zwangsläufig diejenige mit den meisten Schnittstellen. Entscheidend ist, wie zuverlässig sich die benötigten Infrastrukturprozesse damit standardisieren, integrieren und dauerhaft betreiben lassen. Damit erweitert sich unser Plattformvergleich um eine weitere Dimension: Neben der technischen Leistungsfähigkeit und den verfügbaren Funktionen müssen wir auch die Kosten für Werkzeuge, Kompetenzen und den laufenden Betrieb berücksichtigen. Denn eine Virtualisierungsplattform kann auf den ersten Blick wirtschaftlich attraktiv erscheinen und dennoch erhebliche Folgekosten verursachen.
Lizenzierung und Kosten: Kostenlos ist nicht gleich wirtschaftlich
Spätestens bei der wirtschaftlichen Betrachtung wird deutlich, warum sich viele Unternehmen derzeit erneut mit ihrer Virtualisierungsstrategie beschäftigen. Über Jahre hinweg galt VMware in zahlreichen Rechenzentren als etablierte Plattform. Lizenz- und Wartungskosten waren Bestandteil langfristiger Infrastrukturplanungen und wurden häufig im Rahmen regelmäßiger Vertragsverlängerungen fortgeschrieben. Mit der Übernahme durch Broadcom und der anschließenden Neuausrichtung des VMware-Portfolios haben sich diese Rahmenbedingungen jedoch verändert. Die Umstellung auf stärker gebündelte Produktangebote und abonnementbasierte Lizenzmodelle führt dazu, dass Unternehmen ihre bisherigen Kostenstrukturen neu bewerten müssen.
Dabei geht es nicht zwangsläufig darum, dass VMware für jedes Unternehmen unwirtschaftlich geworden wäre. Entscheidend ist vielmehr, ob die angebotenen Produktpakete, Lizenzbedingungen und Vertragsmodelle weiterhin zu den tatsächlichen Anforderungen passen. Gleichzeitig rücken Alternativen wie Microsoft Hyper-V und Proxmox VE stärker in den Mittelpunkt. Doch auch hier wäre es zu einfach, lediglich die Lizenzpreise gegenüberzustellen. Die Kosten einer Virtualisierungsplattform entstehen nicht nur durch den Hypervisor, sondern durch das gesamte technische und organisatorische Umfeld, das für einen zuverlässigen Betrieb erforderlich ist.
VMware: Abonnementmodelle und gebündelte Produktangebote
Unter Broadcom wurde das VMware-Produktportfolio neu strukturiert. Im Mittelpunkt stehen insbesondere abonnementbasierte Angebote wie VMware vSphere Foundation (VVF) und VMware Cloud Foundation (VCF). Diese Pakete richten sich an unterschiedliche Infrastruktur- und Betriebsanforderungen und umfassen jeweils definierte Produkt- und Funktionsbestandteile. Die Lizenzierung orientiert sich dabei unter anderem an den physischen Prozessorkernen der eingesetzten Hosts. Je nach Angebot und Vertragsbedingungen können Mindestlizenzierungen sowie weitere Voraussetzungen relevant sein.
Für Unternehmen bedeutet dies, dass sich die Kosten nicht allein aus der Anzahl der tatsächlich betriebenen virtuellen Maschinen ableiten lassen. Auch die Hardwareausstattung der Hosts, die benötigten Funktionen und die gewählte Produktkonfiguration beeinflussen die wirtschaftliche Betrachtung. Gerade bei kleineren Virtualisierungsumgebungen kann sich deshalb die Frage stellen, ob der Umfang eines angebotenen Produktpakets zu den tatsächlich genutzten Funktionen passt. In größeren Rechenzentren können dagegen integrierte Verwaltungs-, Automatisierungs- und Infrastrukturkomponenten einen erheblichen Mehrwert bieten.
Hinzu kommt ein weiterer Faktor: Unternehmen, die VMware seit vielen Jahren einsetzen, verfügen häufig bereits über geschulte Administrator:innen, dokumentierte Betriebsprozesse und etablierte Integrationen in ihre Datensicherungs- und Monitoringlösungen. Diese vorhandenen Investitionen sollten in einem Kostenvergleich berücksichtigt werden. Ein Wechsel zu einer anderen Plattform kann zwar laufende Lizenzkosten reduzieren, verursacht aber möglicherweise zunächst erhebliche Migrations- und Umstellungskosten. Deshalb sollte die Wirtschaftlichkeit einer VMware-Umgebung immer anhand des konkret angebotenen Produkt- und Vertragsmodells beurteilt werden.
Microsoft Hyper-V: Der Hypervisor ist nur ein Teil der Lizenzrechnung
Bei Microsoft Hyper-V gestaltet sich die wirtschaftliche Betrachtung anders. Die Virtualisierungsfunktion ist Bestandteil unterstützter Windows-Server-Editionen. Daraus folgt allerdings nicht, dass sich beliebig viele virtuelle Windows-Server-Instanzen ohne zusätzliche Lizenzanforderungen betreiben lassen. Entscheidend ist insbesondere die Unterscheidung zwischen Windows Server Standard und Datacenter. Beide Editionen werden grundsätzlich anhand der physischen Prozessorkerne eines Servers lizenziert, wobei entsprechende Mindestanforderungen gelten.
Die Unterschiede betreffen vor allem die Virtualisierungsrechte:
- Windows Server Standard: Bei vollständiger Lizenzierung aller erforderlichen physischen Kerne dürfen grundsätzlich bis zu zwei virtuelle Windows-Server-Standard-Instanzen betrieben werden. Für jeweils zwei weitere Instanzen müssen die erforderlichen Kernlizenzen erneut vollständig zugewiesen werden.
- Windows Server Datacenter: Bei vollständiger Lizenzierung der erforderlichen physischen Kerne dürfen unbegrenzt viele virtuelle Windows-Server-Instanzen der Editionen Standard und Datacenter auf dem lizenzierten Host betrieben werden.
Diese Rechte beziehen sich auf Windows-Server-Betriebssystemumgebungen, nicht auf die technisch mögliche Anzahl virtueller Maschinen. Linux-Gastsysteme benötigen beispielsweise keine Windows-Server-Gastbetriebssystemlizenz. Zusätzliche Serveranwendungen, Client Access Licenses und Verwaltungsprodukte wie System Center Virtual Machine Manager können dagegen weitere Kosten verursachen. Besondere Aufmerksamkeit erfordern Clusterumgebungen. Werden virtuelle Windows-Server-Instanzen zwischen Hosts verschoben oder nach einem Ausfall auf anderen Knoten gestartet, müssen auch dort die erforderlichen Nutzungsrechte vorhanden sein. Eine technisch mögliche Live-Migration stellt die korrekte Lizenzierung nicht automatisch sicher.
Neben der klassischen hostbasierten Kernlizenzierung existieren unter bestimmten Voraussetzungen weitere Lizenzierungsmodelle, etwa pro virtueller Maschine. Maßgeblich sind die jeweils gültigen Microsoft-Produktbestimmungen. Hyper-V kann gerade in Microsoft-geprägten IT-Landschaften wirtschaftlich attraktiv sein. Entscheidend bleiben jedoch die Anzahl und Edition der Windows-Gastsysteme, die Clusterarchitektur und die vorhandenen Lizenzverträge.
Proxmox VE: Open Source bedeutet nicht kostenfreien Betrieb
Proxmox Virtual Environment verfolgt ein anderes Lizenzmodell. Die Plattform basiert auf Open-Source-Technologien und kann grundsätzlich ohne verpflichtende Lizenzgebühr für die Nutzung des Hypervisors und der integrierten Verwaltungsfunktionen eingesetzt werden. Damit unterscheidet sich Proxmox VE deutlich von klassischen kommerziellen Virtualisierungsprodukten.
Allerdings wäre es falsch, daraus einen grundsätzlich kostenfreien Unternehmensbetrieb abzuleiten. Für professionelle Umgebungen bietet Proxmox kommerzielle Subskriptionen an, die unter anderem den Zugang zum Enterprise-Repository und – abhängig von der gewählten Stufe – definierte Supportleistungen umfassen. Die Subskriptionskosten orientieren sich bei Proxmox VE am jeweiligen physischen CPU-Sockel und dem gewählten Supportumfang. Auch hier müssen Unternehmen deshalb die tatsächliche Hardwarekonfiguration berücksichtigen.
Darüber hinaus entstehen selbstverständlich Kosten für Serverhardware, Netzwerkinfrastruktur, Speicherressourcen, Datensicherung und den laufenden Betrieb. Bei anspruchsvollen Installationen können außerdem externe Dienstleistungen, Schulungen oder zusätzliche Supportvereinbarungen erforderlich sein. Besonders bei Ceph-basierten Speicherarchitekturen sollten die Anforderungen an Hardware, Netzwerk und administratives Fachwissen nicht unterschätzt werden. Ein weiterer Aspekt betrifft die Lizenzierung der Gastbetriebssysteme. Wer virtuelle Windows-Server-Instanzen unter Proxmox VE betreibt, benötigt weiterhin die entsprechenden Microsoft-Nutzungsrechte. Der Wechsel des Hypervisors beseitigt diese Lizenzanforderungen nicht.
Damit kann Proxmox VE insbesondere dort wirtschaftlich interessant sein, wo eine flexible Virtualisierungsplattform benötigt wird und die erforderlichen Betriebs- und Supportkompetenzen bereits vorhanden sind. Ob sich daraus tatsächlich niedrigere Gesamtkosten ergeben, muss jedoch für die konkrete Infrastruktur ermittelt werden.
Die eigentliche Rechnung ist größer
Ein seriöser Wirtschaftlichkeitsvergleich sollte deshalb nicht beim Lizenzpreis enden. In der Praxis hat sich dafür die Betrachtung der Total Cost of Ownership (TCO) etabliert. Gemeint sind die gesamten Kosten, die während eines definierten Betrachtungszeitraums durch Anschaffung, Einführung, Betrieb und Weiterentwicklung einer Lösung entstehen.
Bei Virtualisierungsplattformen gehören dazu insbesondere:
- Software und Subskriptionen: Hypervisor-Lizenzen, Verwaltungsprodukte, Supportverträge und gegebenenfalls zusätzliche Infrastruktursoftware
- Hardware und Infrastruktur: Server, Prozessoren, Arbeitsspeicher, Netzwerktechnik, Storage sowie Energie- und Rechenzentrumskosten
- Migration und Einführung: Planung, Tests, Datenübertragung, Anpassung vorhandener Integrationen und gegebenenfalls externe Dienstleistungen
- Administration und Personal: Schulungen, Aufbau neuer Kompetenzen, Wartung, Fehleranalyse und laufende Betriebsaufgaben
- Datensicherung und Wiederherstellung: Backupsoftware, zusätzliche Speicherkapazitäten, geschützte Sicherungskopien und regelmäßige Wiederherstellungstests
- Betriebsrisiken: Mögliche Ausfallzeiten, Abhängigkeiten von einzelnen Herstellern und der Aufwand für die Behebung kritischer Störungen
Gerade der Personal- und Betriebsaufwand wird in solchen Vergleichen häufig unterschätzt. Eine Plattform mit niedrigen Lizenzkosten kann zusätzliche Aufwände verursachen, wenn vorhandene Administrator:innen zunächst geschult, Automatisierungen neu entwickelt oder bestehende Datensicherungsprozesse angepasst werden müssen. Umgekehrt kann eine kommerzielle Plattform trotz höherer Lizenzkosten wirtschaftlich sinnvoll sein, wenn sie gut in vorhandene Prozesse integriert ist und den laufenden Betriebsaufwand reduziert.
Dabei sollten wir jedoch zwischen einmaligen und wiederkehrenden Kosten unterscheiden. Die Migration zu einer neuen Plattform verursacht möglicherweise zunächst erhebliche Aufwände. Diese können sich über mehrere Jahre amortisieren, wenn anschließend niedrigere laufende Kosten entstehen.
Wirtschaftlichkeit über den Lebenszyklus betrachten
Für eine belastbare Entscheidung empfiehlt es sich deshalb, die Kosten über einen mehrjährigen Zeitraum zu vergleichen. Ein Betrachtungszeitraum von beispielsweise fünf oder sechs Jahren kann sinnvoll sein, weil er häufig einen wesentlichen Teil des vorgesehenen Hardwarelebenszyklus abbildet. Dabei sollten Unternehmen nicht nur die erwarteten Ausgaben erfassen, sondern auch unterschiedliche Szenarien berücksichtigen.
Was geschieht, wenn zusätzliche Virtualisierungshosts benötigt werden? Wie verändert sich die Rechnung, wenn die Anzahl virtueller Windows-Server-Instanzen steigt? Welche Kosten entstehen bei einer Erweiterung der Speicherinfrastruktur oder beim Wechsel auf eine neue Hardwaregeneration? Auch die langfristige Planbarkeit spielt eine Rolle. Abonnementmodelle schaffen regelmäßige Zahlungsverpflichtungen, während andere Lizenz- und Supportmodelle unterschiedliche Möglichkeiten zur Gestaltung der laufenden Kosten bieten.
Allerdings lassen sich künftige Preisentwicklungen nicht mit Sicherheit vorhersagen. Deshalb sollten Unternehmen ihre Kalkulationen mit nachvollziehbaren Annahmen und gegebenenfalls unterschiedlichen Kostenszenarien erstellen. Eine solche Betrachtung macht sichtbar, ob eine alternative Plattform lediglich kurzfristig günstiger erscheint oder tatsächlich über mehrere Jahre wirtschaftliche Vorteile bietet.
Der Plattformwechsel selbst ist ein Kostenfaktor
Ein weiterer Punkt darf bei dieser Rechnung nicht fehlen: die Migration. Virtuelle Maschinen lassen sich nicht in jedem Fall ohne Anpassungen von einem Hypervisor auf einen anderen übertragen. Neben den virtuellen Festplatten können beispielsweise Netzwerkkonfigurationen, virtuelle Hardware, Sicherheitsfunktionen und Integrationen in vorhandene Betriebsprozesse betroffen sein. Auch Backupsoftware, Monitoring, Automatisierungen und Dokumentationen müssen gegebenenfalls angepasst werden. Während dieser Umstellung können zusätzliche Testumgebungen, temporär parallel betriebene Plattformen und externe Unterstützungsleistungen erforderlich sein.
Gerade bei umfangreichen Bestandsinfrastrukturen können diese einmaligen Kosten erheblich sein. Deshalb wäre es wirtschaftlich wenig sinnvoll, eine bewährte Virtualisierungsumgebung ausschließlich aufgrund eines niedrigeren Lizenzpreises zu ersetzen, ohne die Kosten und Risiken des Wechsels zu berücksichtigen. Andererseits kann eine Migration langfristig durchaus erhebliche Einsparungen ermöglichen, wenn die neue Plattform die technischen Anforderungen erfüllt und sich mit vertretbarem Aufwand betreiben lässt. Nicht der niedrigste Lizenzpreis entscheidet über die Wirtschaftlichkeit, sondern die Gesamtkosten einer zuverlässig betriebenen Infrastruktur über ihren vorgesehenen Lebenszyklus.
Damit wird auch deutlich, weshalb die Entscheidung für eine Virtualisierungsplattform nicht allein eine technische oder kaufmännische Frage ist. Sie verbindet Architektur, Lizenzierung, vorhandene Kompetenzen und langfristige Betriebsstrategie. Und sobald ein Unternehmen ernsthaft über einen Plattformwechsel nachdenkt, stellt sich unmittelbar die nächste Herausforderung: Wie lassen sich bestehende virtuelle Maschinen und ihre Anwendungen tatsächlich auf eine neue Virtualisierungsumgebung übertragen?
Migration: Eine virtuelle Festplatte allein reicht nicht
Nehmen wir an, ein Unternehmen hat seine bestehende Virtualisierungsinfrastruktur bewertet und sich tatsächlich für einen Plattformwechsel entschieden. Die technischen Anforderungen sind definiert, die wirtschaftlichen Rahmenbedingungen geprüft und die neue Umgebung wurde bereits vorbereitet. Dann stellt sich eine zunächst einfach klingende Frage: Wie gelangen die vorhandenen virtuellen Maschinen auf die neue Plattform? Auf den ersten Blick scheint die Antwort überschaubar. Virtuelle Festplatten müssen übertragen und gegebenenfalls in ein anderes Format konvertiert werden. VMware verwendet beispielsweise VMDK-Dateien, Microsoft Hyper-V setzt auf VHDX und in Proxmox-Umgebungen können unter anderem RAW-Images oder QCOW2-Dateien zum Einsatz kommen.
Doch die Konvertierung einer virtuellen Festplatte ist lediglich ein Teil der Migration. Denn eine virtuelle Maschine besteht nicht nur aus ihren gespeicherten Daten. Sie besitzt eine definierte virtuelle Hardwarekonfiguration, ist in Netzwerke eingebunden und häufig eng mit den Verwaltungs- und Sicherheitsfunktionen ihrer bisherigen Plattform verbunden. Eine Hypervisormigration ist deshalb keine reine Datenübertragung, sondern die Überführung eines bestehenden Systems in eine andere technische und organisatorische Betriebsumgebung.
Virtuelle Hardware ist nicht überall identisch
Moderne Hypervisoren stellen ihren virtuellen Maschinen unterschiedliche Hardwarekomponenten zur Verfügung. Dazu gehören beispielsweise virtuelle Netzwerkkarten, Speichercontroller, Firmwareimplementierungen und weitere Geräte, die vom Gastbetriebssystem erkannt und verwendet werden. Beim Wechsel zwischen VMware vSphere, Microsoft Hyper-V und Proxmox VE können sich diese Komponenten verändern. Das Gastbetriebssystem benötigt deshalb möglicherweise andere Treiber oder muss seine Hardwarekonfiguration nach dem ersten Start neu erkennen.
Besondere Aufmerksamkeit verdienen dabei die virtuellen Speichercontroller. Fehlen die erforderlichen Treiber für den Zugriff auf das Systemlaufwerk, kann eine virtuelle Maschine nach der Migration unter Umständen nicht mehr starten. Auch die Netzwerkkonfiguration muss überprüft werden. Durch den Austausch virtueller Netzwerkkarten können sich Gerätezuordnungen verändern, sodass bisherige IP-Konfigurationen nicht automatisch auf die neue virtuelle Hardware übertragen werden. Hinzu kommen Unterschiede zwischen BIOS- und UEFI-basierten virtuellen Maschinen. Gerade bei älteren Systemen sollte deshalb frühzeitig geprüft werden, welche Firmware- und Hardwarekonfigurationen von der Zielplattform unterstützt werden.
Sicherheitsfunktionen können die Migration erschweren
Zusätzliche Anforderungen entstehen, wenn virtuelle Maschinen erweiterte Sicherheitsfunktionen verwenden. Dazu gehören beispielsweise Secure Boot, virtuelle Trusted Platform Modules (vTPM) und die Verschlüsselung virtueller Maschinen beziehungsweise ihrer Datenträger. Diese Funktionen sind häufig eng mit der jeweiligen Virtualisierungsplattform und ihrer Schlüsselverwaltung verbunden. Ein vorhandenes virtuelles TPM lässt sich deshalb nicht zwangsläufig unverändert auf eine andere Plattform übertragen. Gerade bei Betriebssystemen und Anwendungen, die Schlüsselmaterial im TPM schützen, müssen die Auswirkungen sorgfältig untersucht werden. Das betrifft beispielsweise BitLocker-geschützte Systemlaufwerke oder andere Verfahren, bei denen kryptografische Schlüssel an die bisherige virtuelle Hardware gebunden sind.
Vor einer Migration müssen deshalb geeignete Wiederherstellungsschlüssel verfügbar sein und die erforderlichen Sicherheitsmaßnahmen geplant werden. Auch spezielle Gerätezuordnungen, etwa durch PCI-Passthrough oder GPU-Virtualisierung, können einen Plattformwechsel erheblich erschweren. Hier genügt es nicht, dass die Zielplattform grundsätzlich eine vergleichbare Funktion anbietet. Entscheidend ist, ob die konkrete Hardware- und Treiberkombination unterstützt wird.
Nicht jede virtuelle Maschine ist gleich einfach zu migrieren
Besonders wichtig ist die Unterscheidung zwischen einer technisch möglichen und einer offiziell unterstützten Konfiguration. Eine virtuelle Maschine kann auf der neuen Plattform möglicherweise problemlos starten, ohne dass damit automatisch die vollständige Unterstützung durch den Hersteller des Gastbetriebssystems oder der darauf betriebenen Anwendung gewährleistet ist. Gerade bei geschäftskritischen Systemen sollten deshalb die jeweiligen Supportfreigaben und Lizenzbedingungen geprüft werden. Das betrifft beispielsweise Datenbankserver, spezialisierte Unternehmensanwendungen oder Systeme mit besonderen Anforderungen an Hardware und Virtualisierung.
Auch ältere Betriebssysteme können problematisch sein, wenn erforderliche Treiber fehlen oder die neue Plattform bestimmte virtuelle Hardwarekomponenten nicht mehr bereitstellt. In solchen Fällen kann es wirtschaftlich und technisch sinnvoller sein, eine Anwendung neu bereitzustellen und ihre Daten zu übernehmen, anstatt die bestehende virtuelle Maschine unverändert zu migrieren. Damit wird deutlich, dass eine Virtualisierungsmigration nicht zwangsläufig für sämtliche Systeme nach demselben Verfahren durchgeführt werden sollte.
Die Migration betrifft auch die Betriebsprozesse
Selbst wenn eine virtuelle Maschine technisch erfolgreich übertragen wurde, ist die Migration noch nicht abgeschlossen. Die neue Umgebung muss auch die bisher erforderlichen Betriebsfunktionen zuverlässig bereitstellen. Dazu gehören insbesondere die Integration in Monitoring und Datensicherung, die Vergabe administrativer Berechtigungen sowie die Einbindung in vorhandene Automatisierungsprozesse.
Auch Hochverfügbarkeitskonzepte müssen auf der Zielplattform neu bewertet und gegebenenfalls anders umgesetzt werden. Ein bisheriger VMware-Cluster lässt sich beispielsweise nicht allein dadurch ersetzen, dass seine virtuellen Maschinen auf mehrere Hyper-V- oder Proxmox-Hosts verteilt werden. Erst wenn Clusterkommunikation, Speicherzugriff, Netzwerkkonfiguration und Wiederherstellungsverfahren entsprechend eingerichtet sind, entsteht eine vergleichbare Betriebsumgebung.
Hinzu kommen gegebenenfalls Änderungen an Dokumentation, Inventarisierung und bestehenden Wartungsprozessen. Gerade in größeren Infrastrukturen können diese organisatorischen Aufgaben einen erheblichen Teil des gesamten Migrationsaufwands ausmachen.
Eine erfolgreiche Migration benötigt einen kontrollierten Ablauf
Ein Plattformwechsel sollte deshalb nicht als einmaliger Kopiervorgang geplant werden. Sinnvoller ist ein schrittweises Vorgehen, bei dem zunächst die vorhandenen Systeme und ihre Abhängigkeiten erfasst werden. Anschließend lassen sich geeignete Migrationsverfahren auswählen und zunächst mit weniger kritischen virtuellen Maschinen erproben.
Dabei sollten Unternehmen insbesondere folgende Phasen berücksichtigen:
- Bestandsaufnahme: Virtuelle Maschinen, Betriebssysteme, Anwendungen, Abhängigkeiten und besondere Hardwareanforderungen erfassen
- Kompatibilitätsprüfung: Unterstützte Konfigurationen, Lizenzbedingungen und erforderliche Anpassungen der virtuellen Hardware untersuchen
- Testmigration: Ausgewählte Systeme in einer geeigneten Testumgebung übertragen und ihre Funktionsfähigkeit überprüfen
- Produktive Umstellung: Datenübertragung, gegebenenfalls erforderliche Synchronisation und den eigentlichen Wechsel innerhalb eines definierten Wartungsfensters durchführen
- Abnahme und Rückfallplanung: Anwendungen, Leistung, Datensicherung und Betriebsprozesse prüfen sowie einen geeigneten Rückweg für den Fehlerfall vorsehen
Besonders wichtig ist dabei die Frage, wie mit Änderungen umgegangen wird, die während der Migration auf dem bisherigen System entstehen. Je nach Anwendung und eingesetztem Verfahren kann eine abschließende Datensynchronisation oder eine geplante Betriebsunterbrechung erforderlich sein. Auch die Rückfallplanung darf nicht erst dann beginnen, wenn die Migration bereits fehlgeschlagen ist. Unternehmen sollten vorab festlegen, unter welchen Bedingungen ein Wechsel abgebrochen wird und wie sich der vorherige Betriebszustand wiederherstellen lässt.
Erst die Anwendung entscheidet über den Erfolg
Eine Migration sollte nicht bereits dann als erfolgreich gelten, wenn das Gastbetriebssystem auf der neuen Plattform gestartet wurde. Entscheidend ist vielmehr, ob die darauf betriebenen Anwendungen zuverlässig funktionieren und die vereinbarten Anforderungen weiterhin erfüllen. Dazu gehört die Überprüfung von Netzwerkverbindungen, Authentifizierung, Datenbankzugriffen und gegebenenfalls vorhandenen Schnittstellen zu anderen Systemen. Auch die Leistungsfähigkeit muss betrachtet werden. Unterschiedliche virtuelle Hardwarekomponenten, Speicherarchitekturen und Netzwerkkonfigurationen können das Verhalten einer Anwendung beeinflussen. Nicht zuletzt müssen Datensicherungen erneut eingerichtet und ihre Wiederherstellbarkeit überprüft werden.
Gerade bei geschäftskritischen Systemen empfiehlt es sich deshalb, technische Funktionstests mit einer fachlichen Abnahme durch die verantwortlichen Anwendungsteams zu verbinden. Die eigentliche Herausforderung einer Hypervisormigration liegt selten nur im Verschieben virtueller Maschinen. Entscheidend ist die zuverlässige Übertragung einer vollständigen Betriebsumgebung – einschließlich ihrer Anwendungen, Sicherheitsfunktionen und organisatorischen Prozesse.
Damit schließt sich der Kreis zu unseren bisherigen Betrachtungen: Administration, Hochverfügbarkeit, Storage, Backup, Automatisierung und Lizenzierung lassen sich bei einem Plattformwechsel nicht unabhängig voneinander bewerten. Erst wenn diese Anforderungen gemeinsam betrachtet werden, lässt sich beurteilen, welche Virtualisierungsplattform tatsächlich zum jeweiligen Unternehmen passt.
Welche Plattform passt zu welchem Unternehmen?
Nach all diesen Überlegungen wäre es verlockend, VMware vSphere, Microsoft Hyper-V und Proxmox VE anhand einzelner Kriterien zu bewerten und daraus einen eindeutigen Gewinner abzuleiten. Doch so einfach ist die Entscheidung nicht. Alle drei Plattformen können eine geeignete Grundlage für professionelle Virtualisierungsumgebungen darstellen. Sie unterscheiden sich jedoch in ihren Ökosystemen, Verwaltungsmodellen, Lizenzierungsansätzen und den Anforderungen an den laufenden Betrieb. Welche Plattform am besten passt, hängt deshalb weniger von einer möglichst langen Funktionsliste ab als von den konkreten Anforderungen und den bereits vorhandenen Kompetenzen.
Drei Plattformen, unterschiedliche Ausgangssituationen
VMware vSphere kann insbesondere dort sinnvoll sein, wo bereits eine umfangreiche VMware-Infrastruktur betrieben wird. Etablierte Verwaltungsprozesse, vorhandene Automatisierungen, integrierte Datensicherungslösungen und geschulte Administrator:innen stellen einen erheblichen Wert dar. Ein Plattformwechsel muss in solchen Umgebungen nicht nur technisch möglich, sondern auch wirtschaftlich und organisatorisch begründbar sein. Gleichzeitig sollten Unternehmen ihre bisherigen Entscheidungen regelmäßig überprüfen und nicht allein deshalb an VMware festhalten, weil die Plattform seit vielen Jahren eingesetzt wird.
Microsoft Hyper-V ist besonders für Organisationen interessant, deren Infrastruktur bereits stark auf Windows Server, Active Directory, PowerShell und weitere Microsoft-Technologien ausgerichtet ist. Vorhandene Kompetenzen und Werkzeuge können die Integration erleichtern. Gerade bei einer hohen Anzahl virtueller Windows-Server-Instanzen lohnt sich zudem eine sorgfältige Betrachtung der Lizenzierung von Windows Server Standard und Datacenter. Allerdings ist Hyper-V keineswegs auf Windows-Gastbetriebssysteme beschränkt. Auch Linux-Systeme lassen sich betreiben. Entscheidend bleibt, ob die ergänzenden Verwaltungs-, Cluster- und Speichertechnologien zu den jeweiligen Anforderungen passen.
Proxmox VE bietet sich als Alternative an, wenn offene Technologien, eine integrierte Verwaltungsumgebung und ein flexibel gestaltbares Betriebsmodell im Vordergrund stehen. Gerade Unternehmen mit vorhandenen Linux-Kompetenzen können von der Kombination aus KVM, LXC und den unterstützten Speichertechnologien profitieren. Auch größere und anspruchsvollere Infrastrukturen sind möglich, sofern Architektur, Support und Betrieb entsprechend geplant werden. Dabei sollte die Entscheidung nicht allein auf den vergleichsweise niedrigen Einstiegskosten beruhen. Insbesondere bei komplexen Cluster- und Storage-Architekturen sind geeignete Fachkenntnisse und verlässliche Betriebsprozesse unverzichtbar.
Die Unterschiede im Überblick
Die folgende Gegenüberstellung fasst die wesentlichen Merkmale zusammen, die wir im Verlauf dieses Kapitels betrachtet haben.
|
Kriterium |
VMware vSphere |
Microsoft Hyper-V |
Proxmox VE |
|
Grundlegender Ansatz |
Kommerzielles Virtualisierungsökosystem |
Virtualisierung innerhalb der Microsoft-Infrastruktur |
Integrierte Open-Source-Plattform |
|
Zentrale Verwaltung |
vCenter Server |
Windows Admin Center, Failover Cluster Manager und gegebenenfalls SCVMM |
Integrierte Weboberfläche |
|
Hochverfügbarkeit |
vSphere HA |
Windows Failover Clustering |
Integrierter HA-Manager |
|
Speicherarchitekturen |
SAN, NAS und vSAN |
SAN, SMB, CSV und geeignete S2D-Architekturen |
Lokaler Storage, ZFS, NFS, iSCSI und Ceph |
|
Datensicherung |
Umfangreiches Drittanbieterökosystem |
Windows-basierte Schnittstellen und Drittanbieterprodukte |
Proxmox Backup Server und weitere Lösungen |
|
Automatisierung |
PowerCLI, APIs und IaC-Integrationen |
PowerShell und ergänzende Managementwerkzeuge |
REST-API, CLI und IaC-Integrationen |
|
Lizenzmodell |
Kommerzielle Subskriptionen und Produktpakete |
Windows-Server-Lizenzierung und gegebenenfalls Zusatzprodukte |
Open Source mit optionalen kommerziellen Subskriptionen |
|
Besondere Stärke |
Etablierte Integrationen und Betriebsprozesse |
Einbindung in bestehende Microsoft-Umgebungen |
Offene Technologien und integrierte Verwaltung |
Die Tabelle zeigt bewusst keine Bewertung mit Punkten oder Sternen. Denn eine Funktion, die für ein Unternehmen unverzichtbar ist, kann für ein anderes praktisch bedeutungslos sein. Auch die vorhandenen Kompetenzen verändern die Bewertung erheblich. Eine IT-Abteilung mit umfangreicher PowerShell-Erfahrung wird andere Voraussetzungen mitbringen als ein Team, das seit Jahren VMware PowerCLI einsetzt oder Linux-basierte Infrastrukturen administriert.
Hinzu kommen Anforderungen, die sich nicht sinnvoll in einer allgemeinen Vergleichstabelle abbilden lassen: besondere Anwendungssysteme, verbindliche Supportzusagen, regulatorische Vorgaben oder bereits vorhandene Hardware. Die passende Virtualisierungsplattform ergibt sich deshalb nicht aus einer allgemeinen Rangliste, sondern aus dem Abgleich zwischen technischen Anforderungen, vorhandenen Kompetenzen und wirtschaftlichen Rahmenbedingungen.
Die Plattform ist eine Entscheidung – der Betrieb eine dauerhafte Aufgabe
Damit gelangen wir zu einer Erkenntnis, die sich durch unseren gesamten Beitrag zieht. Virtualisierung bedeutet längst nicht mehr nur, mehrere Betriebssysteme auf einem physischen Server auszuführen. Eine moderne Virtualisierungsinfrastruktur entsteht aus dem Zusammenspiel von Rechenleistung, Speicher, Netzwerk, Sicherheitsmechanismen, Verwaltung, Datensicherung und Automatisierung. Der Hypervisor bildet dafür eine wesentliche technische Grundlage. Er ist jedoch nur eine von mehreren Komponenten, die über die Leistungsfähigkeit und Zuverlässigkeit der gesamten Umgebung entscheiden.
Für Administrator:innen und IT-Verantwortliche bedeutet dies, dass eine Plattformentscheidung nicht allein anhand einzelner Funktionen oder Lizenzpreise getroffen werden sollte. Mindestens ebenso wichtig ist die Frage, wie sich die Infrastruktur über ihren vorgesehenen Lebenszyklus hinweg betreiben lässt. Können vorhandene Kompetenzen weiterverwendet werden? Lassen sich neue Systeme standardisiert bereitstellen? Sind Hochverfügbarkeit und Wiederherstellung ausreichend abgesichert? Und bleibt die Architektur auch dann beherrschbar, wenn sich technische Anforderungen oder wirtschaftliche Rahmenbedingungen verändern? Dabei gibt es keine Entscheidung, die für alle Unternehmen gleichermaßen richtig sein kann.
Eine bewährte VMware-Infrastruktur muss nicht zwangsläufig ersetzt werden. Eine Microsoft-geprägte IT-Landschaft kann gute Voraussetzungen für Hyper-V bieten. Und Proxmox VE kann eine leistungsfähige Alternative darstellen, wenn die erforderlichen Kompetenzen und Betriebsprozesse vorhanden sind. Entscheidend ist, diese Möglichkeiten ohne vorschnelle Festlegung zu prüfen. Die beste Virtualisierungsplattform ist nicht diejenige, die auf dem Papier die meisten Funktionen bietet. Es ist diejenige, die zu den technischen Anforderungen, den vorhandenen Kompetenzen und den langfristigen Zielen eines Unternehmens passt.
Doch selbst diese Entscheidung beschreibt inzwischen nur einen Teil der Entwicklung. Denn während Unternehmen ihre lokalen Virtualisierungsplattformen neu bewerten, verändern Cloud-Dienste, Containerplattformen und hybride Infrastrukturmodelle längst die Anforderungen an den Betrieb virtueller Ressourcen. Die Frage lautet deshalb zunehmend nicht mehr nur, welchen Hypervisor ein Unternehmen einsetzen sollte, sondern wie lokale Virtualisierung, Cloud-Ressourcen und moderne Anwendungsplattformen künftig sinnvoll zusammenarbeiten können.
Die Zukunft der Virtualisierung ist hybrid
Lange Zeit war die Frage nach der richtigen Virtualisierungsplattform vergleichsweise einfach gestellt: Welcher Hypervisor soll auf den physischen Servern im eigenen Rechenzentrum eingesetzt werden? Heute greift diese Frage zu kurz. Unternehmen betreiben ihre Anwendungen längst nicht mehr ausschließlich auf lokalen Servern. Virtuelle Maschinen laufen in eigenen Rechenzentren, bei Hostinganbietern oder in Public-Cloud-Umgebungen. Gleichzeitig gewinnen Containerplattformen, automatisierte Bereitstellungsverfahren und spezialisierte Infrastrukturen für künstliche Intelligenz an Bedeutung.
Die Grenzen zwischen diesen Betriebsmodellen werden zunehmend durchlässiger. Eine Anwendung kann lokal betrieben werden, während ihre Daten über Cloud-Dienste gesichert werden. Andere Systeme nutzen Cloud-Ressourcen für zusätzliche Rechenkapazität oder greifen auf zentral bereitgestellte Identitäts- und Sicherheitsdienste zurück. Damit verändert sich auch die Rolle der Virtualisierung. Sie ist nicht länger nur ein Verfahren zur besseren Auslastung physischer Server. Sie bildet vielmehr eine technische Grundlage für Infrastrukturen, die unterschiedliche Standorte, Plattformen und Betriebsmodelle miteinander verbinden. Die Zukunft der Virtualisierung entscheidet sich deshalb nicht allein zwischen VMware, Hyper-V und Proxmox VE. Sie liegt zunehmend in der Frage, wie unterschiedliche Infrastrukturwelten sicher, automatisiert und wirtschaftlich zusammenarbeiten können.
Hybrid bedeutet mehr als lokale Server und Public Cloud
Der Begriff Hybrid Cloud wird häufig verwendet, wenn Unternehmen sowohl eigene Rechenzentren als auch Public-Cloud-Dienste nutzen. Doch allein die parallele Existenz beider Umgebungen schafft noch keine durchgängige hybride Infrastruktur. Erst wenn Identitäten, Sicherheitsrichtlinien, Verwaltungsprozesse und gegebenenfalls Anwendungen über diese Grenzen hinweg sinnvoll integriert werden, entsteht ein zusammenhängendes Betriebsmodell.
Für Administrator:innen ergeben sich daraus neue Anforderungen. Sie müssen nicht nur virtuelle Maschinen verwalten, sondern zunehmend unterschiedliche Plattformen, Schnittstellen und Verantwortlichkeiten berücksichtigen. Dabei stellt sich beispielsweise die Frage, welche Systeme lokal verbleiben sollen, welche von Cloud-Diensten profitieren und wie sich beide Umgebungen mit möglichst einheitlichen Betriebsprozessen verwalten lassen.
Die Gründe für eine hybride Architektur können sehr unterschiedlich sein. Technische Abhängigkeiten, Anforderungen an Datenhaltung und Latenz, regulatorische Vorgaben oder wirtschaftliche Überlegungen beeinflussen die Entscheidung. Nicht jede Anwendung muss deshalb in die Cloud migriert werden. Ebenso wenig muss jede bislang lokal betriebene Infrastruktur dauerhaft im eigenen Rechenzentrum verbleiben. Entscheidend ist, für jede Anwendung ein geeignetes Betriebsmodell zu finden, ohne die gesamte IT-Infrastruktur unnötig zu fragmentieren.
Hybride Verwaltung: Wenn die Plattformgrenzen verschwimmen
Eine hybride Infrastruktur bringt zunächst eine zusätzliche Herausforderung mit sich: Unterschiedliche Plattformen besitzen häufig eigene Verwaltungswerkzeuge, Sicherheitsmodelle und Automatisierungsschnittstellen. Während virtuelle Maschinen im lokalen Rechenzentrum beispielsweise über VMware vCenter, Windows Admin Center oder die Proxmox-Weboberfläche verwaltet werden, kommen in der Public Cloud weitere Dienste und Verwaltungsportale hinzu.
Für Administrator:innen entsteht dadurch schnell eine fragmentierte Betriebsumgebung. Inventarisierung, Richtlinienverwaltung, Überwachung und Sicherheitskontrollen müssen über mehrere Systeme hinweg organisiert werden. Dabei besteht die Gefahr, dass für jede Plattform eigene Prozesse entstehen, obwohl die zugrunde liegenden Anforderungen weitgehend identisch sind. Die entscheidende Frage lautet deshalb nicht mehr ausschließlich, wie sich eine einzelne Virtualisierungsplattform verwalten lässt. Vielmehr geht es darum, wie Unternehmen über unterschiedliche Infrastrukturgrenzen hinweg einheitliche Betriebs- und Sicherheitsstandards etablieren können.
Azure Arc: Verwaltung über Infrastrukturgrenzen hinweg
Microsoft verfolgt mit Azure Arc einen Ansatz, bei dem ausgewählte lokale und außerhalb von Azure betriebene Ressourcen in die Azure-Verwaltung eingebunden werden können. Dazu gehören beispielsweise unterstützte Windows- und Linux-Server, unabhängig davon, ob sie auf physischen Systemen, virtuellen Maschinen oder bei anderen Cloud-Anbietern betrieben werden. Über Azure Arc können solche Systeme als verwaltbare Ressourcen in Azure sichtbar gemacht und in unterstützte Verwaltungs- und Governance-Prozesse integriert werden. Dazu zählen unter anderem die Nutzung von Azure Policy, bestimmte Überwachungs- und Sicherheitsfunktionen sowie die Einbindung in automatisierte Betriebsabläufe.
Der wesentliche Gedanke besteht darin, Verwaltungsfunktionen bereitzustellen, ohne dass sämtliche Workloads zwangsläufig in Azure ausgeführt werden müssen. Allerdings sollten wir hier eine wichtige Unterscheidung treffen. Azure Arc ersetzt weder den lokalen Hypervisor noch dessen Verwaltungsplattform. Die Bereitstellung virtueller Hardware, Live-Migrationen oder lokale Clusterfunktionen verbleiben grundsätzlich in der Verantwortung der jeweiligen Virtualisierungsumgebung. Azure Arc ergänzt diese Funktionen vielmehr um eine übergreifende Verwaltungsebene für unterstützte Ressourcen.
Azure Local: Virtualisierung als Teil einer hybriden Plattform
Einen anderen Ansatz verfolgt Microsoft mit Azure Local, der Weiterentwicklung von Azure Stack HCI. Hier steht nicht nur die Einbindung vorhandener Server in zentrale Verwaltungsprozesse im Vordergrund. Azure Local stellt vielmehr eine eigenständige, Azure-integrierte Infrastrukturplattform für den lokalen Betrieb bereit. Sie kombiniert Virtualisierung, softwaredefinierte Infrastrukturkomponenten und hybride Verwaltungsfunktionen auf entsprechend unterstützter Hardware. Damit unterscheidet sich Azure Local von einer klassischen Windows-Server-Installation mit aktivierter Hyper-V-Rolle.
Auch wenn beide Technologien auf verwandten Virtualisierungskomponenten aufbauen, unterscheiden sich Produktmodell, Bereitstellungsvoraussetzungen, Lizenzierung und Betriebsintegration. Für Unternehmen kann Azure Local insbesondere dann interessant sein, wenn Anwendungen aus technischen oder regulatorischen Gründen lokal ausgeführt werden sollen, gleichzeitig aber eine enge Integration in ausgewählte Azure-Dienste gewünscht ist. Die Entscheidung für eine solche Architektur ist allerdings zugleich eine Entscheidung für bestimmte Plattformabhängigkeiten und Betriebsmodelle.
Einheitliche Verwaltung bedeutet nicht automatisch Plattformunabhängigkeit
So attraktiv zentrale Verwaltungsansätze erscheinen, sie beseitigen nicht sämtliche Unterschiede zwischen den zugrunde liegenden Plattformen. Eine virtuelle Maschine auf VMware ESXi verwendet weiterhin andere virtuelle Hardwarekomponenten und Verwaltungsmechanismen als eine virtuelle Maschine unter Hyper-V oder KVM. Auch Speicherarchitekturen, Hochverfügbarkeitsfunktionen und Migrationsverfahren bleiben zunächst plattformspezifisch.
Eine übergreifende Verwaltungsoberfläche kann diese Unterschiede teilweise abstrahieren. Sie macht die darunterliegenden Technologien jedoch nicht automatisch austauschbar. Hinzu kommt, dass die Verfügbarkeit einzelner Verwaltungsfunktionen von unterstützten Betriebssystemen, installierten Agenten, Netzwerkverbindungen und gegebenenfalls zusätzlichen Lizenzierungen abhängen kann. Gerade bei hybriden Architekturen müssen deshalb auch die Abhängigkeiten von externen Diensten betrachtet werden.
Was geschieht beispielsweise, wenn die Verbindung zur zentralen Verwaltungsplattform vorübergehend ausfällt? Welche lokalen Betriebsfunktionen bleiben verfügbar? Und welche Verwaltungs- oder Sicherheitsprozesse benötigen eine funktionierende Cloud-Anbindung? Diese Fragen sollten bereits bei der Architekturplanung beantwortet werden.
Hybride Verwaltung beginnt bei gemeinsamen Standards
Eine dauerhaft beherrschbare hybride Infrastruktur entsteht nicht allein durch die Einführung eines zusätzlichen Verwaltungsprodukts. Wichtiger ist die Definition gemeinsamer Betriebsstandards. Dazu gehören nachvollziehbare Namenskonventionen, konsistente Identitäts- und Berechtigungskonzepte, einheitliche Sicherheitsanforderungen sowie dokumentierte Prozesse für Bereitstellung, Überwachung und Wiederherstellung. Die eingesetzten Werkzeuge müssen diese Standards anschließend möglichst zuverlässig umsetzen.
Dabei kann es sinnvoll sein, bestimmte Verwaltungsaufgaben zentral zu organisieren, während andere weiterhin innerhalb der jeweiligen Plattform ausgeführt werden. Hybride Verwaltung bedeutet deshalb nicht, alle Unterschiede zwischen Virtualisierungsplattformen zu beseitigen. Sie bedeutet, trotz dieser Unterschiede einen konsistenten und kontrollierbaren IT-Betrieb sicherzustellen.
Damit verändert sich auch die Rolle der Automatisierung. Wenn Infrastrukturressourcen über mehrere Plattformen verteilt sind, reicht es langfristig nicht aus, wiederkehrende Aufgaben lediglich innerhalb einzelner Verwaltungsumgebungen zu automatisieren. Die Herausforderung besteht vielmehr darin, Infrastruktur möglichst standardisiert, nachvollziehbar und reproduzierbar bereitzustellen – unabhängig davon, ob die benötigten Ressourcen lokal oder in der Cloud betrieben werden.
Infrastructure as Code: Infrastruktur wird reproduzierbar
Wer eine virtuelle Maschine benötigt, öffnet eine Verwaltungsoberfläche, wählt Prozessoren, Arbeitsspeicher und Speicherplatz aus, konfiguriert die Netzwerkanbindung und startet anschließend die Bereitstellung. So oder ähnlich wurden virtuelle Maschinen über viele Jahre eingerichtet. Auch heute ist dieses Vorgehen technisch möglich. In größeren und insbesondere hybriden Infrastrukturen stößt die manuelle Bereitstellung jedoch schnell an organisatorische Grenzen. Denn jede manuelle Konfiguration birgt das Risiko von Abweichungen. Unterschiedliche Administrator:innen verwenden möglicherweise andere Einstellungen, Sicherheitsrichtlinien werden nicht einheitlich umgesetzt und die spätere Nachvollziehbarkeit hängt häufig von der Qualität der Dokumentation ab.
Hier setzt Infrastructure as Code (IaC) an. Anstatt Infrastruktur ausschließlich über grafische Verwaltungsoberflächen zu konfigurieren, werden ihre gewünschten Eigenschaften in maschinenlesbaren Konfigurationsdateien beschrieben. Darin kann beispielsweise festgelegt werden, welche virtuellen Maschinen benötigt werden, welche Ressourcen ihnen zur Verfügung stehen und wie sie mit Netzwerken oder Speicherressourcen verbunden werden sollen. Die eigentliche Bereitstellung erfolgt anschließend automatisiert über die Schnittstellen der jeweiligen Infrastrukturplattform. Damit verändert sich die Arbeitsweise grundlegend. Infrastruktur wird nicht mehr ausschließlich manuell eingerichtet, sondern als definierter und wiederholbarer Zustand beschrieben.
Terraform und OpenTofu: Infrastruktur deklarativ beschreiben
Zu den bekanntesten Werkzeugen für Infrastructure as Code gehören Terraform und OpenTofu. Beide verwenden die HashiCorp Configuration Language (HCL), um Infrastrukturressourcen deklarativ zu beschreiben. Deklarativ bedeutet, dass Administrator:innen in erster Linie den gewünschten Zielzustand definieren. Das Werkzeug ermittelt anschließend anhand seiner Konfiguration, des gespeicherten Zustands und der Informationen der jeweiligen Plattform, welche Änderungen erforderlich sind. Dabei kommen sogenannte Provider zum Einsatz. Sie stellen die Verbindung zu den APIs unterstützter Infrastrukturplattformen her.
Auf diese Weise können beispielsweise virtuelle Maschinen, Netzwerke und weitere Ressourcen automatisiert bereitgestellt werden. Allerdings ist die Unterstützung nicht auf allen Virtualisierungsplattformen identisch. Welche Funktionen verfügbar sind und wie zuverlässig sich Änderungen durchführen lassen, hängt wesentlich vom jeweiligen Provider und dessen Entwicklungsstand ab. Gerade bei VMware, Hyper-V und Proxmox VE sollten deshalb die konkret benötigten Ressourcen und Integrationen geprüft werden. Die Verwendung derselben IaC-Sprache bedeutet schließlich nicht, dass sich eine virtuelle Maschine ohne Anpassungen zwischen unterschiedlichen Hypervisoren verschieben lässt.
Ansible: Wenn die virtuelle Maschine bereits existiert
Infrastructure as Code endet nicht zwangsläufig mit der Bereitstellung virtueller Hardware. Eine neu erstellte virtuelle Maschine benötigt häufig zunächst ein Betriebssystem, zusätzliche Software, Sicherheitskonfigurationen und die Einbindung in vorhandene Verwaltungsprozesse. Hier kommen Werkzeuge für die automatisierte Systemkonfiguration ins Spiel. Ein verbreitetes Beispiel ist Ansible. Damit lassen sich wiederkehrende Konfigurationsaufgaben beschreiben und auf unterstützten Zielsystemen ausführen.
Während Terraform oder OpenTofu häufig die Bereitstellung von Infrastrukturressourcen übernehmen, kann Ansible anschließend beispielsweise Software installieren, Dienste konfigurieren oder definierte Systemeinstellungen umsetzen. Diese Aufgabenverteilung ist allerdings keine starre technische Grenze. Die Werkzeuge besitzen teilweise überlappende Funktionen und können je nach Architektur unterschiedlich kombiniert werden. Entscheidend ist, dass Bereitstellung und Konfiguration möglichst konsistent ineinandergreifen. Aus einer zunächst leeren virtuellen Maschine wird dadurch ein nach definierten Vorgaben eingerichtetes System.
Git und Versionskontrolle: Änderungen werden nachvollziehbar
Ein wesentlicher Vorteil von Infrastructure as Code entsteht durch die Möglichkeit, Konfigurationsdateien in einer Versionsverwaltung wie Git abzulegen. Änderungen an der Infrastruktur lassen sich dadurch ähnlich behandeln wie Änderungen am Quellcode einer Anwendung. Neue Konfigurationen können überprüft, dokumentiert und vor ihrer produktiven Umsetzung getestet werden. Auch frühere Versionsstände bleiben nachvollziehbar.
Das bedeutet allerdings nicht, dass jede Infrastrukturänderung automatisch gefahrlos rückgängig gemacht werden kann. Insbesondere Änderungen an persistenten Daten, Speicherressourcen oder bestehenden Netzwerkkonfigurationen können Auswirkungen haben, die über die Wiederherstellung einer früheren Konfigurationsdatei hinausgehen. Versionskontrolle verbessert deshalb vor allem die Nachvollziehbarkeit und Steuerung von Änderungen. Sie ersetzt keine Datensicherung und keine geeignete Rückfallplanung. In Verbindung mit automatisierten Prüf- und Freigabeprozessen kann daraus ein Betriebsmodell entstehen, bei dem Infrastrukturänderungen kontrolliert über definierte Abläufe umgesetzt werden. Dieser Ansatz wird häufig als GitOps bezeichnet, wenn ein Git-Repository als maßgebliche Quelle des gewünschten Zustands dient und entsprechende Automatisierungsmechanismen dessen Umsetzung beziehungsweise Abgleich übernehmen.
Hybride Infrastruktur benötigt gemeinsame Prozesse
Besonders interessant wird Infrastructure as Code, wenn Unternehmen mehrere Infrastrukturplattformen parallel betreiben. Eine Organisation kann beispielsweise lokale virtuelle Maschinen auf VMware oder Proxmox VE bereitstellen und gleichzeitig zusätzliche Ressourcen in Microsoft Azure verwenden. Anstatt für jede Umgebung ausschließlich eigene manuelle Prozesse zu etablieren, lassen sich Teile der Bereitstellung über gemeinsame Automatisierungswerkzeuge organisieren. Dabei bleiben die technischen Unterschiede der Plattformen bestehen. Eine virtuelle Netzwerkkarte unter Hyper-V ist nicht identisch mit einer Netzwerkschnittstelle einer Azure-VM. Auch Speicher-, Sicherheits- und Hochverfügbarkeitsfunktionen unterscheiden sich.
Infrastructure as Code beseitigt diese Unterschiede nicht. Es ermöglicht jedoch, sie innerhalb definierter Bereitstellungsprozesse kontrolliert zu berücksichtigen. Dafür benötigen Unternehmen geeignete Standards, beispielsweise für Namenskonventionen, Ressourcenzuweisungen, Berechtigungen und Sicherheitskonfigurationen. Ebenso wichtig sind der Schutz von Zugangsdaten, die sichere Verwaltung von IaC-Zustandsdateien und der kontrollierte Umgang mit Änderungen außerhalb der automatisierten Prozesse. Denn wenn Administrator:innen Ressourcen nachträglich manuell verändern, kann eine Abweichung zwischen dem dokumentierten Zielzustand und der tatsächlich vorhandenen Infrastruktur entstehen. Diese sogenannte Configuration Drift muss erkannt und bewusst behandelt werden.
Reproduzierbarkeit statt manueller Einzelfälle
Der eigentliche Mehrwert von Infrastructure as Code liegt deshalb nicht darin, möglichst viele Administrationsaufgaben durch Skripte zu ersetzen. Vielmehr entsteht die Möglichkeit, Infrastruktur nach einheitlichen Vorgaben bereitzustellen, Änderungen nachvollziehbar zu gestalten und wiederkehrende Abläufe über unterschiedliche Plattformen hinweg zu standardisieren. Für Administrator:innen verändert sich dadurch auch der Schwerpunkt ihrer Tätigkeit. Statt einzelne virtuelle Maschinen immer wieder manuell einzurichten, entwickeln und pflegen sie zunehmend Vorlagen, Konfigurationen und automatisierte Bereitstellungsprozesse. Die Zukunft der Infrastrukturverwaltung liegt damit nicht allein in der Automatisierung einzelner Aufgaben, sondern in der reproduzierbaren und kontrollierten Bereitstellung vollständiger Betriebsumgebungen.
Allerdings betrifft diese Entwicklung zunächst vor allem die Art und Weise, wie Infrastruktur verwaltet wird. Parallel dazu verändert sich auch, was auf dieser Infrastruktur betrieben wird. Denn während virtuelle Maschinen weiterhin eine wichtige Grundlage darstellen, werden moderne Anwendungen zunehmend in Containern bereitgestellt und über Plattformen wie Kubernetes orchestriert.
Container und Kubernetes: Neue Ebenen hybrider Infrastrukturen
Virtuelle Maschinen bilden bis heute eine wesentliche Grundlage moderner Rechenzentren. Sie ermöglichen die flexible Bereitstellung unterschiedlicher Betriebssystemumgebungen und sind fest in etablierte Verwaltungs-, Sicherheits- und Datensicherungsprozesse integriert. Mit der zunehmenden Verbreitung containerisierter Anwendungen hat sich jedoch auch die Art verändert, wie Unternehmen ihre IT-Infrastruktur organisieren. Während klassische Virtualisierungsplattformen vor allem die Bereitstellung und Verwaltung virtueller Systeme übernehmen, rückt bei containerisierten Architekturen zunehmend der Betrieb einzelner Anwendungen und Dienste in den Mittelpunkt.
Für hybride Infrastrukturen entsteht daraus eine zusätzliche Ebene: Anwendungen sollen möglichst standardisiert bereitgestellt werden können, unabhängig davon, ob die zugrunde liegenden Ressourcen im eigenen Rechenzentrum oder in einer Cloud-Umgebung betrieben werden. Dabei treten virtuelle Maschinen und Container nicht zwangsläufig in Konkurrenz zueinander. Vielmehr übernehmen sie unterschiedliche Aufgaben innerhalb einer gemeinsamen Infrastrukturarchitektur. Die entscheidende Entwicklung liegt deshalb nicht in der Ablösung klassischer Virtualisierung, sondern im Zusammenspiel unterschiedlicher Abstraktionsebenen und Betriebsmodelle.
Kubernetes: Eine zusätzliche Ebene hybrider Infrastrukturen
Kubernetes haben wir bereits als Orchestrierungsplattform für containerisierte Anwendungen kennengelernt. Im Kontext hybrider Infrastrukturen gewinnt diese Technologie jedoch eine weitere Bedeutung. Sie kann eine gemeinsame Grundlage für den Betrieb containerisierter Anwendungen in lokalen Rechenzentren und unterschiedlichen Cloud-Umgebungen schaffen. Dabei bleibt die zugrunde liegende Infrastruktur weitgehend von der eigentlichen Anwendungsorchestrierung getrennt.
Diese Abstraktion erleichtert die Standardisierung von Bereitstellungs- und Betriebsprozessen über Plattformgrenzen hinweg. Vollständige Portabilität entsteht dadurch allerdings nicht automatisch: Netzwerk-, Speicher- und Sicherheitsfunktionen sowie angebundene Plattformdienste können weiterhin spezifische Anpassungen erfordern. Damit ersetzt Kubernetes nicht die Virtualisierungsplattform, sondern ergänzt sie um eine weitere Ebene für den Betrieb moderner Anwendungen.
Virtuelle Maschinen als Grundlage für Kubernetes
Dass sich containerisierte Anwendungen zunehmend durchsetzen, bedeutet keineswegs, dass klassische Virtualisierungsplattformen überflüssig werden. Im Gegenteil: Viele Kubernetes-Cluster werden auf virtuellen Maschinen betrieben. Diese stellen die Infrastruktur für die Control-Plane- und Worker-Knoten bereit, während die Containerorchestrierung auf einer darüberliegenden Ebene erfolgt. Für Unternehmen bietet diese Kombination mehrere Vorteile. Bestehende Virtualisierungsumgebungen können weiterhin für die Ressourcenverwaltung, Isolation und grundlegende Infrastrukturverfügbarkeit genutzt werden. Gleichzeitig lassen sich unterschiedliche Kubernetes-Cluster voneinander trennen und unabhängig voneinander betreiben. Ob die zugrunde liegenden virtuellen Maschinen auf VMware, Hyper-V, KVM oder in einer Public Cloud ausgeführt werden, ist für die grundlegenden Kubernetes-Konzepte zunächst zweitrangig.
Vollständig austauschbar sind diese Umgebungen allerdings nicht. Insbesondere Netzwerk- und Speicherintegrationen, Load Balancer sowie Sicherheitsfunktionen können weiterhin von der jeweiligen Infrastrukturplattform abhängen. Kubernetes schafft damit eine zusätzliche Abstraktionsebene, ohne die technischen Unterschiede der darunterliegenden Virtualisierungsplattformen vollständig aufzuheben.
Unterschiedliche Anwendungen benötigen unterschiedliche Betriebsmodelle
Für Unternehmen ergibt sich daraus keine grundsätzliche Entscheidung zwischen virtuellen Maschinen und Containern. Vielmehr können beide Betriebsmodelle innerhalb einer gemeinsamen Infrastruktur sinnvoll nebeneinander bestehen. Klassische Unternehmensanwendungen verbleiben beispielsweise auf virtuellen Windows- oder Linux-Servern, während neu entwickelte Dienste containerisiert bereitgestellt werden. Entscheidend sind dabei die technischen Anforderungen, vorhandene Abhängigkeiten und die Supportvorgaben der jeweiligen Anwendungen. Eine pauschale Containerisierung bestehender Systeme wäre deshalb ebenso wenig sinnvoll wie die grundsätzliche Bereitstellung jeder neuen Anwendung auf einer eigenen virtuellen Maschine.
Gerade in hybriden Umgebungen eröffnet die Kombination beider Ansätze zusätzliche Möglichkeiten. Unternehmen können bestehende Virtualisierungsplattformen weiterverwenden und gleichzeitig containerisierte Anwendungen lokal oder in geeigneten Cloud-Umgebungen betreiben. Dabei verschiebt sich der Schwerpunkt zunehmend von der Verwaltung einzelner Server auf die Bereitstellung und den zuverlässigen Betrieb vollständiger Anwendungsplattformen. Die Zukunft der Virtualisierung liegt deshalb nicht in der vollständigen Ablösung virtueller Maschinen durch Container. Beide Technologien ergänzen sich und übernehmen unterschiedliche Aufgaben innerhalb moderner IT-Infrastrukturen. Je stärker Unternehmen solche unterschiedlichen Plattformen miteinander verbinden, desto wichtiger wird allerdings eine weitere Frage: Wie unabhängig bleiben sie von den Herstellern, Technologien und Diensten, auf denen ihre Anwendungen betrieben werden?
Digitale Souveränität und Herstellerabhängigkeit
Die Übernahme von VMware durch Broadcom hat eine Diskussion neu entfacht, die weit über die Auswahl eines Hypervisors hinausgeht. Wie abhängig sollte ein Unternehmen von einem einzelnen Technologieanbieter sein? Diese Frage ist keineswegs neu. Proprietäre Software, herstellerspezifische Schnittstellen und langfristige Lizenzverträge gehören seit Jahrzehnten zum Alltag professioneller IT-Infrastrukturen. Doch mit der zunehmenden Verbreitung hybrider Architekturen verändert sich die Dimension solcher Abhängigkeiten. Unternehmen beziehen heute nicht nur Virtualisierungssoftware von externen Herstellern. Sie nutzen Cloud-Plattformen, Identitätsdienste, Sicherheitslösungen, Verwaltungswerkzeuge und zunehmend auch KI-Dienste, deren technische und wirtschaftliche Rahmenbedingungen sich verändern können.
Damit wird digitale Souveränität zu einem wichtigen Bestandteil langfristiger Infrastrukturentscheidungen. Gemeint ist dabei nicht zwangsläufig die vollständige Unabhängigkeit von externen Anbietern. Eine solche Unabhängigkeit wäre in modernen IT-Umgebungen kaum realistisch. Vielmehr geht es um die Fähigkeit, technische und organisatorische Entscheidungen möglichst selbstbestimmt treffen zu können. Ein Unternehmen sollte wissen, wo seine Daten verarbeitet werden, welche Abhängigkeiten bestehen und welche Möglichkeiten verfügbar sind, wenn sich technische Anforderungen, Vertragsbedingungen oder strategische Rahmenbedingungen verändern.
Vendor Lock-in entsteht nicht nur durch Lizenzverträge
Herstellerabhängigkeit wird häufig mit proprietären Dateiformaten oder kostenpflichtigen Softwarelizenzen verbunden. Tatsächlich entsteht ein sogenannter Vendor Lock-in jedoch auf mehreren Ebenen. Eine Virtualisierungsplattform kann beispielsweise eigene Verwaltungswerkzeuge, Automatisierungsschnittstellen, Speichertechnologien und Hochverfügbarkeitsmechanismen verwenden. Je stärker diese Komponenten miteinander integriert sind, desto aufwendiger kann ein späterer Wechsel werden.
Ähnliche Abhängigkeiten entstehen in der Cloud. Wer Anwendungen eng mit proprietären Datenbankdiensten, Identitätsplattformen oder spezialisierten Cloud-Funktionen verbindet, profitiert möglicherweise von einer hohen Integration und einem geringeren eigenen Betriebsaufwand. Gleichzeitig kann die Übertragung dieser Anwendungen auf eine andere Plattform erhebliche Anpassungen erfordern.
Das bedeutet allerdings nicht, dass proprietäre Technologien grundsätzlich vermieden werden sollten. Eine enge Integration kann technisch und wirtschaftlich sinnvoll sein, wenn sie konkrete Anforderungen erfüllt und die damit verbundenen Abhängigkeiten bewusst akzeptiert werden. Problematisch wird Herstellerabhängigkeit vor allem dann, wenn sie erst sichtbar wird, sobald ein Wechsel notwendig erscheint.
Open Source schafft Möglichkeiten, aber keine automatische Unabhängigkeit
Offene Technologien können dazu beitragen, bestimmte Herstellerabhängigkeiten zu reduzieren. Plattformen wie Proxmox VE basieren auf etablierten Open-Source-Komponenten. Auch KVM, QEMU, Linux und zahlreiche Werkzeuge für Automatisierung und Containerisierung sind in offenen Entwicklungsökosystemen verankert. Unternehmen erhalten dadurch grundsätzlich mehr Möglichkeiten, Software einzusehen, anzupassen und unterschiedliche Dienstleister einzubeziehen.
Allerdings entsteht daraus nicht automatisch eine vollständig unabhängige Infrastruktur. Auch Open-Source-Plattformen besitzen eigene Verwaltungsmodelle, Konfigurationsformate und technische Besonderheiten. Ein Proxmox-Cluster lässt sich beispielsweise nicht ohne Weiteres durch eine andere KVM-basierte Verwaltungsplattform ersetzen, nur weil beide denselben grundlegenden Hypervisor verwenden. Ebenso können kommerzielle Supportleistungen, spezialisierte Integrationen und das verfügbare Fachwissen neue Abhängigkeiten schaffen. Open Source verbessert somit bestimmte Handlungsoptionen. Ob daraus tatsächlich mehr digitale Souveränität entsteht, hängt jedoch von der konkreten Architektur und den vorhandenen Betriebskompetenzen ab.
Datenkontrolle und technische Portabilität gehören zusammen
Ein wesentlicher Bestandteil digitaler Souveränität ist die Kontrolle über Daten. Dabei geht es nicht ausschließlich um deren geografischen Speicherort. Ebenso wichtig sind die Fragen, wer administrativen Zugriff besitzt, welche Verschlüsselungsverfahren eingesetzt werden und wie sich Daten bei Bedarf vollständig exportieren oder wiederherstellen lassen.
In hybriden Infrastrukturen müssen diese Anforderungen über unterschiedliche Plattformen hinweg berücksichtigt werden. Eine lokal betriebene virtuelle Maschine kann beispielsweise von externen Identitätsdiensten, Cloud-basierten Verwaltungsfunktionen oder ausgelagerten Datensicherungslösungen abhängig sein. Umgekehrt kann eine Anwendung in der Public Cloud so gestaltet sein, dass ihre Daten über dokumentierte Schnittstellen exportiert und ihre wesentlichen Komponenten auf anderen Plattformen neu bereitgestellt werden können.
Der physische Betriebsort allein entscheidet deshalb nicht über den Grad digitaler Souveränität. Mindestens ebenso wichtig ist die technische Portabilität. Sie beschreibt, mit welchem Aufwand sich Daten, Anwendungen und Infrastrukturkonfigurationen in eine andere Umgebung übertragen lassen. Offene Dateiformate, dokumentierte APIs, standardisierte Protokolle und automatisierte Bereitstellungsverfahren können dabei helfen.
Allerdings sollte Portabilität nicht mit vollständiger Austauschbarkeit verwechselt werden. Selbst bei standardisierten Technologien bleiben häufig Unterschiede bei Netzwerk, Storage, Sicherheit und Betriebsfunktionen bestehen.
Eine Exit-Strategie gehört zur Architekturplanung
Aus diesen Überlegungen ergibt sich eine praktische Konsequenz. Unternehmen sollten sich nicht erst dann mit einem möglichen Plattformwechsel beschäftigen, wenn ein bestehender Anbieter seine Lizenzbedingungen verändert oder eine eingesetzte Technologie abgekündigt wird. Eine geeignete Exit-Strategie sollte bereits bei der Architekturplanung berücksichtigt werden.
Dazu gehört beispielsweise die Frage, ob virtuelle Maschinen und ihre Daten in geeigneten Formaten exportiert werden können. Ebenso wichtig ist, ob Anwendungen auf alternativen Plattformen unterstützt werden und welche Anpassungen bei einem Wechsel erforderlich wären. Auch Dokumentation, Automatisierung und Datensicherung spielen eine zentrale Rolle. Eine Infrastruktur, deren Bereitstellung ausschließlich auf manuell ausgeführten Einzelschritten beruht, lässt sich häufig schwieriger auf einer neuen Plattform reproduzieren als eine Umgebung mit nachvollziehbaren Konfigurationen und standardisierten Prozessen.
Dabei muss eine Exit-Strategie keineswegs bedeuten, jederzeit einen vollständigen Anbieterwechsel durchführen zu können. Ein solcher Anspruch wäre für viele Unternehmen wirtschaftlich kaum vertretbar. Vielmehr geht es darum, die wesentlichen Abhängigkeiten zu kennen, kritische Daten und Anwendungen identifizieren zu können und realistische Handlungsalternativen vorzubereiten.
Digitale Souveränität ist eine Frage der Gestaltungsfreiheit
Am Ende geht es bei digitaler Souveränität nicht darum, möglichst viele Hersteller aus der eigenen Infrastruktur zu verbannen. Auch eine vollständig selbst betriebene Umgebung kann erhebliche technische und organisatorische Abhängigkeiten aufweisen. Entscheidend ist vielmehr, ob ein Unternehmen seine Infrastruktur langfristig nach eigenen Anforderungen weiterentwickeln kann. Dazu gehören transparente Kostenmodelle, nachvollziehbare Sicherheits- und Betriebsprozesse, geeignete Supportvereinbarungen und die Möglichkeit, technologische Entscheidungen bei Bedarf zu korrigieren. Gerade hybride Architekturen können dabei zusätzliche Handlungsspielräume eröffnen. Sie ermöglichen es, unterschiedliche Betriebsmodelle miteinander zu kombinieren und Anwendungen dort auszuführen, wo dies technisch, wirtschaftlich und organisatorisch sinnvoll ist.
Allerdings entstehen diese Vorteile nicht automatisch durch den Einsatz mehrerer Plattformen. Ohne gemeinsame Standards und klare Verantwortlichkeiten kann eine hybride Infrastruktur sogar zusätzliche Komplexität und neue Abhängigkeiten schaffen. Digitale Souveränität bedeutet deshalb nicht, auf Abhängigkeiten vollständig verzichten zu können. Sie bedeutet, diese Abhängigkeiten zu verstehen, bewusst zu gestalten und die eigene Handlungsfähigkeit möglichst langfristig zu bewahren. Diese Frage gewinnt zusätzlich an Bedeutung, weil sich die Anforderungen an Rechenzentren bereits erneut verändern. Mit der zunehmenden Nutzung künstlicher Intelligenz rücken spezialisierte Prozessoren, GPU-Ressourcen und neue Betriebsmodelle in den Mittelpunkt. Damit stellt sich auch für die Virtualisierung eine neue Frage: Wie lassen sich klassische Unternehmensanwendungen und rechenintensive KI-Workloads künftig auf einer gemeinsamen oder zumindest sinnvoll integrierten Infrastruktur betreiben?
KI verändert die Anforderungen an Virtualisierung
Über viele Jahre hinweg orientierte sich die Dimensionierung von Virtualisierungsinfrastrukturen vor allem an klassischen Serverressourcen: Prozessorleistung, Arbeitsspeicher, Speicherplatz und Netzwerkbandbreite. Diese Faktoren bleiben weiterhin entscheidend. Mit der zunehmenden Nutzung künstlicher Intelligenz kommt jedoch eine weitere Dimension hinzu. Moderne KI-Anwendungen benötigen je nach Einsatzszenario erhebliche Rechenkapazitäten. Insbesondere das Training großer Modelle, aber auch deren produktive Ausführung, kann spezialisierte Hardwarebeschleuniger erfordern. Damit gewinnen Grafikprozessoren (GPUs) und andere KI-Beschleuniger auch außerhalb klassischer High-Performance-Computing-Umgebungen an Bedeutung.
Für die Virtualisierung entsteht daraus eine neue Herausforderung: Wie lassen sich solche Ressourcen effizient bereitstellen, unterschiedlichen Workloads zuweisen und in bestehende Betriebsprozesse integrieren? Die Virtualisierung der Zukunft muss nicht nur klassische Serverressourcen verwalten, sondern zunehmend auch spezialisierte Rechenkapazitäten für daten- und KI-intensive Anwendungen berücksichtigen.
GPU-Passthrough und GPU-Sharing: Beschleuniger flexibel bereitstellen
Klassische virtuelle Maschinen verwenden überwiegend virtualisierte Prozessor-, Speicher- und Netzwerkressourcen. Bei KI-Workloads kann dagegen der direkte oder gemeinsam genutzte Zugriff auf Hardwarebeschleuniger entscheidend sein. Eine Möglichkeit stellt das sogenannte GPU-Passthrough dar. Dabei wird eine physische GPU einer virtuellen Maschine zur direkten Nutzung zugewiesen. Das kann eine hohe Leistungsfähigkeit ermöglichen, schränkt jedoch die flexible gemeinsame Nutzung dieser Hardware ein. Je nach Hypervisor, Hardware und Konfiguration können außerdem Einschränkungen bei Live-Migration, Hochverfügbarkeit und anderen Verwaltungsfunktionen bestehen.
Eine andere Möglichkeit ist die Aufteilung geeigneter GPU-Ressourcen auf mehrere virtuelle Maschinen. Solche Verfahren werden häufig unter Begriffen wie vGPU oder GPU-Sharing zusammengefasst. Ihre technische Umsetzung unterscheidet sich allerdings je nach Hersteller, Grafikkarte, Treibermodell und Virtualisierungsplattform. Teilweise sind zusätzliche Softwarelizenzen oder bestimmte Hardwaregenerationen erforderlich. Auch die Unterstützung innerhalb der Gastbetriebssysteme und KI-Frameworks muss berücksichtigt werden.
Für Administrator:innen bedeutet dies, dass die Auswahl einer Virtualisierungsplattform künftig stärker von den konkret benötigten Beschleunigerfunktionen beeinflusst werden kann. Ein Hypervisor, der klassische Windows- und Linux-Server zuverlässig betreibt, unterstützt nicht zwangsläufig jede gewünschte GPU-Konfiguration.
KI-Workloads stellen neue Anforderungen an Storage und Netzwerk
Neben der reinen Rechenleistung verändern KI-Anwendungen auch die Anforderungen an andere Infrastrukturkomponenten. Besonders beim Training und bei der Verarbeitung großer Datenbestände können erhebliche Datenmengen zwischen Speicher, Arbeitsspeicher und Beschleunigern bewegt werden. Langsame Speicherzugriffe können dazu führen, dass leistungsfähige GPUs nicht ausreichend ausgelastet werden. Auch das Netzwerk gewinnt an Bedeutung, insbesondere wenn mehrere Systeme gemeinsam an rechenintensiven Aufgaben arbeiten oder große Datenbestände zwischen unterschiedlichen Infrastrukturkomponenten übertragen werden. Bei verteiltem KI-Training können deshalb Netzwerklatenz, Bandbreite und geeignete Kommunikationsmechanismen einen erheblichen Einfluss auf die Gesamtleistung haben.
Allerdings unterscheiden sich die Anforderungen je nach Workload deutlich. Die lokale Ausführung eines kleineren Sprachmodells benötigt eine andere Infrastruktur als das Training eines umfangreichen Modells auf zahlreichen Beschleunigern. Auch klassische KI-gestützte Unternehmensanwendungen, die lediglich externe Modell-APIs verwenden, stellen häufig keine besonderen Anforderungen an die lokale Virtualisierungshardware. Deshalb sollten Unternehmen zunächst klären, welche KI-Workloads tatsächlich selbst betrieben werden sollen. Erst daraus lassen sich sinnvolle Anforderungen an GPUs, Arbeitsspeicher, Storage und Netzwerk ableiten.
Lokale KI oder Cloud: Eine Frage des Betriebsmodells
Gerade bei KI-Anwendungen gewinnt die Entscheidung zwischen lokalen Ressourcen und Cloud-Diensten zusätzliche Bedeutung. Cloud-Plattformen ermöglichen den Zugriff auf spezialisierte Beschleuniger und verwaltete KI-Dienste, ohne dass Unternehmen die erforderliche Hardware selbst beschaffen und dauerhaft betreiben müssen. Das kann insbesondere bei zeitlich begrenzten Projekten, stark schwankendem Ressourcenbedarf oder experimentellen Anwendungen wirtschaftlich sinnvoll sein.
Demgegenüber können lokale KI-Infrastrukturen interessant sein, wenn sensible Daten innerhalb einer kontrollierten Umgebung verarbeitet werden sollen, niedrige Antwortzeiten erforderlich sind oder spezialisierte Rechenressourcen dauerhaft und ausreichend ausgelastet werden. Allerdings ist auch der lokale Betrieb mit erheblichen Anforderungen verbunden. Leistungsfähige Beschleuniger verursachen nicht nur Anschaffungskosten. Sie benötigen Strom, Kühlung, geeignete Serverplattformen und entsprechende Betriebskenntnisse. Hinzu kommen die Wartung der eingesetzten Softwareumgebungen, Sicherheitsupdates sowie die kontinuierliche Weiterentwicklung der KI-Frameworks und Modelle.
Die wirtschaftliche Entscheidung hängt deshalb wesentlich von der tatsächlichen Auslastung und dem vorgesehenen Einsatzszenario ab. Eine teure GPU-Infrastruktur, die nur gelegentlich verwendet wird, kann langfristig unwirtschaftlicher sein als die bedarfsgerechte Nutzung externer Rechenkapazitäten. Umgekehrt können dauerhaft ausgelastete lokale Systeme unter geeigneten Voraussetzungen wirtschaftliche und organisatorische Vorteile bieten.
Hybride KI-Infrastrukturen verbinden unterschiedliche Anforderungen
In vielen Unternehmen wird sich deshalb kein ausschließlich lokales oder vollständig Cloud-basiertes Betriebsmodell durchsetzen müssen. Stattdessen können unterschiedliche KI-Workloads auf verschiedene Umgebungen verteilt werden. Beispielsweise lassen sich kleinere Modelle lokal ausführen, während für rechenintensive Trainings- oder Anpassungsprozesse zeitweise zusätzliche Cloud-Ressourcen genutzt werden.
Ebenso können Unternehmen Anwendungen im eigenen Rechenzentrum betreiben, die bei Bedarf auf externe KI-Dienste zugreifen. Solche Architekturen erfordern allerdings eine sorgfältige Betrachtung von Datenflüssen, Zugriffskontrollen und Kosten. Gerade wenn sensible Unternehmensdaten an externe Dienste übertragen werden, müssen die jeweiligen Sicherheits-, Datenschutz- und Vertragsbedingungen berücksichtigt werden.
Hinzu kommt, dass sich KI-Workloads nicht beliebig zwischen unterschiedlichen Beschleunigerplattformen verschieben lassen. Treiber, Laufzeitumgebungen, Frameworks und unterstützte Hardwarefunktionen können technische Abhängigkeiten schaffen, die bei der Architekturplanung berücksichtigt werden müssen. Damit begegnen uns erneut die Fragen nach Portabilität und digitaler Souveränität, die wir bereits im vorherigen Abschnitt betrachtet haben.
Virtualisierung bleibt relevant – ihre Aufgaben verändern sich
Die zunehmende Bedeutung künstlicher Intelligenz bedeutet nicht, dass klassische Virtualisierungsplattformen ihre bisherige Rolle verlieren. Windows- und Linux-Server, Datenbanken, Fachanwendungen und zahlreiche weitere Unternehmenssysteme werden auch künftig auf virtuellen Maschinen betrieben. Gleichzeitig müssen moderne Infrastrukturen zusätzliche Anforderungen unterstützen. Dazu gehören die Bereitstellung spezialisierter Beschleuniger, die Integration containerisierter KI-Anwendungen und die flexible Kombination lokaler Ressourcen mit Cloud-Diensten. Dabei ist keineswegs jeder KI-Workload auf eine klassische virtuelle Maschine angewiesen. Je nach Anforderungen können auch Containerplattformen oder dedizierte physische Systeme geeigneter sein.
Die entscheidende Entwicklung liegt deshalb nicht in einer weiteren Ablösung bestehender Technologien. Vielmehr erweitert sich das Spektrum der Workloads, für die Unternehmen geeignete Betriebsmodelle bereitstellen müssen. Virtualisierung bleibt eine wesentliche Grundlage moderner IT-Infrastrukturen. Ihre Zukunft wird jedoch zunehmend davon geprägt, wie flexibel sie klassische Anwendungen, containerisierte Dienste und spezialisierte KI-Workloads in unterschiedlichen Betriebsumgebungen unterstützen kann.
Damit schließt sich auch der Gedankengang dieses Kapitels. Hybride Verwaltung, Infrastructure as Code, Kubernetes, digitale Souveränität und KI sind keine voneinander unabhängigen Entwicklungen. Sie verändern gemeinsam die Anforderungen an die Architektur und den Betrieb moderner IT-Infrastrukturen. Die Frage nach dem richtigen Hypervisor bleibt wichtig. Sie ist jedoch längst Teil einer größeren strategischen Entscheidung geworden. Nicht mehr allein die Virtualisierungsplattform bestimmt die Architektur des Rechenzentrums. Zunehmend entscheiden die Anforderungen der Anwendungen darüber, welche Infrastrukturplattformen überhaupt benötigt werden.
Fazit: Virtualisierung war nie verschwunden
‚Wir machen VMware.‘ – Mit diesem Satz haben wir unseren Beitrag begonnen. Über viele Jahre war er in zahlreichen Unternehmen weniger eine technische Begründung als vielmehr die Beschreibung einer etablierten Realität. Die Virtualisierungsplattform war vorhanden, Administrator:innen kannten ihre Werkzeuge, Betriebsprozesse hatten sich bewährt und neue virtuelle Maschinen wurden innerhalb dieser Infrastruktur bereitgestellt. Warum sollte man daran etwas ändern?
Heute fällt die Antwort auf diese Frage nicht mehr ganz so selbstverständlich aus. Die Übernahme von VMware durch Broadcom und die Veränderungen bei Produktportfolio und Lizenzierung haben viele Unternehmen dazu veranlasst, ihre bisherigen Entscheidungen erneut zu überprüfen.
Plötzlich stehen Fragen im Raum, die lange Zeit kaum gestellt wurden. Ist die vorhandene Virtualisierungsplattform auch künftig wirtschaftlich sinnvoll? Welche Alternativen gibt es? Wie aufwendig wäre eine Migration? Und welche technologischen Abhängigkeiten möchte ein Unternehmen langfristig eingehen? Dabei ist die zugrunde liegende Technologie keineswegs neu.
Eine alte Idee unter veränderten Vorzeichen
Unsere Reise durch die Geschichte der Virtualisierung hat gezeigt, wie weit ihre Ursprünge zurückreichen. Bereits auf den IBM-Mainframes der 1960er-Jahre entstand die Idee, physische Rechenressourcen so aufzuteilen, dass mehrere voneinander getrennte Betriebssystemumgebungen auf derselben Hardware ausgeführt werden konnten. Jahrzehnte später übertrug VMware dieses Prinzip erfolgreich auf die x86-Welt und veränderte damit den Betrieb moderner Rechenzentren grundlegend.
Microsoft entwickelte mit Hyper-V eine eigene Virtualisierungsplattform, während sich mit KVM, Xen und weiteren Technologien zusätzliche Alternativen etablierten. Die Public Cloud machte virtualisierte Rechenressourcen anschließend zu einem flexibel nutzbaren Dienst. Container und Kubernetes erweiterten die Möglichkeiten, Anwendungen unabhängig von einzelnen Serverinstanzen bereitzustellen und zu betreiben. Und mit hybriden Infrastrukturen, Infrastructure as Code und spezialisierten KI-Workloads verändern sich die Anforderungen bereits erneut.
Trotz dieser Entwicklungen ist die grundlegende Idee erstaunlich konstant geblieben: Physische Ressourcen sollen möglichst flexibel, effizient und kontrolliert für unterschiedliche Aufgaben bereitgestellt werden. Verändert haben sich vor allem die technischen Möglichkeiten und die Erwartungen an ihren Betrieb.
Die Rückkehr von Hyper-V ist Teil einer größeren Entwicklung
Vor diesem Hintergrund lässt sich auch das erneute Interesse an Microsoft Hyper-V besser einordnen. Hyper-V ist nicht plötzlich zu einer neuen Technologie geworden. Die Plattform verfügt seit vielen Jahren über Funktionen für professionelle Virtualisierungsumgebungen und ist tief in das Microsoft-Ökosystem integriert. Was sich verändert hat, ist die wirtschaftliche und strategische Ausgangssituation vieler Unternehmen. Wenn bisherige Lizenzmodelle neu bewertet werden müssen, rücken vorhandene Alternativen zwangsläufig stärker in den Mittelpunkt.
Davon profitieren nicht ausschließlich Microsoft-Technologien. Auch Proxmox VE, KVM-basierte Lösungen und andere Virtualisierungsplattformen werden verstärkt als mögliche Bestandteile zukünftiger Infrastrukturstrategien betrachtet. Das bedeutet jedoch nicht, dass VMware seine technische Bedeutung verloren hätte. Eine etablierte VMware-Umgebung kann weiterhin die richtige Wahl sein, insbesondere wenn ihre Funktionen, Integrationen und Betriebsprozesse den Anforderungen eines Unternehmens entsprechen.
Ebenso wenig wird Hyper-V automatisch zur besten Alternative, nur weil bereits Windows Server eingesetzt wird. Und auch eine Open-Source-Plattform wie Proxmox VE ist nicht allein deshalb wirtschaftlich überlegen, weil für ihre grundlegende Nutzung keine verpflichtende Lizenzgebühr anfällt. Die eigentliche Veränderung besteht darin, dass die Wahl des Hypervisors wieder zu einer bewussten Entscheidung wird – statt lediglich eine bestehende Entscheidung fortzuschreiben.
Der Hypervisor bleibt wichtig, aber er entscheidet nicht mehr allein
Im Verlauf unseres Beitrags haben wir außerdem gesehen, dass die Auswahl einer Virtualisierungsplattform nur einen Teil der gesamten Infrastrukturarchitektur bestimmt. Hochverfügbarkeit entsteht nicht allein durch die Installation eines Hypervisors. Sie benötigt geeignete Cluster-, Netzwerk- und Speicherarchitekturen. Datensicherung ist mehr als das Erstellen von Snapshots. Automatisierung geht über einzelne Skripte hinaus. Und eine erfolgreiche Migration endet nicht damit, dass eine virtuelle Maschine auf einer anderen Plattform startet. Hinzu kommen Fragen der Lizenzierung, des Supports, der Sicherheit und der langfristigen Wirtschaftlichkeit.
Gerade deshalb wäre es wenig hilfreich, VMware, Hyper-V und Proxmox VE auf eine einfache Rangliste zu reduzieren. Die entscheidenden Unterschiede zeigen sich häufig erst im Zusammenspiel mit den vorhandenen Anwendungen, Kompetenzen und Betriebsprozessen. Gleichzeitig verschiebt sich der Blick zunehmend über die Grenzen einzelner Virtualisierungsplattformen hinaus. Lokale Rechenzentren, Public-Cloud-Dienste, Containerplattformen und spezialisierte KI-Infrastrukturen werden künftig in unterschiedlichen Kombinationen zusammenarbeiten.
Damit wird nicht jeder Workload automatisch cloudbasiert oder containerisiert. Vielmehr müssen Unternehmen für unterschiedliche Anwendungen geeignete Betriebsmodelle finden. Virtualisierung bleibt dabei eine wichtige Grundlage – auch wenn sie zunehmend Teil einer umfassenderen Infrastrukturarchitektur wird.
Nicht die Technologie steht erneut zur Wahl, sondern die Strategie
Vielleicht liegt genau darin die wichtigste Erkenntnis dieser Entwicklung. Die Diskussion um VMware, Hyper-V und alternative Hypervisoren ist auf den ersten Blick eine Diskussion über Virtualisierungssoftware. Tatsächlich geht es jedoch um wesentlich mehr. Unternehmen müssen entscheiden, wie sie ihre IT-Infrastruktur langfristig gestalten möchten. Welche Technologien passen zu ihren Anwendungen? Welche Kompetenzen sind vorhanden? Welche Abhängigkeiten sind vertretbar? Und wie lässt sich ein zuverlässiger Betrieb sicherstellen, ohne wirtschaftliche und technologische Handlungsspielräume unnötig einzuschränken?
Diese Fragen lassen sich nicht allein durch einen Produktvergleich beantworten. Sie erfordern eine Betrachtung der gesamten Infrastruktur und ihrer zukünftigen Entwicklung. Dabei kann das Ergebnis durchaus sein, an einer bestehenden Plattform festzuhalten. Ebenso kann es sinnvoll sein, Hyper-V oder Proxmox VE einzuführen, unterschiedliche Technologien parallel zu betreiben oder bestimmte Anwendungen künftig in einer Cloud-Umgebung bereitzustellen. Entscheidend ist, dass diese Entscheidungen auf nachvollziehbaren technischen, organisatorischen und wirtschaftlichen Grundlagen beruhen.
Kehren wir deshalb noch einmal zu unserem Ausgangssatz zurück. ‚Wir machen VMware.‘ Vielleicht lautet die Antwort in manchen Unternehmen auch künftig genau so. In anderen wird es heißen: ‚Wir setzen auf Hyper-V.‘ , oder: ‚Wir betreiben unsere Infrastruktur mit Proxmox.‘ Doch eigentlich sollte die Frage inzwischen anders gestellt werden. Nicht: ‚Welchen Hypervisor verwenden wir?‘, sondern: ‚Welche Infrastruktur benötigen wir, um unsere Anwendungen heute und in Zukunft sicher, zuverlässig und wirtschaftlich betreiben zu können?‘ Virtualisierung erlebt keine Rückkehr, weil sie jemals verschwunden wäre. Sie steht erneut im Mittelpunkt, weil Unternehmen gerade neu entscheiden müssen, auf welcher technologischen Grundlage sie ihre digitale Zukunft gestalten wollen.
Quellenangaben
(Abgerufen am 11. Oktober 2026)
Geschichte und Grundlagen der Virtualisierung
- Arteq (Cisco Learning Network): A Brief History of Network Virtualization
- IBM: VM History and Heritage
- Karen Scarfone, Murugiah Souppaya, Paul Hoffman (NIST): Guide to Security for Full Virtualization Technologies (NIST SP 800-125)
- Kristin Morris (Computer History Museum): Turtles, Blocks, and Memories
- Stephanie Susnjara, Ian Smalley (IBM): What is virtualization?
Microsoft Hyper-V und Windows Server
- Microsoft Learn: Compare Azure Local to Windows Server
- Microsoft Learn: Hyper-V Architecture
- Microsoft Learn: Hyper-V feature compatibility by generation and guest
- Microsoft Learn: Hyper-V virtualization in Windows Server and Windows
- Microsoft Learn: Overview of Hyper-V
- Microsoft Learn: Virtualization-based Security (VBS)
- Microsoft Learn: What's new in Windows Server 2025
- Microsoft: Windows Server 2025 licensing guidance
VMware, Broadcom und Lizenzierung
- Broadcom: Broadcom Software Offerings — Agreements and Resources
- Broadcom: Licensing Overview
- Foo Yun Chee (Reuters): Broadcom questioned by EU over VMware licensing changes
- Jill Armour (Microsoft): Broadcom VMware Licensing Changes: What Azure VMware Solution Partners Need to Know
- Tim McCarthy (TechTarget): Broadcom axes VMware education licensing options for schools
Alternative Virtualisierungsplattformen
- KubeVirt: KubeVirt user guide
- Proxmox: About Proxmox
- Proxmox: Proxmox Celebrates 10-Year Anniversary
- Proxmox: Proxmox celebrates 20 years of open-source enterprise solutions
- Proxmox: Proxmox VE Documentation Index
Container, Kubernetes und Cloud-Computing
- Bob Killen, Chris Short, Frederico Muñoz, Kaslin Fields, Tim Bannister (The Kubernetes Authors): 10 Years of Kubernetes
- Jeff Barr (Amazon): AWS Lambda turns ten – looking back and looking ahead
- Jeff Barr (Amazon): Happy 15th Birthday Amazon EC2
- Scott Johnston (Docker): 11 Years of Docker: Shaping the Next Decade of Development
- Stephanie Susnjara (IBM): The history of Kubernetes
- Tim Hildred (Red Hat): The History of Containers
Sicherheit und Virtualisierungsbetrieb
- BSI: 1.5 Virtualisierung (Edition 2023) (PDF-Datei)
- Matthew Anania (Veeam): Virtualization Security: Secure Hypervisors and VMs
- VMware: What is virtualized security?
Marktanalysen und Trends
- 6sense: Virtualization Platform
- Adrienn Lawson, Jeffrey Sica, Jonathan Bryce (CNCF): CNCF Annual Cloud Native Survey (PDF-Datei)
- Grand View Research: Virtual Machine Market (2023 - 2030)
- Lionel Sujay Vailshery (Statista): Virtualization - Statistics & Facts
- Mordor Intelligence: Markt für Virtualisierungssoftware Grössen- und Marktanteilsanalyse – Wachstumstrends und Prognose (2026 – 2031)
Weiterlesen hier im Blog
- Moderne Microsoft Security-Architektur in der Praxis – Zero Trust, Identity, Cloud und Operations ganzheitlich denken
- Von Windows NT bis Windows Server 2025: Wie Microsoft das Unternehmensnetzwerk neu erfand
- Wie moderne Computer funktionieren – Von Architekturmodellen zu CPU, RAM und Systempraxis
- Windows im Wandel: Von Bare Metal bis Cloud Management – Wie sich Installation, Updates und Verwaltung verändert haben
- Windows Server 2025 – What’s New?
- Windows Server 2025 Storage – Funktionen, Neuerungen und Best Practices